Как создать парсер отзывов Amazon, который действительно работает
Создайте надежный парсер отзывов Amazon с проверенными тактиками использования прокси, обхода блокировок и парсинга. Пошаговое руководство для технических специалистов и агентств.
Если вы натыкаетесь на стену авторизации, несколько избранных отзывов и пул прокси, который начинает гореть в тот момент, когда вы выходите за рамки тестового трафика, вы уже знаете проблему. Скрейпер отзывов Amazon - это уже не простой HTML-парсер. Это конвейер, который должен пережить антибот-стек Amazon, справиться с частичной видимостью и при этом дать аналитикам что-то достаточно чистое для анализа настроений, мониторинга конкурентов и исследования продуктов.
Содержание
- С чем сталкивается скрейпер отзывов Amazon в 2026 году
- Создание конвейера обнаружения и извлечения
- Выбор правильного класса прокси для скрейпинга отзывов
- Тактики обхода блокировок, которые выдерживают нагрузку
- Пагинация, парсинг и нормализация между маркетплейсами
- Юридические и этические границы, которые нельзя пересекать
- Мониторинг, хранение и масштабирование конвейера
С чем сталкивается скрейпер отзывов Amazon в 2026 году
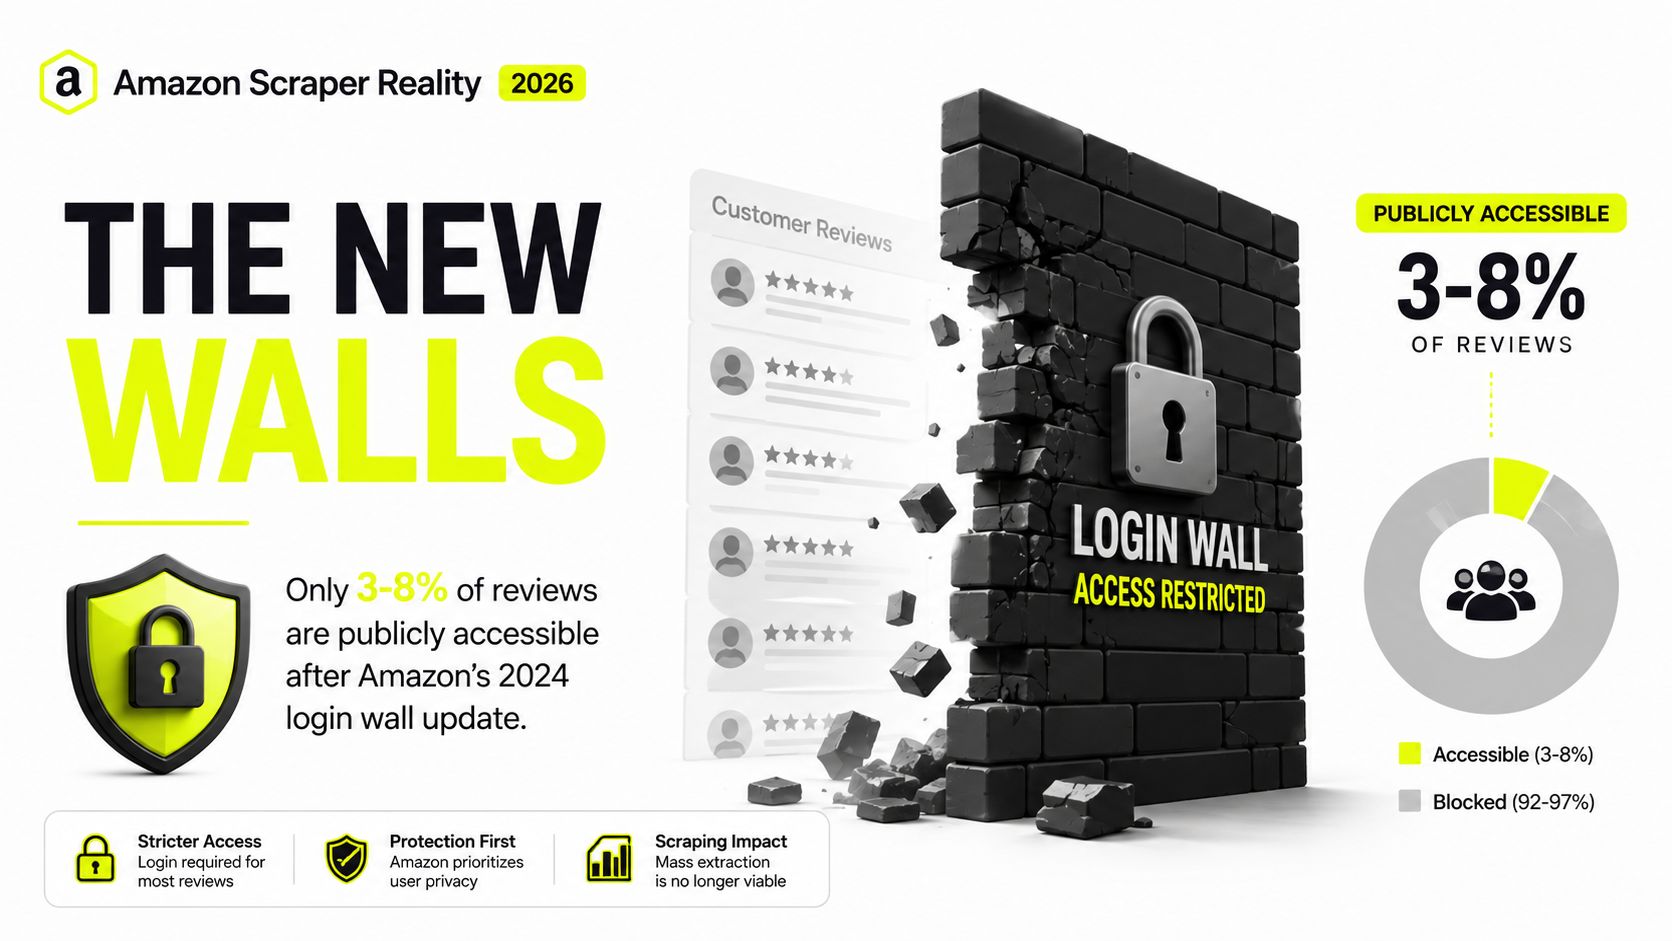
Вы все еще можете быстро просмотреть страницу продукта, но старый подход «захватить отзывы и двигаться дальше» остался в прошлом. 5 ноября 2024 года Amazon спрятал почти все отзывы за стену авторизации, и эндпоинт /product-reviews/ теперь перенаправляет неаутентифицированный трафик на страницу входа. Публично остаются обычно только от 3 до 8 избранных отзывов на странице деталей продукта, плюс совокупный рейтинг, общее количество и распределение от 5 до 1 звезды. Это изменение превратило скрейпинг отзывов из широкого извлечения в ограниченный доступ к данным, особенно для команд, занимающихся анализом настроений, мониторингом конкурентов или исследованием продуктов на разных рынках, как описано в руководстве об изменениях доступа к отзывам Amazon. Изменения доступа к отзывам Amazon
Практический результат неприятен. Ваш первый запуск выглядит нормально, затем тот же ASIN начинает возвращать частичные данные, пустые списки отзывов или страницу входа, которую ваш парсер не был создан распознавать. Вот почему рабочий процесс должен учитывать стены авторизации, поведение троттлинга и логику отката с самого начала, а не рассматривать их как граничные случаи. Если вы уже сталкиваетесь со спорами об отзывах на странице продукта, ресурс о том, как удалить отзыв с Amazon, дает полезный контекст о том, как поверхность отзывов Amazon ведет себя и со стороны продавца.
Практическое правило: если страница отзывов выглядит легкой на первом URL, предполагайте, что более сложный путь появится, как только вы начнете пагинацию, смените локаль или переиспользуете сессию.
Большая ловушка - это расхождения между маркетплейсами. Конвейер, который выглядит здоровым на одном домене, все равно может провалиться в тот момент, когда вы сравните amazon.com с amazon.co.uk, amazon.fr или amazon.de. Защиты Amazon - это не только блокировка запросов, они также меняют то, какие данные видимы, где они появляются и сколько работы требуется, чтобы нормализовать их в один используемый набор данных.
Если вам нужна быстрая справка по поведению скрининга ботов, внутреннее руководство по антибот-системам стоит держать открытым, пока вы отлаживаете свой скрейпер. Суть не просто в том, чтобы получить отзывы. Суть в том, чтобы получить правильный срез, на правильном рынке, до того как сессия будет помечена.
Создание конвейера обнаружения и извлечения
Производственный скрейпер отзывов Amazon не должен начинаться с парсинга. Он должен начинаться с обнаружения. Руководство ScrapeOps рекомендует двухэтапный процесс: сначала определить фактический URL отзывов продукта из ASIN или результатов поиска, затем пролистать раздел отзывов и распарсить стабильные поля, такие как рейтинг, автор, дата, текст и флаг подтвержденной покупки. Страницы отзывов Amazon также предоставляют эти поля в структурированных выходных данных, которые могут корректно попасть в CSV или JSON. Рабочий процесс скрейпера отзывов Amazon от ScrapeOps
Процесс, который выдерживает реальные нагрузки
Рассматривайте ASIN как точку входа, а не цель. Результат поиска или страница продукта дает вам маршрут к эндпоинту отзывов, и этот маршрут может варьироваться в зависимости от маркетплейса, локали и состояния страницы. Как только у вас есть URL отзывов, скрейпер должен проходить по страницам отзывов, собирать стабильные поля и корректно останавливаться, когда пагинация заканчивается или форма страницы меняется.
import requests
from bs4 import BeautifulSoup

def get_review_page(review_url, headers=None, cookies=None):
    resp = requests.get(review_url, headers=headers, cookies=cookies, timeout=30)
    resp.raise_for_status()
    return resp.textdef parse_reviews(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    for card in soup.select("[data-hook='review']"):
        rows.append({
            "rating": card.select_one("[data-hook='review-star-rating']").get_text(strip=True) if card.select_one("[data-hook='review-star-rating']") else "",
            "author": card.select_one(".a-profile-name").get_text(strip=True) if card.select_one(".a-profile-name") else "",
            "date": card.select_one("[data-hook='review-date']").get_text(strip=True) if card.select_one("[data-hook='review-date']") else "",
            "body": card.select_one("[data-hook='review-body']").get_text(" ", strip=True) if card.select_one("[data-hook='review-body']") else "",
            "verified_purchase": bool(card.select_one("[data-hook='avp-badge']"))
        })
    return rows
Сначала используйте парсинг сырого HTML. Переходите к отрендеренному DOM только когда тело страницы или контейнер с отзывами перестают появляться в ответе сервера.
Где должны быть повторные попытки
Повторные попытки должны оборачивать запрос, а не парсер. Если ответ приходит искажённым, заблокированным или перенаправленным, уровень запроса решает, нужно ли ротировать состояние сессии, сменить класс прокси или сделать паузу. Парсер должен видеть только страницу, которую вы уже сочли достойной обработки.
| Поле | Источник на странице | Форма хранения |
|---|---|---|
| Рейтинг | Элемент звёзд в карточке отзыва | Целое число или строка |
| Автор | Блок имени профиля | Текст |
| Дата | Строка даты отзыва | Текст |
| Текст | Контейнер текста отзыва | Текст |
| Подтверждённая покупка | Наличие значка | Булево значение |
Для команд, предпочитающих автоматизацию браузера, резервный вариант с Playwright имеет смысл, когда DOM требует рендеринга JS или сохранения cookie. Внутреннее руководство по краулингу на Python о паттернах браузерного краулинга будет полезным дополнением, если вы встраиваете запросы и браузерный резерв в один пул воркеров. Важная часть - разделение ответственности: сначала обнаружение, затем извлечение, повторные попытки вокруг транспорта, а не вокруг бизнес-логики.
Выбор правильного класса прокси для скрейпинга отзывов
Amazon не наказывает все классы прокси одинаково. Диапазоны дата-центров и IPv6 дёшевы и быстры, но они быстро выгорают на экранах защиты отботов. Резидентные IP живут дольше, потому что выглядят как обычный домашний трафик, хотя ротация может стать шумной, если злоупотреблять подсетью. Мобильные IP наследуют доверие оператора и обычно лучше переживают самые сложные страницы, что важно, когда ваш скрейпер попадает на потоки отзывов, защищённые логином, которые постоянно срабатывают на трение. Обзор таксономии прокси в статье о типах прокси чётко отражает эту реальность.
Подбирайте прокси под задачу
Если задача - обнаружение ASIN, дата-центр всё ещё может иметь смысл, потому что риск блокировки ниже, а стоимость страницы дешёвая. Если вы массово извлекаете страницы отзывов, резидентные должны быть рабочей лошадкой. Если семейство продуктов постоянно попадает в циклы CAPTCHA, мобильные - это спасательный слой. IPv6 всё ещё может помочь в контролируемом внутреннем инструментарии, но защита Amazon обычно делает его наименее прощающим вариантом для сбора отзывов.
| Класс прокси | Лучшая нагрузка для отзывов | Типичное поведение блокировки | Скорость |
|---|---|---|---|
| Резидентные | Основной сбор отзывов | Живут дольше, но всё равно помечаются при повторении паттернов | Средняя |
| Мобильные | Упрямые ASIN и страницы рядом с логином | Наивысшее доверие, наименьшее трение на практике | Средняя |
| Дата-центр | Обнаружение ASIN и запросы с низким риском | Выгорают быстрее всего на экранах ботов | Быстрая |
| IPv6 | Ограниченное контролируемое тестирование | Часто нестабильны против агрессивной защиты | Быстрая |
Практическое правило: не используйте лучший класс прокси для каждого этапа. Тратьте более дешёвые диапазоны на обнаружение, а затем резервируйте более сильный трафик для запросов отзывов, которым это действительно нужно.
Правильный стек также зависит от того, как вы управляете сессиями. Фиксированное назначение помогает, когда одному ASIN нужна непрерывность на нескольких страницах. Ротация помогает, когда Amazon начинает коррелировать повторяющиеся паттерны. Для операторов, уже работающих с AdsPower, Dolphin Anty, GoLogin, Multilogin или Hidemyacc, уровень прокси должен соответствовать той же модели сессии, что и профиль браузера, иначе вы потеряете доверие ещё до того, как скрейпер дойдёт до второй страницы.
Тактики анти-блокировки, которые выдерживают нагрузку
Обычно всё ломается там, где команды проявляют небрежность. Amazon не нужно блокировать каждый запрос. Ему достаточно добавить столько трения, чтобы ваша сессия начала выглядеть скриптовой. Операционный паттерн, который лучше всего выживает под нагрузкой, использует запросы с темпом, ротацию прокси по расписанию, откат при росте поведения CAPTCHA, резидентные прокси для основного пути запросов, скрытые заголовки браузера и cookie, остающиеся согласованными внутри каждой сессии. Тактики скрейпинга отзывов Amazon
Части, которые действительно важны
Строки User-agent важны меньше, чем ожидают многие операторы. Отпечатки заголовков и отпечатки TLS обычно разоблачают скрейпер первыми, особенно когда браузер говорит одно, а стек соединения ведёт себя как что-то другое. Если вы уже управляете рекламными аккаунтами Facebook и TikTok, занимаетесь фармингом аккаунтов или используете клоакинг для гео-таргетированных кампаний, вы знаете, как быстро несоответствующий отпечаток может разрушить доверие ко всему профилю.
Cookie сессии несут остальную нагрузку. Amazon связывает поведение с непрерывностью, поэтому стабильная банка cookie может поддерживать сессию достаточно согласованной, чтобы пройти через страницы отзывов без принудительной новой проверки доверия при каждом запросе. Вот почему выбор прокси и выбор браузера должны проектироваться вместе, а не рассматриваться как отдельные проблемы.
Делайте идентичность сессии скучной. Большинство блокировок появляется, когда скрейпер меняется слишком сильно и слишком быстро.
Где подходит Sota Proxy
Sota Proxy полезен для управления ротацией, контроля липких сессий и геотаргетинга, который соответствует уже используемому браузерному профилю. Это важно для медиабайеров, запускающих геотаргетированные кампании, и не менее важно для агентств, которым нужен конвейер проверки, привязанный к мультипрофильной настройке, без сжигания одной и той же IP-репутации на каждом воркере. Для команд, которым нужен более жёсткий контроль над оборотом сессий, руководство по ротации proxy IP является практическим ориентиром для решения, когда сохранять IP липким, а когда переключаться. Если вы монетизируете рабочий процесс или передаёте стек коллегам, реферальная программа Sota Proxy с комиссией до 40% - это та деталь, которую команды обсуждают после того, как технические средства контроля уже установлены.
Правило защиты от блокировок простое. Не боритесь с Amazon сырым объёмом запросов. Распределяйте нагрузку, сохраняйте стабильность куки, переключайте прокси по расписанию и отступайте в момент, когда начинает расти частота CAPTCHA.
Пагинация, парсинг и кросс-маркетплейсная нормализация
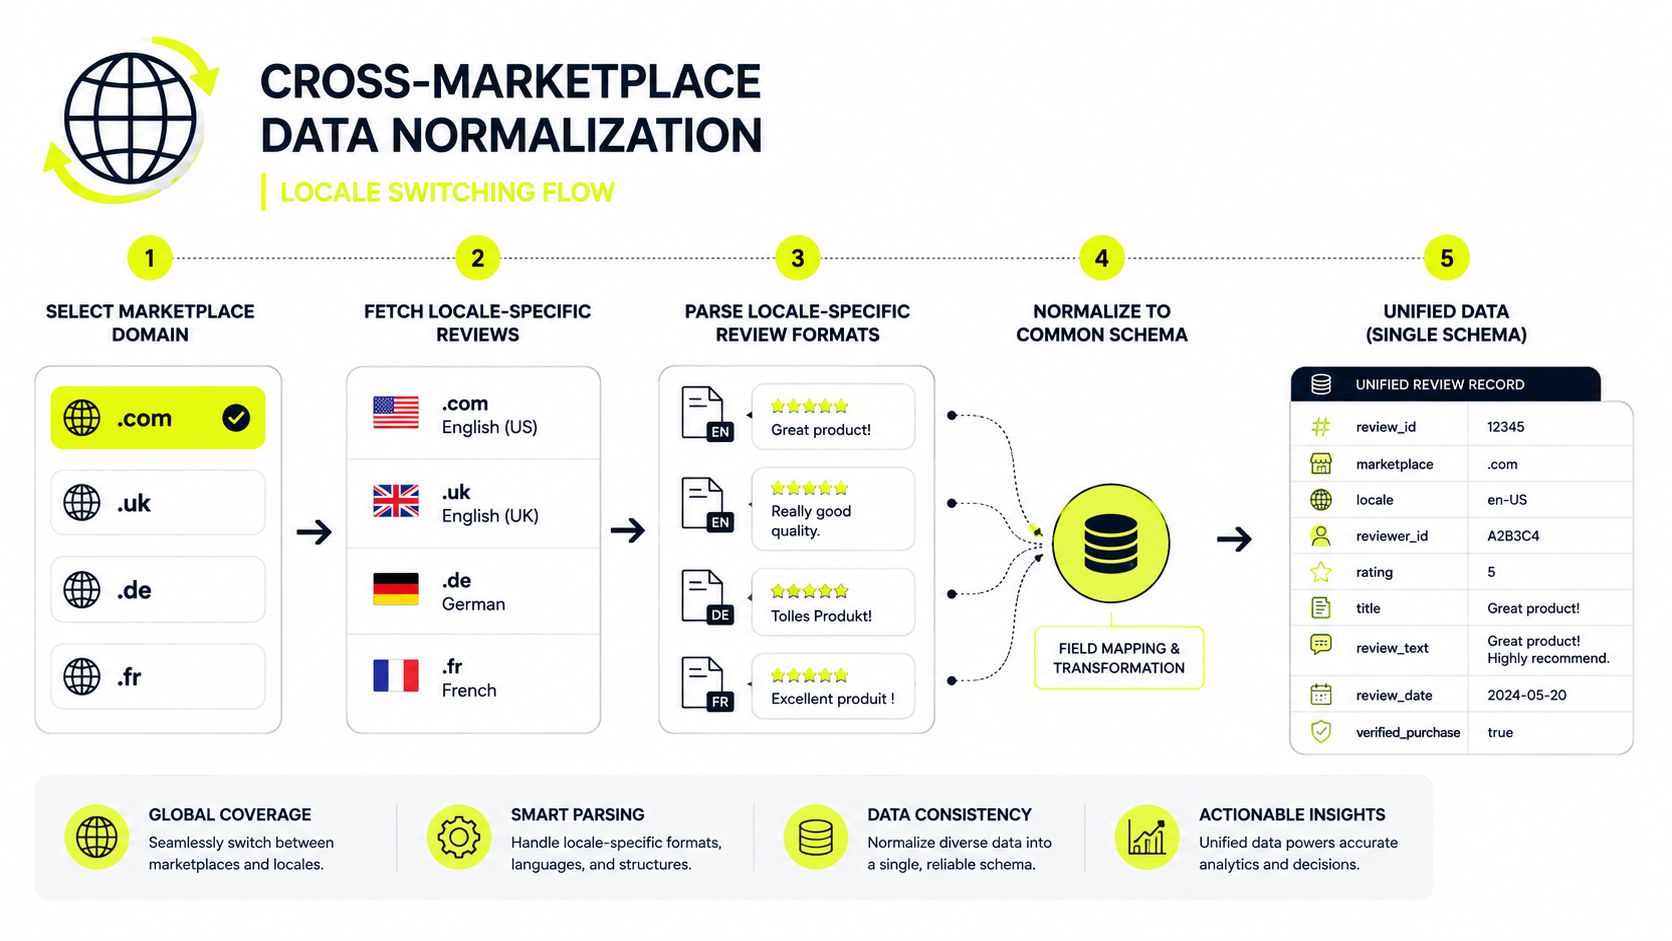
Недостаточно обсуждаемая проблема - не просто пагинация. Дело в том, что данные отзывов не пересекаются между маркетплейсами, такими как amazon.com, amazon.co.uk, amazon.fr и amazon.de, поэтому парсинг отзывов Amazon - это на самом деле множество рынок-специфичных датасетов. Реальная работа - это сегментация и нормализация рынков, а не просто скорость извлечения. Контекст кросс-маркетплейсного парсера отзывов
Паттерны пагинации, которые вы реально увидите
Страницы отзывов Amazon, как правило, демонстрируют поток номеров страниц, токен следующей страницы или ограниченный блок избранного, который ведёт себя как небольшой фиксированный список. Ваш краулер должен определить, какой паттерн присутствует, а затем двигаться по списку, не предполагая, что одна и та же структура существует на всех маркетплейсах. Это важно, потому что переключение локали может изменить не только язык, но и саму форму страницы.
Чистый слой нормализации должен отображать каждый отзыв в одну каноническую запись. Сохраняйте исходное поле локали, домен маркетплейса и оригинальную строку даты, затем нормализуйте ниже по потоку для анализа. Это предотвращает незаметное повреждение, когда один рынок форматирует даты отзывов или строки рейтинга иначе, чем другой.
Сегментация рынка превосходит сырую скорость, когда конечная цель - тестирование геотаргетированных рекламных креативов или международное ценовое исследование. Более быстрый парсинг неправильной локали всё равно даёт вам неправильный ответ.
Что должно входить в каноническую строку
- Домен маркетплейса: Разделяйте amazon.com, amazon.co.uk, amazon.fr и amazon.de на этапе приёма данных.
- Исходный текст отзыва: Храните исходный текст до перевода или обрезки.
- Метаданные локали: Сохраняйте язык и регион, чтобы аналитики могли сравнивать подобное с подобным.
- Рейтинг и даты: Нормализуйте их после приёма данных, а не во время извлечения.
- Идентификатор продукта: Привязывайте ASIN к маркетплейсу, а не как глобальный уникальный ключ.
Инженерное решение, которое избавляет от наибольшей боли - рассматривать локаль как измерение первого класса. Это позволяет одному конвейеру питать конкурентные исследования, тестирование рекламы и мониторинг бренда без смешивания рынков, которые не должны смешиваться. Если команде отчётности нужно единое представление, дайте им его, но стройте его из рынок-осведомлённых строк, а не из слитого размытия.
Юридические и этические границы, которые нельзя пересекать
Условия Amazon явные. Условия использования запрещают использование «любых роботов, пауков, парсеров или других автоматизированных средств» для доступа к сервисам Amazon без предварительного письменного разрешения, а язык политики парсинга Amazon также запрещает «интеллектуальный анализ данных, роботов, парсинг экрана или аналогичные инструменты сбора и извлечения данных». Публичные данные о продуктах, цены, рейтинги, результаты поиска и ограниченные выдержки из отзывов находятся в корзине с более низким риском, в то время как контент, защищённый логином, история заказов покупателей и Seller Central переходят в гораздо более рискованную зону по CFAA. Разбор политики парсинга Amazon
Граница, которую операторы фактически пересекают
Жёсткая граница - не то, выглядит ли страница видимой в браузере. Граница в том, нужна ли вашему парсеру стена логина, обход CAPTCHA или привилегированная сессия, чтобы продолжать работу. Как только это происходит, позиция соответствия быстро ухудшается, особенно если вы запускаете рабочий процесс через несколько учётных записей покупателей или пытаетесь использовать антидетект-браузеры, чтобы скрыть, что одна и та же команда контролирует набор сессий.
Это момент, когда командам следует замедлиться и переоценить ситуацию. Если нужные вам данные доступны как публичные фрагменты, используйте публичные фрагменты. Если вам нужен контент, требующий входа, риск и операционная нагрузка резко возрастают.
Для валидационной работы руководство о том, как проверить подлинность отзывов Amazon, полезно, потому что оно сохраняет внимание на качестве сигнала, а не просто на объёме сбора. Приём отзывов полезен только в том случае, если команда ниже по потоку может доверять тому, что она видит.
Если парсеру нужен логин для выполнения своей работы, юридический и договорной риск меняется немедленно.
Внутренняя заметка о том, является ли веб-парсинг законным, должна быть в руководстве каждой команды по отзывам. Не потому, что она даёт разрешение, а потому, что она вынуждает задать правильный вопрос рано, до того, как конвейер уже находится в продакшене и привязан к бюджету кампании.
Мониторинг, хранение и масштабирование конвейера
Конвейер отзывов ломается в скучных местах. Меняется разметка, проседают показатели успешности, подскакивает частота CAPTCHA, и команда замечает это только после того, как датасет уже устарел. Одно итоговое исследование 2026 года сообщило, что наивысший показатель успешности среди протестированных провайдеров достиг 96% для парсинга отзывов Amazon, в то время как Decodo зафиксировал показатель успешности 11% на Amazon со средним временем завершения 10 секунд на обработанных URL. Этот разброс напоминает, что защита от блокировок и логика повторных попыток важнее, чем сырой парсинг HTML. Итоговое исследование парсинга отзывов Amazon
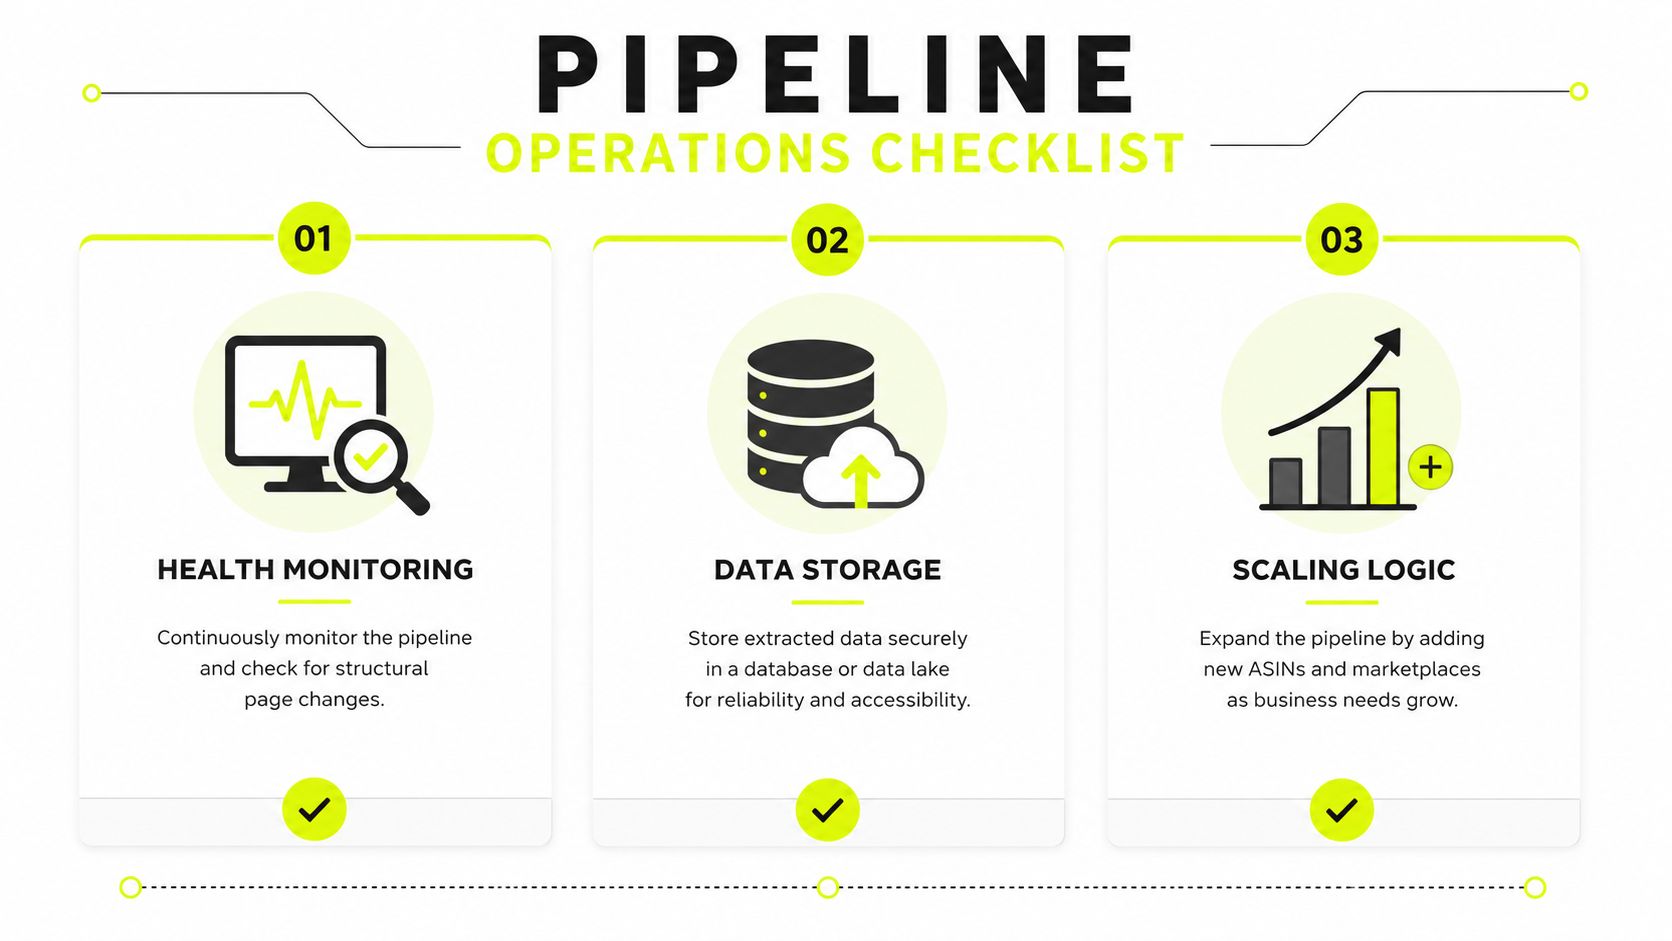
Операционный стек
Используйте Postgres для нормализованных строк отзывов, S3 для снимков сырого HTML и очередь между воркерами, чтобы повторные попытки не блокировали весь запуск. Настройте оповещения на внезапные падения успешных извлечений, всплески CAPTCHA и сдвиги в структуре страниц. Если один маркетплейс начинает отклоняться, снижайте производительность плавно, вместо того чтобы навязывать один и тот же парсер всем локалям.
Чек-лист масштабирования
- Пулы воркеров на каждый ASIN: Сохраняйте зоны отказа небольшими, чтобы один проблемный товар не отравил всю пачку.
- Региональные пулы прокси: Разделяйте трафик по маркетплейсам и локалям вместо того, чтобы смешивать всё в одном пуле.
- Структурный диффинг: Сравнивайте текущую структуру страницы с последним известным рабочим снимком, прежде чем доверять парсингу.
- Бюджеты на повторы: Ограничивайте количество повторов на ASIN, чтобы заблокированный маршрут не съел всё окно выполнения задачи.
- Резервное хранилище: Сохраняйте сырую страницу даже при ошибке парсинга, потому что парсер сможет догнать позже.
Если вам нужен пример того, как выглядит контролируемое масштабирование в среде с большими объёмами данных, кейс-стади Xr Voyage с FalkorDB показывает, как команды думают о росте без потери управляемости. Та же дисциплина применима и здесь. Держите слой сбора узким, слой хранения надёжным, а слой мониторинга достаточно шумным, чтобы замечать сбои раньше, чем это сделают клиенты.
Если вам нужен прокси-стек, созданный для пайплайнов отзывов, геотаргетированных задач и скрейпинга с чувствительностью к сессиям, Sota Proxy предоставляет вам резидентное, мобильное, ISP и дата-центровое покрытие с липкими и ротирующимися опциями, которые подходят для этого сценария. Настройте его для маркетплейса и профиля браузера, который вы уже используете, затем используйте для стабильного сбора отзывов с Amazon вместо того, чтобы целыми днями бороться с блокировками.
Похожие статьи
10 лучших прокси-сервисов для рекламы, скрейпинга и автоматизации
Сравните лучшие прокси-сервисы для проверки рекламы, скрейпинга, управления аккаунтами и геотаргетинга по типу IP, цене, надёжности и возможностям управления.
10 альтернатив Smartproxy для технических команд
Сравните 10 альтернатив Smartproxy по типу прокси, качеству IP, таргетингу, ротации, скорости, ценообразованию и сценариям использования для технических команд.
10 альтернатив IPRoyal для серьезных прокси-задач
Сравните 10 альтернатив IPRoyal для скрейпинга, верификации рекламы, фарминга аккаунтов, антидетект-браузеров, гео-кампаний, ценообразования, ротации и поддержки.
10 альтернатив Oxylabs для скрейпинга и рекламных операций
Сравните 10 альтернатив Oxylabs по типу прокси, географическому охвату, аптайму, ротации, ценам и применению для скрейпинга, верификации рекламы и фарминга аккаунтов.
Лучшие альтернативы Brightdata для прокси-команд в 2026 году
Изучите лучшие альтернативы Brightdata для скрейпинга, верификации рекламы и геотаргетированных кампаний в 2026 году, а также советы по миграции.
Достигнут лимит ресурсов: решения для прокси, серверов и API
Узнайте, как исправить ошибки достижения лимита ресурсов на прокси, серверах и API с помощью практических решений на 2026 год.