Продвинутый Node Web Scraping: Антидетект и обход блокировок 2026
Освойте node web scraping в 2026! Создавайте production-grade инструменты с ротацией прокси, обходом fingerprinting и антидетектом для высоконагруженных задач сбора данных.
Большинство советов по Node web scraping ориентировано на демо, а не на реальные операции. Скрипт, который парсит несколько страниц на вашем ноутбуке, ничего не говорит о том, выдержит ли он проверки рекламных кабинетов Facebook, парсинг рабочих процессов TikTok, пайплайны фарминга аккаунтов, аудиты клоаки или проверки геотаргетированных кампаний без сжигания IP и профилей.
Этот разрыв сейчас важен как никогда, потому что скрейпинг перестал быть побочной задачей. Прогнозируется, что мировой рынок веб-скрейпинга превысит 9 миллиардов долларов США к концу 2025 года, с ожидаемым ростом 12–15% CAGR до 2030 года, в то время как скрейпинг сэкономил компаниям примерно 30% времени, затрачиваемого на ручной сбор данных в 2024 году, согласно прогнозам рынка и эффективности веб-скрейпинга на 2025 год. Операционная проблема не в том, как выбрать DOM-узел. Проблема в том, как поддерживать стабильность извлечения, когда антибот-системы оценивают каждый запрос.
Команды арбитража трафика уже знают основы. Сложность в том, чтобы запускать Node.js-скрейперы вместе с антидетект-браузерами, такими как AdsPower, Dolphin Anty, GoLogin, Multilogin и Hidemyacc, сохраняя согласованность fingerprints, сессий, геолокаций и поведения прокси. Именно здесь большинство туториалов перестают быть полезными.
Содержание
- Node Web Scraping за рамками базовых знаний
- Архитектура вашего Node JS Scraping-инструментария
- Обход блокировок с продвинутым антидетектом
- Интеграция прокси для масштабируемых операций
- Создание надёжного и масштабируемого скрейпера
- Навигация по CAPTCHA и этическим границам
Node Web Scraping за рамками базовых знаний
Node web scraping часто упрощают. Большинство гайдов учат: запрос, парсинг, экспорт. Это нормально для страницы каталога. Всё разваливается, когда цель сопротивляется, когда ваш скрейпер делит инфраструктуру с операциями по рекламным кабинетам Facebook и TikTok, или когда антидетект-профиль должен оставаться правдоподобным на протяжении нескольких сессий.
Для операторов мультиаккаунтов скрейпинг не изолирован. Он соседствует с прогревом аккаунтов, проверками кампаний, QA лендингов, верификацией клоаки и проверкой геолокации. Сбой при запросе может потратить время байера. Несоответствие fingerprint может отравить профиль, используемый позже в AdsPower или GoLogin. Плохое назначение прокси может вызвать проблемы с проверкой на фармленном аккаунте, который вчера был стабильным.
Production-мышление отличается. Вы не спрашиваете: «Может ли этот скрипт парсить страницу?» Вы спрашиваете:
- Может ли он поддерживать согласованность поведения сессий через воркфлоу фарминга аккаунтов и управления рекламными кабинетами?
- Может ли он разделять дешёвые задачи сбора от чувствительных задач, связанных с аккаунтами, чтобы одно не загрязняло другое?
- Может ли он падать безопасно без атаки на цель или порчи ваших собственных данных?
- Может ли он оставаться правдоподобным, когда одна и та же геолокация, часовой пояс, язык и browser fingerprint должны совпадать?
Практическое правило: Если скрейпер касается инфраструктуры, которая также касается рекламных аккаунтов, обращайтесь с ним как с инфраструктурой аккаунтов, а не одноразовым скриптом.
Это означает более жёсткую изоляцию, лучшие логи и более чистую стратегию прокси. Это также означает отказ от новичковых допущений, особенно идеи, что «просто добавить Puppeteer» решает защищённые цели. Это не так. Часто это упрощает обнаружение, если браузер, TLS-поведение, часовой пояс и репутация IP не совпадают.
Многие команды обнаруживают это только после масштабирования. Затем они начинают перестраивать архитектуру вокруг пулов прокси, контролируемой параллельности и потоков запросов с учётом профиля. Если вы запускаете серьёзный сбор данных, полезно взглянуть на паттерны инфраструктуры веб-скрейпинга, используемые для крупномасштабных операций, с этой production-линзой с первого дня.
Архитектура вашего Node JS Scraping-инструментария
Выбор инструмента определяет стоимость, скорость и поверхность обнаружения. Выберите неправильный стек - и вы либо переплатите за браузеры, либо недостроите систему и попадёте под блокировки на динамических целях.
Выбирайте самый лёгкий инструмент, способный справиться с задачей
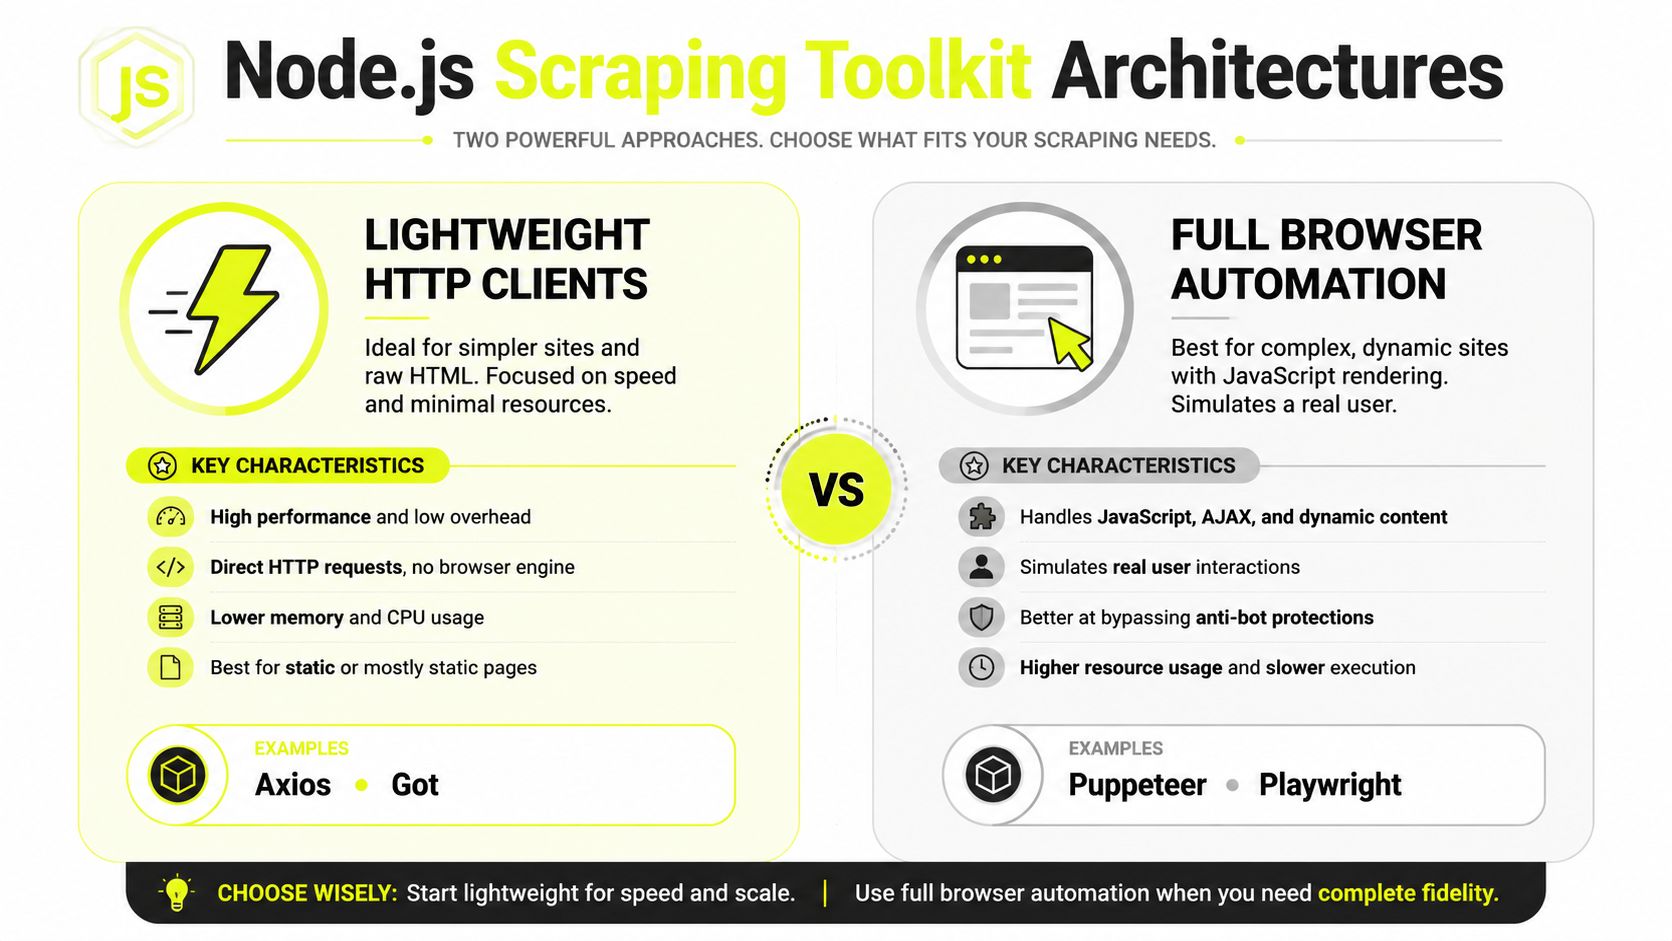
Для статических страниц, внутренних API и простых серверно-рендереных целей HTTP-клиент плюс парсер всё ещё остаются лучшим первым шагом. В Node это обычно означает Axios или Got для запросов, затем Cheerio для извлечения.
Этот стек хорошо работает, когда вам нужна чистая скорость и низкое использование RAM. Он идеален для задач вроде:
- Проверки лендингов в разных геолокациях
- Сбора библиотеки объявлений, где данные находятся в предсказуемом HTML или доступных API
- Мониторинга цен или офферов для арбитражных сравнений
- Верификации клоаки на простых редирект-цепочках
Преимущество операционное. Вы можете запускать больше воркеров на машину, удерживать накладные расходы на запросы низкими и отлаживать на HTTP-слое без шума браузера. Для команд трафика это важно, когда вам нужно много дешёвых проверок, а не идеальный рендеринг.
Но у этого пути есть ограничения. Он не выполняет клиентский JavaScript. Он не ведёт себя как полноценный браузер. Он не будет нести реалистичное состояние браузера, если вы сами не построите значительную часть этого поведения.
Когда автоматизация браузеров перестаёт быть опциональной
Playwright и Puppeteer становятся необходимы, когда цель - это приложение с интенсивным использованием JavaScript, или когда состояние страницы появляется только после рендеринга и взаимодействия. Социальные платформы, рекламные панели, ecommerce SPA и потоки с мощной антибот-защитой обычно попадают сюда.
Многие команды переоценивают Puppeteer. Запуск Chromium - это не то же самое, что слияние с толпой. Согласно анализу инструментов и архитектур для скрейпинга защищённых сайтов, headless-браузеры вроде Puppeteer часто недостаточны для современных целей, использующих canvas fingerprinting и AI-driven обнаружение ботов, которые составляют 73% корпоративных сбоев скрейпинга в 2025 году, в то время как serverless-автоматизация браузеров может достичь 94% успеха против защищённых сайтов.
Это не делает Playwright или Puppeteer бесполезными. Это означает, что вам нужно относиться к ним как к движкам выполнения, а не к решениям для стелс-режима.
Практичное разделение выглядит так:
- Axios или Got плюс Cheerio для сбора, ориентированного на скорость
- Playwright, когда вам нужен более сильный контроль над современными потоками приложений
- Puppeteer, когда ваш стек зависит от Chromium-специфического инструментария или существующих стелс-экосистем
- Serverless-автоматизация браузеров, когда накладные расходы на управление флотом браузеров начинают съедать время команды
Где место serverless-браузерам
Управляемые браузерные платформы имеют смысл, когда ваше узкое место - не парсинг. Это операции. Падения браузера, устаревшие стелс-патчи, сломанные CAPTCHA-потоки и баги несоответствия прокси-браузеров съедают больше времени, чем сама логика извлечения.
Для рекламных операций главная ценность - это согласованность. Управляемый браузерный слой может поддерживать версии Chrome, среды выполнения, ротацию прокси и обработку челленджей более стабильно, чем кастомный флот, склеенный под давлением дедлайнов.
Headless-автоматизация - это инструмент рендеринга. Антидетект по-прежнему зависит от согласованности fingerprint, выравнивания геолокации и качества прокси.
Если вы строите внутренний стек, сохраняйте его модульным. Используйте один слой запросов, один слой парсера, один слой браузера и один слой сессий. Не встраивайте всё жёстко в один скрипт. Это упрощает замену HTTP-клиентов на браузеры только там, где это необходимо, и упрощает подключение вашего скрейпера с Node.js-интеграциями с поддержкой прокси, созданными для автоматизационных рабочих нагрузок, когда маршрутизация запросов становится более сложной.
Обход блокировок с продвинутым антидетектом
Базовые туториалы всё ещё продвигают ротацию user-agent, как будто этого достаточно. Это не так. Серьёзные цели оценивают полный fingerprint, а не один заголовок.
User-agents - это простая часть
Изменение User-Agent помогает, только когда всё остальное вокруг него имеет смысл. Если ваш браузер говорит одно, ваше TLS-рукопожатие говорит другое, а ваш прокси выходит из страны, которая не соответствует часовому поясу и языку браузера, запрос выглядит фальшивым ещё до того, как страница закончит загружаться.
Это очень важно для операторов, использующих AdsPower, Dolphin Anty, GoLogin, Multilogin или Hidemyacc. Эти инструменты существуют для поддержания согласованности профиля. Если ваш Node-скрейпер питает или отражает активность вокруг этих профилей, он должен соблюдать те же правила согласованности.
Распространённые ошибки предсказуемы:
- Дрифт заголовков, такой как
accept-language, не соответствующий геолокации - Несоответствие часового пояса между профилем браузера и выходом прокси
- Несоответствие viewport и платформы, которое не совпадает с заявленным устройством
- TLS-несоответствие, когда стек запросов раскрывает небраузерное рукопожатие
- Загрязнение сессий, когда один пул прокси обслуживает задачи с разными требованиями доверия
Соответствуйте профилю, а не только IP
Критический нюанс, упускаемый большинством гайдов, - это несоответствие TLS и browser fingerprint. Согласно отраслевым данным о сбоях скрейперов, связанных с несогласованностью fingerprint, 68% неудавшихся скрейперов блокируются из-за несоответствий TLS-рукопожатия или часовых поясов между прокси и браузером, и игнорирование этого приводит к на 30–40% более высоким показателям блокировок.
Если вы скрейпите в контексте управления рекламными кабинетами, это не академично. Facebook и TikTok оценивают не один сигнал. Они коррелируют многие. Аккаунт, открытый через резидентский прокси в одном регионе, а затем парсимый через Node-клиент с несовпадающей локалью и TLS-признаками, создаёт избыточный риск.
Антибот-системе всё равно, что ваш CSS-селектор корректен. Ей важно, выглядит ли ваш стек запросов как настоящий браузер, привязанный к настоящему пользователю в настоящем месте.
Это меняет выбор реализации. Иногда сырой HTTP-запрос безопаснее, потому что он не раскрывает сломанные headless-артефакты. Иногда полный браузер безопаснее, потому что цель ожидает браузерного поведения и оценивает TLS. Неправильный выбор не просто менее эффективен. Он приводит к блокировкам быстрее.
Как операторы сохраняют согласованность fingerprints
Для чувствительных задач сохраняйте согласованность стека на этих слоях:
Сетевая идентичность
Геолокация прокси, тип ASN и длительность сессии должны соответствовать целевому действию. Фарминг аккаунтов и повторный доступ к рекламным кабинетам требуют стабильных сессий. Широкие задачи сбора требуют более широкой ротации.Идентичность браузера
Сопоставьте часовой пояс, язык, метрики экрана, подсказки платформы и сборку браузера с профилем. Если антидетект-браузерный профиль говорит Берлин, не позволяйте скрейперу объявлять майамское время.Идентичность запроса
Сохраняйте заголовки внутренне согласованными. Значенияaccept-language,sec-ch-ua, поведение кодирования и паттерны навигации должны соответствовать семейству браузера, которое вы имитируете.Идентичность взаимодействия
Не запускайте идеальные интервалы, идентичные пути кликов или невозможные последовательности страниц. Особенно на рабочих процессах, чувствительных к проверкам.
Часто многие команды начинают использовать клиенты с учётом fingerprint или управляемые браузерные слои вместо того, чтобы навешивать больше стелс-плагинов на Puppeteer.
Короткая демонстрация помогает обозначить разницу между общей автоматизацией браузера и трафиком, напоминающим стабильную браузерную сессию:
Если IP-баны уже вредят вашим задачам, практические тактики избежания IP-банов для автоматизационных стеков обычно важнее, чем очередная переписка парсера. Блокировки - это часто инфраструктурные сбои, замаскированные под проблемы приложения.
Интеграция прокси для масштабируемых операций
Прокси - это не коммодитная надстройка. Они определяют доверие, поведение сессий и юнит-экономику. Если вы скрейпите данные для управления рекламными кабинетами, фарминга аккаунтов, проверок клоаки или геотаргетированных кампаний, выбор прокси меняет то, что вы можете делать безопасно.
По мере того как контроль антискрейпинга становится стандартом, прокси стали обязательным условием для крупномасштабного скрейпинга, и анализ рынка веб-скрейпинга от Mordor Intelligence сообщает, что Северная Америка лидировала с 34,08% доли рынка в 2025 году, в то время как прогнозируется самый быстрый рост в Азиатско-Тихоокеанском регионе. Это расширение рынка отслеживает то, что операторы уже видят. Каждый серьёзный стек теперь рассматривает маршрутизацию и IP-стратегию как основную инфраструктуру.
Выбор прокси меняет результат
Датацентровые, резидентские, мобильные и IPv6-прокси решают не одну и ту же проблему.
Датацентровые прокси быстрые и дешёвые. Они хороши для высоконагруженных задач на целях с низкой чувствительностью. Публичные страницы, лёгкий краулинг, агрегация офферов или первичные проверки, где индивидуальное доверие запроса не так важно. Они также первыми попадают под флаги на более строгих платформах.
Резидентские прокси маршрутизируются через потребительское IP-пространство. Они стоят дороже, но лучше сливаются на платформах, которые заботятся о репутации и поведенческой согласованности. Обычно они являются дефолтом для скрейпинга, смежного с логинами, проверок рекламных кабинетов и повторного доступа, привязанного к одной сессии.
Мобильные прокси - это то, что команды резервируют для более сложных поверхностей. На чувствительных социальных целях мобильное доверие полезно, потому что паттерн трафика напоминает реальный трафик оператора связи и поведение общей мобильной сети. Они медленнее и дороже, поэтому тратить их на лёгкие задачи - плохая операционка.
IPv6-прокси могут быть полезны для масштаба и экономической эффективности, когда цель чисто принимает IPv6-трафик. Они не универсальный обход. Некоторые цели плохо обрабатывают IPv6, некоторые флагируют его быстрее, и многие чувствительные к аккаунтам рабочие процессы по-прежнему ведут себя лучше на тщательно выбранных IPv4-based резидентских или мобильных маршрутах.
Сравнение типов прокси для Node.js Scraping
| Тип прокси | Лучший сценарий использования | Анонимность/Доверие | Стоимость |
|---|---|---|---|
| Датацентровые | Высоконагруженный сбор на целях с низкой чувствительностью, широкий краулинг, простой мониторинг | Низкое доверие на защищённых платформах | Низкая |
| Резидентские | Скрейпинг, связанный с аккаунтами Facebook и TikTok, геопроверки, повторные сессии, валидация клоаки | Высокое доверие для потребительского трафика | Средняя - высокая |
| Мобильные | Сложные социальные цели, фарминг аккаунтов, действия, чувствительные к проверке, сложные геолокации | Очень высокое доверие | Высокая |
| IPv6 | Экономичный масштаб, где цель хорошо поддерживает IPv6, задачи широкого распределения | Зависит от цели и реализации | Низкая - средняя |
Многие сбои происходят из-за использования одного класса прокси для всего. Это не выдерживает в production. Датацентр для bulk. Резидентские для непрерывности сессий. Мобильные для сложных краевых случаев. IPv6, где цель это терпит.
Дешёвые прокси становятся дорогими, когда они сжигают прогретые профили или заставляют вручную восстанавливать рекламные аккаунты.
Практичный паттерн прокси для Node.js
В Node.js держите обработку прокси вне вашей бизнес-логики. Вашему парсеру не должно быть дела, какой пул обслужил запрос. Постройте фабрику запросов, которая принимает целевой профиль, уровень риска и политику сессии, затем выбирает правильный пул.
Минимальный паттерн выглядит так:
import got from 'got';
import { HttpsProxyAgent } from 'https-proxy-agent';

function buildClient({ username, password, host, port }) {
  const proxyUrl = `http://${username}:${password}@${host}:${port}`;
  const agent = new HttpsProxyAgent(proxyUrl);

  return got.extend({
    agent: {
      http: agent,
      https: agent
    },
    timeout: {
      request: 30000
    },
    retry: {
      limit: 0
    },
    headers: {
      'accept-language': 'en-US,en;q=0.9'
    }
  });
}

const client = buildClient({
  username: process.env.PROXY_USER,
  password: process.env.PROXY_PASS,
  host: process.env.PROXY_HOST,
  port: process.env.PROXY_PORT
});

const html = await client.get('https://example.com').text();
console.log(html.slice(0, 200));
Этот пример намеренно простой. В production добавьте теги сессий, выбор геолокации, наборы заголовков для каждой цели и логирование того, какой пул обслужил какой запрос. Так вы отслеживаете сбои без догадок.
Для контроля ротации команды обычно разделяют политику по задачам:
- Ротирующиеся сессии для сбора на уровне страниц, где каждый запрос может приходить с нового IP
- Sticky-сессии для потоков логина, многошаговых форм, действий фарминга аккаунтов и браузерных сессий, которые должны выглядеть непрерывными
- Геопривязанные сессии для проверок предпросмотра рекламы и валидации локальных лендингов
- Изоляция пулов, чтобы работа с аккаунтами TikTok не делила поведение выхода с широкими задачами скрейпинга
Ротация и sticky-сессии для работы с аккаунтами
Ротация не всегда лучше. Для операций с аккаунтами Facebook и TikTok постоянная смена IP может выглядеть хуже, чем стабильная сессия. Прогретому аккаунту часто нужна правдоподобная, постоянная сетевая идентичность. Для широкого скрейпинга верно обратное. Повторное использование одного и того же IP слишком долго увеличивает баны и троттлинг.
Это операционное разделение - причина, по которой команды сопоставляют политику прокси с рабочим процессом, а не с кодовой базой. Один и тот же Node-проект может использовать один маршрут для публичного сбора, другой для браузерных действий, связанных с аккаунтом, и ещё один для геотаргетированных проверок рекламы.
Если вы управляете настройками для клиентов или других байеров, прокси-инфраструктура также может стать частью вашего доходного стека. Некоторые провайдеры запускают партнёрские программы. Sota Proxy, например, предлагает реферальную и партнёрскую программу с комиссией до 40%. Это актуально для агентств и операторов, которые уже консультируют клиентов по выбору и маршрутизации прокси.
Что касается механики ротирующих пулов и постоянства сессий, паттерны ротации прокси IP для автоматизации и скрейпинга более полезны, чем общие советы «используйте прокси». Политика маршрутизации - это стратегия.
Создание надёжного и масштабируемого скрейпера
Production-скрейперы сначала падают по мелочам. Несколько пустых страниц. Парсер, который молча возвращает ноль строк. Цикл повтора, который продолжает бить по одному и тому же сломанному маршруту. Если вы не инструментируете это рано, задача выглядит здоровой, пока данные деградируют.
Начинайте медленнее, чем хотите
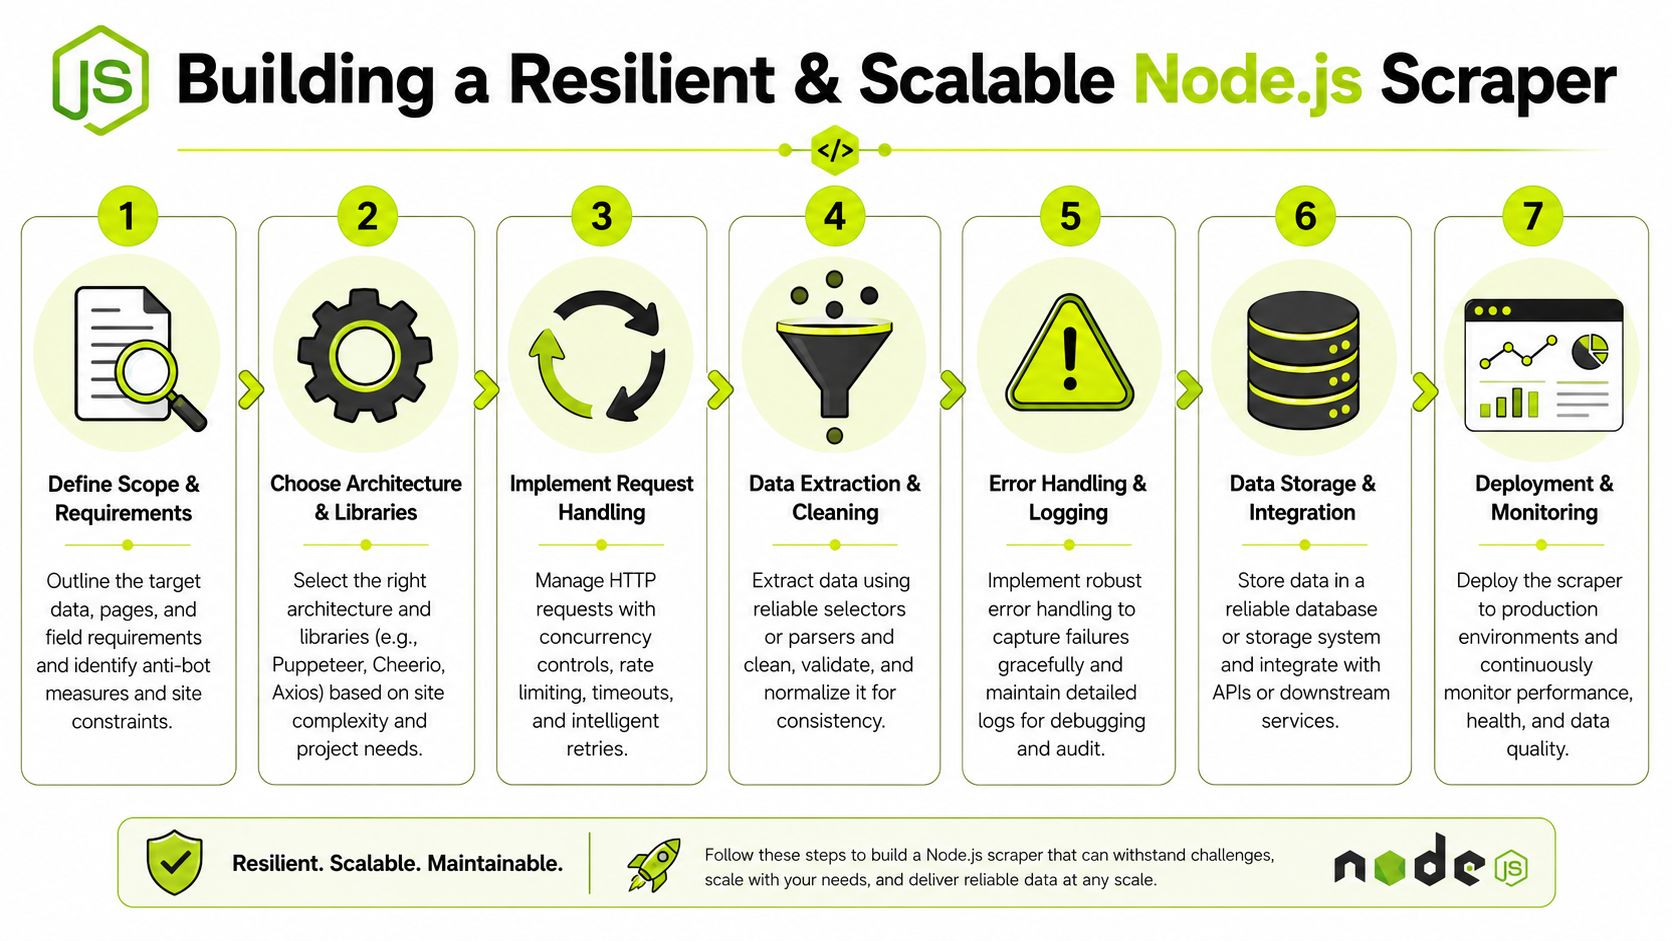
Наиболее эффективная методология Node.js-скрейпинга начинается с низкой параллельности, измеряет успешность выборки и парсера, а затем увеличивает нагрузку только после подтверждения стабильности, согласно практическому руководству по скрейпингу на Node от Context. Это правильная позиция для высоконагруженных работ, потому что сбой под нагрузкой часто скрывает, является ли проблема дрейфом парсера, транспортным сбоем или блокировкой.
Начните с ограниченной параллельности на хост. Не глобальной параллельности. На хост. Именно это не даёт одной шумной цели захватить процесс.
Полезные метрики включают:
- Успешность выборки для видимости состояния транспорта
- Успешность парсера для отлова дрейфа разметки
- Записи на страницу, чтобы частичные сбои не выглядели нормально
- Частота дубликатов для обнаружения проблем пагинации или маршрутизации
- P95 задержка выборки для выявления деградировавших пулов до их коллапса
Сохраняйте артефакты ошибок каждый раз
Когда скрейпер ломается, сохраняйте сырой HTML до того, как трогать парсер. Эта одна привычка устраняет часы догадок. Вы можете проверить, изменилась ли страница, появилась ли страница челленджа или прокси вернул что-то неожиданное.
Чистый рабочий процесс сбоев выглядит так:
- Запрос падает или парсер возвращает ноль записей.
- Сохраните сырое тело ответа с временной меткой, целью, меткой пула прокси и тегом сессии.
- Захватите заголовки ответа и финальный URL после редиректов.
- Оповестите о повторных страницах с нулевыми записями до повтора с повышенной сложностью.
- Только потом решайте, добавлять ли рендеринг браузера или другой класс прокси.
Сохраните страницу, которая упала, а не предположение о том, почему она упала.
Повторы тоже важны, но им нужен смысл. Используйте backoff. Ограничьте попытки. Разделяйте повторяемые ошибки от постоянных. 429, таймаут или временная проблема шлюза заслуживают новой попытки. Сломанный селектор - нет.
Мониторьте то, что реально ломается
Надёжный скрейпер действует больше как сервис, чем как скрипт. У него есть очереди, логи, метрики и слой постоянства, выбранный под размер задачи.
Для хранения сохраняйте простоту, когда задача небольшая. JSONL или CSV подойдут для разовых сборов и отладки. Переходите на PostgreSQL или MongoDB, когда вам нужны дедупликация, перепроцессинг, джойны или downstream-отчётность для медиабайеров.
Практичный чеклист для развёртывания Node web scraping:
- Дисциплина очередей, чтобы задачи не вырывались за пределы лимитов хоста
- Конфиг на цель для заголовков, логики парсера и правил повторов
- Структурированное логирование с ID задачи, ID сессии, целью и меткой прокси
- Оповещения о нулевых записях, потому что молчаливые блокировки опаснее жёстких ошибок
- Захват фикстур для упавших страниц
- Путь перепроцессинга, чтобы исправления парсера не требовали полного пересбора
Используйте отдельных воркеров для браузерных задач и задач с простым HTTP. Смешайте их - и вы создадите шумную задержку, нестабильное использование памяти и более сложную отладку. Браузерная сторона должна быть дорогой и намеренной. HTTP-сторона должна быть быстрой и одноразовой.
Навигация по CAPTCHA и этическим границам
CAPTCHA обычно симптом, а не корневая проблема. Если цель продолжает бросать вам вызов, первое исправление - лучшее качество трафика. Более чистый резидентский или мобильный маршрутинг, согласованные fingerprints и менее агрессивное поведение снижают частоту челленджей эффективнее, чем забрасывание решателями каждой страницы.
Когда челленджи всё же блокируют необходимый поток, команды обычно подключают сервисы решателей, такие как 2Captcha или Anti-CAPTCHA, через API-вызовы. Это решение о стоимости столько же, сколько о технике. Для фарминга аккаунтов и рекламных воркфлоу решатель может поддерживать движение задачи, но он не восстановит сломанный fingerprint или грязную сессию.
Что касается данных, плохая инфраструктура может тонко портить вывод. Согласно отчётности о точности скрейпинга и качестве инфраструктуры, более 27% парсенных данных дублируются, неполны или неточны из-за плохой маршрутизации запросов и непроверенной прокси-инфраструктуры. Это реальный бизнес-риск. Вы думаете, что скрейпер сработал. Датасет говорит иначе.
Юридические и этические границы тоже являются операционными вопросами. Проверьте Условия использования цели. Прочитайте robots.txt, даже если это не окончательный юридический авторитет. Держите параллельность достаточно низкой, чтобы не влиять на производительность сайта. Вытягивайте только публичные данные, которые вам нужны. Если ваш стек начинает вызывать всплески нагрузки, циклы челленджей или сопутствующий ущерб для обычных пользователей, вы запускаете плохую операцию.
Для команд, которые часто попадают на страницы челленджей, помогает сохранять общий словарь по типам CAPTCHA и решениям рабочих процессов обхода, чтобы инженеры, байеры и менеджеры аккаунтов обсуждали один и тот же режим сбоя.
Если вы запускаете задачи скрейпинга, связанные с рекламными операциями, фармингом аккаунтов, геопроверками или высокорисковой автоматизацией, Sota Proxy создан для такого рода рабочих нагрузок. Он предоставляет командам доступ к резидентским, мобильным, ISP, датацентровым и IPv6-пулам с широким геопокрытием, с контролем ротации и sticky-сессий, которые соответствуют реальным операторским рабочим процессам, а не игрушечным скриптам.
Похожие статьи
Reddit «Вы заблокированы сетевой безопасностью»: все причины и решения для каждой
Это не бан, и обжаловать нечего. Блокировка исходит от пограничной инфраструктуры Reddit, применяется к вашему подключению и имеет шесть причин. Вот как определить, какая из них у вас, и как долго длится каждая.
Сколько аккаунтов Discord можно иметь в 2026 году (на email, на телефон, на устройство)
Discord не публикует ограничений на количество аккаунтов. Реальные лимиты: один на email, один номер телефона одновременно без VOIP и пять в переключателе аккаунтов, что Discord может применять глобально.
Telegram-автоматизация с Telegram Expert: что делать, если задача остановилась на середине
Сколько аккаунтов Reddit можно иметь в 2026 году (ограничения по карме, баны, блокировки сетевой безопасности)
Reddit разрешает иметь несколько аккаунтов напрямую. Что вас останавливает - это ограничения по карме, качество участника, лимиты частоты запросов и одно строгое правило о голосовании, плюс три типа банов, как каждый обжалуется, и почему «заблокировано службой сетевой безопасности» - это не один из них.
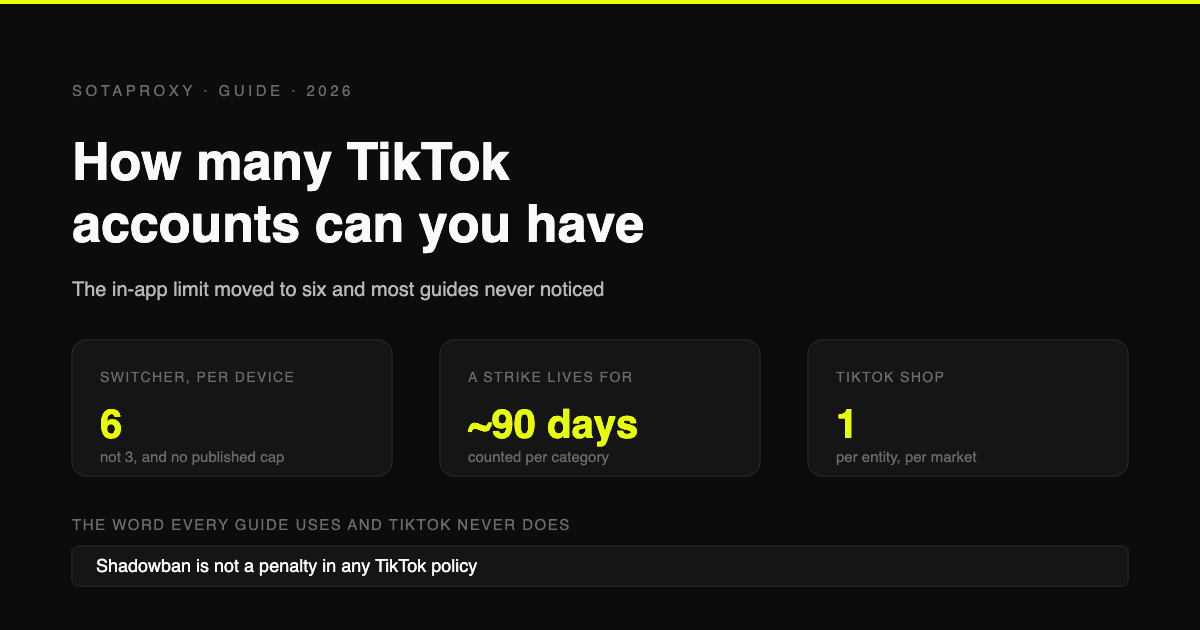
Сколько аккаунтов TikTok можно иметь в 2026 году (лимиты, страйки и правила Shop)
Шесть аккаунтов на устройство, а не три, и без официального ограничения. Правила, которые реально определяют выживание: лимиты действий в зависимости от возраста аккаунта, как истекают страйки, что на самом деле такое shadowban и один Shop на бизнес-субъект на рынок.
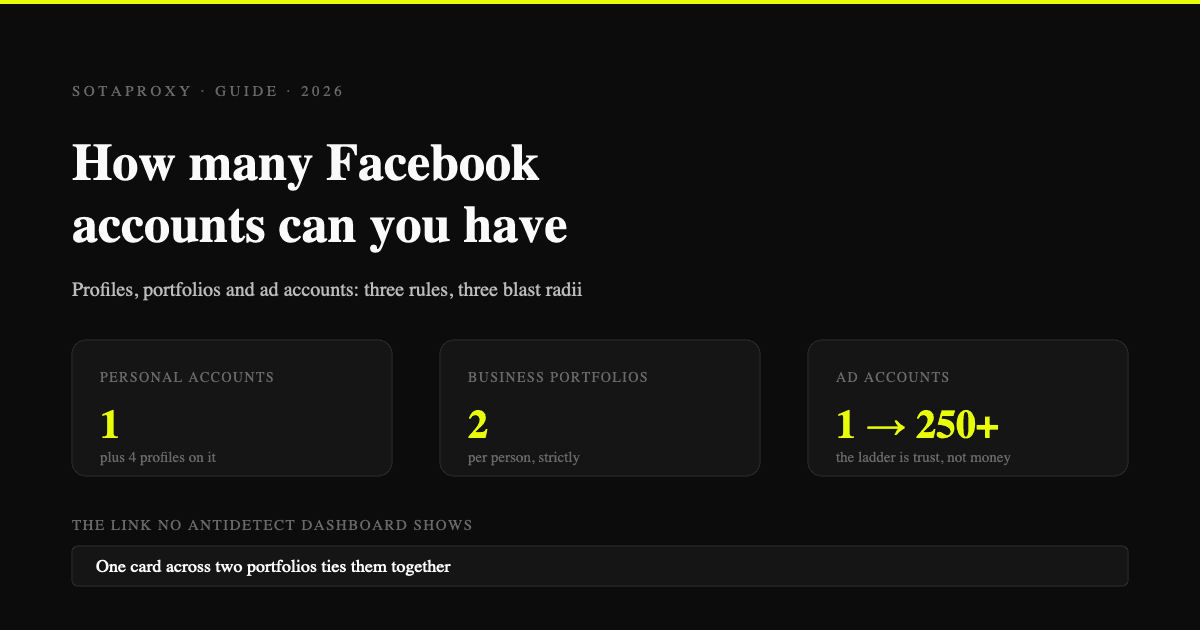
Сколько аккаунтов Facebook можно иметь в 2026 году (профили, портфолио, рекламные кабинеты)
Один личный аккаунт, четыре дополнительных профиля с общими мерами модерации, два бизнес-портфолио на человека и лимит рекламных кабинетов, который растёт с доверием. Что реально ограничивается и в каком порядке.