Веб-скрапінг на PHP: Посібник для операторів та арбітражників
Створюйте надійних ботів для веб-скрапінгу на PHP для мульти-акаунтингу, верифікації реклами та клоакінгу. Навчіться обробляти JS, ротувати проксі та уникати блокувань. Для операторів.
Ваш PHP-скрапер, ймовірно, добре працював на тестовому сайті. Потім ви спрямували його на реальну ціль, що використовується для верифікації реклами, моніторингу конкурентів, перевірок клоакінгу або фармінгу акаунтів, і він розвалився. Ви отримали сторінку відмови в доступі, напівзавантажену розмітку, порожні вузли або фальшиву відповідь про успіх із непотрібним HTML.
Ця прогалина є місцем, де більшість посібників перестають бути корисними. Реальні оператори, які скрапують посадкові сторінки, партнерські воронки, вітрини магазинів, поверхні реклами Facebook або сторінки креативів TikTok, потребують не лише селекторів. Їм потрібен робочий процес, який витримує рендеринг JavaScript, ротацію проксі, перевірки відбитків браузера, геотаргетовані відповіді та обмеження швидкості. Якщо ви проводите кампанії через кілька рекламних акаунтів у AdsPower, Dolphin Anty, GoLogin, Multilogin або Hidemyacc, ваш скрапер є частиною того ж самого інфраструктурного стека. Він повинен поводитися відповідно.
Зміст
- Чому ваш базовий PHP-скрапер не працює
- Вибір інструментарію для PHP-скрапінгу
- Побудова основної логіки скрапінгу
- Обробка сайтів, керованих JavaScript
- Інтеграція проксі для обходу блокувань та геотаргетингу
- Просунутий обхід та протидія антиботам
- Масштабування PHP-операцій скрапінгу
Чому ваш базовий PHP-скрапер не працює
Звичайний виклик file_get_contents() працює на сайтах, які віддають основний вміст у першій HTML-відповіді. Це все ще існує, але це не те середовище, в якому працює більшість команд медіабаїнгу. Коли ви вперше скрапите ціль, пов'язану з рекламними акаунтами Facebook, рекламними акаунтами TikTok, процесами фармінгу акаунтів або геотаргетованими вітринами, ви стикаєтеся з системами, призначеними для швидкої класифікації трафіку.
Патерн відмови передбачуваний. Ваш скрипт завантажує сторінку і отримує одне з чотирьох: сторінку виклику, неповний HTML, локалізований варіант, якого ви не очікували, або розмітку, яка має сенс лише після виконання клієнтського JavaScript. Скрапер не зламаний. Зламані ваші припущення.
Базовий код завантаження та парсингу не працює, тому що сучасні цілі не просто віддають сторінки. Вони оцінюють патерни запитів, репутацію IP, заголовки, куки, поведінку сесії, а іноді й повне середовище браузера.
Це важливо для команд арбітражу. Якщо ви перевіряєте заклоаковані сторінки, валідуєте розміщення реклами або моніторите доступність офферів за географією, неправильна відповідь гірша за відсутність відповіді. Вона отруює ваші дані та веде до поганих рішень щодо розподілу бюджету.
Що ламається першим у продакшені
- Контент, відрендерений JavaScript, відображається порожнім у PHP, тому що стандартний парсинг DOM не виконує клієнтський код.
- Перевірки ідентичності позначають очевидний бот-трафік. Голий запит зі слабкими заголовками та шумним IP дата-центру помічається швидко.
- Геоперевірки повертають неправильну версію для ринку, що руйнує локальні ціни, мову та перевірки відповідності.
- Потоки, залежні від сесії, ламаються, якщо ви не зберігаєте куки або не слідуєте тим самим переходам стану, що й браузер.
Якщо ви використовуєте мульти-акаунтні налаштування в GoLogin, AdsPower, Dolphin Anty, Multilogin або Hidemyacc, ви вже знаєте, що ідентичність багатошарова. Скрапер, який ігнорує цей шар, не протримається довго.
Вибір інструментарію для PHP-скрапінгу
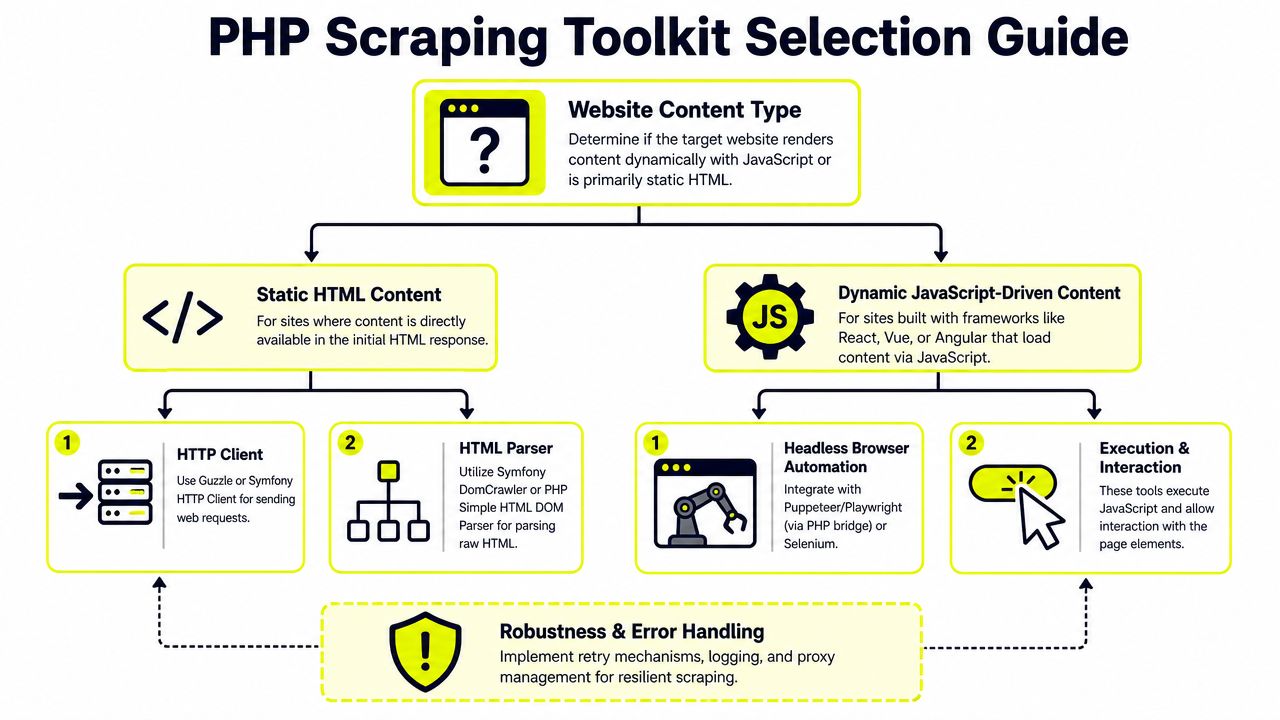
PHP-скрапінг перетворився на компонентний стек замість однієї магічної бібліотеки. На практиці веб-скрапінг з PHP працює найкраще, коли ви розділяєте роботу на обробку запитів, парсинг та виконання браузера за потреби. Цей перехід від застарілих універсальних інструментів, таких як Goutte, до підтримуваних компонентів, таких як BrowserKit та DomCrawler, задокументовано в огляді Firecrawl сучасних стеків PHP-скрапінгу.
Статичні цілі потребують чіткого розділення
Для статичних сторінок тримайте стек простим.
Використовуйте HTTP-клієнт для завантаження сторінки. Використовуйте парсер для витягування даних. Не змішуйте ці завдання, якщо ви не пишете одноразовий скрипт. Надійні комбінації в екосистемі PHP добре відомі:
- Guzzle для запитів, коли потрібні заголовки, куки, таймаути, повтори та підтримка проксі.
file_get_contents(), коли завдання невелике і ви контролюєте середовище.- DOMDocument та DOMXPath, коли ви хочете обійтися без додаткових залежностей парсера.
- Symfony DomCrawler, коли потрібен чистіший API для обходу та краща довгострокова підтримка.
- Roach PHP, коли завдання більше схоже на обхід, ніж на одиночне завантаження.
Що використовувати і від чого відмовитися
Якби я зараз збирав стек для скрапінгу для команди медіабаїнгу, я б не почав зі старих зручних обгорток. Я б використав Guzzle + DomCrawler для більшості статичних цілей і додав би автоматизацію браузера лише після доведення, що ціль її потребує.
Ось практична розбивка:
| Інструмент | Використовуйте для | Сильні сторони | Слабкі місця |
|---|---|---|---|
| Guzzle | HTTP-запити | Заголовки, куки, конфігурація проксі, контроль запитів | Не парсить HTML |
| DOMDocument + DOMXPath | Нативний парсинг | Вбудовано в PHP, добре працює з XPath | Багатослівний |
| Symfony DomCrawler | Структурований парсинг | Чистіший обхід, добре інтегрується зі стеком Symfony | Все ще тільки статичний парсинг |
| Roach PHP | Великі робочі процеси обходу | Павуки, конвеєри, middleware, планування | Більше налаштувань, ніж для однофайлового скрапера |
| BrowserKit + DomCrawler | Імітація потоку браузера на статичних сайтах | Форми, посилання, патерни краулера | Без виконання клієнтського JS |
Багато старих посібників все ще згадують Goutte. Не будуйте нову роботу навколо нього. Ця бібліотека вважається застарілою в нових посібниках з PHP-скрапінгу, а підтримуваний шлях - це стек Symfony BrowserKit плюс DomCrawler.
Практичне правило: Обирайте найлегший інструмент, який підходить до цілі. Якщо HTML-відповідь містить дані, не запускайте браузер. Якщо відповідь не містить даних, жоден парсер вас не врятує.
Для випадків використання в арбітражі цей вибір має значення. Простий монітор сторінки продукту для перевірок клоакінгу може добре працювати на Guzzle. Потік посадкової сторінки TikTok з відрендереними елементами, локалізацією та воротами взаємодії - ні.
Побудова основної логіки скрапінгу
Для статичних цілей основний конвеєр простий: надішліть GET-запит, розпарсіть HTML, витягніть за допомогою селекторів, потім обережно рухайтеся по пагінації. Цей точний робочий процес показано в посібнику з PHP-скрапінгу від FreeCodeCamp з loadHTML(), DOMXPath, витягуванням на основі селекторів, sleep(1) та темпом повторів.
Базовий скрапер, який витримує навантаження
Почніть з Guzzle для запиту. Потім парсьте за допомогою нативних DOM-інструментів або DomCrawler. Нативного шляху достатньо для багатьох завдань:
<?php

require 'vendor/autoload.php';

use GuzzleHttp\Client;

$client = new Client([
    'timeout' => 20,
    'headers' => [
        'User-Agent' => 'Mozilla/5.0',
        'Accept-Language' => 'en-US,en;q=0.9',
    ],
]);

$response = $client->request('GET', 'https://example.com');
$html = (string) $response->getBody();

libxml_use_internal_errors(true);

$doc = new DOMDocument();
$doc->loadHTML($html);

$xpath = new DOMXPath($doc);

$items = $xpath->query('//article');
foreach ($items as $item) {
    $titleNode = $xpath->query('.//h2', $item)->item(0);
    $priceNode = $xpath->query('.//*[contains(@class, "price")]', $item)->item(0);

    $title = $titleNode ? trim($titleNode->textContent) : null;
    $price = $priceNode ? trim($priceNode->textContent) : null;

    if ($title || $price) {
        print_r([
            'title' => $title,
            'price' => $price,
        ]);
    }
}
Рядок libxml_use_internal_errors(true) не є косметичним. Реальні сторінки часто містять неправильно сформовану розмітку. Без нього loadHTML() може переповнити логи або зламатися способами, які витрачають час під час довгих запусків.
Багато команд пропускають це і виявляють проблему лише після аварії парсера під час вікна обходу.
Пагінація без поведінки флудера
Пагінація - це місце, де початкові скрипти стають операційним ризиком. Поширений патерн - або визначити формат URL сторінки, або слідувати за наступним посиланням. Обидва працюють. Важливі темп, поведінка повтору та можливість відновлення.
Використовуйте щось подібне:
<?php

$nextUrl = 'https://example.com/page/1';
$failed = [];

while ($nextUrl) {
    try {
        $response = $client->request('GET', $nextUrl);
        $html = (string) $response->getBody();

        libxml_use_internal_errors(true);
        $doc = new DOMDocument();
        $doc->loadHTML($html);
        $xpath = new DOMXPath($doc);

        // витягніть записи тут

        $nextNode = $xpath->query('//a[contains(., "Next")]')->item(0);
        $nextUrl = $nextNode ? $nextNode->getAttribute('href') : null;

        sleep(1);
    } catch (\Throwable $e) {
        $failed[] = $nextUrl;
        sleep(2);
        // логіка повтору може продовжитися з 4 та 8 секундами
        $nextUrl = null;
    }
}
Корисні виробничі звички:
- Логуйте невдалі URL, щоб можна було відновити роботу замість перезапуску повного завдання.
- Використовуйте відстрочку для тимчасових відмов. Проста послідовність 2, 4 та 8 секунд достатня, щоб уникнути атаки на нестабільну ціль.
- Сплячий режим між сторінками навіть на дружніх сайтах.
sleep(1)- це нормальна базова лінія. - Зберігайте сирий HTML при відмовах парсера, щоб можна було перевірити, що повернула ціль.
Якщо ви хочете більше патернів для підтримки скраперів після запуску, блог Sota Proxy про проксі та автоматизацію варто тримати у вашому списку посилань.
Пізніше в робочому процесі, коли ви переходите до проксі та обробки сесій, ця сама логіка залишається. Рівень завантаження змінюється. Дисципліна - ні.
Короткий посібник допомагає, якщо ви навчаєте молодшого в команді:
Обробка сайтів, керованих JavaScript
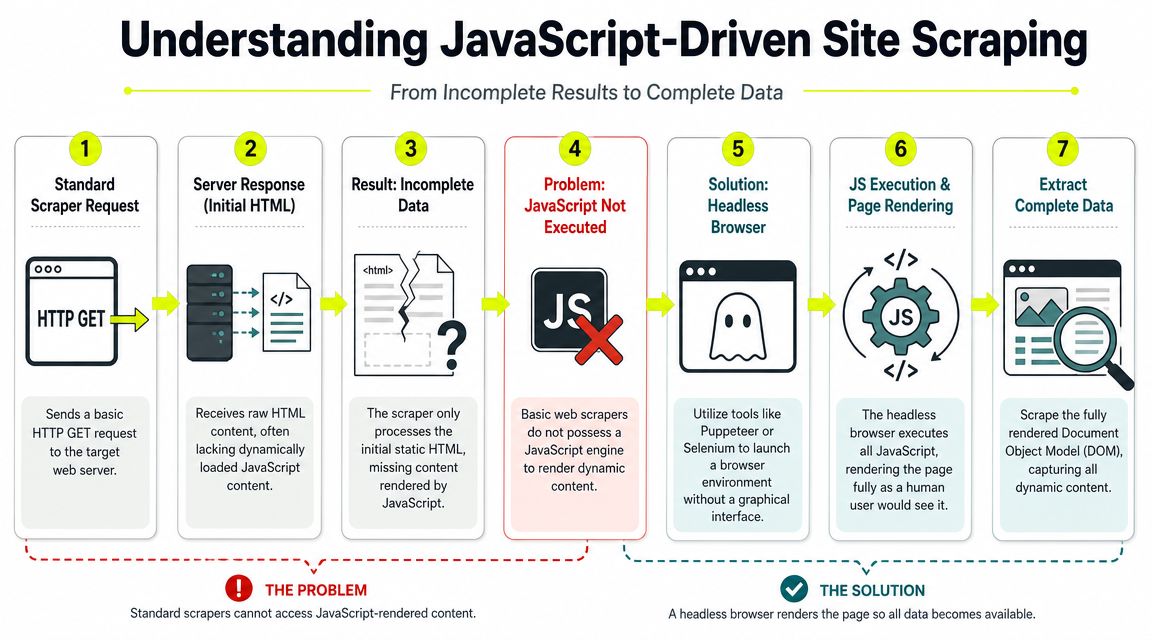
Багато невдалих завдань веб-скрапінгу на PHP - це не проблеми парсингу. Це проблеми рендерингу. Останні посібники з PHP все ще витрачають більшу частину часу на статичний HTML, хоча багато живих цілей тепер рендерять контент через JavaScript і потребують іншого шляху витягування. Ця прогалина вказана в обговоренні Scrape.do просунутого PHP-скрапінгу та обмежень простого DOM-парсингу на сайтах з великою кількістю JavaScript.
Як визначити, коли одного PHP недостатньо
Відкрийте ціль у своєму браузері та перевірте дві речі:
- Переглянути джерело, а не лише DOM у devtools.
- Мережева активність після завантаження сторінки.
Якщо потрібні вам дані не існують у початковому HTML-джерелі, Guzzle плюс DOMXPath їх не витягне. Це поширено на сайтах React, Vue та Angular. Це також поширено на внутрішніх рекламних бібліотеках, фільтрах вітрин, панелях керування акаунтами та заклоакованих сторінках відгуків.
Типові ознаки:
- початковий HTML містить заповнювачі або оболонкову розмітку
- контент з'являється лише після викликів XHR або fetch
- пагінація прив'язана до прокрутки або взаємодії з кнопкою
- ключові поля надходять через фонові API-запити
- перевірки антибота виконуються до показу реального контенту
Якщо ви скрапите джерело і отримуєте порожні контейнери, припиніть додавати селектори. Ви вирішуєте неправильну проблему.
Headless-браузер або рівень рендерингу
У вас є два робочих варіанти.
Перший варіант - автоматизація браузера. У PHP це зазвичай означає Symfony Panther, прив'язки Selenium або міст до Puppeteer чи Playwright. Це дає вам реальне виконання сторінки, оновлення DOM, кліки, очікування, збереження куків та взаємодію з кнопками, формами або контентом з відкладеним завантаженням.
Другий варіант - зовнішній рівень рендерингу. Це може бути служба браузера, API для скрапінгу або виділена служба Node, яку викликає PHP. Це часто чистіше для команд, які вже мають PHP у продакшені, але не хочуть локальної оркестрації браузера на кожному воркері.
Ось компроміси:
| Метод | Підходить для | Компроміс |
|---|---|---|
| Symfony Panther | PHP-центричні стеки, що потребують реального виконання браузера | Більше навантаження на CPU та пам'ять |
| Puppeteer або Playwright через міст | Складні JS-сайти з кроками взаємодії | Додатковий сервісний шар і більше рухомих частин |
| Selenium | Існуючі середовища автоматизації браузера | Важча інфраструктура |
| API рендерингу | Команди, які хочуть, щоб PHP залишався легким | Менше контролю над низькорівневим потоком браузера |
Для поверхонь Facebook та TikTok я зазвичай не довіряю чистому DOM-парсеру, поки не доведу, що контент знаходиться в тілі відповіді. Те саме стосується потоків фармінгу акаунтів, перевірок профілів та валідації офферів для конкретної географії. Динамічні сторінки часто потребують виконання браузера плюс стабільного рівня ідентичності. У цей момент скрапер починає виглядати менше як скрипт і більше як система автоматизації.
Інтеграція проксі для обходу блокувань та геотаргетингу
Якщо ви скрапите більше кількох сторінок, проксі перестають бути опціональними. Вони потрібні не лише для уникнення банів. Вони також дозволяють отримати правильну версію сторінки. Для команд арбітражу це означає перевірку того самого оффера, як користувач у цільовій країні, валідацію доставки креативу за регіонами та перегляд того, що показують воронки Facebook або TikTok з того ринку.
Вибирайте тип проксі за ціллю, а не за ціною
Дешеві проксі створюють дорогі погані дані. Правильний проксі залежить від цілі та патерну сесії.
| Тип проксі | Основне призначення | Ризик виявлення | Продуктивність | Вартість |
|---|---|---|---|---|
| Datacenter | Швидкий скрапінг низькочутливих цілей, масове збирання, публічні сторінки | Високий | Висока | Низька |
| Residential | Верифікація реклами, електронна комерція, соціальні поверхні, локалізований контент | Середній | Середня | Вища |
| Mobile | Чутливі соціальні платформи, потоки, схожі на додатки, робота з високою довірою | Нижчий | Середня | Вища |
| IPv6 | Високооб'ємні завдання на цілях, які чисто приймають IPv6 | Залежить від цілі | Висока | Низька |
Кілька практичних правил мають більше значення, ніж маркетинг постачальників:
- Datacenter-проксі швидкі та дешеві. Вони працюють для статичних сайтів, широкого відкриття та цілей зі слабким захистом. Вони швидше помічаються на соціальних платформах і високоцінних комерційних цілях.
- Residential-проксі є стандартом для серйозного скрапінгу. Вони виглядають більше як звичайний користувацький трафік і краще працюють для геотаргетованих кампаній, верифікації реклами та перевірок вітрин.
- Mobile-проксі корисні, коли довіра важливіша за пропускну здатність. Якщо ви торкаєтеся потоків акаунтів Facebook, перевірок акаунтів TikTok або чутливих процедур фармінгу, mobile часто виживає довше.
- IPv6-проксі можуть бути корисними для обсягу, але сумісність цілі вирішує, чи є вони практичними. Деякі сайти обробляють їх добре. Інші ставляться до них як до крайового трафіку й поводяться інакше.
Я не включив ISP-проксі в таблицю, тому що ви запитали про конкретні типи проксі, але вони заслуговують згадки. Вони добре підходять для тривалих сесій. Якщо вам потрібна стійка ідентичність для повторних перевірок, ISP-проксі часто мають більше сенсу, ніж агресивна ротація.
Residential-ротація зазвичай є безпечною базовою лінією для скрапінгу сторінок, пов'язаних з географією, комерцією або перевіркою реклами. Mobile - для складніших цілей. Datacenter - для швидкості, коли довіра не дуже важлива.
Підключення проксі до Guzzle
Сама інтеграція проста. Операційні правила навколо неї - складна частина.
<?php

use GuzzleHttp\Client;

$client = new Client([
    'proxy' => 'http://username:password@proxy-gateway:port',
    'timeout' => 30,
    'headers' => [
        'User-Agent' => 'Mozilla/5.0',
        'Accept-Language' => 'en-US,en;q=0.9',
    ],
]);

$response = $client->request('GET', 'https://example.com');
echo (string) $response->getBody();
Що вам потрібно вирішити:
Ротаційна або стійка сесія
- ротація для широкого обходу, перевірок реклами за багатьма регіонами та високозапитних завдань
- стійка для потоків входу, перевірок стану акаунта та будь-чого, пов'язаного з куками
Таргетинг за країною або містом
- рівень країни достатній для більшості перевірок офферів
- рівень міста має значення, коли доставка реклами або місцевий інвентар змінюється за регіоном
Якість пулу
- шумні пули спалюються швидше
- чисті пули мають значення, якщо ви використовуєте ту саму інфраструктуру як для скрапінгу, так і для автоматизації браузера
Для команд, що підключають проксі до потоків на основі браузера, Sota Proxy документує шляхи інтеграції на своїй сторінці інтеграцій проксі. Це корисно, якщо ви розділяєте роботу між PHP-завантажувачами та браузерними сесіями в антидетект-інструментах.
Є також бізнес-аспект, який важливий для деяких операторів. Якщо ваша команда вже рекомендує інфраструктуру клієнтам або підрядникам, Sota Proxy має реферальну програму з комісією до 40% через свою партнерську систему, описану в матеріалах компанії про продукт. Згадуйте це лише якщо це підходить вашій операції. Основна суть все одно інфраструктурна відповідність, а не побічний дохід.
Просунутий обхід та протидія антиботам
Проксі лише змінює, звідки надходить запит. Він не виправляє погану історію браузера. Цілі оцінюють повний профіль запиту. Вони дивляться на заголовки, мову, безперервність сесії, поведінку куків, потік навігації, а іноді й на те, чи відповідає відбиток браузера заявленому середовищу.
Заголовки, куки та правдоподібні сесії
Найшвидший спосіб бути заблокованим - надсилати стерильні запити у масштабі. Не ротуйте лише IP. Ротуйте контекст запиту контрольованим чином.
Використовуйте реалістичний набір заголовків:
- User-Agent, що відповідає реальному сімейству браузерів і платформі
- Accept-Language, узгоджений з вашою проксі-географією
- Referer, коли потік зазвичай його має
- Cookies, збережені для повторних відвідувань
- Поведінка сесії, яка не скидає ідентичність на кожному запиті
Якщо ви скрапите публічний каталог, легкого управління заголовками достатньо. Якщо ви перевіряєте потоки посадкових сторінок реклами, заклоаковані воронки або сторінки, пов'язані з акаунтом, вам потрібна безперервність сесії. Це означає банки куків, стабільне призначення проксі під час сесії та менше різких змін.
Список функцій, подібний до того, що на сторінці функцій платформи Sota Proxy, корисний, коли ви підбираєте стійкі сесії, контроль ротації та таргетинг за місцем розташування до дизайну скрапера.
Передача антидетект-браузеру
Для деяких цілей чистий PHP не повинен бути останньою милею.
Якщо робота включає рекламні акаунти Facebook, рекламні акаунти TikTok, прогрівання акаунтів, фармінг акаунтів або перевірки заклоакованих кампаній, антидетект-браузер часто повинен володіти сесією. AdsPower, Dolphin Anty, GoLogin, Multilogin та Hidemyacc існують з однієї операційної причини. Вони дають кожному профілю браузера зв'язний відбиток та стійкий стан ідентичності.
Практичний патерн виглядає так:
- PHP збирає цілі. URL, стани офферів, списки регіонів, посилання на бібліотеки реклами.
- Черга надсилає високоризикові завдання до браузерних воркерів.
- Антидетект-браузер відкриває призначений профіль зі своїм прив'язаним проксі.
- Автоматизація браузера виконує перевірки, які потребують рендерингу, кліків, стану входу або довіри профілю.
- PHP отримує структуровані дані результатів для зберігання та подальших рішень.
Це розділення працює добре, тому що PHP все ще чудово справляється з оркестрацією, парсингом, логікою повтору та очищенням даних. Він просто не повинен робити вигляд, що він повний браузер, коли ціль явно піклується про ідентичність браузера.
Скрапер може імітувати запити. Антидетект-профіль підтримує ідентичність. Це різні завдання.
CAPTCHA та операційні обмеження
CAPTCHA означає, що ціль перейшла від пасивної оцінки до активного виклику. У цьому момент у вас є три варіанти:
- Шлях ручного вирішення для рідкісних цінних сесій
- Інтеграція служби вирішення для повторюваної обробки викликів
- Редизайн робочого процесу, щоб менше завдань потрапляли на сторінки, схильні до викликів
Не розглядайте вирішення CAPTCHA як перше рішення. Зазвичай кращий виправлення знаходиться раніше. Зменшіть шум запитів, покращте якість сесії, сповільніться, тримайте мову та географію узгодженими та припиніть перетинати ідентичності між акаунтами.
Поважайте також технічні межі. robots.txt не є юридичним щитом або дозволом, але це все ще корисний сигнал для очікувань обходу. Важливіша проста дисципліна. Не перевантажуйте цілі. Не розкидайте повтори наосліп. Не запускайте логіку фармінгу та трафік скрапінгу через один слабкий пул і не очікуйте стабільних результатів.
Масштабування PHP-операцій скрапінгу
Один PHP-скрипт корисний. Система скрапінгу прибуткова. Різниця полягає в контролі завдань, ізоляції воркерів та відновленні після відмов.
Перехід від скриптів до воркерів
У масштабі припиніть запускати довгі цикли з cron і сподіватися, що вони завершаться. Покладіть завдання в чергу. Redis та RabbitMQ є поширеним вибором, тому що вони дозволяють відокремити планування від виконання.
Чиста структура виглядає так:
- Виробник створює завдання з потреб кампанії, списків географії або відстежуваних URL.
- Черга буферизує роботу та контролює розподіл.
- Воркери завантажують, парсять, рендерять або передають браузерним сесіям.
- Рівень зберігання тримає сирі відповіді, витягнуті поля та журнали відмов окремо.
- Супервізор перезапускає мертві воркери та відстежує повторювані відмови.
Це важливо для мульти-акаунтних операцій. Невдалий скрапінг сторінки продукту - це одне. Невдале завдання верифікації Facebook, керованої браузером, прив'язане до прогрітого профілю - інше. Розділіть ці робочі навантаження.
Конкурентність без хаосу
PHP може масштабувати пропускну здатність запитів, якщо ви обережно використовуєте конкурентність. Guzzle підтримує конкурентні патерни запитів, чого достатньо для статичних цілей, які не потребують виконання браузера. Так ви скорочуєте час обходу, не відкриваючи сотню неконтрольованих циклів.
Кілька правил тримають це в здоровому глузді:
- Групуйте за профілем проксі, щоб один поганий вихід не отруїв кожен запит.
- Розділіть статичні та відрендерені завдання, тому що їхні ресурсні витрати різні.
- Повторюйте вибірково замість повторного відтворення повного пакету.
- Відстежуйте причину відмови за категорією. Тайм-аут, сторінка блокування, промах парсера, промах JS або невідповідність географії.
Roach PHP також варто розглянути, коли робоче навантаження виглядає як справжній обхід. Він додає павуків, конвеєри, middleware та планування, що допомагає, коли ваша операція PHP-скрапінгу переросла окремі скрипти.
Кінцевий стан простий. PHP добре справляється з оркестрацією, парсингом, зберіганням та логікою черги. Браузерні воркери обробляють рендеринг та дії, чутливі до ідентичності. Проксі обробляють локальність та репутацію. Антидетект-інструменти обробляють довірчі сесії. Коли ці ролі правильно розділені, весь стек стає легшим у підтримці.
Якщо ваші завдання скрапінгу залежать від чистих геотаргетованих IP, стійких сесій або ротації, що підходить для автоматизації браузера та PHP-воркерів, Sota Proxy - це один варіант для оцінки поряд з рештою вашого інфраструктурного стека. Він охоплює residential, mobile, ISP, datacenter та IPv6 типи проксі, що робить його придатним як для легких PHP-завантажувачів, так і для більш довірчих робочих процесів антидетект-браузерів.
Схожі статті
Як OnlyFans-агенції керують 20 акаунтами криейторів без їх зв'язування
Що насправді зв'язує акаунти криейторів, який тип проксі потрібен кожному з них, як чатери з трьох країн використовують один логін та скільки коштує рівень ізоляції порівняно з 20‒50 відсотками частки агенції.
Купити проксі для гео-серфінгу, які дійсно працюють
Дізнайтеся, як правильно купити проксі для гео-серфінгу - виберіть типи, таргетуйте міста, налаштуйте антидетект браузери та перевірте гео-результати.

Як побудувати інфраструктуру захисту рекламного трафіку з Cloaking.House та SotaProxy
Дізнайтеся, як створити надійний стек для рекламного трафіку з проксі, браузерними профілями та клоакінгом для тестування GEO, фільтрації та усунення проблем у кампаніях.
Підробка цифрових відбитків: методи, виявлення та використання антидетект браузерів
Дізнайтеся, як працює підробка цифрових відбитків, які методи використовуються для обходу виявлення, і як антидетект браузери з проксі безпечно керують мультиакаунтними операціями.
Моніторинг у реальному часі
Моніторинг у реальному часі. Моніторинг проксі-мереж, рекламних акаунтів та систем збору даних у реальному часі. Метрики, сповіщення, SLA та практичні тактики
Мережева надлишковість для проксі та платформ автоматизації
Дізнайтеся, як мережева надлишковість підтримує працездатність проксі та платформ автоматизації. Розглядаємо активні/пасивні схеми, мультирегіональні кластери, налаштування відмовостійкості та забезпечення доступності 99,9%