Proxies para SEO en 2026: qué envía realmente Google a un scraper y cuánto cuesta posicionarse
La mayoría de tareas SEO no requieren proxy. El seguimiento de posiciones en Google necesita más de uno. Qué enviaron Google, Bing y DuckDuckGo a nuestro scraper, tres formas de obtener rankings con precios reales y qué proxy se adapta al resto del SEO.
Los "proxies para SEO" son una frase de búsqueda, no un producto. La mayor parte del trabajo SEO no necesita ningún proxy, hay una parte que los necesita urgentemente, y esa parte ha cambiado en los últimos dos años de una forma que la mayoría de las guías no han reflejado aún. Así que este artículo arranca con una prueba que realizamos el 30 de septiembre de 2026, y pone precio a cada opción.
Qué tareas SEO requieren un proxy
| Tarea | ¿Proxy? | Qué tipo |
|---|---|---|
| Leer Search Console, analítica, logs | No | |
| Rastrear tu propio sitio | No | |
| Rastrear sitios de competidores, verificar backlinks en muchos dominios | Sí, a volumen | Datacenter, unas pocas direcciones dedicadas |
| Comprobar posiciones en Bing o DuckDuckGo | Solo a volumen | Datacenter |
| Comprobar posiciones en Google | Sí, y es el caso difícil | Residencial, o ninguno, ver más abajo |
| Resultados locales por ciudad, paquetes locales, anuncios | Sí | Residencial con targeting por ciudad, en navegador |
Las dos primeras filas son las que la gente olvida mencionar. Si tu trabajo SEO trata sobre tu propio sitio, el presupuesto para proxies es cero.
Qué envían los motores de búsqueda a un scraper
Solicitamos la misma consulta desde una conexión doméstica, sin proxy, tal como lo haría un scraper.
| Motor | Petición HTTP simple (curl) | Chrome headless |
|---|---|---|
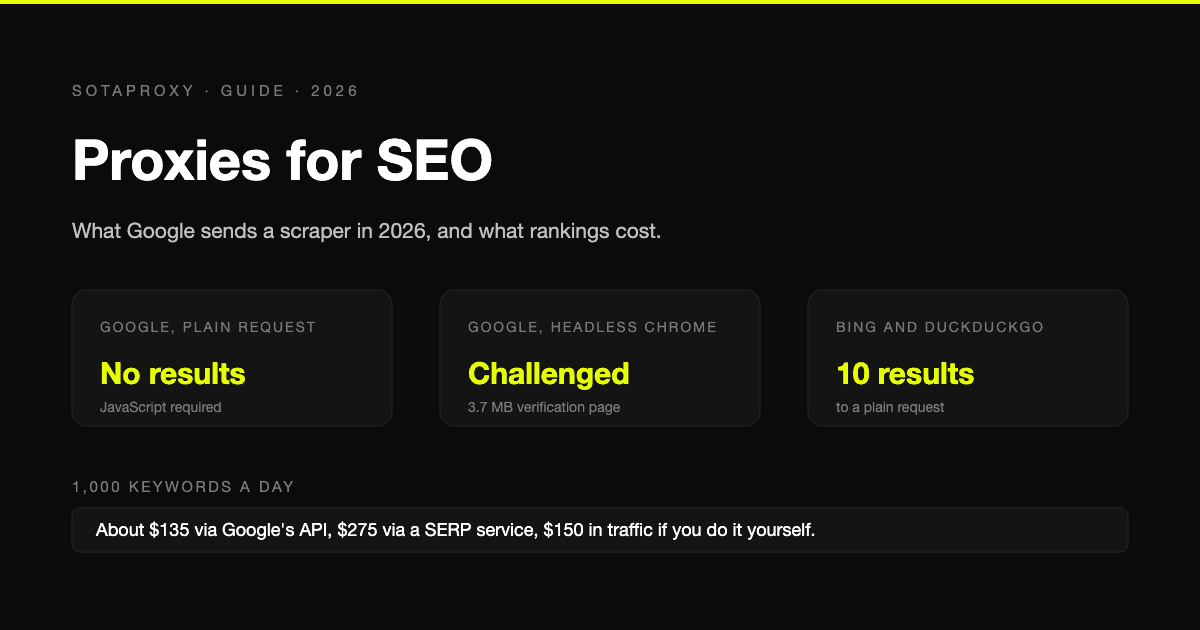
| Página de 92 KB sin resultados, "haz clic aquí si no se te redirige" | "Nuestros sistemas han detectado tráfico inusual", página de verificación, 3,7 MB transferidos | |
| Bing | 10 resultados, 126 KB | no necesario |
| DuckDuckGo (endpoint html) | 12 resultados incluyendo anuncios, 47 KB | no necesario |
De aquí se deducen dos cosas.
Google ya no devuelve resultados a nada que no ejecute JavaScript. Un scraper construido sobre peticiones simples, que es como lo describen todavía la mayoría de las guías sobre proxies para SEO, obtiene una carcasa vacía desde cualquier dirección, residencial o no. Para ver resultados necesitas un navegador real, y cada página renderizada pesa megabytes en lugar de kilobytes.
Google verifica el navegador además de la dirección. Nuestro Chrome headless recibió un desafío desde una conexión doméstica ordinaria en su primera petición. Un proxy residencial te da una dirección doméstica, pero no te da un navegador en el que Google confíe. Eso es un problema separado, y es por eso que "simplemente usa rotativos residenciales" ya no es una respuesta completa.
Bing y DuckDuckGo siguen siendo HTML simple. Si tus posiciones ahí importan, son baratas de recopilar.
Tres formas de obtener posiciones en Google, con precios
Tomemos un trabajo realista: 1.000 keywords comprobadas una vez al día, 30.000 páginas de resultados al mes.
| Método | Cuánto cuesta para 30.000 páginas al mes | Qué obtienes |
|---|---|---|
| API JSON de Custom Search de Google | 100 consultas al día gratis, luego $5 por 1.000: unos $135 | Diez resultados por consulta desde un Programmable Search Engine, no la página de resultados real. Sin paquete local, sin anuncios |
| Un servicio de API SERP | SerpApi: $150 al mes por 15.000, $275 por 30.000 | La página real parseada, con funcionalidades. Los bloqueos son su problema |
| Tu propio navegador y proxies residenciales | Solo tráfico: 30.000 páginas a unos 3 MB cada una son unos 90 GB, $150 con nosotros a $1,50 por GB, antes de servidores y fallos | La página en bruto, bajo tus condiciones |
Lee la última fila con sinceridad. A este volumen, hacerlo tú mismo cuesta en tráfico aproximadamente lo mismo que cuesta en total un servicio SERP, y luego todavía tienes que ejecutar los navegadores y absorber cada página de verificación. Gana cuando necesitas la página real (capturas de un paquete local, posiciones de anuncios, maquetación), cuando el volumen es mucho mayor, o cuando ya ejecutas los navegadores para otra cosa.
Los precios fueron tomados de las páginas de Google y SerpApi el 30 de septiembre de 2026. La cifra de 3 MB es lo que transfirió nuestra única petición bloqueada. No pudimos medir una página con resultados sin recibir un desafío, así que trátala como una estimación y no como una medición.
Si scraepas Google tú mismo
Los parámetros que hacen que los resultados sean comparables de una ejecución a otra:
| Parámetro | Significado | Ejemplo |
|---|---|---|
hl | Idioma de la interfaz | hl=en |
gl | País de los resultados | gl=us |
num | Resultados por página | num=10 |
pws=0 | Desactivar personalización | pws=0 |
uule | Ubicación codificada para resultados locales | ver abajo |
uele es la forma en que un rastreador de posiciones pide a Google que se comporte como si el usuario buscara desde un lugar específico. Es un prefijo, un carácter de longitud y el nombre del lugar en base64:
import base64
def uule(canonical_name):
key = "ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789-_"
b64 = base64.b64encode(canonical_name.encode()).decode().rstrip("=")
return "w+CAIQICI" + key[len(canonical_name)] + b64uule("New York,New York,United States")
# w+CAIQICIfTmV3IFlvcmssTmV3IFlvcmssVW5pdGVkIFN0YXRlcw
El nombre del lugar debe estar en la forma canónica de Google: "Ciudad,Región,País". Combínalo con una dirección proxy del mismo país: el uule define el lugar, la dirección tiene que hacer creíble ese lugar.
Tres prácticas después de trabajar con esto:
- Una dirección por sesión de resultados. La página dos debe venir de la misma dirección que la página uno, o estás uniendo dos buscadores distintos. En nuestra puerta de enlace eso es un sufijo de sesión,
login_c_US_s_42_ttl_15m. - Ralentiza por dirección, no en total. Los límites de Google son por dirección. Más direcciones a un ritmo más lento cada una sobreviven más tiempo que pocas direcciones a velocidad.
- Espera la página de verificación y regístrala. Cuenta las páginas retadas como fallos, reintenta desde una dirección distinta y vigila la tasa. Cuando sube, la solución es el ritmo, no más tráfico.
Proxies dedicados para herramientas SEO
Gran parte del tráfico de búsqueda aquí es por "proxies dedicados para posicionamiento SEO": direcciones estáticas para herramientas que ejecutan sus propias consultas. Dos herramientas diferentes se esconden detrás de esa frase.
Rastreadores de ranking que consultan Google directamente piden proxies porque Google limita cada dirección. Dales sesiones residenciales en lugar de direcciones de hosting, una por cada hilo concurrente, y ejecútalas al ritmo más lento que la herramienta permita. Se reporta ampliamente que las comprobaciones automáticas de Google caen más duramente sobre rangos de hosting, y un rastreador que quema direcciones de datacenter en Google está gastando dinero para recopilar páginas de desafío.
Crawlers y verificadores de enlaces buscan sitios web ordinarios, no Google. Una herramienta de auditoría de sitio rastreando un competidor, o un verificador de backlinks visitando mil páginas de referencia, funciona bien desde unas pocas direcciones dedicadas de datacenter. Las nuestras cuestan $1,80 al mes por una y $1,35 cada una desde diez, con tráfico sin medidor, y la mayoría de herramientas las aceptan como dirección:puerto:usuario:contraseña, una por línea. Mantén el rastreo educado: una dirección golpeando un sitio pequeño a máxima velocidad es como un rastreo termina bloqueado, y es derecho del sitio bloquearlo.
Para todo lo demás en esa lista, mejores proxies para web scraping tiene la prueba que te dice si un objetivo necesita direcciones residenciales en absoluto.
Comprobaciones de SEO local
Los resultados locales dependen de tres cosas que tienen que coincidir: el país de la dirección, el parámetro gl y el lugar del uule. Una dirección alemana con gl=us y un uule de Nueva York devuelve algo que ningún buscador real ve.
Para trabajo a nivel de ciudad, residencial con sufijo de ciudad es la herramienta correcta, y la ciudad es una preferencia en lugar de una garantía: login_c_US_city_New-York te da Nueva York cuando un dispositivo allí está en línea y el país en caso contrario. La sintaxis está en la referencia de cadena de conexión.
Preguntas frecuentes
¿Qué son los proxies SEO?
Proxies ordinarios comprados para tareas SEO, principalmente seguimiento de ranking y rastreo de competencia. No hay un tipo especial SEO. La elección es entre direcciones residenciales para Google y direcciones de datacenter para todo lo demás.
¿Necesito proxies para seguimiento de ranking?
Si verificas posiciones scrapeando Google tú mismo, sí, y un navegador también, porque Google no devuelve nada a una petición simple. Si usas la API de Google o un servicio SERP, no. Para unos cientos de palabras clave, la API o el servicio suele ser más barato que los proxies.
¿Cuál es el mejor tipo de proxy para SEO?
Residencial con segmentación por ciudad para cualquier cosa en Google. Direcciones dedicadas de datacenter para rastrear sitios y verificar backlinks. Nada en absoluto para trabajo en tu propio sitio.
¿Cuántos proxies necesito para seguimiento de ranking?
Los suficientes para que cada dirección se mantenga bajo el límite de Google a tu ritmo. El número depende de la herramienta y el ritmo, así que comienza con unas pocas sesiones, vigila la tasa de páginas de desafío y añade direcciones cuando suba en lugar de adivinar de antemano.
¿Puedo usar proxies gratuitos para SEO?
Para Google, no: son direcciones de hosting compartidas con todos los que encontraron la misma lista, y Google las reta primero. Para rastrear un sitio público, son poco fiables pero no peligrosos.
¿Está permitido scrapear Google?
Los términos de Google prohíben consultas automatizadas, y Google hace cumplir eso técnicamente en lugar de legalmente para seguimiento ordinario de ranking. La ruta conforme es la Custom Search API. Esto no es asesoría legal.
Artículos relacionados
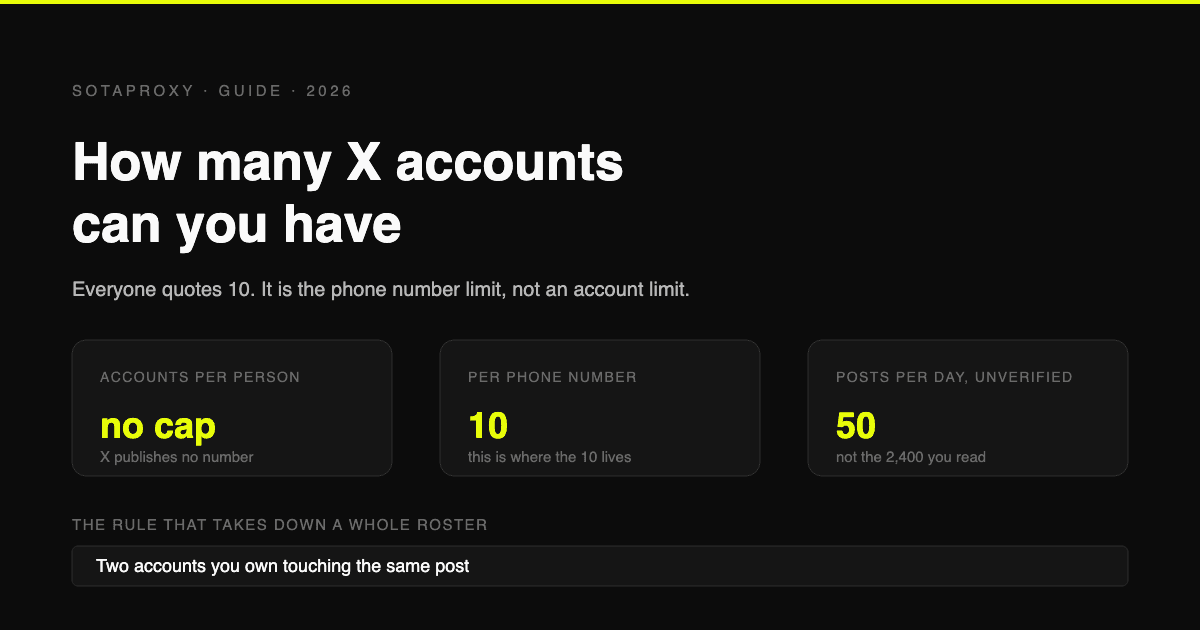
¿Cuántas cuentas de X (Twitter) puedes tener en 2026? (El límite de 10 es por teléfono, no por persona)
X no establece límite oficial de cuentas por usuario. El número 10 que todos mencionan se refiere a cuántas cuentas puedes asociar a un mismo número de teléfono. Las restricciones reales son los 50 posts diarios en cuentas gratuitas, casos de uso duplicados y cuentas que interactúan entre sí.
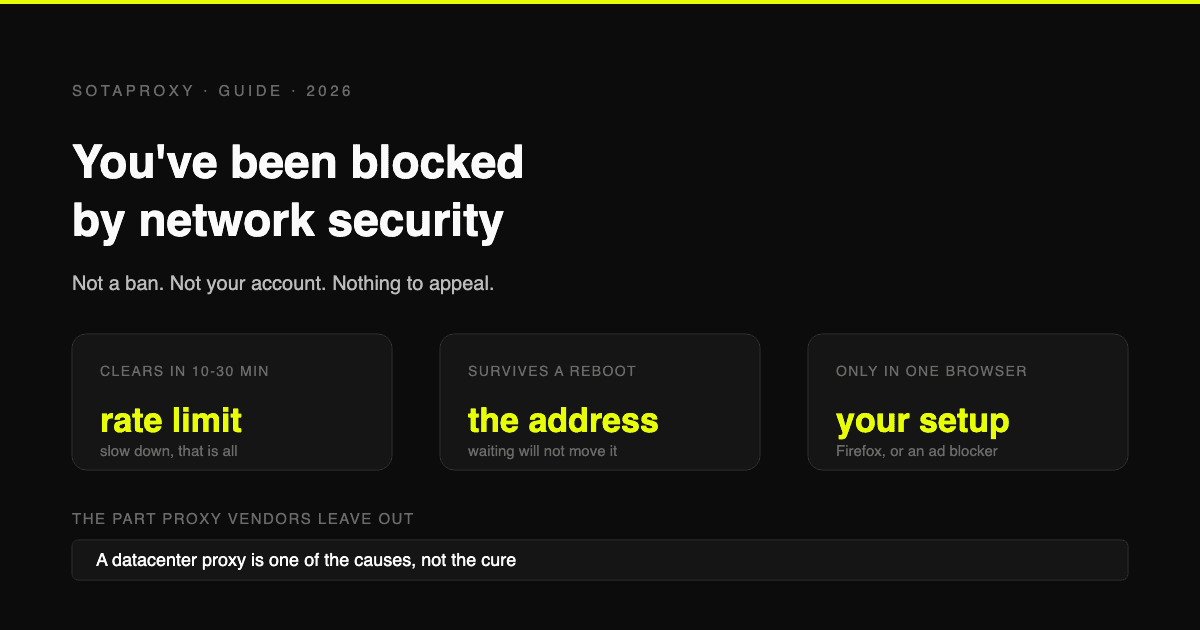
Reddit "You've Been Blocked by Network Security": Todas las causas y la solución para cada una
No es un baneo y no hay nada que apelar. Proviene del edge de Reddit, se aplica a tu conexión y tiene seis causas. Aquí te mostramos cómo identificar cuál tienes y cuánto dura cada una.
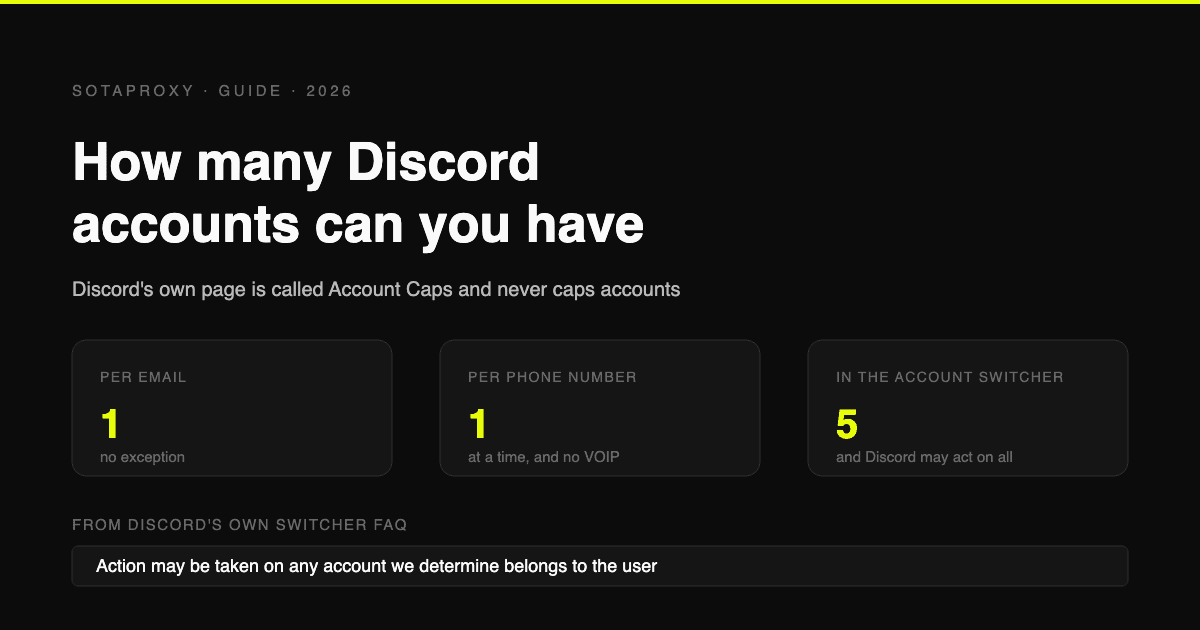
Cuántas Cuentas de Discord Puedes Tener en 2026 (Por Email, Por Teléfono, Por Dispositivo)
Discord no publica ningún límite en las cuentas. Los límites reales son uno por email, un número de teléfono a la vez sin VOIP, y cinco en el Cambio de Cuentas, que Discord indica que puede hacer cumplir de forma general.
Automatización de Telegram con Telegram Expert: qué hacer si la tarea se detuvo a la mitad
Cuántas Cuentas de Reddit Puedes Tener en 2026 (Barreras de Karma, Baneos, Bloqueos de Seguridad de Red)
Reddit permite múltiples cuentas abiertamente. Lo que te detiene son las barreras de karma, calidad del colaborador, límites de tasa y una regla estricta sobre votación, además de los tres tipos de baneo, cómo se apela cada uno, y por qué "bloqueado por seguridad de red" no es ninguno de ellos.
Cuántas Cuentas de TikTok Puedes Tener en 2026 (Límites, Strikes y Reglas de Shop)
Seis cuentas por dispositivo, no tres, y sin límite publicado. Las reglas que realmente deciden la supervivencia: límites de acción según la antigüedad de la cuenta, cómo expiran los strikes, qué es realmente un shadowban y una Shop por entidad comercial por mercado.