Automatización de Telegram con Telegram Expert: qué hacer si la tarea se detuvo a la mitad
Cuando una tarea de Telegram procesa varios miles de registros, un fallo rara vez se ve como un solo problema comprensible. Parte de las solicitudes pueden toparse con una limitación de Telegram, parte puede perder la conexión, y parte terminará con error debido a la configuración de un chat o usuario específico.
El error más frecuente en esta situación no está en el fallo en sí, sino en la misma reacción ante diferentes causas. Si después de cualquier error se cambia el proxy y se reinicia la acción, una interrupción de red temporal puede desaparecer realmente. Pero FLOOD_WAIT no terminará por ello, la prohibición de enviar mensajes no cambiará, y una respuesta perdida después de una acción ya ejecutada puede llevar a una operación repetida.
Por eso, en la automatización masiva primero se determina la causa del fallo, y solo entonces se elige la acción: repetir la solicitud, cambiar la ruta, esperar o finalizar el procesamiento del registro.
Contenido
1. Por qué un error en Telegram puede requerir cuatro reacciones diferentes
2. Cuándo vale la pena repetir una tarea de Telegram a través del mismo proxy
3. Cuándo el problema realmente requiere cambiar el proxy
4. Por qué FLOOD_WAIT hay que esperarlo, no evitarlo con repeticiones
5. Por qué timeout no puede considerarse automáticamente una operación fallida
6. Cómo configurar retry para procesamiento masivo en Telegram Expert
7. Qué guardar en la base de datos después de cada intento
8. Cómo separar el trabajo del proxy y Telegram Expert
9. FAQ sobre fallos de automatización de Telegram
Por qué un error en Telegram puede requerir cuatro reacciones diferentes
A nivel de tarea, el resultado a menudo se ve igual: registro no procesado. Pero la causa puede encontrarse en diferentes capas.
Telegram separa los errores RPC por significado. Unos hablan de una solicitud incorrecta, otros están relacionados con autorización o permisos, otros informan de una limitación temporal, y una clase separada se refiere a errores internos del servidor.
Para la automatización masiva es suficiente dividirlos en varios grupos.
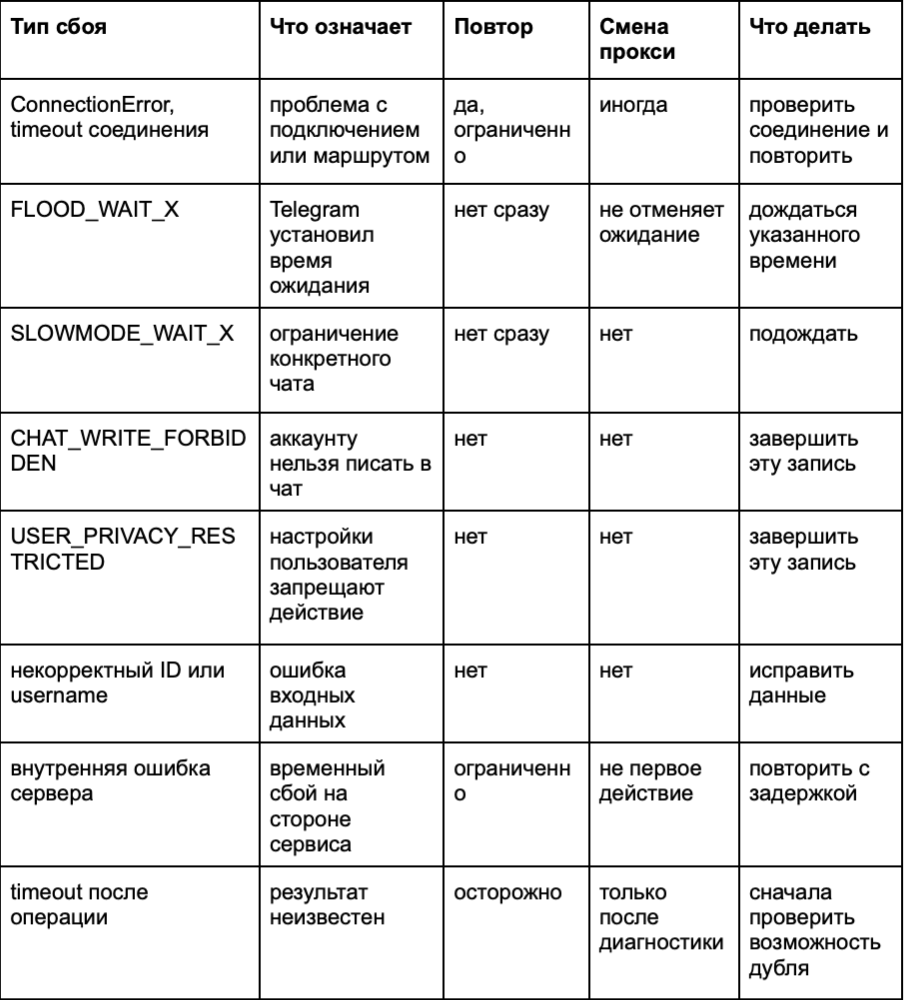
Esta es una estrategia básica, no una tabla universal para todos los métodos de Telegram. Un método concreto puede devolver errores adicionales.
El principio principal es simple: la repetición tiene sentido solo cuando la ejecución repetida realmente puede dar un resultado diferente.
Antes de repetir, hay que determinar qué cambiará entre el primer y segundo intento. Si nada, la repetición la mayoría de las veces solo reproduce el mismo fallo.
Este enfoque es especialmente importante para tareas donde una base de datos contiene miles de usuarios, chats u otros objetos. El error de un registro no debe detener todo el proceso, pero tampoco se puede devolver infinitamente este registro al trabajo.
Cuándo vale la pena repetir una tarea de Telegram a través del mismo proxy
La repetición a través de la misma ruta es adecuada para un error temporal de conexión o un fallo del servidor de corta duración.
Por ejemplo, Telegram puede devolver un error interno de clase 500. Esto por sí mismo no demuestra que el problema esté en el proxy. En este caso, cambiar la ruta puede no dar nada, y una repetición limitada con pausa tiene sentido.
No vale la pena enviar la misma solicitud varias veces seguidas. Si la causa del problema aún no está solucionada, las solicitudes repetidas solo aumentarán la carga.
El esquema práctico se ve así:
- el primer error se registra en el log;
- la tarea obtiene una pausa corta;
- se ejecuta el segundo intento;
- en caso de fallo repetido, se incrementa el intervalo;
- después del número establecido de intentos, el registro se transfiere a un estado separado.
Para estas tareas se utiliza el retraso exponencial. El intervalo entre intentos aumenta gradualmente. El retraso aleatorio añade una pequeña dispersión en el tiempo, para que varios procesos paralelos no repitan la solicitud simultáneamente.
Es importante limitar el número de intentos. Si se repiten infinitamente las solicitudes después de cada error, un fallo temporal puede convertirse al final en una carga constante sobre el sistema.
Cuándo el problema realmente requiere cambiar el proxy
Cambiar el proxy tiene sentido cuando hay razones para considerar que la causa está en la ruta de red.
Si la conexión no se establece, se interrumpe regularmente o una ruta da errores, la repetición a través de ella puede solo reproducir el problema. Por ejemplo, ConnectionError - error de conexión, en el cual se recomienda verificar el proxy.
Pero cambiar el proxy no es una reacción universal ante errores de Telegram.
Por ejemplo, CHAT_WRITE_FORBIDDEN significa que a la cuenta actual se le prohíbe enviar mensajes en el chat. Otra IP no cambiará los permisos de la cuenta. USER_PRIVACY_RESTRICTED está relacionado con la configuración del usuario y tampoco se resuelve cambiando la ruta.
Por eso, la restauración de la conexión de red es mejor separarla del procesamiento del resultado de Telegram.
En tareas grandes no vale la pena vincular toda la lógica al reemplazo manual de IP. Hay que separar las solicitudes repetidas de la gestión de proxies problemáticos y utilizar el aumento gradual del intervalo entre intentos, retraso aleatorio y mecanismo de desactivación de solicitudes repetidas en caso de errores masivos. Este enfoque es especialmente útil a nivel de red.
Si se necesita una capa de proxy separada para estos escenarios, se puede usar SotaProxy: el servicio ofrece proxies residenciales, móviles, ISP y de data center, soporta rotación y sticky-sessions, por lo que se puede elegir la ruta para una sesión estable o automatización masiva.
Por qué FLOOD_WAIT hay que esperarlo, no evitarlo con repeticiones
FLOOD_WAIT_X tiene una diferencia fundamental respecto a un fallo de red. Telegram informa directamente cuánto tiempo hay que esperar antes de repetir la acción. En la documentación de Telegram este mecanismo se describe como limitación de frecuencia de solicitudes.
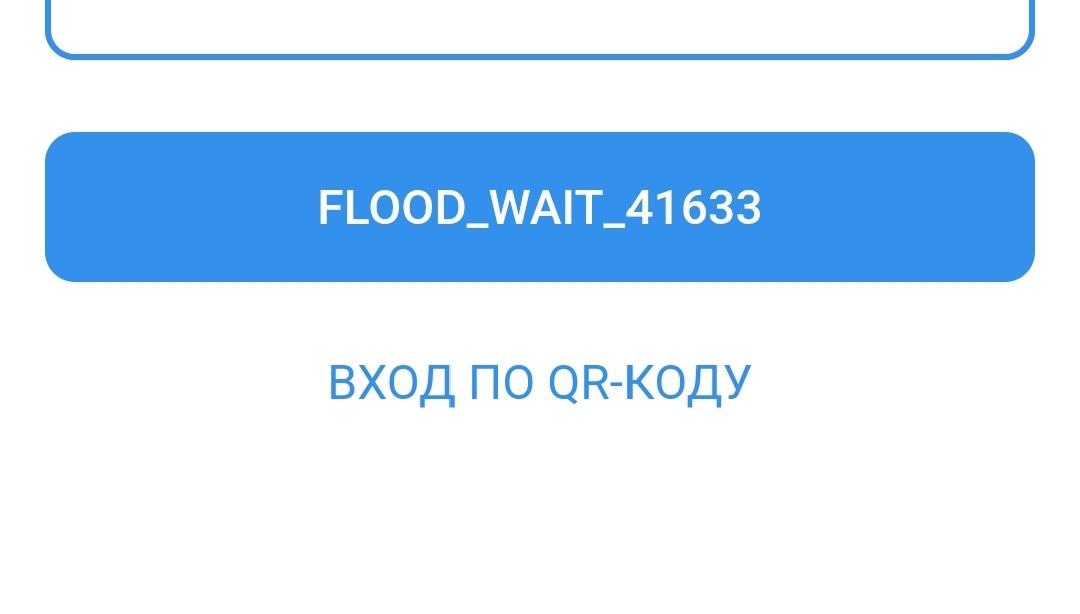
Por eso Telegram no recomienda cambiar automáticamente el proxy y repetir la solicitud después de recibir FLOOD_WAIT. El simple hecho de cambiar la IP no cancela la espera del servidor.
Lo mismo se aplica a SLOWMODE_WAIT_X. Esta es una limitación establecida para un chat específico. El cambio de ruta de red no cambia el slow mode.
Aquí es más correcto guardar el tiempo de espera y devolver la tarea a la cola después de su finalización.
Resulta otro modelo de procesamiento:
1. Telegram informa el tiempo de espera.
2. El sistema guarda este valor.
3. El registro se excluye temporalmente del procesamiento activo.
4. Después de finalizar la espera, la tarea vuelve a la cola.
5. Si la repetición lleva de nuevo a una limitación, el sistema tiene en cuenta la nueva respuesta de Telegram.
Este enfoque es mejor que inventar localmente retrasos del tipo esperar cinco segundos. Para limitaciones del servidor, la prioridad la tiene la información que devolvió el propio servicio.
Por qué timeout no puede considerarse automáticamente una operación fallida
La situación más compleja surge cuando el cliente no recibió respuesta.
En un error normal, la causa a menudo es clara. Con timeout solo se sabe que el cliente no recibió el resultado esperado en el tiempo dado. Esto no demuestra que Telegram no procesó la solicitud.
Telegram documenta por separado este escenario para el envío de mensajes. La solicitud puede crear exitosamente un mensaje, pero la respuesta del método se pierde. Como resultado, el cliente considera la operación fallida, aunque la acción ya ocurrió. Para esto, Telegram utiliza random_id y updateMessageID, que permiten vincular la llamada original con el mensaje creado.
El servidor también utiliza random_id para la deduplicación. Si el mismo identificador ya fue aplicado para la llamada correspondiente, Telegram no debe crear un segundo mensaje idéntico.
Después de un timeout, primero es necesario determinar si la acción pudo haberse ejecutado ya. Solo después de esto se elige un escenario de reintento seguro.
Esto es especialmente importante para operaciones que crean un efecto secundario. Reintentar una verificación suele ser más seguro que reintentar el envío de un mensaje. Por lo tanto, la política de retry debe considerar no solo el tipo de error, sino también la operación en sí.
Cómo configurar el reintento para procesamiento masivo en Telegram Expert
Cuando la tarea consiste en miles de registros, una regla general única para todo el proceso no es suficiente. Cada registro debe tener un estado claro y una reacción clara ante errores.
Esto puede dividirse condicionalmente en etapas.
1. Primero clasificar el error
Un conjunto mínimo es suficiente:
- error de conexión;
- restricción temporal de Telegram;
- prohibición o privacy restriction;
- datos incorrectos;
- error interno;
- resultado desconocido después de timeout.
2. Para cada clase determinar la acción
Por ejemplo:
1. ConnectionError → reintento limitado → cambio de ruta si es necesario → detención
2. FLOOD_WAIT → espera → reintento después del tiempo indicado
3. Privacy / Forbidden → finalización del registro
4. Invalid data → corrección de datos
5. 500 → reintento con aumento del intervalo de espera
Este enfoque no requiere escribir manualmente una estrategia separada para cada error.
3. Limitar el número de intentos
La cantidad de reintentos debe ser finita. Si una ruta o un registro continúa fallando, la tarea debe salir del ciclo y obtener un estado final claro.
Para problemas de red recurrentes, se puede detener temporalmente los reintentos. Su tarea no es corregir el error, sino detener temporalmente las solicitudes a la dirección problemática y no propagar un fallo a todo el proceso.
4. Guardar el estado de cada registro
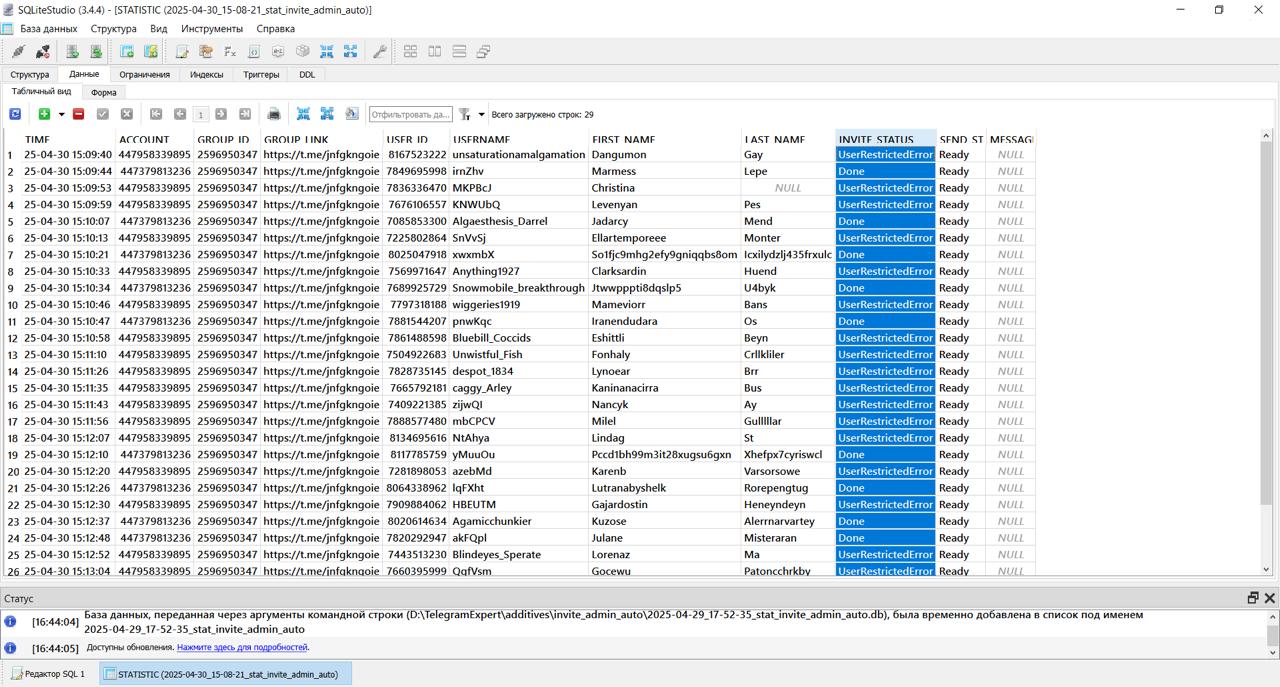
En Telegram Expert la base de datos separa los estados Ready, Taken y Done. Ready significa que el registro está listo para procesarse, Taken muestra que ya está en proceso, y Done registra la acción completada.
Esto es importante ante fallos. Si toda la tarea consiste en diez mil registros, no es necesario reiniciarla desde el principio solo porque unos cientos terminaron con error.
La base de datos permite continuar el procesamiento desde el estado necesario. Si es necesario, el estado del registro puede cambiarse manualmente, por ejemplo, devolver Done a Ready para ejecutarlo nuevamente.
Además, si ocurrió un error, esto también quedará marcado en los logs, lo que permitirá entender qué acción tomar.
5. Separar los reintentos de la verificación manual
Después de varios intentos fallidos, el registro debe llegar a un estado final o a una cola de verificación manual.
Si Telegram informa que la acción está prohibida por la configuración del usuario, no es necesario reintentarla automáticamente. Si el problema está en la conexión, el registro puede devolverse al procesamiento después de restaurar la ruta.
Así aparece un proceso gestionable, y no un ciclo infinito de reintentos.
Qué guardar en la base de datos después de cada intento
En automatización masiva, el error en sí raramente ayuda a entender lo que sucedió. Se necesita contexto.
Para cada intento es útil guardar:
- tiempo;
- cuenta;
- acción ejecutada;
- objeto objetivo;
- identificador del proxy o ruta;
- número de intento;
- duración de la solicitud;
- error de Telegram;
- hecho del cambio de proxy;
- acción final: retry, wait, skip, stop o review.
Después de esto, el registro "47 errores" se convierte en un diagnóstico normal.
Por ejemplo, se puede ver que los 47 errores son ConnectionError y ocurren a través de una ruta. Es un problema de la capa de red.
Si los 47 registros recibieron FLOOD_WAIT, la causa ya está en las limitaciones de Telegram.
Si 47 usuarios recibieron USER_PRIVACY_RESTRICTED, el problema pertenece a las condiciones de operaciones específicas, y no al proxy.
Telegram Expert justamente trabaja con los resultados de operaciones a través de bases de datos y estados, y para diferentes acciones forma bases de resultados propias. Esto permite no mezclar registros procesados exitosamente con aquellos que requieren trabajo adicional.
Cómo dividir el trabajo del proxy y Telegram Expert
El proxy es responsable de la conexión de red. Aquí se verifican la disponibilidad de la ruta, la conexión, las latencias y los fallos de red recurrentes.
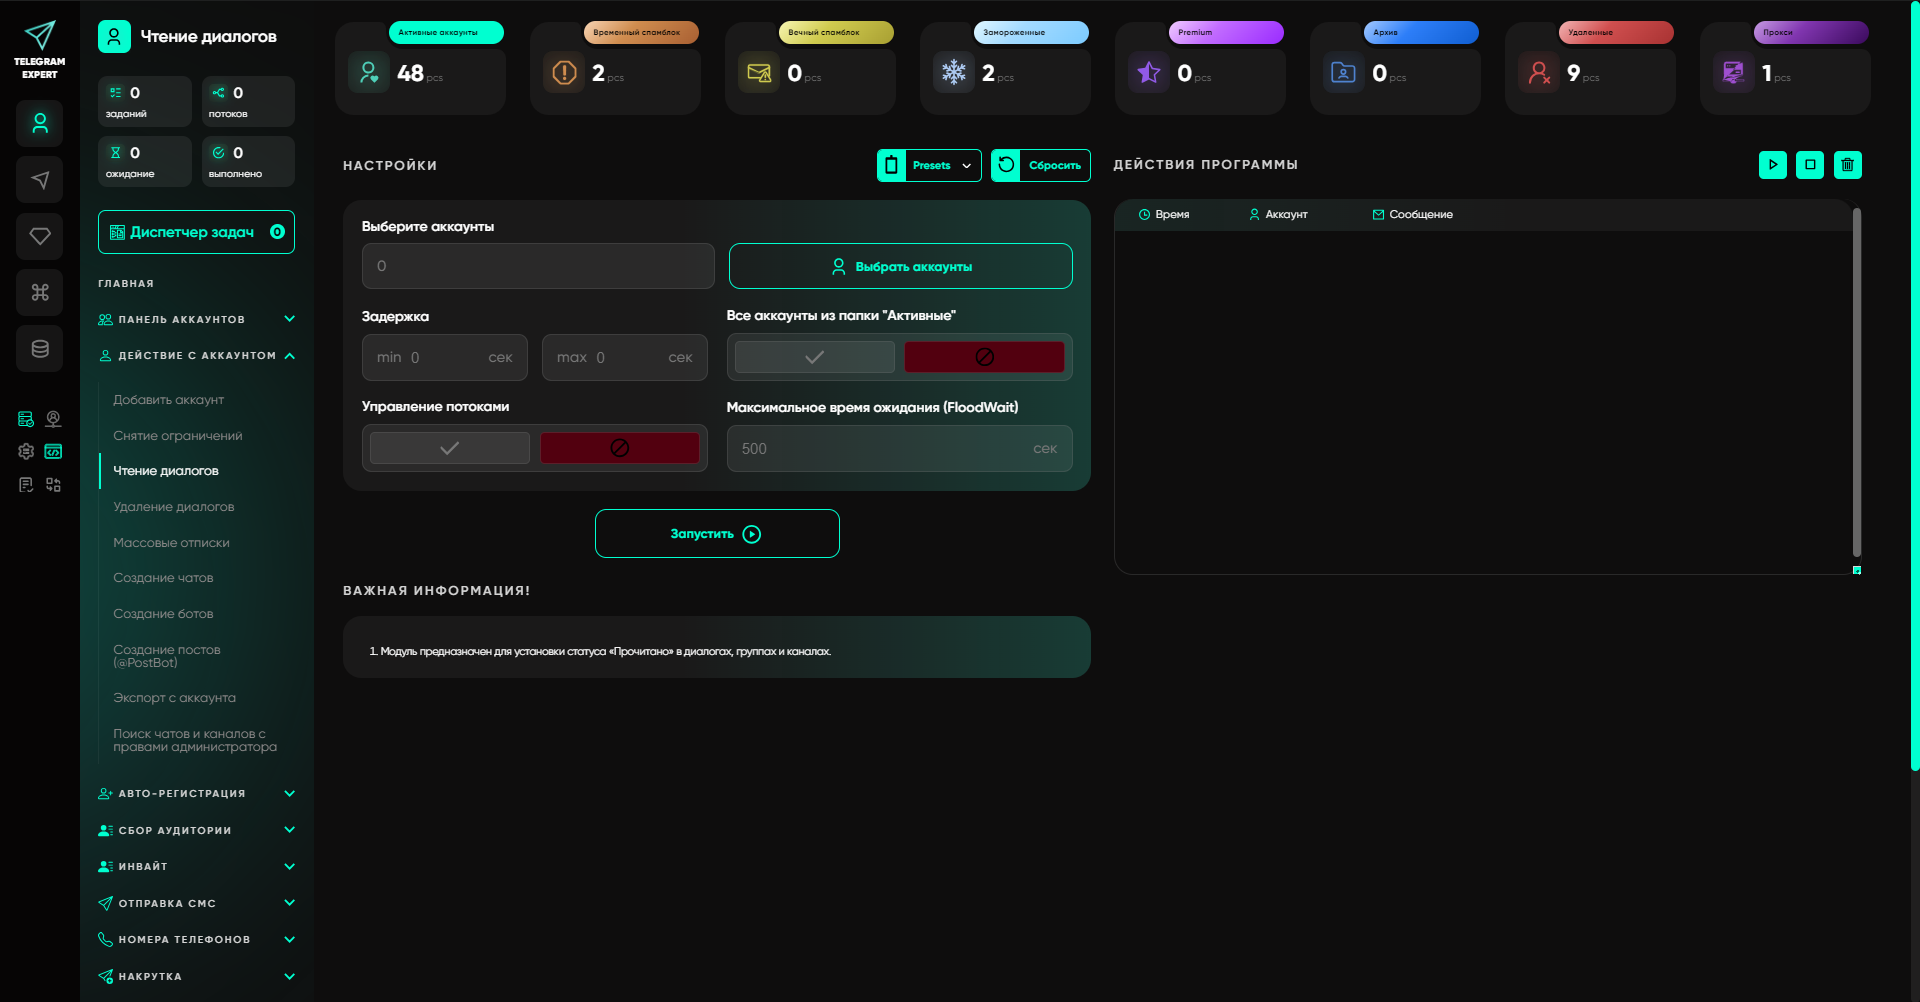
Telegram Expert es responsable de la parte aplicativa. Aquí se determina qué cuenta ejecuta la acción, qué registro está en proceso, qué respuesta devolvió Telegram y qué hacer con ese registro a continuación.
Esta división evita convertir cualquier error de Telegram en un problema del proxy.
Para el usuario esto es especialmente notable en tareas masivas. Si un registro recibió ConnectionError, se puede reintentar después de verificar la ruta. Si otro recibió ChatWriteForbiddenError, no tiene sentido enviarlo a través de una nueva IP. Si un tercero recibió FLOOD_WAIT, necesita asignársele una espera.
Telegram Soft Expert ya utiliza estados separados para estos resultados y almacena el estado de trabajo de los registros. Esto permite construir el procesamiento no alrededor de una bandera general única "error", sino alrededor del resultado de cada operación específica.
El propio Telegram Expert resuelve un círculo mucho más amplio de tareas relacionadas con cuentas, sesiones, bases de datos y operaciones masivas.
En él se puede trabajar por separado con el registro y calentamiento de cuentas, gestionar cuentas y sus estados, verificar y distribuir proxies, recopilar audiencias, invitar usuarios, enviar mensajes y publicar contenido.
Las principales capacidades de Telegram Expert cubren todo el ciclo de trabajo con cuentas:
1. Panel de cuentas. Gestión centralizada de cuentas, agrupación, estados, verificación masiva y acciones masivas.
2. Auto-registro. Generador de parámetros, registro manual, registro a través de servicios SMS y registrador universal.
3. Recopilación de audiencia. Búsqueda global, recopilación de usuarios de chats, comentarios y cuentas, verificación de enlaces y trabajo con bases de datos de parsing.
4. Invitación. Invitación de usuarios por username e ID, así como herramientas de invitación a través de administradores y bots.
5. Envío de mensajes. Envíos masivos, envío por ID y contactos, trabajo con diálogos abiertos, autoposteo, autorrespuesta, comentarios y neurocomentarios.
6. Números de teléfono y contactos. Verificación de números en Telegram, trabajo con bases de datos telefónicas, adición y eliminación de contactos, exportación de contactos, envíos masivos e invitaciones por agenda de contactos.
7. Stories. Publicación, comentarios, exportación de enlaces y eliminación de stories de las cuentas.
8. Informes y bases de datos. Generación de informes, combinación de bases de datos y recuento de resultados de envíos masivos e invitaciones.
9. Módulos especiales. Duplicador de sesiones, conversor de Session y TData, sesiones ocultas, potenciador de cuentas, reenviador, clonadores de chats y canales, interceptor de contenido y herramientas de gestión de administradores.
10. Proxies. Adición y verificación de proxies, así como verificador de pool de proxies con comprobación de intersecciones de direcciones IP.
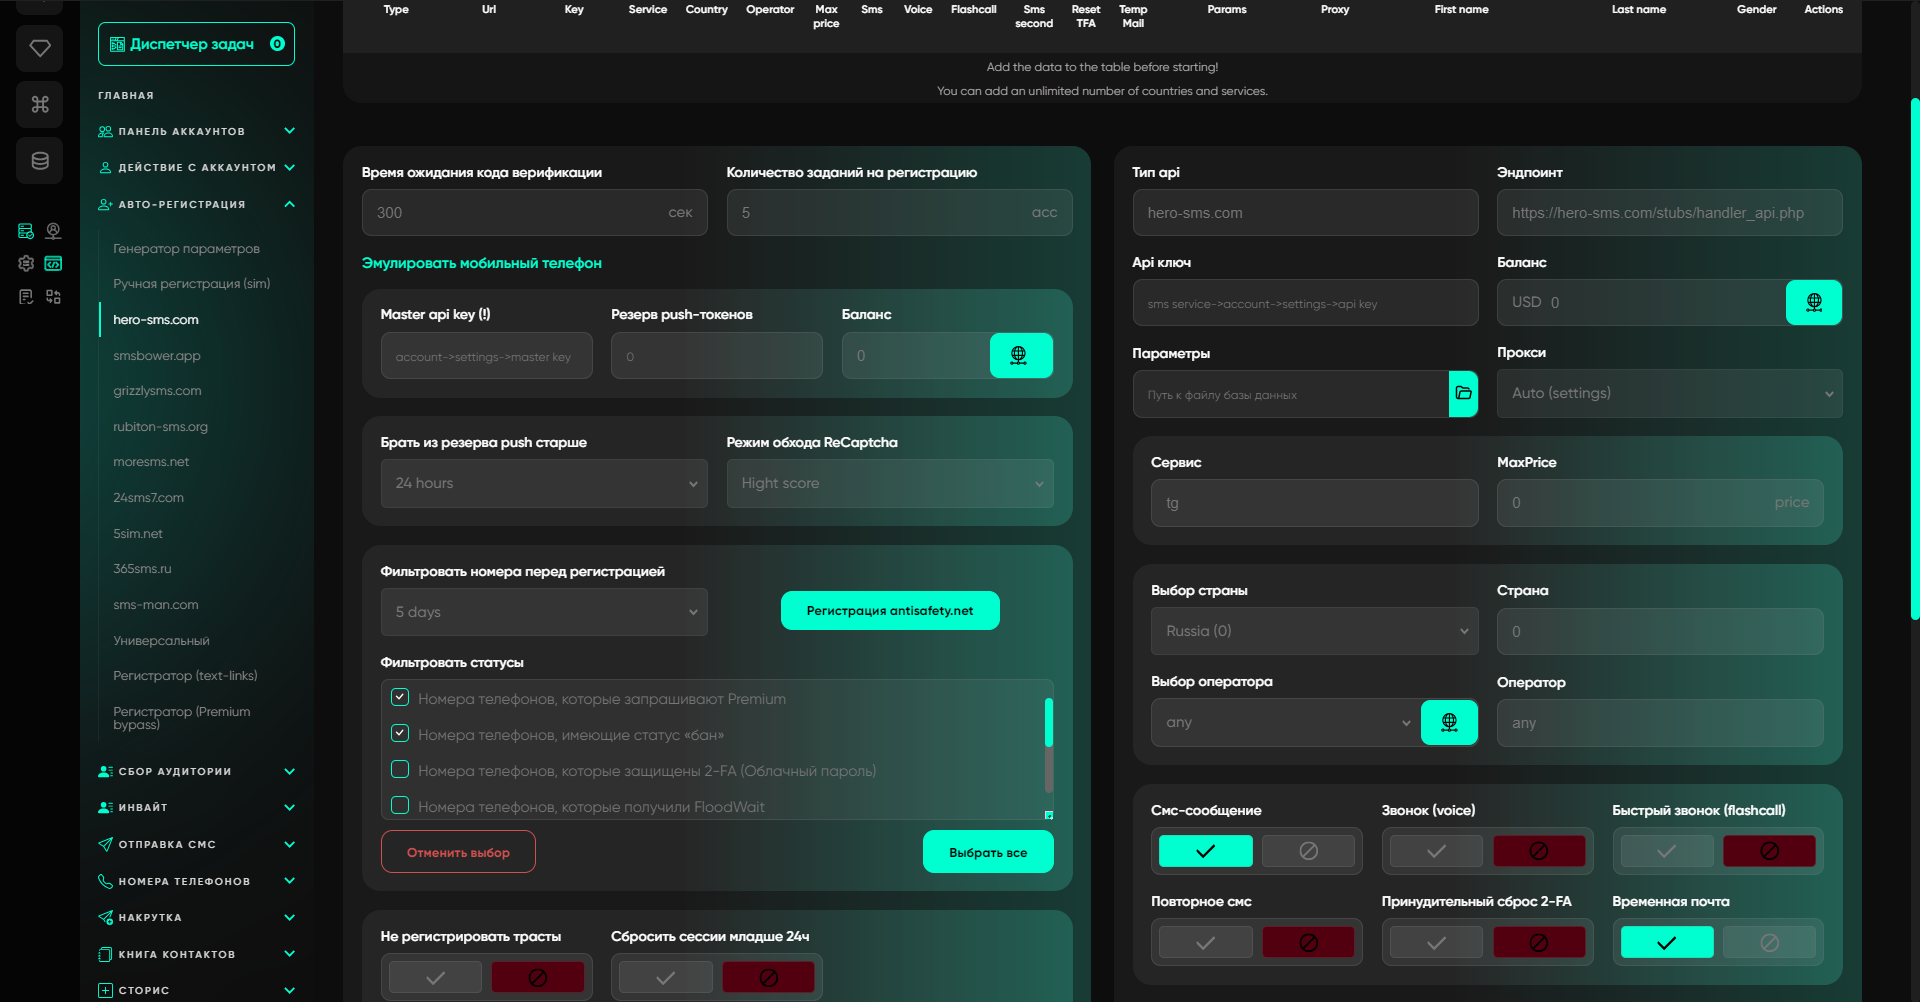
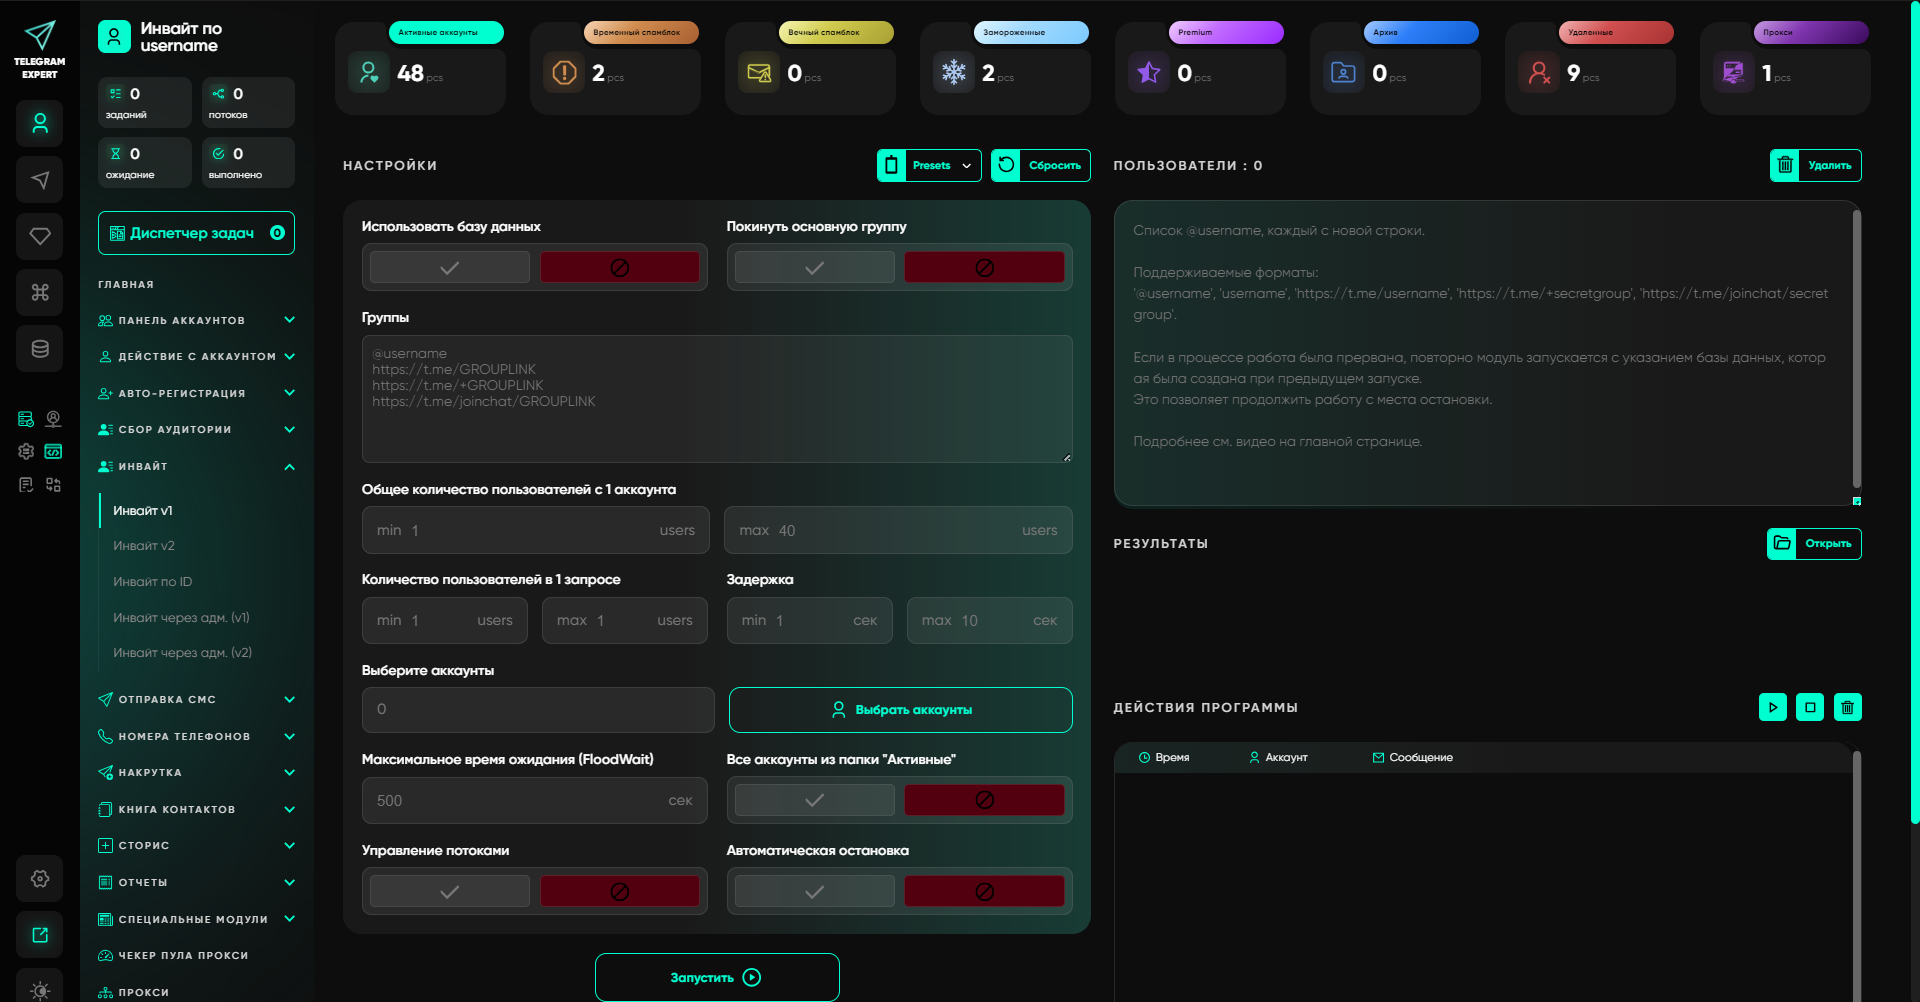
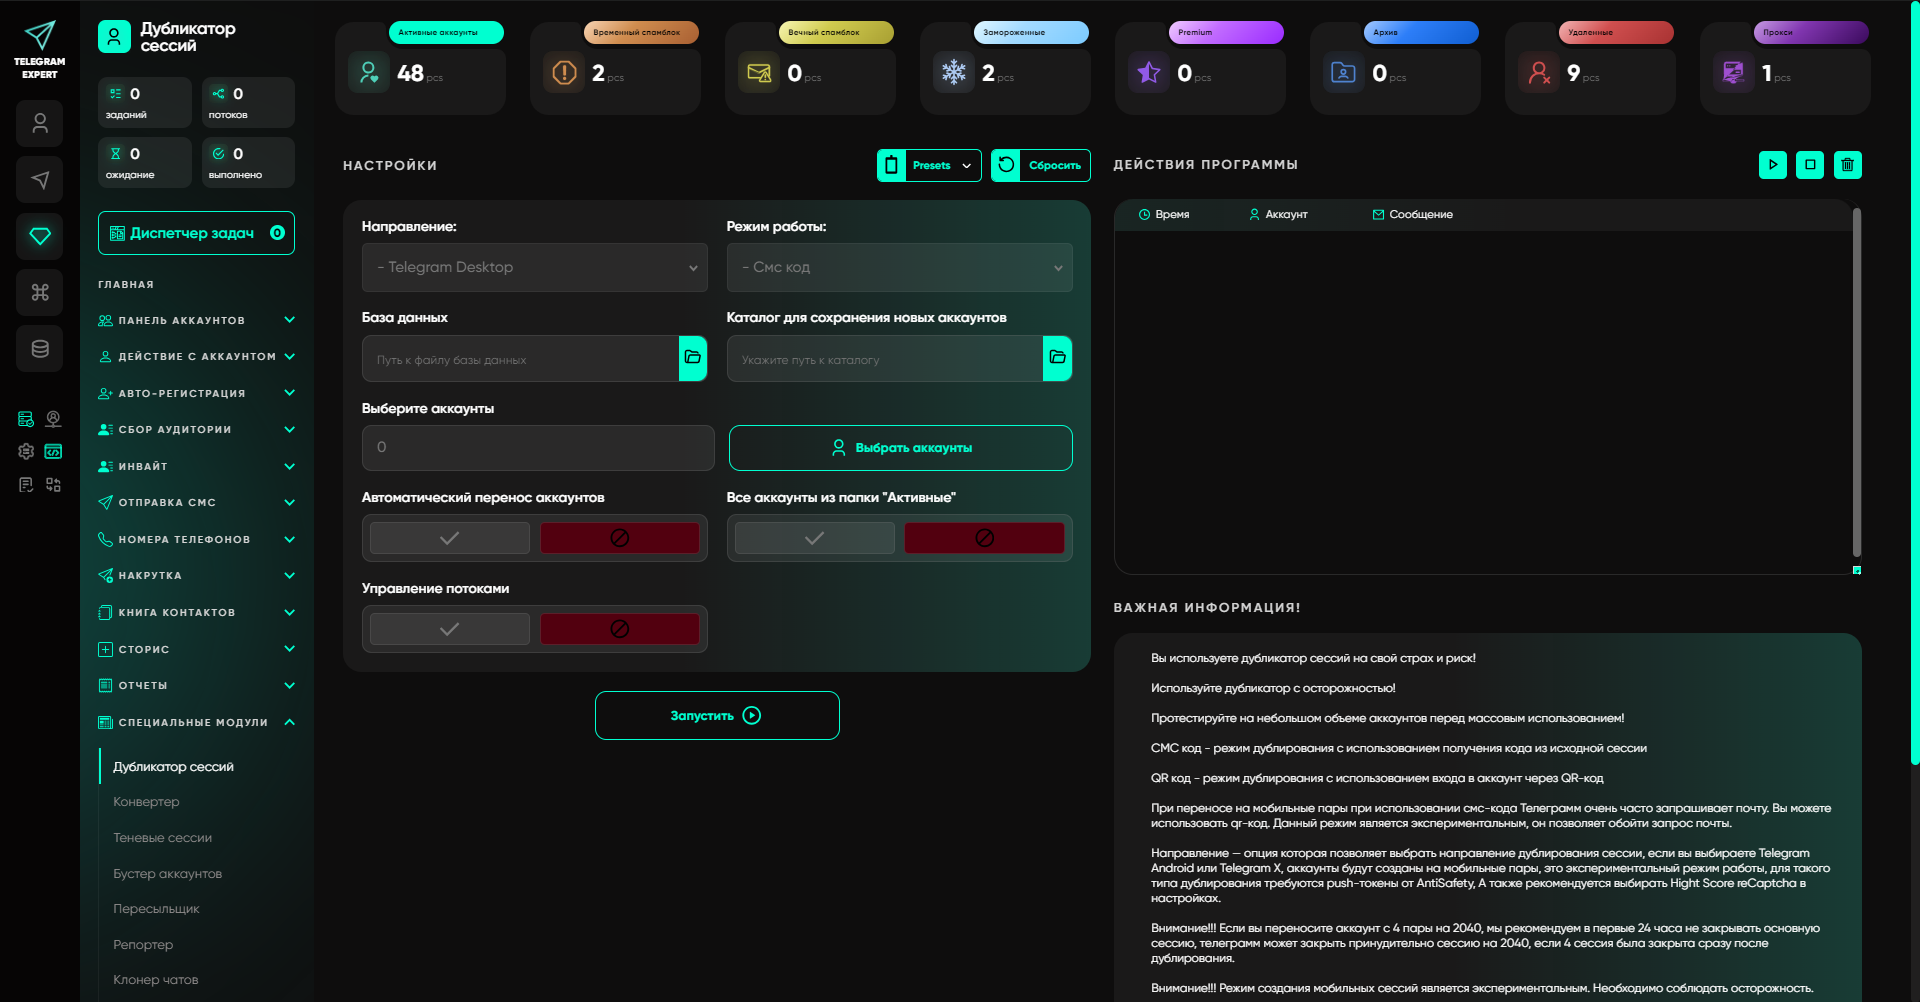
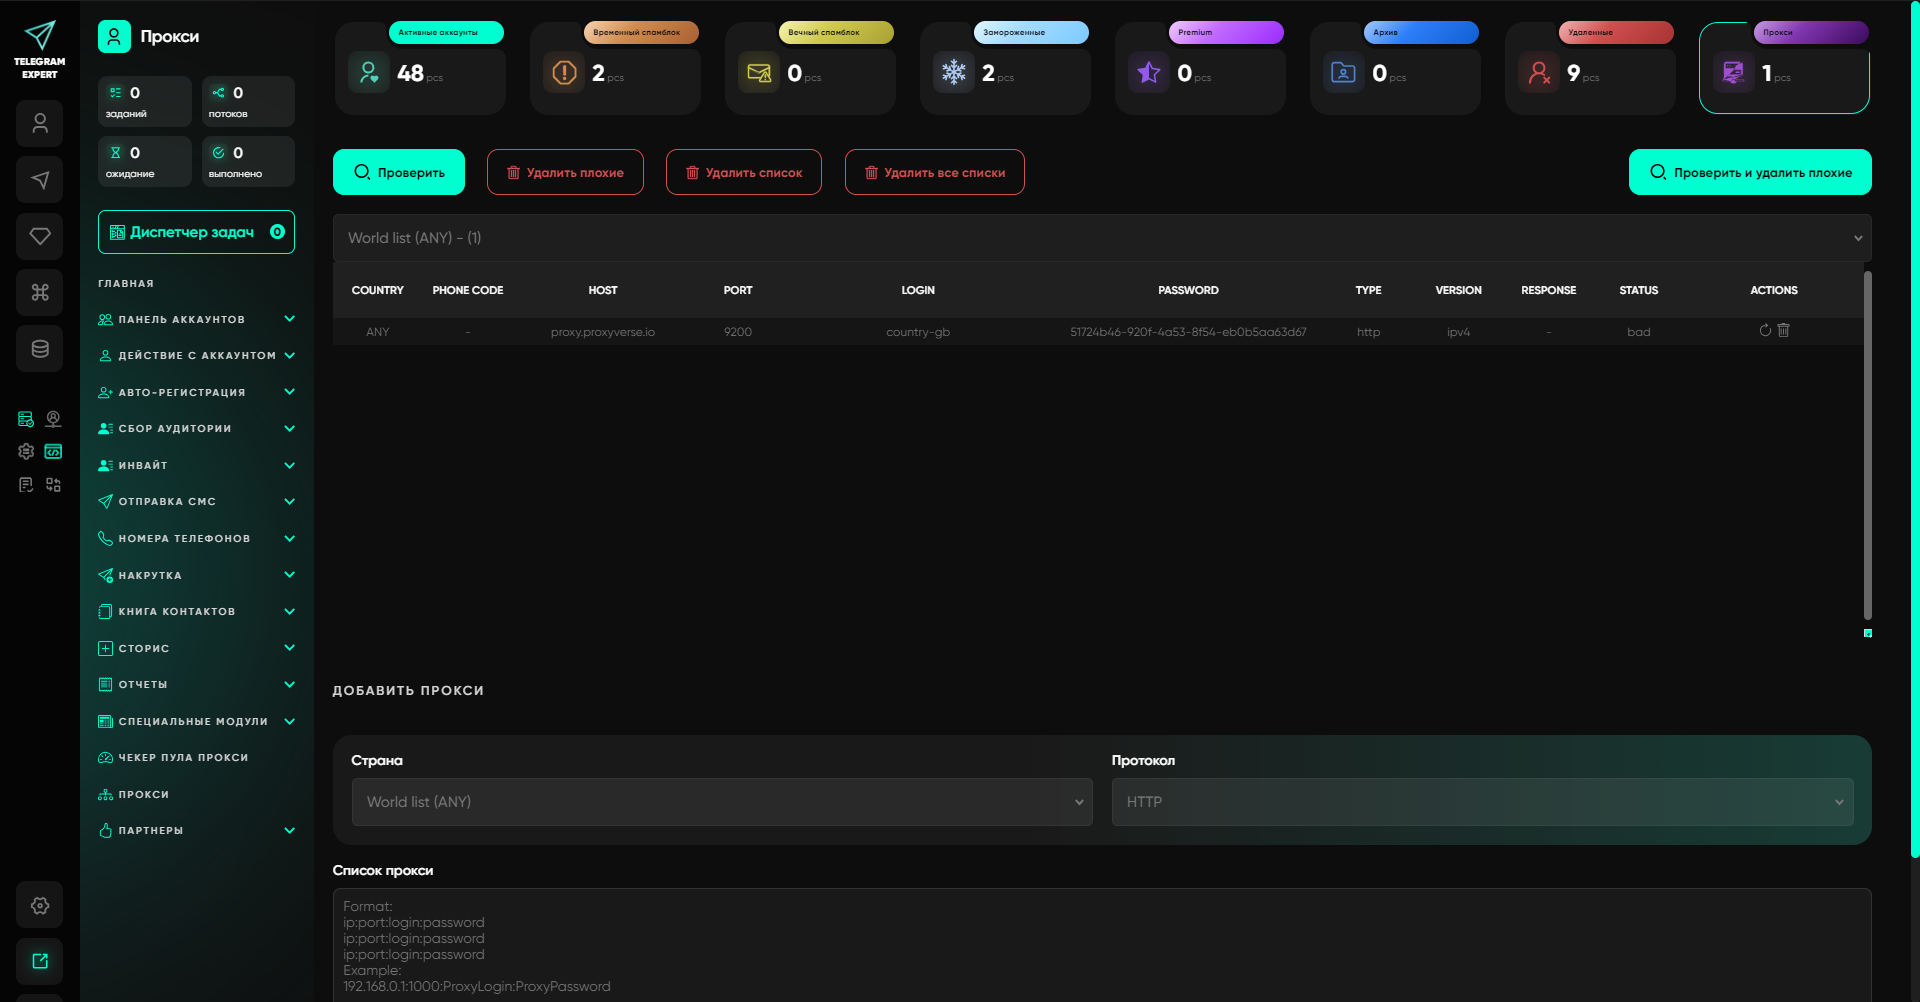
Por lo tanto, Telegram Soft Expert no puede considerarse únicamente como una herramienta para trabajar con proxies. Los proxies se encargan de la conexión, mientras que el programa gestiona el proceso de trabajo en sí: las cuentas, sus estados, las bases de datos, las audiencias, la comunicación y los resultados de operaciones individuales.FAQ sobre fallos en la automatización de Telegram
¿Es necesario cambiar el proxy después de FLOOD_WAIT?
El propio FLOOD_WAIT_X indica la necesidad de esperar el tiempo especificado antes de repetir la acción. La documentación de Telegram no describe el cambio de IP como una forma de cancelar esta espera.
¿Se puede reintentar CHAT_WRITE_FORBIDDEN?El reintento automático de la misma acción no resolverá el problema. El error significa que la cuenta actual no puede enviar un mensaje a ese chat. Es necesario cambiar las condiciones de la operación o excluir el registro.
¿Qué hacer después de un timeout?
Primero determinar si la acción pudo haberse ejecutado ya. Para el envío de mensajes, Telegram proporciona un mecanismo de correspondencia entre operación y resultado a través de random_id y updateMessageID, por lo que una respuesta perdida no siempre significa un envío fallido.
¿Cuántas veces reintentar una solicitud?
Telegram no tiene un número universal de reintentos para todos los métodos. El número de intentos depende del tipo de operación y del error. Para fallos temporales se necesitan reintentos limitados con aumento de intervalo, mientras que para errores definitivos no se necesita reintento.
¿Cuándo realmente se necesita un nuevo proxy?
Cuando hay señales de un problema de conexión o de una ruta específica. Los errores de permisos, privacidad, datos incorrectos y restricciones del servidor no se convierten en problemas de red solo porque la operación se ejecute a través de un proxy.
Una política de reintentos correcta no comienza con la cantidad de proxies ni con el número de reintentos. Comienza con la clasificación del error. Si Telegram restringió temporalmente la acción, la tarea debe esperar. Si el problema está en la ruta, se puede cambiar el proxy. Si la acción está prohibida, el registro debe finalizarse. Si el cliente no recibió respuesta después de la operación, primero hay que descartar que la acción ya se haya ejecutado.
Telegram Soft Expert es útil precisamente en el siguiente nivel. Con un gran número de cuentas y registros, estos estados no deben mantenerse en la memoria, sino fijarse en bases de datos, estados y resultados de procesamiento. Entonces el fallo de una operación individual sigue siendo una operación individual, y no se convierte en una reejecución de toda la tarea.
Artículos relacionados

Soporte al Cliente 24/7: Lo Que los Operadores Realmente Necesitan
Soporte al cliente 24/7 explicado para operadores de proxies y automatización. KPIs, SLAs, preguntas para proveedores y flujos de escalamiento reales que reducen el tiempo de inactividad.
Qué es un Forward Proxy: Guía completa para 2026
Aprende qué es un forward proxy, cómo funciona para el tráfico saliente y por qué los equipos lo usan con navegadores antidetección para Facebook, TikTok y web scraping.

Clave API de Bing Search: Configuración, Pruebas y Escalado en 2026
Obtén una clave API de Bing Search funcional en 2026, prueba solicitudes, protege la clave y escala scraping de alto volumen sin bloqueos. Guía práctica para equipos técnicos.

10 Formas de Recopilar Datos Cualitativos para Compradores de Medios
Descubre 10 formas de recopilar datos cualitativos de tus usuarios. Aprende métodos como entrevistas y grupos focales para optimizar el uso de proxies y la estrategia de campañas.
Para Qué Se Usa un Proxy: Guía de Arbitraje 2026
Para qué se usa un proxy - Descubre para qué se utiliza un proxy en 2026, desde mejorar la seguridad hasta gestionar operaciones multiaccount para equipos de arbitraje
¿Qué es el 99.9% de Uptime? Desglose Práctico para Usuarios de Proxies
¿Qué es el 99.9% de uptime? Convierte este porcentaje en tiempo de inactividad diario, mensual y anual, compara niveles de servicio y revisa los SLAs antes de comprar.