Понимание маркетинговых исследований: руководство для медиабайера
Освойте маркетинговые исследования для медиабайеров и арбитража. Изучите сбор данных через прокси, анализ кампаний и подводные камни, которых следует избегать в 2026 году.
Вы запускаете геотаргетированную кампанию в Facebook на рынок, который на бумаге выглядел дешёвым. CPM резко взлетает, качество модерации падает, а аккаунты начинают быстро стареть. Или вы фармите чистую партию профилей TikTok в AdsPower, но после изменения правил детекции платформой доверие рушится. Такой исход часто считают невезением.
Обычно это не так.
Для операторов понимание маркетинговых исследований не имеет ничего общего с академическими отчётами или отполированными презентациями. Это дисциплина изучения того, как поведёт себя рынок, платформа или аудитория, прежде чем вы сожжёте бюджет, потеряете аккаунты или масштабируете в тупик. В арбитраже трафика маркетинговые исследования - это часть ежедневных операций. Они влияют на то, какое гео вы тестируете, какому пулу прокси доверяете, как валидируете потоки клоакинга и отражают ли ваши собранные данные реальных пользователей или просто смещение вашей собственной инфраструктуры.
Содержание
- Почему маркетинговые исследования важны для арбитража и работы с аккаунтами
- Переосмысление целей исследований для технических команд
- Основные методологии сбора цифровых данных
- Автоматизация сбора данных с помощью прокси и скраперов
- Анализ данных для практических инсайтов кампании
- Преодоление технических подводных камней и смещения данных
- Правовые и этические границы в операциях, основанных на данных
Почему маркетинговые исследования важны для арбитража и работы с аккаунтами
Многие неудачные кампании списывают на креативы, трекинг или дисциплину медиабаинга. Иногда это правда. Но многие потери начинаются раньше - на уровне исследований.
Если ваша команда не знает, как выглядит воронка в целевом гео, что продвигают местные конкуренты, как ведёт себя модерация объявлений в зависимости от типа аккаунта или как пользователи видят страницу с резидентского подключения, вы покупаете вслепую. То же касается фарминга аккаунтов. Когда выращенные активы быстро умирают, операторы часто корректируют процедуры прогрева или отпечатки браузера в Dolphin Anty, GoLogin, Multilogin или Hidemyacc. Им также следует спросить, были ли неверными исходные рыночные предположения.
Исследование - это операционная функция
Маркетинговые исследования важны, потому что защищают маржу и качество активов. Они показывают, где растёт насыщенность, какие углы уже перегружены, где ломаются пути клоакинга и выглядят ли ваши геотаргетированные кампании нормально со стороны аудитории.
Примерно 80% компаний по всему миру проводят маркетинговые исследования, чтобы собирать информацию о производительности, клиентах, трендах и конкурентах, что показывает, насколько стандартной стала эта практика в цифровых операциях, а не только в традиционных бизнес-командах (Salesforce о проведении маркетинговых исследований). В арбитраже эта же привычка применяется к валидации оффера, верификации рекламы, проверке цен, выгрузке SERP и мониторингу локальных конкурентов.
Если вы выстраиваете рабочие процессы вокруг использования прокси для маркетинговых исследований, дело не в том, чтобы собрать больше данных. Дело в том, чтобы собрать данные, которые изменят следующее решение.
Практическое правило: Если этап исследования не сокращает потери бюджета, не улучшает выживаемость аккаунтов и не заостряет геотаргетинг, это, вероятно, шум.
Как выглядят плохие исследования на практике
Плохие маркетинговые исследования внутри команды байеров обычно проявляются так:
- Масштабируется не то гео: Вы видели низкую конкуренцию из узкой выборки парсинга, но местное рекламное давление уже было высоким.
- Верификация рекламы вводит в заблуждение: Вы проверили страницу через неправильный тип IP, поэтому путь пользователя выглядел чистым, когда реальная аудитория видела что-то другое.
- Работа с аккаунтами неправильно интерпретируется: Проблему TikTok или Facebook списывают на настройку браузера, хотя реальная проблема - непоследовательное рыночное поведение в разных регионах.
- Клоакинг тестируется в вакууме: Клоакер работает против одного пути проверки, а затем не срабатывает при других региональных условиях.
Хорошие операторы не отделяют исследование от исполнения. Они рассматривают его как первую часть исполнения.
Переосмысление целей исследований для технических команд
Большинство советов по маркетинговым исследованиям говорят об осведомлённости, настроениях и портретах покупателей. Это слишком мягко для команд, управляющих аккаунтами Facebook, расходами в TikTok, флотами скраперов и фармингом аккаунтов.
Техническим командам нужны цели исследований, которые могут привести к прямому действию. Не широкие вопросы. Конкретные.
Начните с операционного вопроса
Полезная цель исследования начинается с производственной проблемы. Если кампания застопорилась в Германии, цель не «лучше понять рынок». Она выглядит скорее так:
- Какие три VSL-хука чаще всего встречаются в живых воронках конкурентов для этой категории офферов?
- Какие элементы лендинга меняются между чистым резидентским визитом и визитом из дата-центра?
- Меняется ли поведение модерации TikTok, когда профиль браузера в AdsPower не соответствует прокси-окружению?
- В каком гео наименьшая насыщенность для этого угла при сохранении стабильного здоровья аккаунтов?
- Выдерживает ли клоакинг повторную проверку с смешанных резидентских и мобильных путей?
Эти вопросы достаточно узкие, чтобы на них можно было ответить. Они также производят что-то, на основе чего ваша команда может действовать сегодня.
Переводите бизнес-язык в операционные KPI
Традиционный язык целей всё ещё имеет ценность, но операторы должны переписывать его в измеримые задачи.
| Общая цель | Версия оператора |
|---|---|
| Понять конкурентов | Спарсить активные лендинги, выявить повторяющиеся утверждения, сравнить структуру локализованных CTA |
| Улучшить таргетинг | Валидировать доставку геотаргетированной кампании по городам и типам IP |
| Снизить риск соответствия | Проверить поведение клоакинга по множественным профилям устройств и локаций |
| Улучшить производительность аккаунтов | Отслеживать здоровье аккаунтов по настройке браузера, длине сессии и постоянству IP |
Суть в том, чтобы связать каждый исследовательский бриф с одним из трёх результатов: запуск, блокировка или изменение.
Формулируйте вопросы с учётом ограничений
Сильные команды не определяют цели абстрактно. Они определяют их исходя из того, что они могут собрать.
Например, если вы проводите верификацию рекламы в Facebook и TikTok, у вас уже могут быть контейнеры браузера в Dolphin Anty или GoLogin, политика ротации, логи скраперов, заметки по модерации и локальные скриншоты. Этого достаточно, чтобы задавать лучшие вопросы, чем многие другие команды.
Используйте простой фильтр:
- Можем ли мы собрать это чисто?
- Можем ли мы сравнить это по гео или группам аккаунтов?
- Изменит ли ответ распределение бюджета, обработку аккаунтов или настройку воронки?
Если ответ на третий вопрос - нет, откажитесь от этого.
Исследования становятся дорогими, когда команды собирают данные, потому что могут, а не потому что результат изменит закупку или операции.
Правильные цели для реальных задач операторов
Для технических команд вот какие цели стоит сохранить:
- Анализ воронок конкурентов: Сравнить видимые рекламные углы, структуры прелендингов и фрейминг офферов по странам.
- Картирование детекции платформ: Отследить, где Facebook и TikTok начинают отмечать несоответствия в настройке аккаунта, браузера и IP.
- Валидация клоакинга: Протестировать, что видят ревьюеры, пользователи и пути автоматизации при разных условиях.
- Контроль качества фарминга аккаунтов: Наблюдать, как ведут себя активы при разных таймингах сессий и настройках идентичности.
- Верификация геотаргетированных кампаний: Подтвердить, что локальные пользователи получают рекламу, страницу и локализованный опыт, который вы считаете, что предоставляете.
Слабые цели исследований создают красивые дашборды. Сильные - останавливают вас от масштабирования мусора.
Основные методологии сбора цифровых данных
Байер проверяет воронку конкурента из Берлина на одной настройке, затем проверяет ту же воронку из Мадрида на другой. Версия страницы меняется, блок с ценой перемещается, а комментарии к объявлению выглядят чище, чем часом ранее. Если микс прокси, идентичность браузера и метод сбора несогласованы, команда не исследует рынок. Она исследует свои собственные ошибки настройки.
В этом разница, которая имеет значение для технических команд. Для арбитража и фарминга аккаунтов проблема не только в точности данных. Это репрезентативность данных. Если ваш путь сбора не соответствует пользователю, ревьюеру или состоянию платформы, которое вы хотите наблюдать, ваша исследовательская выборка уже искажена до начала анализа.
Первичные методы в рабочих процессах операторов
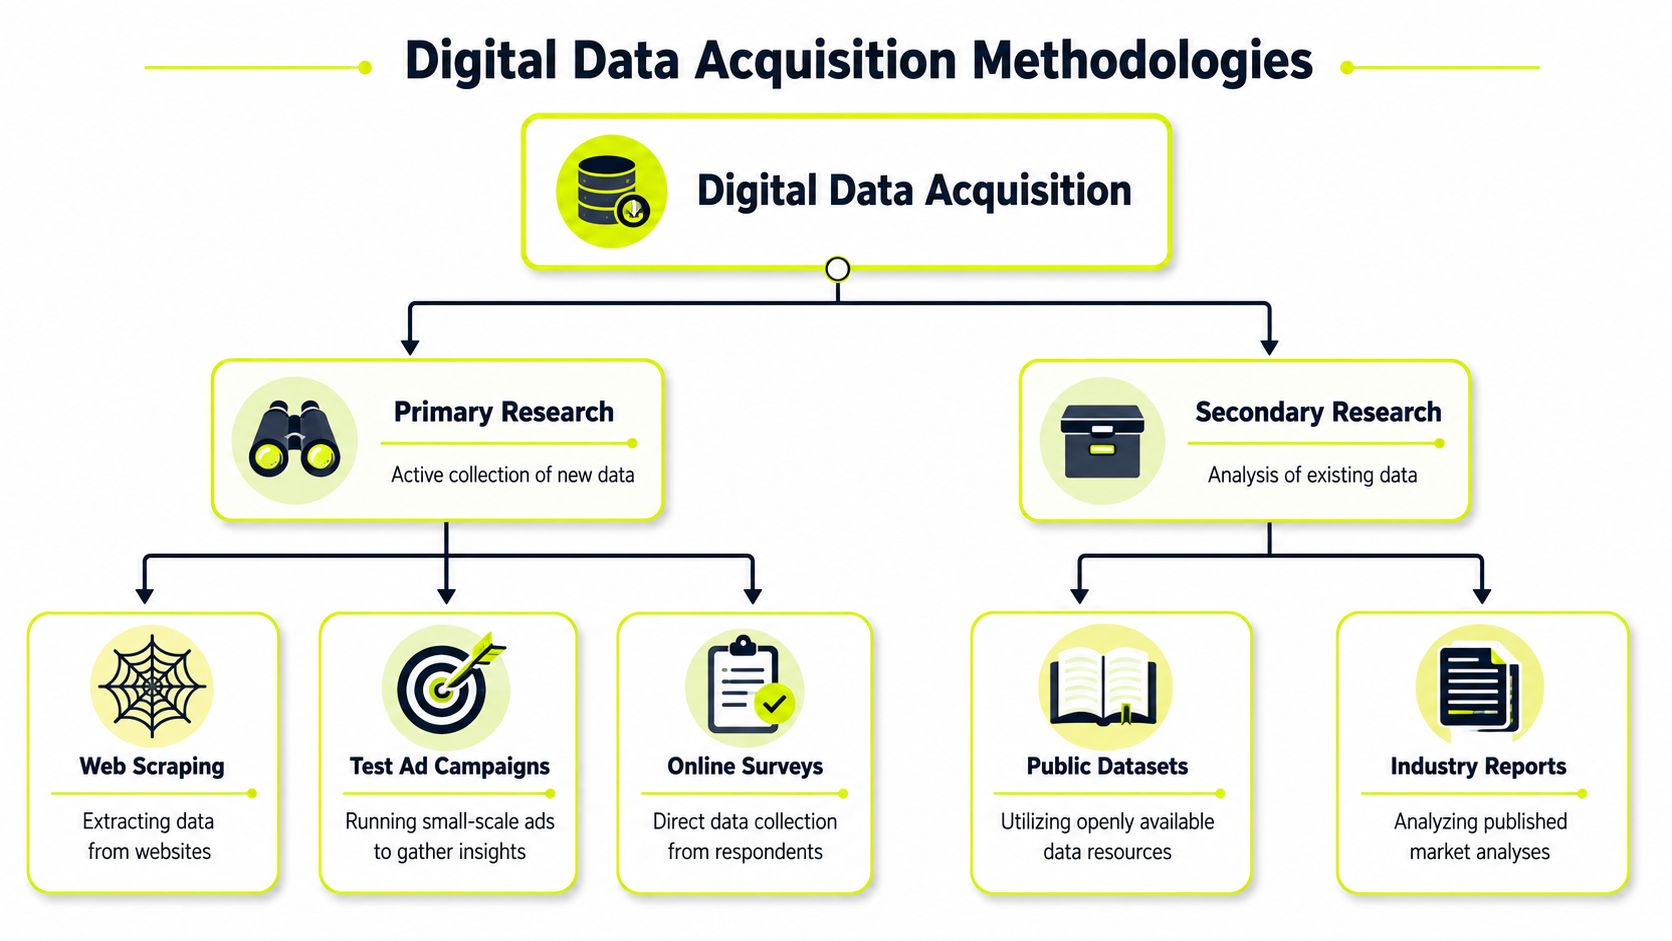
Первичное исследование означает создание свежих наблюдений в контролируемых условиях. На практике это обычно означает проведение проверок через те же окружения, от которых зависят ваши кампании. Команды используют живые превью рекламы, зондирующие кампании с малым бюджетом, контролируемые посещения страниц по гео, повторные захваты конкурентов и тесты путей ревьюеров.
Эта работа стоит времени и денег. Она также даёт самый чистый сигнал, когда поведение платформы быстро меняется.
Команда медиабаинга может запустить ограниченный тест для сравнения уровней модерации по кластерам аккаунтов. Команда по работе с аккаунтами может открыть один и тот же пункт назначения через разные резидентские выходы, чтобы подтвердить, получают ли локальные пользователи один и тот же лендинг, слой перевода и поток оформления заказа. Команда клоакинга может протестировать тайминг, класс устройства и путь реферала, чтобы картировать, какая версия появляется при каждом условии.
Распространённые первичные методы включают:
- Веб-скрапинг: Выгрузка лендингов, страниц с ценами, страниц отзывов, позиций в SERP или записей из библиотеки рекламы по расписанию.
- Тестовые рекламные кампании: Запуск зондов с малым бюджетом для наблюдения паттернов модерации, поведения доставки, качества комментариев и локального рендеринга.
- Циклы прямой обратной связи: Сбор отзывов после клика, логов поддержки или ответов собственной аудитории, когда вы контролируете источник трафика.
Команды, которые строятся вокруг API, часто принимают лучшие решения по сбору, потому что определяют сущности, поля и логику обновления до начала парсинга. Практичным справочником является это руководство по рабочему процессу API социальных медиа для структурированного сбора данных.
Вторичные методы, экономящие время
Вторичное исследование начинается с материала, который у вас уже есть или к которому вы можете получить доступ без генерации нового трафика. Это включает логи кампаний, заметки об отклонениях, историю сессий браузера, архивированные скриншоты, публичные библиотеки рекламы, страницы конкурентов, захваченные ранее, заметки партнёрских сетей и любую внутреннюю запись, связанную с расходами или качеством аккаунтов.
Здесь дисциплинированные команды сокращают потери.
Хорошая вторичная работа сужает вопросы до того, как кто-либо потратит деньги на свежие тесты. Если шестимесячные логи показывают падение модерации только на одной партии аккаунтов, нет причин начинать с широкого рыночного исследования. Сначала проверьте происхождение аккаунтов, постоянство профилей браузера, назначение прокси и последовательность прогрева. Если архивированные захваты конкурентов показывают одинаковый каденс цен по трём гео, следующий шаг - проверить, происходят ли видимые различия из-за стратегии локального инвентаря или из-за вашего пути сбора.
То же правило применяется к статистическим заявлениям. Большие исторические датасеты и объединённые исследования могут усилить принятие решений, но только когда источник задокументирован и выборка соответствует окружению, в котором вы работаете. Без атрибуции конкретные цифры о размере выборки, снижении ошибок, силе корреляции или предсказательной подъёмной силе не должны определять решения по кампаниям.
Как выбрать между ними
Используйте первичный сбор, когда ответ зависит от живой доставки, принуждения платформы, локализованного рендеринга или поведения, специфичного для сессии. Используйте вторичный анализ, когда нужно сузить поле, подтвердить, что паттерн повторяется, или решить, стоит ли свежий тест риска аккаунта.
Практичное разделение выглядит так:
- Начните с первичного для проверок доставки рекламы, валидации пути ревьюеров, тестов клоакинга и рендеринга локальных страниц.
- Начните с вторичного для повторяющихся проблем с модерацией, насыщенности категорий, картирования творческих трендов и сравнения воронок во времени.
- Используйте оба вместе для всего, что меняет распределение бюджета, ротацию аккаунтов или политику инфраструктуры.
Метод имеет значение, но окружение имеет значение не меньше. Парсинг с неправильного класса IP, проверка с перегруженного профиля браузера или зондирующая кампания из слабого фарма могут превратить чистую методологию в плохое исследование. Сильные операторы выбирают метод и контекст сбора вместе.
Автоматизация сбора данных с помощью прокси и скраперов
Ручная проверка говорит, что конкурент продвигает мягкую advertorial в Германии. Парсинг с вашего сервера показывает, что страница чистая. Команда аккаунтов логинится с повторно используемого IP дата-центра и получает третью версию с мёртвой ссылкой. Одна воронка, три разных наблюдения. Проблема не в объёме. Проблема в контексте сбора.
Вот почему автоматизация для арбитражных исследований начинается с репрезентативности, а не скорости. Если слой прокси, идентичность браузера и паттерн запросов не соответствуют аудитории или состоянию аккаунта, которое вы пытаетесь измерить, скрапер соберёт много данных и всё равно ответит на неправильный вопрос.
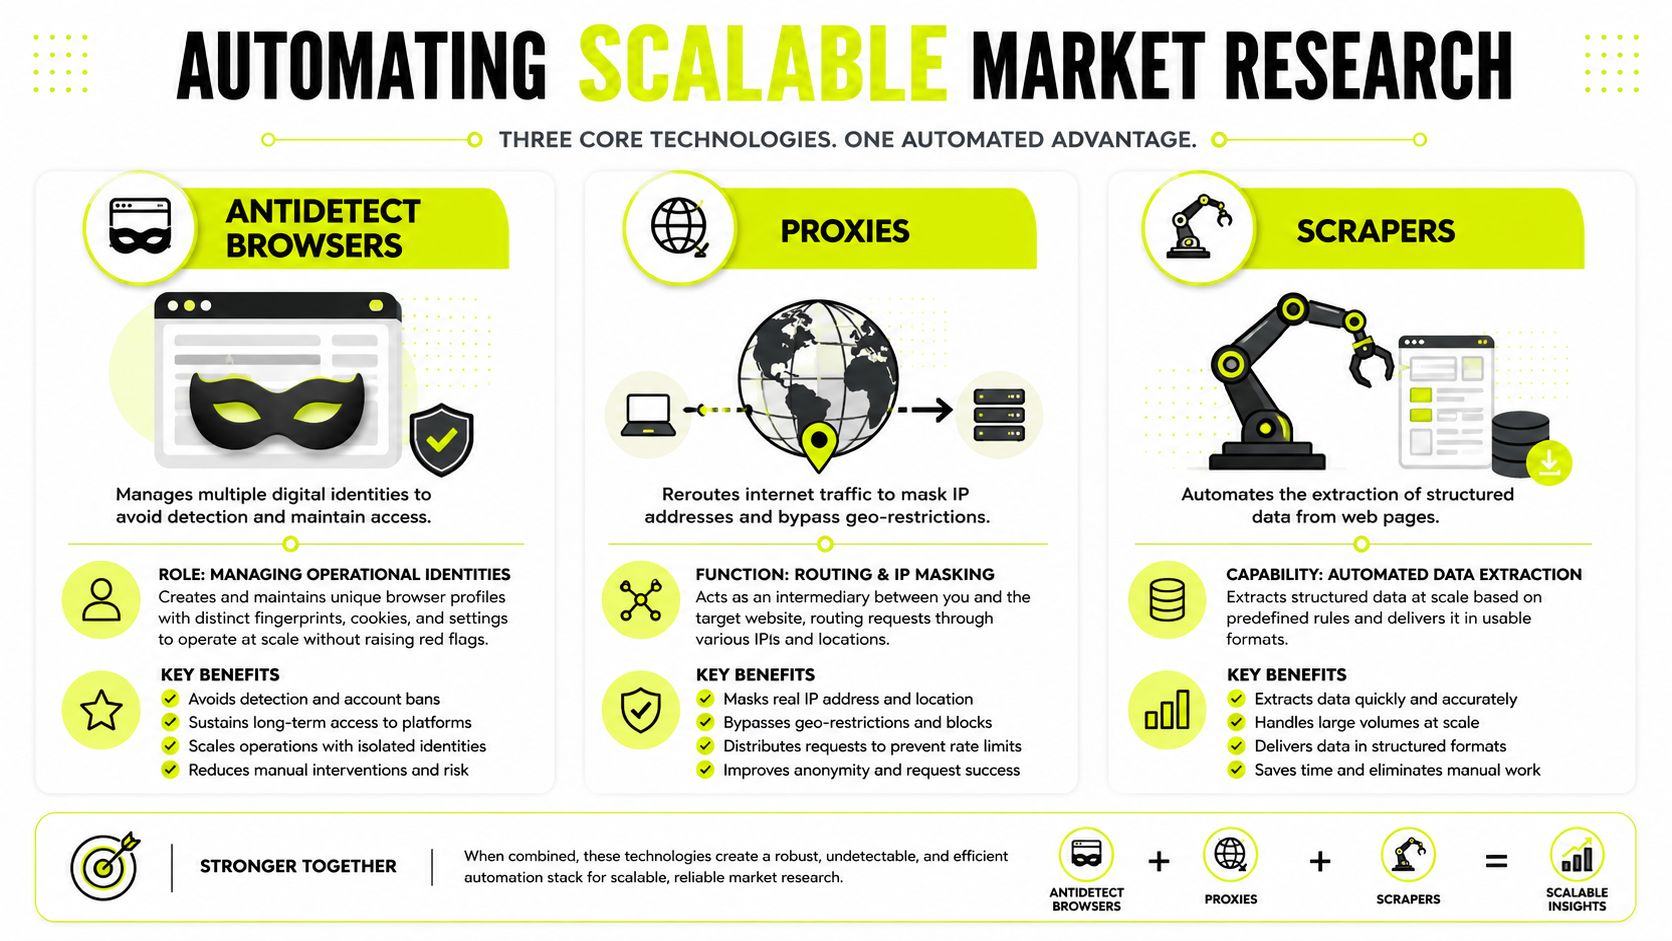
Рабочий стек обычно имеет три слоя. Антидетект-браузеры удерживают стабильные идентичности. Прокси определяют сетевой путь и географию. Скраперы обрабатывают повторные выборки, парсинг, повторные попытки и логи.
Что на самом деле делает каждый слой
Инструменты вроде AdsPower, Dolphin Anty, GoLogin, Multilogin и Hidemyacc делают одну работу хорошо. Они сохраняют отпечатки браузера, куки, локальное хранилище и непрерывность сессии, чтобы каждый аккаунт или путь исследования оставался изолированным.
Прокси отвечают на другой вопрос. Они определяют, как целевая платформа классифицирует визит. Резидентский, мобильный, дата-центровский и IPv6 трафик не обрабатываются одинаково, и эта разница меняет то, что представляет ваша исследовательская выборка. Прокси - это не просто инструмент доступа. Это часть методологии.
Скраперы находятся поверх этого фундамента. Они выгружают страницы по расписанию, захватывают HTML или скриншоты, извлекают поля и повторяют неудавшиеся запросы. Для более крупных операций веб-скрапинга полезная настройка - та, которая связывает каждую выборку с её окружением: класс прокси, гео, профиль браузера, временная метка и качество ответа.
После того, как стек на месте, это пошаговое руководство - полезная визуальная справка для рабочего процесса автоматизации:
Выбор правильного типа прокси для задачи
Выбор прокси изменяет набор результатов, особенно в арбитражной работе, где платформы персонализируют по региону, устройству, истории сессий и сигналам доверия.
| Тип прокси | Лучшее применение | Сильная сторона | Ограничение |
|---|---|---|---|
| Резидентские | Верификация рекламы, проверки пути локального пользователя, работа с аккаунтами | Ближе всего к обычному потребительскому трафику | Более высокая цена и меньшая пропускная способность в крупных парсинг-задачах |
| Мобильные | Проверки мобильных приложений, валидация социальных платформ, пути app-store | Полезны, где контекст оператора влияет на доставку или доверие | Дорогие и неэффективные для широкого извлечения |
| Дата-центровские | Массовый парсинг, быстрый разбор, недорогой мониторинг | Высокая скорость и низкая стоимость единицы | Более вероятно классифицируются как автоматизированный трафик |
| IPv6 | Отдельные региональные задачи и масштабирование с меньшей стоимостью в совместимых окружениях | Большие адресные пулы | Результаты варьируются в зависимости от целевой платформы и качества настройки |
Практичное правило здесь помогает. Используйте дата-центровские для задач мониторинга, где вам важны охват и скорость. Используйте резидентские или мобильные, когда вам нужно знать, как доставка выглядит для реального пользователя или как ведёт себя аккаунт в реалистичных условиях. IPv6 может хорошо работать в узких настройках, но только после валидации того, что платформа обрабатывает этот трафик так же, как обрабатывалась бы ваша целевая аудитория.
Проектирование сессий для фарминга и верификации аккаунтов
Политика сессий имеет такое же значение, как тип IP. Аккаунтные фермы падают, когда идентичность браузера говорит об одном пользователе, а сетевое поведение - о десяти операторах и скрипте.
В ежедневной работе с аккаунтами стабильные сессии обычно превосходят агрессивную ротацию. Профиль Facebook, который логинится через тот же город, тот же профиль устройства и тот же постоянный IP, имеет связную историю для наращивания. Если тот же профиль слишком часто прыгает по сетям, доверие падает, чекпоинты учащаются, и трения при проверке появляются быстрее. Точная толерантность варьируется в зависимости от платформы, возраста аккаунта и паттерна действий, поэтому жёсткие числовые правила рискованны, если источник не задокументирован и не соответствует вашему окружению.
В этом проблема заимствованных бенчмарков. Широкий объяснитель маркетинговых исследований вроде Hanover Research о маркетинговых исследованиях полезен для фреймирования методологии, но это не источник для операционных прокси-порогов в фарминге аккаунтов. На практике команды должны валидировать длину сессии, правила ротации и частоту сбоев внутри своих собственных ферм и логировать результат по платформе, гео и когорте аккаунтов.
Разделение, которое я использую, прямолинейно:
- Фарминг аккаунтов: постоянные сессии, один профиль браузера на аккаунт, медленный ритм логинов, никаких ненужных смен IP
- Верификация рекламы: контролируемые сессии с правильным гео, контекстом устройства и достаточной стойкостью для воспроизведения доставки
- Парсинг публичных страниц: ротация на основе чувствительности цели, лимитов запросов и паттернов сбоя парсера
- Проверки клоакинга: множественные типы сессий из множественных классов IP, потому что один чистый путь доказывает очень мало
В масштабе преимущество приходит от согласования окружения сбора с решением, которое вам нужно принять. Если цель - оценить, что испытывают пользователи в целевом гео, репрезентативный трафик важнее, чем сырой счётчик выборок. Если цель - широкий мониторинг конкурентов, трафик с меньшей стоимостью может быть достаточен, пока команда правильно маркирует этот датасет и не обрабатывает его как пользовательски-репрезентативное доказательство.
Анализ данных для практических инсайтов кампании
Команда проводит проверки модерации по пяти гео, видит всплеск зелёных статусов и к полудню масштабирует расходы. К вечеру качество конверсий снижается, две партии аккаунтов нестабильны, а выигрышный креатив работал только в точной настройке сбора, использованной для исследования. Промах был не из-за недостатка данных. Промах был из-за слабого анализа, привязанного к нерепрезентативному окружению.
Как структурировать исходные данные
Действенный анализ начинается с формата записи, который соответствует решениям, которые принимает ваша команда. Если цель - выбрать креатив, отсечь плохой стек браузеров или проверить, стабильна ли воронка по гео, каждая запись нуждается в достаточном контексте, чтобы объяснить результат позже.
Используйте электронную таблицу, базу Airtable или лёгкую SQL-таблицу. Инструмент важен меньше, чем схема.
Каждая строка должна отвечать на пять вопросов:
- Что вы наблюдали
- Где вы это наблюдали
- Когда это произошло
- Какое окружение сбора это произвело
- Какое действие предприняла команда
Для кампаний и операций с аккаунтами полезными полями обычно являются гео, тип устройства, профиль браузера, класс прокси, постоянство сессии, возрастной диапазон аккаунта, рекламный угол, вариант лендинга, результат модерации, видимый CTA и заметки о редиректах или поведении клоакинга. Для вывода скрапера добавьте статус ответа, успех парсера, повторные попытки, изменения DOM и исходил ли запрос из пользовательски-репрезентативного пути или пути мониторинга с меньшей стоимостью.
Это различие имеет значение на практике. Команды, запускающие партнёрские кампании, часто получают лучшие решения, когда они картируют креативы, прелендинги и поведение конверсий в зависимости от гео и условий трафика так же, как они картируют операционные входные данные в рабочем процессе партнёрской маркетинговой кампании. Агрегированные числа скрывают слишком много.
Как найти сигналы, выдерживающие масштабирование
Как только записи чисты, анализируйте их так же, как оператор проверяет живой риск кампании. Смотрите по сегментам, во времени и по повторяющимся паттерн-группам.
- Сегмент: Разбейте результаты по гео, устройству, типу прокси, когорте аккаунтов и настройке браузера.
- Время: Проверьте, что изменилось после обновления платформы, толчка бюджета, изменения правила ротации или новой партии фарма.
- Кластер: Сгруппируйте креативы и лендинги по типу утверждений, визуальной структуре, языку CTA или риску соответствия.
Формальные исследовательские методы всё ещё помогают здесь, как объясняется в руководстве Forbes Advisor по маркетинговым исследованиям, которое включает пример многофакторной регрессии на 50 000 потребительских ответах. В том приведённом примере анализ изолировал восприятие бренда как драйвер намерения покупки, с коэффициентом 0,42 и p < 0,005, и 10%-ное улучшение восприятия бренда соответствовало 4,2%-ному увеличению намерения покупки. Практичный урок для арбитражных команд прост. Не обрабатывайте поверхностную победу как доказательство. Проверьте, сохраняется ли результат после того, как вы контролируете гео, качество инвентаря, состояние аккаунта и окружение сбора.
Креатив может выглядеть сильным, потому что аккаунты были свежими, модерации были легче в одном регионе или исследовательский трафик был чище, чем трафик, с которым столкнётся ваша кампания.
Практический цикл проверки
Процесс проверки должен заканчиваться операционным решением, а не ещё одной вкладкой дашборда.
Я использую пятишаговый цикл:
- Нормализуйте метки, чтобы гео, устройства, классы прокси и состояния модерации назывались одинаково по всем источникам.
- Тегируйте повторяемые паттерны в копирайте, визуалах, утверждениях, шагах воронки и результатах модерации.
- Сравните репрезентативные и удобные данные, чтобы увидеть, пришла ли находка из реальных пользовательских условий или просто из самого лёгкого пути сбора.
- Быстро отмечайте аномалии, такие как несоответствия рендеринга, внезапные падения модерации, сбои парсера или локальные изменения офферов.
- Назначьте одно конкретное действие с владельцем и дедлайном.
Этот финальный шаг - место, где исследование становится полезным. Запустите угол сначала в одном гео. Остановите стек браузера, который работает только при дата-центровском трафике. Повторно запустите проверки клоакинга через резидентскую сессию. Разделите партии аккаунтов перед толчком бюджета.
Анализ - это то, что превращает сбор в преимущество. В арбитраже и фарминге аккаунтов преимущество обычно приходит от определения того, какие результаты переносимы, а какие существуют только внутри настройки, которая их произвела.
Преодоление технических подводных камней и смещения данных
Команда выгружает рекламу конкурентов, лендинги и цены по пяти гео за ночь. К утру дашборд чист, теги нормализованы, а тренд выглядит очевидным. Затем кампания запускается на реальном трафике и промахивается. Проблема была не в грязных данных. Проблема была в том, что исследовательский стек взял выборку неправильной версии рынка.
Точность - это не репрезентативность
Технические команды обычно сначала фокусируются на точности сбора. Это имеет смысл. Парсерам нужен стабильный HTML, временные метки должны выравниваться, а дублирующие записи должны быть удалены до того, как кто-либо сможет доверять выходу.
Но в арбитраже и работе с аккаунтами больший риск - репрезентативность. Скрапер может захватить страницу идеально и всё равно захватить неправильный опыт.
Это происходит постоянно с выбором прокси. IP дата-центров дешевле, быстрее и легче масштабируются. Они также более вероятно попадают на альтернативные версии страниц, потоки вызовов, обрезанные активы или трафик, который оценивается как подозрительный до полной загрузки контента. Резидентские сессии стоят дороже и труднее управляемы чисто, но часто производят версию рынка, которая ближе к тому, что видят реальные пользователи, ревьюеры или системы платформ.
Я рассматриваю класс прокси как решение о выборке, а не только как решение об инфраструктуре.
Где исследования через прокси идут не так
Распространённые сбои операционные, а не академические.
- Страницы вызова, записанные как успешные выборки: Скрапер сохраняет ответ 200, но браузеру была подана проверка на бота, стена согласия или частичный рендеринг.
- Несоответствие отпечатка и сети: IP геолоцируется в Мадриде, локаль браузера польская, часовой пояс UTC, и платформа отвечает запасным опытом.
- Паттерны темпа, которые не произвёл бы ни один пользователь: Запросы приходят каждые несколько секунд из одной подсети, поэтому логика цен, инвентаря или доставки рекламы смещается.
- Растекание гео по сессиям: Пул ротации говорит одну страну, но DNS, выбор края CDN или история аккаунта указывают куда-то ещё.
- Смещение класса прокси: Исследования, собранные только через один источник трафика, отражают, как платформы обрабатывают этот источник, а не как рынок ведёт себя в целом.
Для команд, сталкивающихся с давлением блокировок, практичные контроли из избежания IP-банов во время автоматизации могут улучшить стабильность. Одной стабильности недостаточно. Стабильная настройка сбора всё равно может производить смещённое исследование, если профиль трафика не соответствует аудитории, ревьюеру или пути модерации, который вам нужно понять.
Что проверяют хорошие команды перед тем, как доверять результатам
Я смотрю на дрейф окружения до того, как смотрю на диаграмму. Если одна и та же лендинг-страница конвертирует, рендерится или проходит модерацию по-разному по классам прокси, я предполагаю, что исследовательская настройка - часть результата, пока не доказано обратное.
Используемый валидационный проход обычно включает три проверки. Во-первых, сравните ключевые страницы как минимум в двух окружениях трафика. Во-вторых, загрузите те же цели через стек браузера, используемый в живых операциях, а не только сырые запросы. В-третьих, проверьте выборку вручную на порядок загрузки активов, локальное ценообразование, подсказки модерации, редиректы и поведение согласия.
Это важнее всего в фарминге аккаунтов и верификации рекламы. Уровни модерации, видимость рекламы и даже то, какой копирайт показывается, могут меняться в зависимости от сетевого следа за сессией. Стандартные руководства по маркетинговым исследованиям оформляют это как проблему точности данных. На практике это проблема репрезентативности. Если ваше окружение сбора не напоминает окружение, где происходят бюджеты, модерации и клики пользователей, анализ будет дрейфовать.
Компромисс прост. Быстрый, дешёвый сбор увеличивает объём. Репрезентативный сбор защищает решения. В масштабе второй экономит больше денег.
Правовые и этические границы в операциях, основанных на данных
Команда выгружает рекламу конкурентов через один прокси-пул, проверяет доставку через другой, затем логинится в прогретые аккаунты из третьего окружения. Отчёты выглядят чисто. Аккаунты - нет. Этот разрыв - место, где начинают пересекаться юридическое воздействие, нарушения политик и плохие исследовательские решения.
Для арбитража и работы с аккаунтами реальный вопрос не в том, разрешён ли сбор данных в абстрактном смысле. Вопрос в том, соответствует ли рабочий процесс сценарию использования, правилам платформы и сигналам идентичности, привязанным к сессии. Сбор публичных страниц, скрапинг с логином, верификация рекламы, прогрев аккаунтов и клоакинг не несут одинаковый риск. Обработка их как одной корзины - это то, как команды оказываются со слабыми контролями и вводящими в заблуждение исследованиями.
Правила платформ, которые нельзя игнорировать
Meta и TikTok обеспечивают соблюдение вокруг автоматизации, постоянства идентичности, обманчивого поведения и целостности аккаунтов. Эти проверки попадают точно в стек, который операторы используют каждый день в AdsPower, Dolphin Anty, GoLogin, Multilogin и Hidemyacc. Качество профиля браузера имеет значение. Класс IP имеет значение. История сессий имеет значение. Также имеет значение то, только наблюдает ли действие страницу или активно меняет состояние аккаунта.
Одна граница ясна. Meta запрещает клоакинг и другие методы, которые показывают ревьюерам другой контент от того, что видят пользователи, как заявлено в рекламных стандартах и политических материалах Meta. Это имеет значение операционно, потому что исследовательские окружения часто перетекают в производственные привычки. Настройка, построенная для проверки рекламы по гео, может дрейфовать в поведение, которое платформы читают как введение в заблуждение, если слой идентичности, поведение пункта назначения и маршрутизация сессии перестают выстраиваться.
Практичный вывод прост. Выбор инфраструктуры - часть соответствия. Они также формируют валидность исследований. Если слой прокси меняет то, как платформы классифицируют сессию, тогда ваши находки могут описывать лабораторное окружение, а не рынок, на котором вы планируете покупать трафик.
Управление рисками в реальных рабочих процессах
Я использую базовую проверку перед одобрением любого рабочего процесса сбора или работы с аккаунтами:
- Является ли цель публичной или требует логина или членства?
- Мы наблюдаем контент, собираем данные в масштабе или меняем состояние аккаунта?
- Изменяет ли настройка сигналы идентичности способом, который платформа могла бы обрабатывать как обманчивый?
- Могут ли данные включать персональную информацию, комментарии, юзернеймы или другие идентификаторы?
- Если бы логи платформы или юридический советник проверили этот рабочий процесс, выдержали бы намерение и контроли?
Этот фильтр быстро меняет решения.
| Рабочий процесс | Основной риск |
|---|---|
| Скрапинг публичных страниц конкурентов | Обеспечение условий, ограничения темпа, юридические вопросы, специфичные для юрисдикции |
| Скрапинг за аутентифицированным доступом | Более высокое договорное воздействие и более сильный юридический риск |
| Верификация рекламы по гео | Более низкий риск контента, но постоянство сессии и репутация прокси всё равно имеют значение |
| Фарминг аккаунтов | Прямая целостность аккаунта и воздействие обеспечения |
| Клоакинг | Явное нарушение политики и высокий риск приостановки |
Операционная ошибка - предположение, что юридический риск и риск платформы - это одно и то же. Они связаны, но ломаются в разных местах. Рабочий процесс может быть легальным в узком смысле и всё равно получать ограничения аккаунтов, потому что платформа читает паттерн идентичности как абузивный. Рабочий процесс также может оставаться внутри правил платформы и всё равно создавать проблемы приватности, если конвейер сбора хранит персональные данные без чёткой основы или политики сохранения.
Хорошие команды документируют намерения, изолируют исследования от производства, логируют, кто что запускал, и держат правила сохранения жёсткими. GDPR и CCPA становятся актуальными быстро, когда спарсенный контент включает юзернеймы, комментарии, email'ы, подсказки локации или что-либо, что может связать активность обратно к человеку.
Операторы, которые остаются в этой области годами, не обрабатывают этику как PR-язык. Они обрабатывают это как системное проектирование. Если метод зависит от скрытого переключения идентичности, непоследовательных пунктов назначения или сбора данных, которые вы не можете оправдать хранением, рабочий процесс слаб ещё до запуска кампании.
Если ваша команда запускает крупномасштабный скрапинг, геотаргетированную верификацию рекламы, работу с аккаунтами Facebook и TikTok или маркетинговые исследования, которые зависят от реалистичного покрытия IP, Sota Proxy построен для этой рабочей нагрузки. Он даёт техническим командам резидентские, мобильные, ISP и дата-центровские прокси-опции в более чем 220 геолокациях, с контролем постоянных и ротационных сессий, который подходит как для исследовательских, так и для рабочих процессов с аккаунтами. Для операторов, которым нужна стабильная инфраструктура вместо сетевого метода проб и ошибок, это практичный стек для оценки.
Похожие статьи
Альтернативы Decodo в 2026 году: куда переходить есть смысл, а куда нет
Decodo - лидер по цене среди ротационных резидентных прокси и один из самых дорогих провайдеров выделенных ISP-прокси. Актуальные цены на оба типа, реальные причины ухода клиентов и какая альтернатива подходит в каждом случае.
Альтернативы Webshare в 2026 году: когда самые дешёвые прокси перестают быть выгодными
Webshare раздаёт 10 прокси бесплатно и продаёт статические резидентные IP по $0,30 за адрес - в десять раз дешевле большинства конкурентов. Проверенные цены, четыре причины, по которым клиенты всё равно уходят, и одна причина остаться.
Dolphin Anty для мультиаккаунтинга: возможности, автоматизация и настройка прокси
Как работать с Dolphin Anty: создание браузерных профилей, Cookie Robot, сценарии, Synchronizer, автоматизация через API и три способа подключения прокси SotaProxy. Промокод SOTA20 дает скидку 20%.
ISP, резидентные, дата-центровые и мобильные прокси: какие действительно нужны вам
Статические резидентные и ISP-прокси - это один и тот же продукт под разными названиями, поэтому половина сравнений сводится к сопоставлению вещи с самой собой. Разбираем типы прокси, их реальную стоимость за единицу и конкретные задачи, для которых каждый тип подходит лучше всего.
Почему рабочего прокси недостаточно: чек-лист ToDetect перед запуском
Рабочий прокси не гарантирует стабильное окружение браузера. Узнайте, как ToDetect проверяет IP, DNS, WebRTC и признаки отпечатка браузера перед запуском.
Сколько аккаунтов X (Twitter) можно иметь в 2026 году (лимит 10 - это ограничение на номер телефона, а не на количество аккаунтов)
X не публикует ограничений на количество аккаунтов на одного человека. Упоминаемая всеми цифра 10 - это число аккаунтов, которые можно привязать к одному номеру телефона. Реальные ограничения - это 50 постов в день для бесплатного аккаунта, дублирование сценариев использования и взаимодействие между аккаунтами.