Веб-скрапинг на PHP: руководство для операторов и арбитражников
Создавайте надёжные боты для веб-скрапинга на PHP для мультиаккаунтинга, верификации рекламы и клоакинга. Научитесь обрабатывать JS, ротировать прокси и обходить блокировки. Для операторов.
Ваш PHP-скрапер, вероятно, нормально работал на тестовом сайте. Затем вы направили его на реальную цель, используемую для верификации рекламы, мониторинга конкурентов, проверки клоакинга или фарма аккаунтов, и всё развалилось. Вы получили страницу отказа в доступе, полуотрисованную разметку, пустые узлы или фальшивый успешный ответ с бесполезным HTML.
Вот в этом разрыве большинство туториалов перестают быть полезными. Реальные операторы, скрапящие посадочные страницы, партнёрские воронки, витрины магазинов, рекламные поверхности Facebook или креативные страницы TikTok, нуждаются не только в селекторах. Им нужен рабочий процесс, который выдерживает рендеринг JavaScript, ротацию прокси, проверки цифровых отпечатков браузера, геотаргетированные ответы и лимиты частоты запросов. Если вы ведёте кампании через несколько рекламных аккаунтов в AdsPower, Dolphin Anty, GoLogin, Multilogin или Hidemyacc, ваш скрапер - часть того же инфраструктурного стека. Он должен вести себя соответствующе.
Оглавление
- Почему ваш базовый PHP-скрапер не работает
- Выбор набора инструментов для PHP-скрапинга
- Построение базовой логики скрапинга
- Работа с сайтами на JavaScript
- Интеграция прокси для обхода блокировок и геотаргетинга
- Продвинутые методы обхода и противодействие антиботам
- Масштабирование PHP-скрапинга
Почему ваш базовый PHP-скрапер не работает
Простой вызов file_get_contents() работает на сайтах, которые отдают основной контент в первом HTML-ответе. Такие сайты всё ещё существуют, но это не та среда, в которой работает большинство команд медиабаинга. При первой же попытке скрапить цель, связанную с рекламными аккаунтами Facebook, рекламными аккаунтами TikTok, потоками фарма аккаунтов или геотаргетированными витринами, вы сталкиваетесь с системами, предназначенными для быстрой классификации трафика.
Паттерн отказа предсказуем. Ваш скрипт запрашивает страницу и получает одно из четырёх: страницу с challenge, неполный HTML, локализованный вариант, которого вы не ожидали, или разметку, которая имеет смысл только после выполнения клиентского JavaScript. Скрапер не сломан. Ваши предположения сломаны.
Базовый код fetch-and-parse не работает, потому что современные цели не просто отдают страницы. Они оценивают паттерны запросов, репутацию IP, заголовки, куки, поведение сессии, а иногда и полное окружение браузера.
Это важно для арбитражных команд. Если вы проверяете заклоаченные страницы, валидируете рекламные размещения или мониторите доступность офферов по гео, неправильный ответ хуже, чем отсутствие ответа. Он отравляет ваши данные и приводит к плохим решениям в распределении бюджета.
Что ломается первым в боевых условиях
- Контент, отрисованный JavaScript, появляется пустым в PHP, потому что стандартный парсинг DOM не выполняет клиентский код.
- Проверки идентификации помечают явный бот-трафик. Голый запрос со слабыми заголовками и шумным датацентровым IP быстро замечается.
- Гео-проверки возвращают неправильную рыночную версию, что портит локальные цены, язык и проверки соответствия.
- Потоки, зависящие от сессии, ломаются, если вы не сохраняете куки или не следуете тем же переходам состояния, что и браузер.
Если вы используете мультиаккаунтинг в GoLogin, AdsPower, Dolphin Anty, Multilogin или Hidemyacc, вы уже знаете, что идентификация многослойна. Скрапер, игнорирующий этот слой, долго не проживёт.
Выбор набора инструментов для PHP-скрапинга
PHP-скрапинг превратился в стек компонентов вместо единой магической библиотеки. На практике веб-скрапинг на PHP работает лучше всего, когда вы разделяете работу на обработку запросов, парсинг и выполнение браузера при необходимости. Этот переход от устаревших универсальных инструментов вроде Goutte к поддерживаемым компонентам вроде BrowserKit и DomCrawler задокументирован в обзоре современных стеков PHP-скрапинга от Firecrawl.
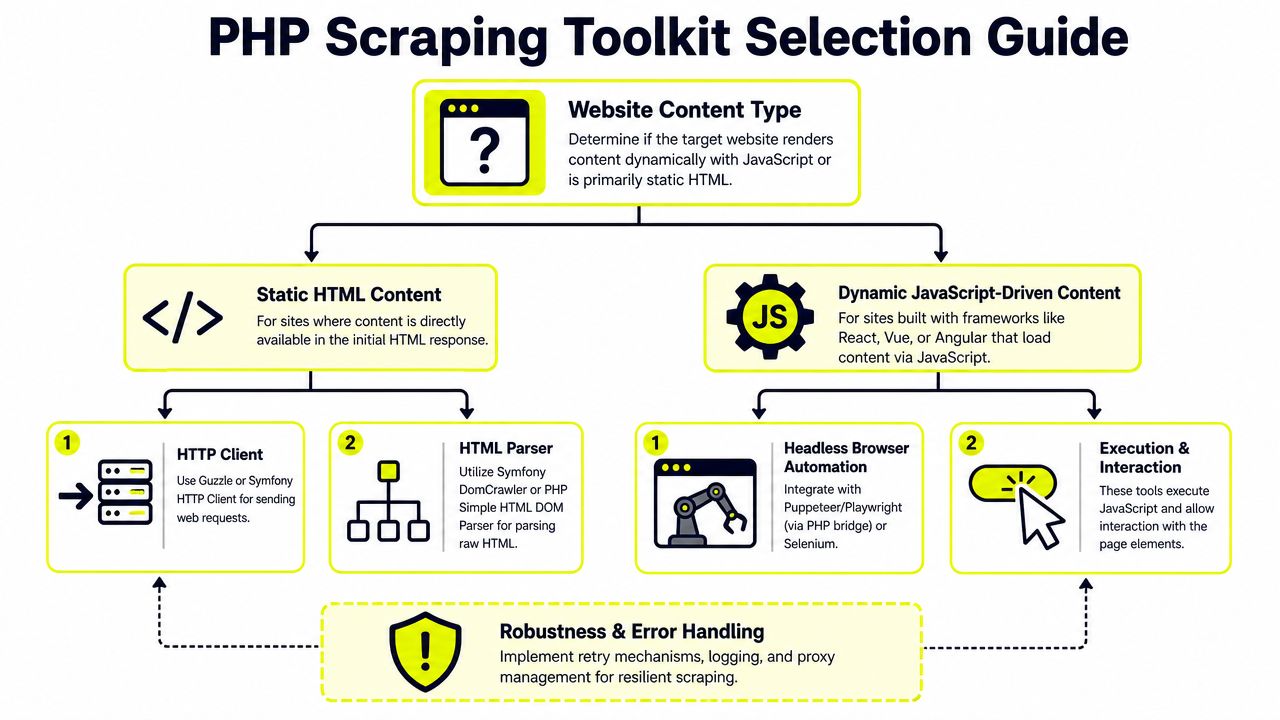
Статичные цели требуют чёткого разделения
Для статичных страниц держите стек простым.
Используйте HTTP-клиент для получения страницы. Используйте парсер для извлечения данных. Не смешивайте эти задачи, если только вы не пишете одноразовый скрипт. Надёжные комбинации в экосистеме PHP хорошо известны:
- Guzzle для запросов, когда нужны заголовки, куки, таймауты, повторы и поддержка прокси.
file_get_contents(), когда задача крошечная и вы контролируете окружение.- DOMDocument и DOMXPath, когда вы хотите нулевых дополнительных зависимостей парсера.
- Symfony DomCrawler, когда вы хотите более чистый API обхода и лучшую долгосрочную поддерживаемость.
- Roach PHP, когда работа больше похожа на краулинг, чем на единичную выборку.
Что использовать, а что оставить
Если бы я собирал сегодня стек для скрапинга для команды медиабаинга, я бы не начинал со старых обёрток-удобностей. Я бы использовал Guzzle + DomCrawler для большинства статичных целей, и добавлял бы автоматизацию браузера только после доказательства, что цель этого требует.
Вот практическая разбивка:
| Инструмент | Используйте для | Хорош в | Слабое место |
|---|---|---|---|
| Guzzle | HTTP-запросов | Заголовки, куки, конфигурация прокси, контроль запросов | Не парсит HTML |
| DOMDocument + DOMXPath | Встроенного парсинга | Встроен в PHP, хорошо работает с XPath | Многословен |
| Symfony DomCrawler | Структурированного парсинга | Более чистый обход, хорошо интегрируется со стеком Symfony | Всё ещё только статический парсинг |
| Roach PHP | Больших краулинговых рабочих процессов | Пауки, пайплайны, middleware, планирование | Больше настройки, чем для однофайлового скрапера |
| BrowserKit + DomCrawler | Имитации потока браузера на статичных сайтах | Формы, ссылки, паттерны краулера | Нет выполнения клиентского JS |
Многие старые гайды всё ещё упоминают Goutte. Не стройте на нём новую работу. Эта библиотека считается устаревшей в новых гайдах по PHP-скрапингу, и поддерживаемый путь - это стек Symfony BrowserKit плюс DomCrawler.
Практическое правило: Выбирайте самый лёгкий инструмент, который соответствует цели. Если HTML-ответ содержит данные, не запускайте браузер. Если ответ не содержит данных, никакой парсер вас не спасёт.
Для арбитражных случаев этот выбор важен. Простой монитор страницы продукта для проверок клоакинга может отлично работать на Guzzle. Поток посадочной TikTok с отрисованными элементами, локализацией и шлюзами взаимодействия - нет.
Построение базовой логики скрапинга
Для статичных целей основной конвейер прост: отправьте GET-запрос, распарсите HTML, извлеките данные селекторами, затем аккуратно проходите по пагинации. Этот точный рабочий процесс показан в пошаговом руководстве по PHP-скрапингу от FreeCodeCamp с loadHTML(), DOMXPath, извлечением на основе селекторов, sleep(1) и темпом повторов.
Базовый скрапер, который выдерживает нагрузку
Начните с Guzzle для запроса. Затем парсите встроенными DOM-инструментами или DomCrawler. Встроенный путь достаточен для многих задач:
<?php

require 'vendor/autoload.php';

use GuzzleHttp\Client;

$client = new Client([
    'timeout' => 20,
    'headers' => [
        'User-Agent' => 'Mozilla/5.0',
        'Accept-Language' => 'en-US,en;q=0.9',
    ],
]);

$response = $client->request('GET', 'https://example.com');
$html = (string) $response->getBody();

libxml_use_internal_errors(true);

$doc = new DOMDocument();
$doc->loadHTML($html);

$xpath = new DOMXPath($doc);

$items = $xpath->query('//article');
foreach ($items as $item) {
    $titleNode = $xpath->query('.//h2', $item)->item(0);
    $priceNode = $xpath->query('.//*[contains(@class, "price")]', $item)->item(0);

    $title = $titleNode ? trim($titleNode->textContent) : null;
    $price = $priceNode ? trim($priceNode->textContent) : null;

    if ($title || $price) {
        print_r([
            'title' => $title,
            'price' => $price,
        ]);
    }
}
Строка libxml_use_internal_errors(true) - не косметика. Реальные страницы часто содержат некорректную разметку. Без неё loadHTML() может заполнить логи или отказать способами, которые тратят время во время длинных прогонов.
Многие команды пропускают это и обнаруживают проблему только после краха парсера во время окна краулинга.
Пагинация без флуда
Пагинация - это место, где скрипты новичков становятся операционным риском. Обычный паттерн - либо определить формат URL страницы, либо следовать по ссылке next. Оба работают. Важен темп, поведение при повторах и возможность возобновления.
Используйте что-то подобное:
<?php

$nextUrl = 'https://example.com/page/1';
$failed = [];

while ($nextUrl) {
    try {
        $response = $client->request('GET', $nextUrl);
        $html = (string) $response->getBody();

        libxml_use_internal_errors(true);
        $doc = new DOMDocument();
        $doc->loadHTML($html);
        $xpath = new DOMXPath($doc);

        // извлекайте записи здесь

        $nextNode = $xpath->query('//a[contains(., "Next")]')->item(0);
        $nextUrl = $nextNode ? $nextNode->getAttribute('href') : null;

        sleep(1);
    } catch (\Throwable $e) {
        $failed[] = $nextUrl;
        sleep(2);
        // логика повтора может продолжиться с 4 и 8 секундами
        $nextUrl = null;
    }
}
Полезные продакшн-привычки:
- Логируйте неудавшиеся URL, чтобы можно было возобновить работу вместо перезапуска всей задачи.
- Используйте backoff для временных сбоев. Простой последовательности в 2, 4 и 8 секунд достаточно, чтобы избежать долбёжки нестабильной цели.
- Делайте паузу между страницами даже на дружелюбных сайтах.
sleep(1)- нормальный базовый уровень. - Сохраняйте сырой HTML при ошибках парсера, чтобы вы могли проверить, что вернула цель.
Если вам нужны дополнительные паттерны для поддержки скраперов после запуска, блог о прокси и автоматизации Sota Proxy стоит держать в списке справочных материалов.
Позже в рабочем процессе, когда вы перейдёте к прокси и обработке сессий, эта же логика останется. Слой выборки изменится. Дисциплина - нет.
Короткое пошаговое руководство поможет, если вы обучаете младшего специалиста в команде:
Работа с сайтами на JavaScript
Многие неудачные задачи веб-скрапинга на PHP - это не проблемы парсинга. Это проблемы рендеринга. Недавние PHP-гайды всё ещё тратят большую часть времени на статичный HTML, хотя многие живые цели теперь рендерят контент через JavaScript и требуют другого пути извлечения. Этот разрыв отмечен в обсуждении продвинутого PHP-скрапинга от Scrape.do и ограничений простого DOM-парсинга на сайтах с тяжёлым JavaScript.
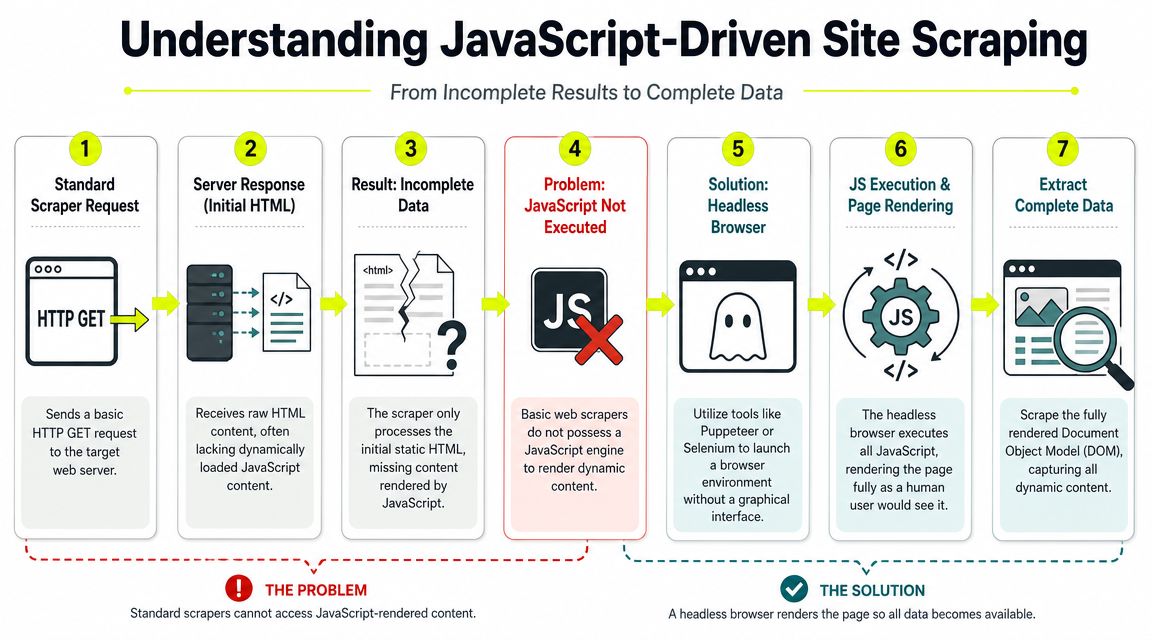
Как определить, когда одного PHP недостаточно
Откройте цель в браузере и проверьте две вещи:
- Просмотр исходного кода, а не только DOM в devtools.
- Сетевая активность после загрузки страницы.
Если нужные данные не существуют в исходном HTML-коде, Guzzle плюс DOMXPath их не извлекут. Это часто встречается на сайтах React, Vue и Angular. Это также часто на внутренних рекламных библиотеках, фильтрах витрин, панелях аккаунтов и заклоаченных страницах отзывов.
Типичные признаки:
- исходный HTML содержит заполнители или каркасную разметку
- контент появляется только после XHR или fetch-вызовов
- пагинация привязана к прокрутке или взаимодействию с кнопкой
- ключевые поля приходят через фоновые API-запросы
- антибот-проверки запускаются до показа реального контента
Если вы скрапите исходный код и получаете пустые контейнеры, прекратите добавлять селекторы. Вы решаете не ту проблему.
Headless-браузер или слой рендеринга
У вас есть два рабочих варианта.
Вариант первый - автоматизация браузера. В PHP это обычно означает Symfony Panther, привязки Selenium или мост к Puppeteer или Playwright. Это даёт вам реальное выполнение страницы, обновления DOM, клики, ожидания, сохранение кук и взаимодействие с кнопками, формами или ленивозагружаемым контентом.
Вариант второй - внешний слой рендеринга. Это может быть браузерный сервис, API для скрапинга или выделенный Node-сервис, который вызывает PHP. Это часто чище для команд, у которых уже есть PHP в продакшне, но которые не хотят локальной оркестрации браузера на каждом воркере.
Вот компромиссы:
| Метод | Хорошо подходит для | Компромисс |
|---|---|---|
| Symfony Panther | PHP-центричных стеков, требующих реального выполнения браузера | Больше нагрузки на CPU и память |
| Puppeteer или Playwright через мост | Сложных JS-сайтов с шагами взаимодействия | Дополнительный слой сервиса и больше движущихся частей |
| Selenium | Существующих окружений автоматизации браузера | Более тяжёлая инфраструктура |
| Rendering API | Команд, которые хотят держать PHP лёгким | Меньше контроля над низкоуровневым потоком браузера |
Для поверхностей Facebook и TikTok я обычно не доверяю чистому DOM-парсеру, пока не докажу, что контент в теле ответа. То же самое для потоков фарма аккаунтов, проверок профилей и валидации геоспецифичных офферов. Динамичные страницы часто требуют выполнения браузера плюс стабильного слоя идентификации. В этот момент скрапер начинает выглядеть меньше как скрипт и больше как система автоматизации.
Интеграция прокси для обхода блокировок и геотаргетинга
Если вы скрапите больше, чем горстку страниц, прокси перестают быть опциональными. Они нужны не только для избегания банов. Они также позволяют получить правильную версию страницы. Для арбитражных команд это означает проверку того же оффера, что видит пользователь в целевой стране, валидацию доставки креатива по регионам и просмотр того, что воронки Facebook или TikTok показывают из этого рынка.
Выбирайте тип прокси по цели, а не по цене
Дешёвые прокси создают дорогие плохие данные. Правильный прокси зависит от цели и паттерна сессии.
| Тип прокси | Основной вариант использования | Риск обнаружения | Производительность | Стоимость |
|---|---|---|---|---|
| Датацентровые | Быстрый скрапинг малочувствительных целей, массовый сбор, публичные страницы | Высокий | Высокая | Низкая |
| Резидентские | Верификация рекламы, e-commerce, социальные поверхности, локализованный контент | Средний | Средняя | Выше |
| Мобильные | Чувствительные социальные платформы, потоки, подобные приложениям, работа с высоким доверием | Ниже | Средняя | Выше |
| IPv6 | Высокообъёмные задачи на целях, которые чисто принимают IPv6 | Зависит от цели | Высокая | Низкая |
Несколько практических правил важнее маркетинга вендоров:
- Датацентровые прокси быстрые и дешёвые. Они работают для статичных сайтов, широкого поиска и целей со слабой защитой. Они быстрее помечаются на социальных платформах и высокоценных коммерческих целях.
- Резидентские прокси - это дефолт для серьёзного скрапинга. Они выглядят больше как обычный пользовательский трафик и работают лучше для геотаргетированных кампаний, верификации рекламы и проверок витрин.
- Мобильные прокси полезны, когда доверие важнее пропускной способности. Если вы касаетесь потоков аккаунтов Facebook, проверок аккаунтов TikTok или чувствительных процедур фарминга, мобильные часто живут дольше.
- IPv6-прокси могут быть полезны для объёма, но совместимость цели решает, практичны ли они. Некоторые сайты обрабатывают их нормально. Другие относятся к ним как к граничному трафику и ведут себя по-другому.
Я не включил ISP-прокси в таблицу, потому что вы запросили конкретные типы прокси, но они заслуживают упоминания. Они хорошо подходят для долгоживущих сессий. Если вам нужна липкая идентичность для повторных проверок, ISP-прокси часто имеют больше смысла, чем агрессивная ротация.
Резидентская ротация обычно безопасный базовый уровень для скрапинга страниц, связанных с гео, коммерцией или рекламным обзором. Мобильные - для более сложных целей. Датацентровые - для скорости, когда доверие не очень важно.
Подключение прокси в Guzzle
Сама интеграция проста. Операционные правила вокруг неё - сложная часть.
<?php

use GuzzleHttp\Client;

$client = new Client([
    'proxy' => 'http://username:password@proxy-gateway:port',
    'timeout' => 30,
    'headers' => [
        'User-Agent' => 'Mozilla/5.0',
        'Accept-Language' => 'en-US,en;q=0.9',
    ],
]);

$response = $client->request('GET', 'https://example.com');
echo (string) $response->getBody();
Что вам нужно решить:
Ротирующая или липкая сессия
- ротирующая для широкого краулинга, проверок рекламы по многим регионам и высокозапросных задач
- липкая для потоков логина, проверок состояния аккаунта и всего, что связано с куками
Таргетинг по стране или городу
- страновой уровень достаточен для большинства проверок офферов
- городской уровень важен, когда доставка рекламы или локальный инвентарь меняется по метро
Качество пула
- шумные пулы выгорают быстрее
- чистые пулы важны, если вы используете ту же инфраструктуру и для скрапинга, и для автоматизации браузера
Для команд, подключающих прокси к браузерным потокам, Sota Proxy документирует пути интеграции на своей странице интеграций прокси. Это полезно, если вы разделяете работу между PHP-получателями и браузерными сессиями в антидетект-инструментах.
Есть также бизнес-угол, который волнует некоторых операторов. Если ваша команда уже рекомендует инфраструктуру клиентам или нижестоящим покупателям, Sota Proxy имеет реферальную программу с до 40% комиссии через свою партнёрскую настройку, описанную в материалах продукта компании. Упоминайте это, только если это подходит вашей операции. Основная точка - всё ещё соответствие инфраструктуры, а не побочный доход.
Продвинутые методы обхода и противодействие антиботам
Прокси только меняет, откуда приходит запрос. Он не исправляет плохую браузерную историю. Цели оценивают полный профиль запроса. Они смотрят на заголовки, язык, непрерывность сессии, поведение кук, поток навигации, а иногда и на то, соответствует ли цифровой отпечаток браузера заявленному окружению.
Заголовки, куки и правдоподобные сессии
Самый быстрый способ быть заблокированным - отправлять стерильные запросы в масштабе. Не ротируйте только IP. Ротируйте контекст запроса контролируемо.
Используйте реалистичный набор заголовков:
- User-Agent, который соответствует реальному семейству браузеров и платформе
- Accept-Language, выровненный с вашим прокси-гео
- Referer, когда поток обычно его имеет
- Cookies, сохранённые для повторных посещений
- Поведение сессии, которое не сбрасывает идентичность на каждом запросе
Если вы скрапите публичный каталог, лёгкого управления заголовками достаточно. Если вы проверяете рекламные посадочные потоки, заклоаченные воронки или страницы, связанные с аккаунтом, вам нужна непрерывность сессии. Это означает хранилища кук, стабильное назначение прокси во время сессии и меньше резких изменений.
Список функций, подобный тому, что на странице функций платформы Sota Proxy, полезен, когда вы сопоставляете липкие сессии, контроль ротации и таргетинг по локации с дизайном скрапера.
Передача антидетект-браузеру
Для некоторых целей чистый PHP не должен быть последней милей.
Если работа включает рекламные аккаунты Facebook, рекламные аккаунты TikTok, прогрев аккаунтов, фарм аккаунтов или проверки заклоаченных кампаний, антидетект-браузер часто должен владеть сессией. AdsPower, Dolphin Anty, GoLogin, Multilogin и Hidemyacc - все существуют по одной и той же операционной причине. Они дают каждому профилю браузера связный цифровой отпечаток и постоянное состояние идентичности.
Практичный паттерн выглядит так:
- PHP собирает цели. URL, состояния офферов, списки регионов, ссылки на рекламные библиотеки.
- Очередь отправляет высокорисковые задачи браузерным воркерам.
- Антидетект-браузер открывает назначенный профиль с его привязанным прокси.
- Автоматизация браузера выполняет проверки, требующие рендеринга, кликов, состояния логина или доверия профиля.
- PHP получает структурированные данные результата для хранения и нижестоящих решений.
Это разделение работает хорошо, потому что PHP всё ещё отличен в оркестрации, парсинге, логике повторов и очистке данных. Просто он не должен притворяться полным браузером, когда цель явно заботится об идентичности браузера.
Скрапер может подделать запросы. Антидетект-профиль поддерживает идентичность. Это разные задачи.
CAPTCHA и операционные лимиты
CAPTCHA означают, что цель перешла от пассивной оценки к активному вызову. В этот момент у вас есть три варианта:
- Путь ручного решения для редких, высокоценных сессий
- Интеграция сервиса решения для повторяемой обработки challenge
- Переработка рабочего процесса, чтобы меньше задач попадало на страницы, склонные к challenge
Не относитесь к решению CAPTCHA как к первому решению. Обычно лучшее исправление выше по потоку. Уменьшите шум запросов, улучшите качество сессии, замедлитесь, держите язык и гео выровненными и прекратите пересекать идентичности между аккаунтами.
Уважайте также технические границы. robots.txt не является юридическим щитом или разрешительным токеном, но это всё же полезный сигнал для ожиданий краулинга. Более важна простая дисциплина. Не перегружайте цели. Не распыляйте повторы слепо. Не запускайте фарм-логику и скрапинговый трафик через один и тот же слабый пул и не ждите стабильных результатов.
Масштабирование PHP-скрапинга
Один PHP-скрипт полезен. Система скрапинга прибыльна. Разница - в контроле задач, изоляции воркеров и восстановлении после сбоев.
Переход от скриптов к воркерам
В масштабе прекратите запускать длинные циклы из cron и надеяться, что они завершатся. Помещайте задачи в очередь. Redis и RabbitMQ - распространённые выборы, потому что они позволяют разделить планирование и выполнение.
Чистая схема выглядит так:
- Производитель создаёт задачи из потребностей кампаний, гео-списков или мониторимых URL.
- Очередь буферизирует работу и контролирует распределение.
- Воркеры получают, парсят, рендерят или передают браузерным сессиям.
- Слой хранения держит сырые ответы, извлечённые поля и логи сбоев отдельно.
- Супервизор перезапускает мёртвые воркеры и отслеживает повторяющиеся сбои.
Это важно для мультиаккаунтных операций. Неудавшийся скрап страницы продукта - одно дело. Неудавшаяся браузерная задача верификации Facebook, связанная с прогретым профилем, - другое. Разделяйте эти рабочие нагрузки.
Конкурентность без хаоса
PHP может масштабировать пропускную способность запросов, если вы используете конкурентность осторожно. Guzzle поддерживает паттерны конкурентных запросов, чего достаточно для статичных целей, не требующих выполнения браузера. Так вы сокращаете время краулинга, не открывая сотню неконтролируемых циклов.
Несколько правил держат это в здравом уме:
- Группируйте по профилю прокси, чтобы один плохой выход не отравил каждый запрос.
- Разделяйте статичные и отрисованные задачи, потому что их ресурсные затраты разные.
- Повторяйте избирательно вместо воспроизведения полной пачки.
- Отслеживайте причину сбоя по категории. Таймаут, страница блокировки, промах парсера, промах JS или несоответствие гео.
Roach PHP также стоит рассмотреть, когда рабочая нагрузка выглядит как настоящий краулинг. Он добавляет пауков, пайплайны, middleware и планирование, что помогает, как только ваша операция PHP-скрапинга переросла автономные скрипты.
Конечное состояние простое. PHP хорошо обрабатывает оркестрацию, парсинг, хранение и логику очереди. Браузерные воркеры обрабатывают рендеринг и действия, чувствительные к идентичности. Прокси обрабатывают локальность и репутацию. Антидетект-инструменты обрабатывают сессии с высоким доверием. Как только эти роли правильно разделены, весь стек становится проще поддерживать.
Если ваши задачи скрапинга зависят от чистых геотаргетированных IP, липких сессий или ротации, которая подходит для автоматизации браузера и PHP-воркеров, Sota Proxy - один из вариантов для оценки наряду с остальной частью вашего инфраструктурного стека. Он охватывает резидентские, мобильные, ISP, датацентровые и IPv6 типы прокси, что делает его пригодным как для лёгких PHP-получателей, так и для рабочих процессов антидетект-браузеров с высоким доверием.
Похожие статьи
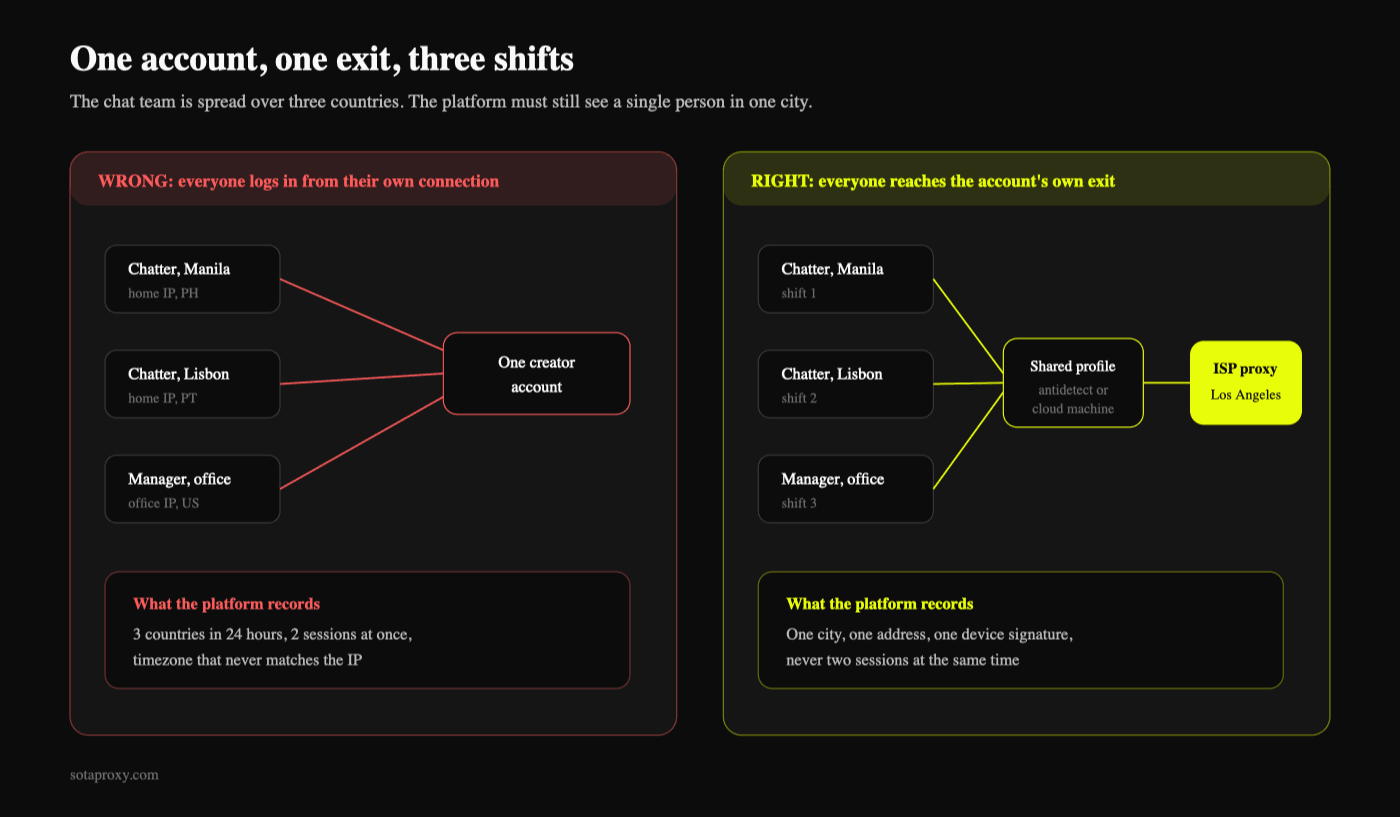
Как OnlyFans-агентства управляют 20 аккаунтами криейторов без их связывания
Что на самом деле связывает аккаунты криейторов, какой тип прокси нужен каждому из них, как чаттеры из трёх стран используют один логин, и во сколько обходится изоляционный слой по сравнению с 20–50-процентной долей агентства.
Купить прокси для гео-серфинга, которые действительно работают
Узнайте, как правильно купить прокси для гео-серфинга - выбрать типы, целевые города, настроить антидетект-браузеры и проверить геолокационные результаты.

How to Build an Advertising Traffic Protection Infrastructure with Cloaking.House and SotaProxy
Learn how to build a reliable ad traffic stack with proxies, browser profiles and cloaking for GEO testing, filtering and campaign troubleshooting.
Подмена цифровых отпечатков: методы, обнаружение и использование антидетект-браузеров
Узнайте, как работает подмена цифровых отпечатков, какие методы используются для обхода систем обнаружения, и как антидетект-браузеры вместе с прокси обеспечивают безопасную работу с множеством аккаунтов.
Мониторинг в реальном времени
Мониторинг в реальном времени. Мониторинг прокси-сетей, рекламных аккаунтов и скрейпинговых систем в режиме реального времени. Метрики, оповещения, SLA и практические тактики
Сетевая избыточность для прокси и платформ автоматизации
Узнайте, как сетевая избыточность обеспечивает бесперебойную работу прокси и платформ автоматизации. Рассматриваются активная/пассивная конфигурация, мультирегиональные кластеры, настройка отказоустойчивости и обеспечение uptime 99,9%