Як створити скрейпер відгуків Amazon, який дійсно працює
Створіть надійний скрейпер відгуків Amazon з перевіреними тактиками проксі, обходу блокування та парсингу. Покрокова інструкція для технічних фахівців та агенцій.
Якщо ви дивитесь на стіну входу, кілька виділених відгуків і пул проксі, який починає горіти в момент масштабування після тестового трафіку, ви вже знаєте проблему. Парсер відгуків Amazon - це вже не простий парсер HTML. Це конвеєр, який повинен витримати анти-бот систему Amazon, обробляти часткову видимість і все ж давати аналітикам щось достатньо чисте для аналізу настроїв, моніторингу конкурентів та дослідження продуктів.
Зміст
- З чим стикається парсер відгуків Amazon у 2026 році
- Побудова конвеєра виявлення та видобування
- Вибір правильного класу проксі для парсингу відгуків
- Тактики обходу блокувань, які витримують навантаження
- Пагінація, парсинг та крос-маркетплейс нормалізація
- Юридичні та етичні межі, які не можна перетинати
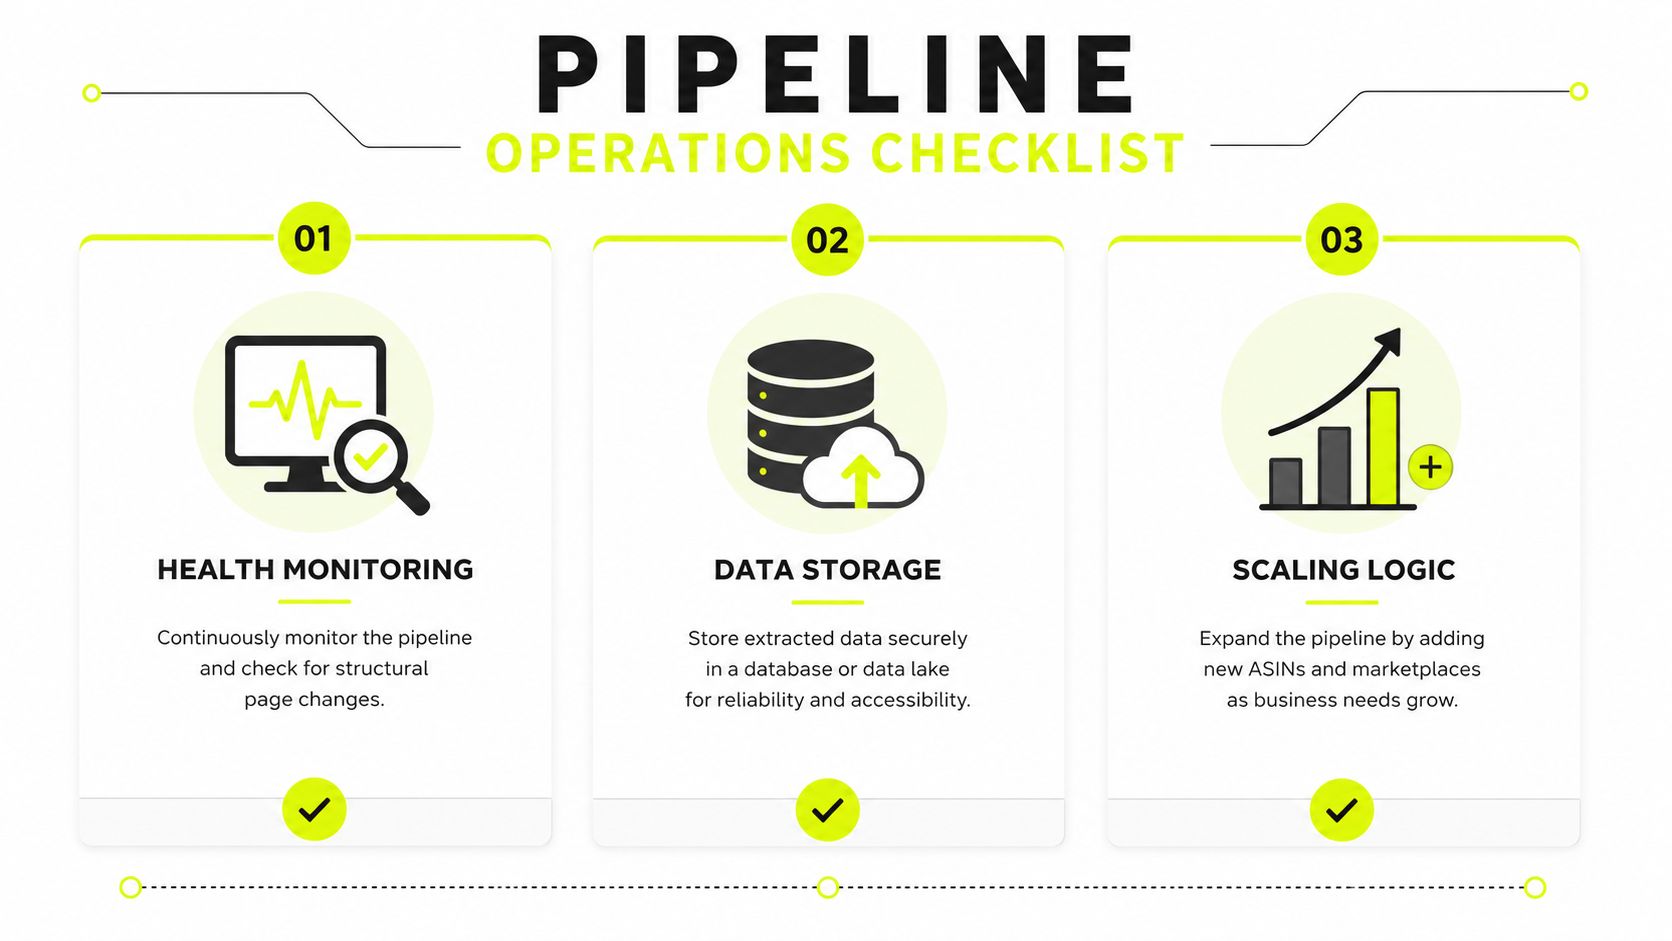
- Моніторинг, зберігання та масштабування конвеєра
З чим стикається парсер відгуків Amazon у 2026 році
Ви все ще можете швидко переглянути сторінку продукту, але старий підхід «забрати відгуки й іти далі» зник. 5 листопада 2024 року Amazon переніс майже всі відгуки за стіну входу, і ендпоінт /product-reviews/ тепер перенаправляє неавторизований трафік на сторінку входу. Те, що залишається публічним, зазвичай становить лише від 3 до 8 виділених відгуків на сторінці деталей продукту, плюс сукупний рейтинг, загальна кількість і розподіл від 5 до 1 зірки. Ця зміна перетворила парсинг відгуків з широкого видобування на обмежений доступ до даних, особливо для команд, що займаються аналізом настроїв, моніторингом конкурентів або дослідженням продуктів на різних ринках, як описано в посібнику про зміни доступу до відгуків Amazon. Зміни доступу до відгуків Amazon
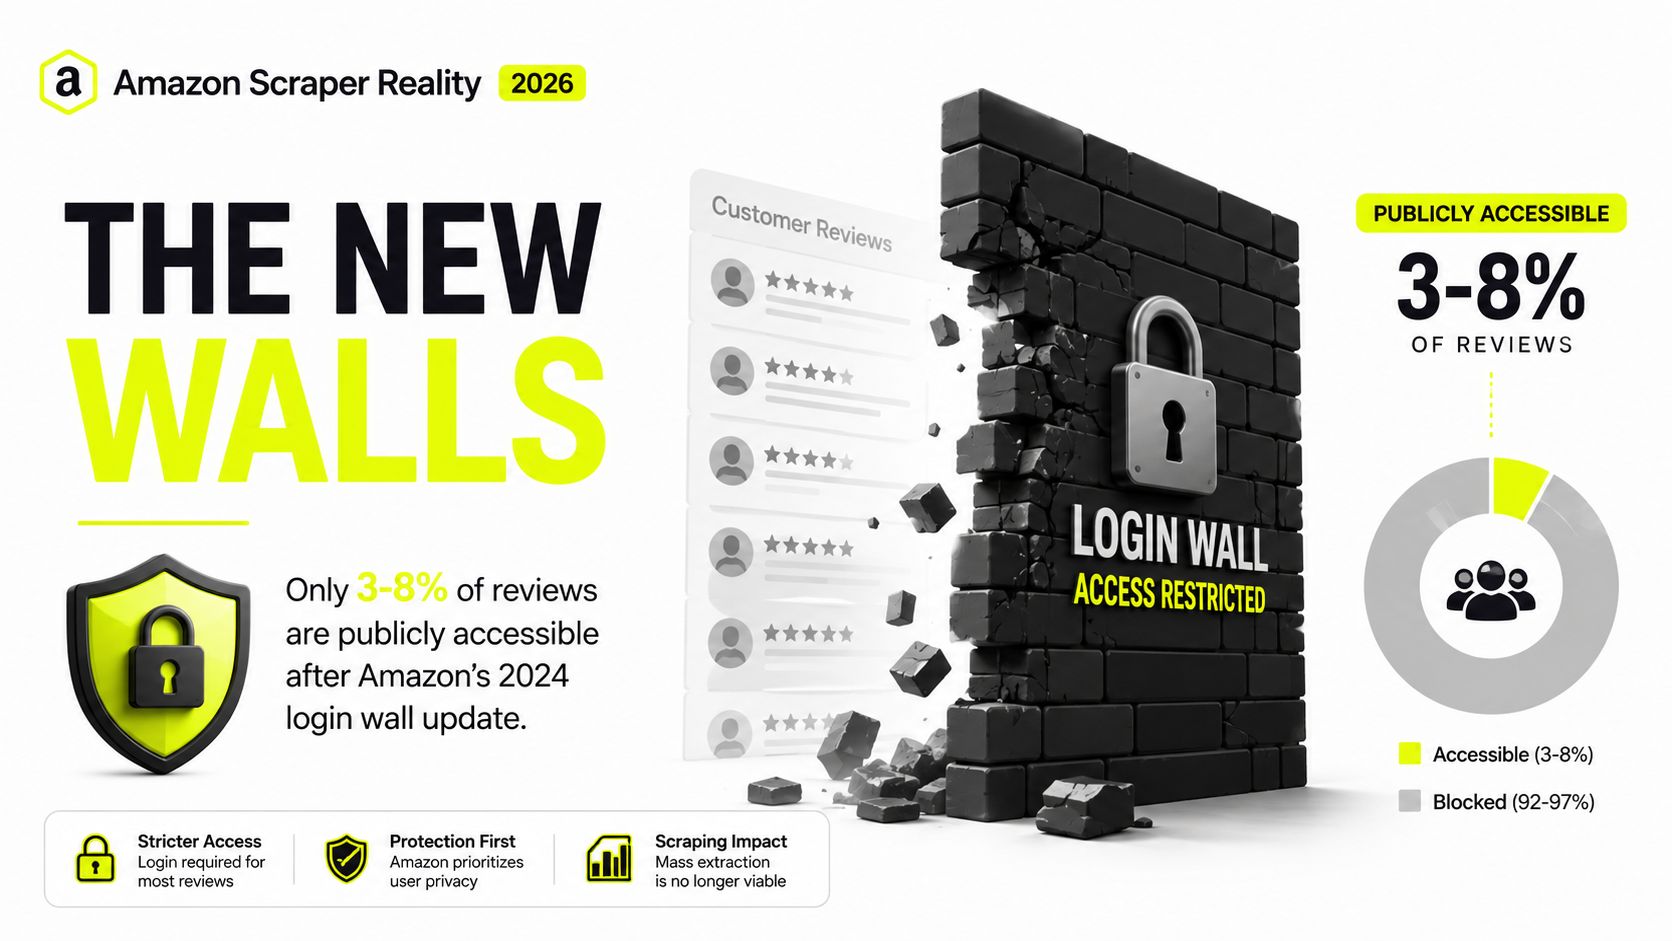
Практичний результат неприємний. Ваш перший запуск виглядає добре, потім той самий ASIN починає повертати часткові дані, порожні списки відгуків або сторінку входу, яку ваш парсер не був створений розпізнавати. Ось чому робочий процес повинен враховувати стіни входу, поведінку дроселювання та резервну логіку з самого початку, а не розглядати їх як крайні випадки. Якщо ви вже маєте справу зі суперечками щодо відгуків на сторінці продукту, ресурс про як видалити відгук з Amazon дає корисний контекст про те, як поверхня відгуків Amazon поводиться і з боку продавця.
Практичне правило: якщо сторінка відгуків виглядає легкою на першому URL, припускайте, що складніший шлях з'являється, щойно ви переходите до пагінації, змінюєте локаль або повторно використовуєте сесію.
Більша пастка - це розбіжність між маркетплейсами. Конвеєр, який виглядає здоровим на одному домені, все одно може зазнати невдачі в момент порівняння amazon.com з amazon.co.uk, amazon.fr або amazon.de. Захист Amazon - це не лише блокування запитів, він також змінює те, які дані видимі, де вони з'являються і скільки роботи потрібно для нормалізації їх в один придатний набір даних.
Якщо вам потрібна швидка довідка про поведінку скринінгу ботів, внутрішній посібник про анти-бот системи варто тримати відкритим під час налагодження вашого парсера. Справа не лише в тому, щоб отримати відгуки. Справа в тому, щоб отримати правильний фрагмент, на правильному ринку, перш ніж сесію буде позначено.
Побудова конвеєра виявлення та видобування
Парсер відгуків Amazon промислового рівня не повинен починатися з парсингу. Він повинен починатися з виявлення. Методика ScrapeOps рекомендує двоетапний потік: спочатку визначити фактичний URL відгуків продукту з ASIN або результатів пошуку, потім пагінувати через розділ відгуків і парсити стабільні поля, такі як рейтинг, автор, дата, текст і прапорець підтвердженої покупки. Сторінки відгуків Amazon також надають ці поля у структурованих виходах, які можуть чисто потрапити в CSV або JSON. Робочий процес парсера відгуків Amazon від ScrapeOps
Потік, який витримує реальні навантаження
Розглядайте ASIN як точку входу, а не ціль. Результат пошуку або сторінка продукту дає вам маршрут до ендпоінта відгуків, і цей маршрут може варіюватися залежно від маркетплейсу, локалі та стану сторінки. Коли у вас є URL відгуків, парсер повинен циклічно проходити через сторінки відгуків, збирати стабільні поля та чисто зупинятися, коли пагінація закінчується або форма сторінки змінюється.
import requests
from bs4 import BeautifulSoup

def get_review_page(review_url, headers=None, cookies=None):
    resp = requests.get(review_url, headers=headers, cookies=cookies, timeout=30)
    resp.raise_for_status()
    return resp.text
def parse_reviews(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    for card in soup.select("[data-hook='review']"):
        rows.append({
            "rating": card.select_one("[data-hook='review-star-rating']").get_text(strip=True) if card.select_one("[data-hook='review-star-rating']") else "",
            "author": card.select_one(".a-profile-name").get_text(strip=True) if card.select_one(".a-profile-name") else "",
            "date": card.select_one("[data-hook='review-date']").get_text(strip=True) if card.select_one("[data-hook='review-date']") else "",
            "body": card.select_one("[data-hook='review-body']").get_text(" ", strip=True) if card.select_one("[data-hook='review-body']") else "",
            "verified_purchase": bool(card.select_one("[data-hook='avp-badge']"))
        })
    return rows
Спочатку використовуйте парсинг сирого HTML. Переходьте на рендерений DOM лише тоді, коли тіло сторінки або контейнер відгуків перестають з'являтися у відповіді сервера.
Куди належать повторні спроби
Повторні спроби повинні обгортати запит, а не парсер. Якщо відповідь приходить у неправильному форматі, заблокованою або з редиректом, рівень запиту вирішує, чи потрібно ротувати стан сесії, змінити клас проксі або зробити паузу. Парсер повинен бачити лише сторінку, яку ви вже визначили як варту обробки.
| Поле | Джерело на сторінці | Форма зберігання |
|---|---|---|
| Рейтинг | Елемент зірочок у картці відгуку | Число або рядок |
| Автор | Блок імені профілю | Текст |
| Дата | Рядок дати відгуку | Текст |
| Текст | Контейнер тексту відгуку | Текст |
| Підтверджена покупка | Наявність значка | Булеве значення |
Для команд, які віддають перевагу автоматизації браузера, резервний варіант Playwright має сенс, коли DOM потребує JS-рендерингу або збереження cookies. Внутрішній посібник Python з патернів краулінгу на основі браузера буде корисним доповненням, якщо ви підключаєте requests та резервний варіант браузера до одного пулу воркерів. Важлива частина - це розділення обов'язків: спочатку виявлення, потім видобуток, повторні спроби навколо транспорту, а не навколо бізнес-логіки.
Вибір правильного класу проксі для скрейпінгу відгуків
Amazon не карає всі класи проксі однаково. Діапазони датацентрів та IPv6 дешеві та швидкі, але швидко згорають на екранах захисту від ботів. Резидентні IP тримаються довше, оскільки виглядають як звичайний домашній трафік, хоча ротація може стати шумною, якщо ви надмірно використовуєте підмережу. Мобільні IP успадковують довіру оператора та зазвичай краще долають найскладніші сторінки, що має значення, коли ваш скрейпер потрапляє на захищені логіном потоки відгуків, які постійно викликають труднощі. Огляд таксономії проксі у статті про типи проксі чітко відображає цю реальність.
Підбирайте проксі під завдання
Якщо завдання - виявлення ASIN, датацентр все ще може мати сенс, оскільки ризик блокування нижчий, а вартість сторінки дешева. Якщо ви масово завантажуєте сторінки відгуків, резидентні проксі мають бути основним робочим інструментом. Якщо сімейство продуктів постійно потрапляє в цикли CAPTCHA, мобільні є рятівним рівнем. IPv6 все ще може допомогти у контрольованих внутрішніх інструментах, але захист Amazon зазвичай робить його найменш прощаючим варіантом для збору відгуків.
| Клас проксі | Найкраще навантаження для відгуків | Типова поведінка блокування | Швидкість |
|---|---|---|---|
| Резидентний | Основний збір відгуків | Тримається довше, все ще позначається при повторенні патернів | Середня |
| Мобільний | Впертті ASIN та сторінки поблизу логіну | Найвища довіра, найменше тертя на практиці | Середня |
| Датацентр | Виявлення ASIN та запити з низьким ризиком | Найшвидше згорає на екранах захисту від ботів | Швидка |
| IPv6 | Обмежене контрольоване тестування | Часто нестабільний проти агресивного захисту | Швидка |
Практичне правило: не використовуйте свій найкращий клас проксі для кожного етапу. Витрачайте дешевші діапазони на виявлення, а потім резервуйте сильніший трафік для запитів відгуків, які дійсно того потребують.
Правильний стек також залежить від того, як ви керуєте сесіями. Липке призначення допомагає, коли один ASIN потребує безперервності на кількох сторінках. Ротація допомагає, коли Amazon починає співвідносити повторювані патерни. Для операторів, які вже використовують AdsPower, Dolphin Anty, GoLogin, Multilogin або Hidemyacc, рівень проксі має відповідати тій самій моделі сесії, що й профіль браузера, інакше ви втратите довіру до того, як скрейпер дійде до другої сторінки.
Тактики проти блокування, які витримують навантаження
Зазвичай виконання провалюється там, де команди стають неуважними. Amazon не потрібно блокувати кожен запит. Достатньо додати стільки тертя, щоб ваша сесія почала виглядати скриптовою. Операційний патерн, який найкраще виживає під навантаженням, використовує розміщені запити, ротацію проксі за розкладом, відступ при зростанні поведінки CAPTCHA, резидентні проксі для основного шляху запитів, приховані заголовки браузера та cookies, які залишаються послідовними в межах кожної сесії. Тактики скрейпінгу відгуків Amazon
Частини, які насправді мають значення
Рядки user-agent мають менше значення, ніж очікують багато операторів. Відбитки заголовків та відбитки TLS зазвичай викривають скрейпер першими, особливо коли браузер каже одне, а стек підключення поводиться як щось інше. Якщо ви вже керуєте рекламними акаунтами Facebook та TikTok, займаєтесь фармінгом акаунтів або використовуєте клоакінг для геотаргетованих кампаній, ви знаєте, як швидко невідповідний відбиток може зламати довіру в усьому профілі.
Cookies сесії несуть решту навантаження. Amazon пов'язує поведінку з безперервністю, тому стабільне сховище cookies може підтримувати когерентність сесії достатньо довго, щоб просуватися по сторінках відгуків, не змушуючи перевіряти довіру заново з кожним запитом. Ось чому вибір проксі та вибір браузера мають бути розроблені разом, а не розглядатися як окремі проблеми.
Тримайте ідентичність сесії нудною. Більшість блокувань з'являються, коли скрейпер змінюється занадто багато і занадто швидко.
Де підходить Sota Proxy
Sota Proxy корисний для контролю ротації, керування липкими сесіями та геотаргетингу, що відповідає профілю браузера, який вже використовується. Це важливо для медіабаєрів, які проводять геотаргетовані кампанії, і не менш важливо для агенцій, яким потрібен конвеєр перевірки, прикріплений до налаштування з кількома профілями, без витрачання однієї репутації IP на кожного виконавця. Для команд, які хочуть краще контролювати зміну сесій, керівництво з ротації IP проксі є практичною відправною точкою для прийняття рішення, коли зберігати IP липким, а коли переходити далі. Якщо ви монетизуєте робочий процес або передаєте стек колегам, реферальна програма Sota Proxy з комісією до 40% - це деталь, яку команди обговорюють після того, як технічні засоби контролю вже налаштовані.
Правило протидії блокуванню просте. Не боріться з Amazon грубою кількістю запитів. Розподіліть навантаження, зберігайте файли cookie стабільними, переключайте проксі за графіком і відступайте в момент, коли поведінка CAPTCHA починає зростати.
Пагінація, парсинг та нормалізація між маркетплейсами
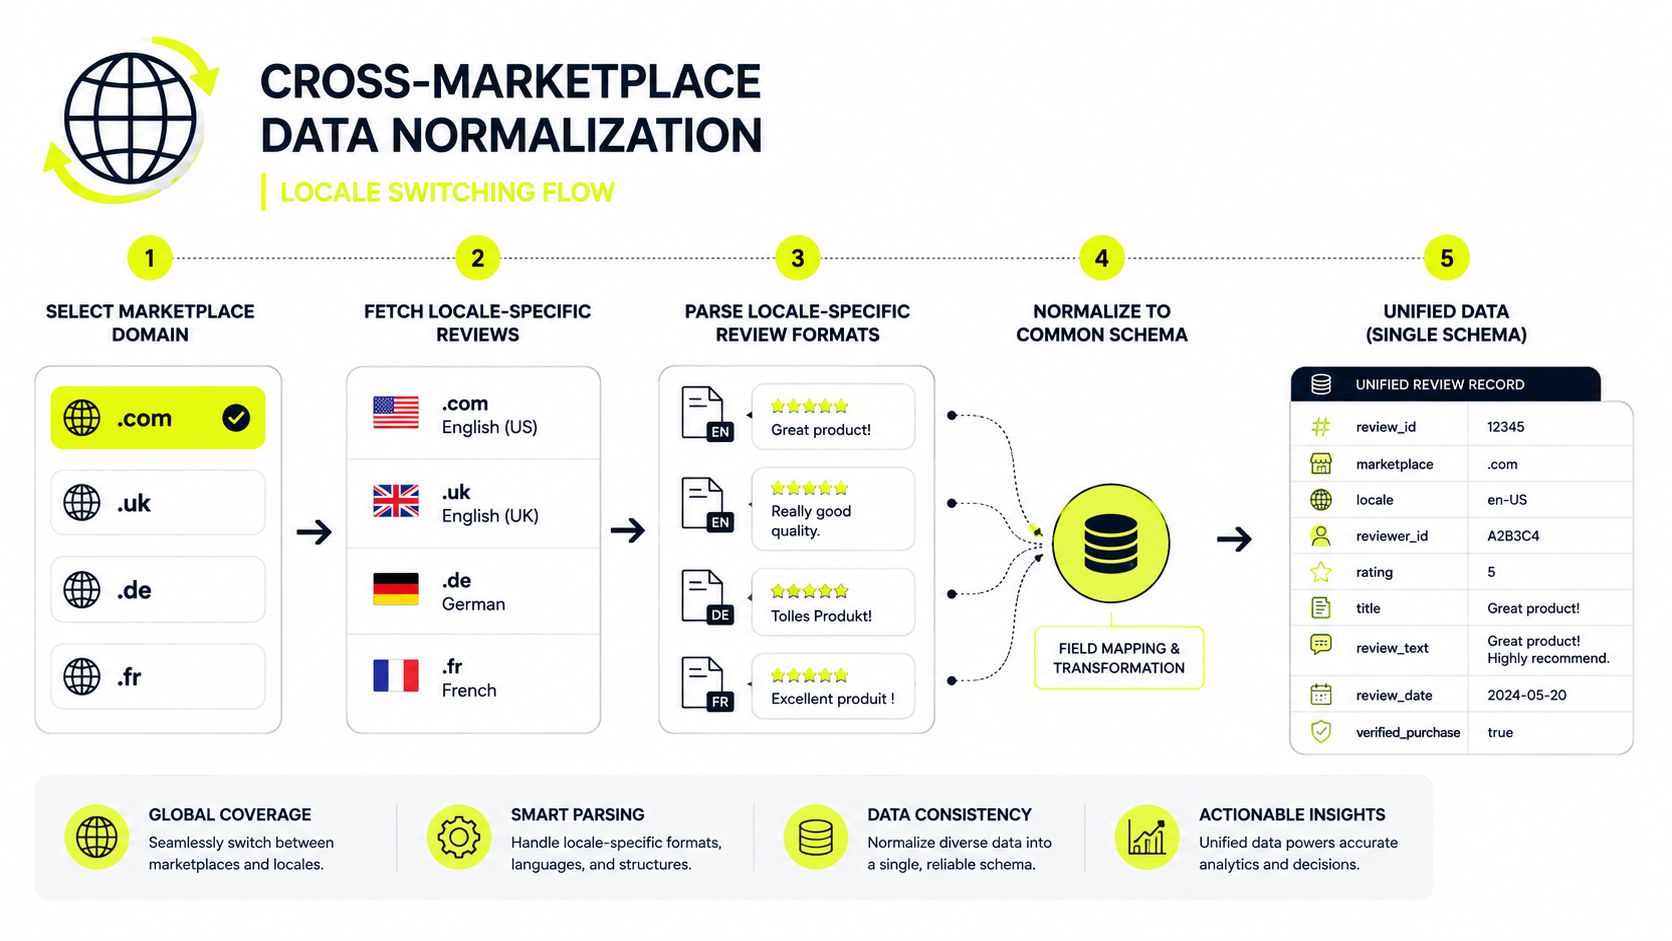
Недостатньо обговорювана проблема - це не просто пагінація. Справа в тому, що дані відгуків не перекриваються між маркетплейсами, такими як amazon.com, amazon.co.uk, amazon.fr та amazon.de, тому скрейпінг відгуків Amazon - це насправді кілька наборів даних, специфічних для кожного ринку. Справжня робота полягає в сегментації ринку та нормалізації, а не просто в швидкості витягування. Контекст скрейпера відгуків між маркетплейсами
Шаблони пагінації, які ви реально побачите
Сторінки відгуків Amazon зазвичай показують потік з номерами сторінок, токен наступної сторінки або обмежений featured блок, який поводиться як невеликий фіксований список. Ваш краулер повинен визначити, який шаблон він має, а потім рухатися по списку, не припускаючи, що така сама структура існує на кожному маркетплейсі. Це важливо, тому що перемикання локалі може змінити не лише мову, а й саму форму сторінки.
Чистий рівень нормалізації повинен відображати кожен відгук в один канонічний запис. Зберігайте поле необробленої локалі, домен маркетплейсу та оригінальний рядок дати, а потім нормалізуйте далі за потоком для аналізу. Це запобігає мовчазному пошкодженню, коли один ринок форматує дати відгуків або рядки рейтингу інакше, ніж інший.
Сегментація ринку перемагає просту швидкість, коли кінцева мета - тестування геотаргетованих рекламних креативів або міжнародне дослідження цін. Швидший скрейпінг неправильної локалі все одно дає неправильну відповідь.
Що має бути в канонічному записі
- Домен маркетплейсу: Зберігайте amazon.com, amazon.co.uk, amazon.fr та amazon.de окремо при завантаженні.
- Необроблений текст відгуку: Зберігайте вихідний текст до перекладу або скорочення.
- Метадані локалі: Зберігайте мову та регіон, щоб аналітики могли порівнювати подібне з подібним.
- Рейтинг і дати: Нормалізуйте це після завантаження, а не під час отримання.
- Ідентифікатор товару: Зберігайте ASIN прив'язаним до маркетплейсу, а не як глобальний унікальний ключ.
Інженерне рішення, яке заощаджує найбільше болю - це розглядати локаль як вимір першого класу. Це дозволяє одному конвеєру живити дослідження конкурентів, тестування реклами та моніторинг бренду без змішування ринків, які не повинні бути змішані. Якщо команда звітності хоче єдиний погляд, надайте їм його, але будуйте його з рядків, що враховують ринок, а не зі змішаного розмиття.
Юридичні та етичні межі, які не можна переходити
Умови Amazon є чіткими. Умови використання забороняють використання «будь-яких роботів, павуків, скрейперів або інших автоматизованих засобів» для доступу до сервісів Amazon без попереднього письмового дозволу, а мовна політика Amazon щодо скрейпінгу також забороняє «видобування даних, роботів, скрейпінг екрану або подібні інструменти збору та витягування даних». Публічні дані про товари, ціни, рейтинги, результати пошуку та обмежені уривки відгуків знаходяться в категорії нижчого ризику, тоді як контент, захищений входом, історія замовлень покупців та Seller Central переходять до набагато ризикованішої території згідно з CFAA. Розбір політики скрейпінгу Amazon
Межа, яку операторі реально переходять
Жорстка межа - це не те, чи виглядає сторінка видимою в браузері. Межа - це те, чи потрібен вашому скрейперу вхід, обхід CAPTCHA або привілейована сесія, щоб продовжувати. Як тільки потрібно, позиція відповідності швидко погіршується, особливо якщо ви виконуєте робочий процес через кілька облікових записів покупців або намагаєтеся використовувати антидетект браузери, щоб приховати, що одна команда контролює набір сесій.
Це той момент, коли командам слід сповільнитися та переоцінити ситуацію. Якщо дані, які вам потрібні, доступні як публічні уривки, використовуйте публічні уривки. Якщо вам потрібен контент, що вимагає входу, ризик та операційне навантаження обидва різко зростають.
Для роботи з валідацією корисним є керівництво про як перевірити автентичність відгуків Amazon, оскільки воно зосереджує увагу на якості сигналу, а не просто на обсязі збору. Завантаження відгуків корисне лише в тому випадку, якщо команда далі за потоком може довіряти тому, що вона бачить.
Якщо скрейперу потрібен вхід для виконання своєї роботи, юридичний та контрактний ризик змінюється негайно.
Внутрішня примітка про чи є веб-скрейпінг законним повинна бути в посібнику кожної команди, що працює з відгуками. Не тому, що це дає дозвіл, а тому, що це змушує поставити правильне питання рано, перед тим, як конвеєр вже в продакшені та прив'язаний до бюджету кампанії.
Моніторинг, зберігання та масштабування конвеєра
Конвеєр відгуків ламається в нудних місцях. Розмітка змінюється, показники успіху падають, частота CAPTCHA зростає, і команда помічає це лише після того, як набір даних вже застарілий. Один зведений бенчмарк 2026 року повідомив, що найвищий показник успіху серед протестованих провайдерів досяг 96% для скрейпінгу відгуків Amazon, тоді як Decodo зафіксував 11% успішність на Amazon із середнім часом завершення 10 секунд на оброблених URL. Цей розрив є нагадуванням про те, що логіка протидії блокуванню та повторних спроб важливіша за простий парсинг HTML. Зведення бенчмарків скрейпінгу відгуків Amazon
Операційний стек
Використовуйте Postgres для нормалізованих рядків відгуків, S3 для знімків необробленого HTML та чергу між виконавцями, щоб повторні спроби не блокували весь запуск. Встановіть сповіщення про раптові падіння успішних завантажень, сплески CAPTCHA та зміни структури сторінки. Якщо один маркетплейс починає відхилятися, погіршуйте плавно замість того, щоб примусово застосовувати один парсер до кожної локалі.
Контрольний список масштабування
- Окремі пули воркерів для кожного ASIN: Тримайте домени збоїв невеликими, щоб один проблемний товар не зіпсував весь пакет.
- Регіональні групи проксі: Розподіляйте трафік за маркетплейсом і локаллю замість того, щоб змішувати все в одному пулі.
- Структурне порівняння: Порівнюйте поточну структуру сторінки з останнім відомим робочим знімком, перш ніж довіряти парсингу.
- Бюджети повторів: Обмежуйте повтори для кожного ASIN, щоб заблокований маршрут не з'їв весь часовий проміжок завдання.
- Резервне сховище: Зберігайте сиру сторінку навіть коли парсинг не вдався, бо парсер зможе опрацювати її пізніше.
Якщо вам потрібен приклад того, як виглядає контрольоване масштабування в середовищі з великим обсягом даних, кейс Xr Voyage з FalkorDB показує, як команди мислять про зростання без втрати керованості. Та сама дисципліна застосовується і тут. Тримайте рівень збору вузьким, рівень зберігання надійним, а рівень моніторингу достатньо шумним, щоб помічати проблеми раніше, ніж це зроблять клієнти.
Якщо вам потрібен стек проксі, створений для конвеєрів відгуків, гео-таргетованих навантажень і скрейпінгу, чутливого до сесій, Sota Proxy надає вам покриття резидентними, мобільними, ISP і датацентр проксі з липкими та ротаційними опціями, що відповідають цьому випадку використання. Налаштуйте його для маркетплейсу та браузерного профілю, який ви вже використовуєте, а потім використовуйте для стабільного збору відгуків Amazon замість того, щоб цілими днями боротися з блокуваннями.
Схожі статті
10 найкращих проксі-сервісів для реклами, скрейпінгу та автоматизації
Порівняйте найкращі проксі-сервіси для перевірки реклами, скрейпінгу, операцій з обліковими записами та гео-таргетингу за типом IP, ціною, аптаймом та можливостями керування.
10 альтернатив Smartproxy для технічних команд
Порівняйте 10 альтернатив Smartproxy за типом проксі, якістю IP, таргетингом, ротацією, швидкістю, ціноутворенням та сценаріями використання для технічних команд.
10 альтернатив IPRoyal для серйозних проксі-навантажень
Порівняйте 10 альтернатив IPRoyal для скрейпінгу, верифікації реклами, фармінгу акаунтів, антидетект-браузерів, гео-кампаній, ціноутворення, ротації та підтримки.
10 альтернатив Oxylabs для скрейпінгу та рекламних операцій
Порівняйте 10 альтернатив Oxylabs за типом проксі, географічним охопленням, часом безвідмовної роботи, ротацією, ціноутворенням та сценаріями використання для скрейпінгу, перевірки реклами та фармінгу акаунтів.
Найкращі альтернативи Brightdata для команд з проксі у 2026 році
Ознайомтеся з найкращими альтернативами brightdata для скрейпінгу, верифікації реклами та геотаргетованих кампаній у 2026 році, а також порадами щодо міграції.
Досягнуто ліміту ресурсів: рішення для проксі, серверів та API
Дізнайтеся, як виправити помилки досягнення ліміту ресурсів на проксі, серверах та API за допомогою практичних рішень на 2026 рік.