Досягнуто ліміту ресурсів: рішення для проксі, серверів та API
Дізнайтеся, як виправити помилки досягнення ліміту ресурсів на проксі, серверах та API за допомогою практичних рішень на 2026 рік.
Ви в розпалі запуску, клієнт чекає на наступну партію прогрітих акаунтів, а панель знову видає Resource Limit Reached. Сайт працював нормально десять хвилин тому, у пулі проксі ще є інвентар, а API-шар раптом відмовляється співпрацювати. Це повідомлення виглядає простим, але на практиці воно зазвичай вказує на одне з трьох різних обмежень, і спосіб виправлення залежить від того, в яке саме ви вперлися.
Зміст
- Три різні помилки за одним повідомленням
- Діагностика збоїв ресурсів cPanel та CloudLinux
- Налаштування серверів Linux та лімітів контейнерів
- Вибір правильного типу проксі для вашого навантаження
- Управління пулом проксі та стратегії ротації
- Фреймворк моніторингу та превенції
- Шляхи ескалації та запити до підтримки
Три різні помилки за одним повідомленням
resource limit is reached - це не одна помилка. На шареному хостингу це часто означає, що акаунт досяг ліміту одночасності, особливо на серверах cPanel та CloudLinux, де обмежувач відстежує Entry Processes замість чистого трафіку. На системах Linux таке ж попередження може походити від ulimits, обмежень файлових дескрипторів або лімітів процесів. У роботі з хмарними сервісами та платформами воно може вказувати на помилку квоти або API-обмеження, що потребує формального запиту, а не налаштування продуктивності.
Спочатку визначте середовище
Якщо повідомлення з'являється всередині cPanel, перевірте, чи збіг збою з активністю WordPress, запитом на лендінг або PHP-завданням, запущеним через cron. Перша перевірка має зосередитися на використанні CPU, RAM/фізичної пам'яті та Entry Processes, бо саме ці лічильники хостинг-провайдери використовують для відстеження шляху збою (діагностика ресурсів на стороні хостингу). У налаштуваннях CloudLinux проблема зазвичай не в "занадто багатьох відвідувачах" абстрактно, а в занадто великій кількості PHP-воркерів, які намагаються працювати одночасно.
Якщо повідомлення з'являється в Azure, Oracle або іншій панелі управління, трактуйте його як проблему квоти, поки докази не скажуть інше. Керівництво Microsoft щодо квот направляє операторів до Usage + quotas та процесу запиту на збільшення ліміту, що є іншим виправленням порівняно з налаштуванням кешу чи очищенням плагінів (обробка помилок квот Azure). V$RESOURCE_LIMIT Oracle - це ще одне нагадування, що ліміти сесій та процесів бази даних належать до свого власного класу збоїв.
Практичне правило: якщо виправлення змінює одночасність запитів, це ліміт хостингу або сервера. Якщо виправлення вимагає більшого дозволу в регіоні чи сервісі, це ліміт квоти.
Для команд трафік-арбітражу, що працюють з AdsPower, Dolphin Anty, GoLogin, Multilogin або Hidemyacc через рекламні акаунти Facebook та TikTok, ця різниця економить час. Проблема вичерпання пулу проксі, помилка cPanel 508 та досягнення квоти API можуть всі виглядати як "систему заблоковано", але вони потребують різних відповідей. Якщо ви трактуєте їх однаково, дедлайн буде витрачено на неправильний рівень.
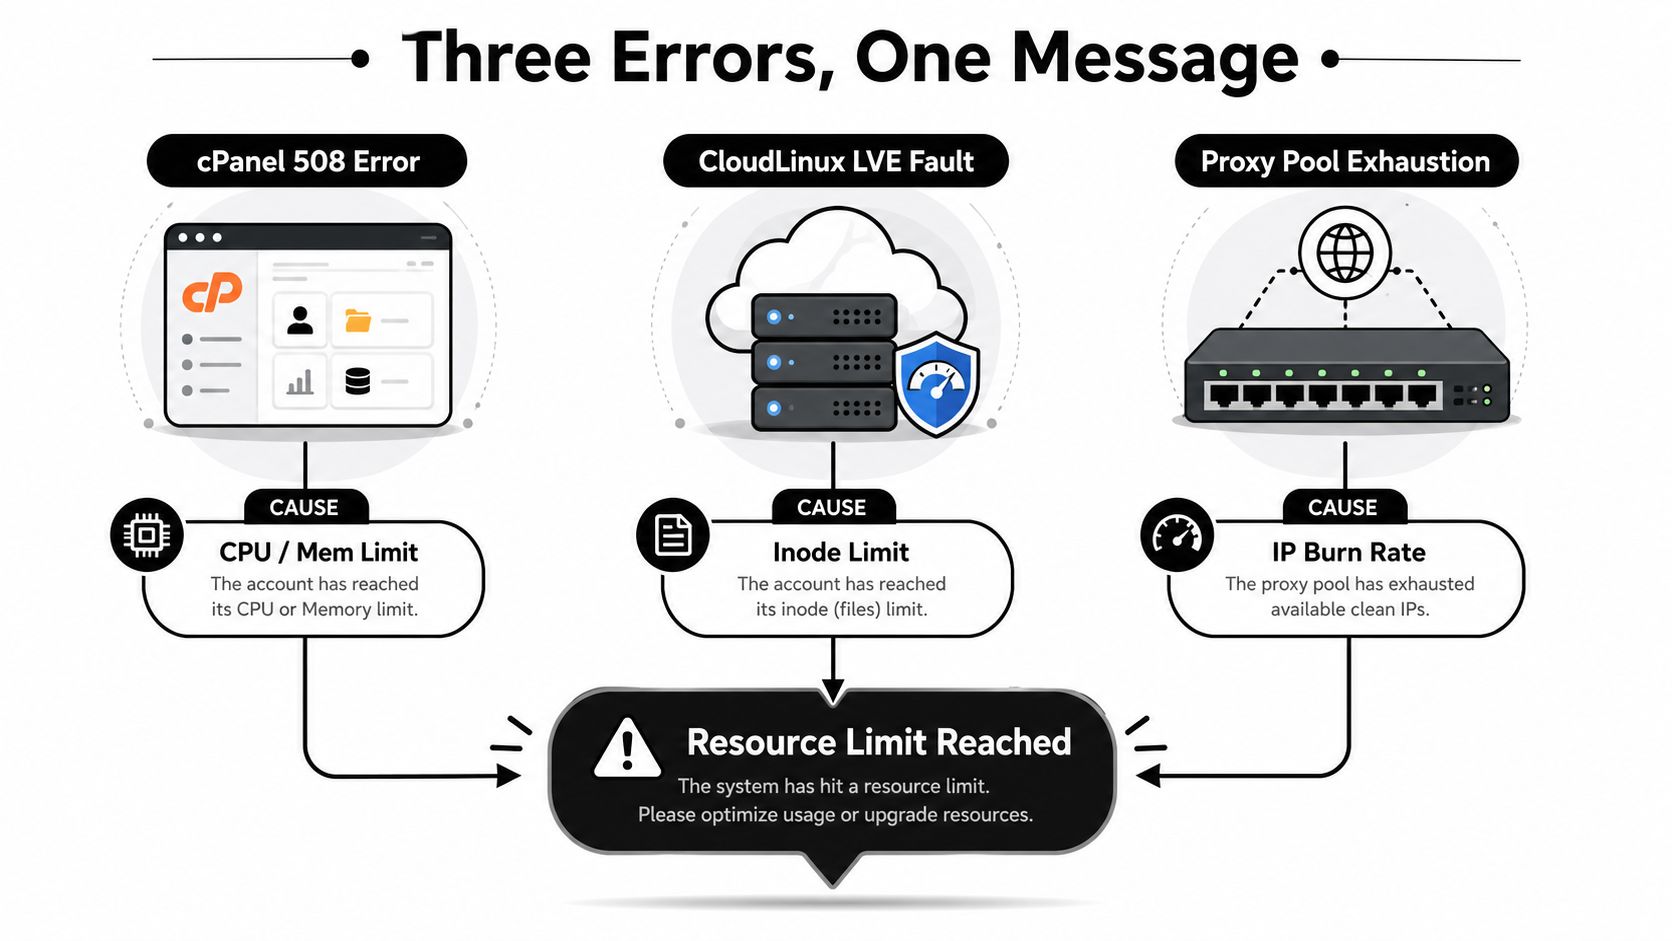
Найшвидша діагностика - пряма. Перевірте контекст помилки, зафіксуйте часову мітку і запитайте, що працювало в той момент. Якщо це був сплеск логінів, редирект клоакінгу, імпорт, бекап або атака ботів, проблема ймовірно в одночасності. Якщо панель провайдера показує квоту, rate або ліміт використання, припиніть налаштовувати додаток і переходьте прямо до управління квотами або підтримки провайдера. Для довідки щодо пов'язаних кодів відповіді див. пояснення HTTP 503.
Діагностика збоїв ресурсів cPanel та CloudLinux
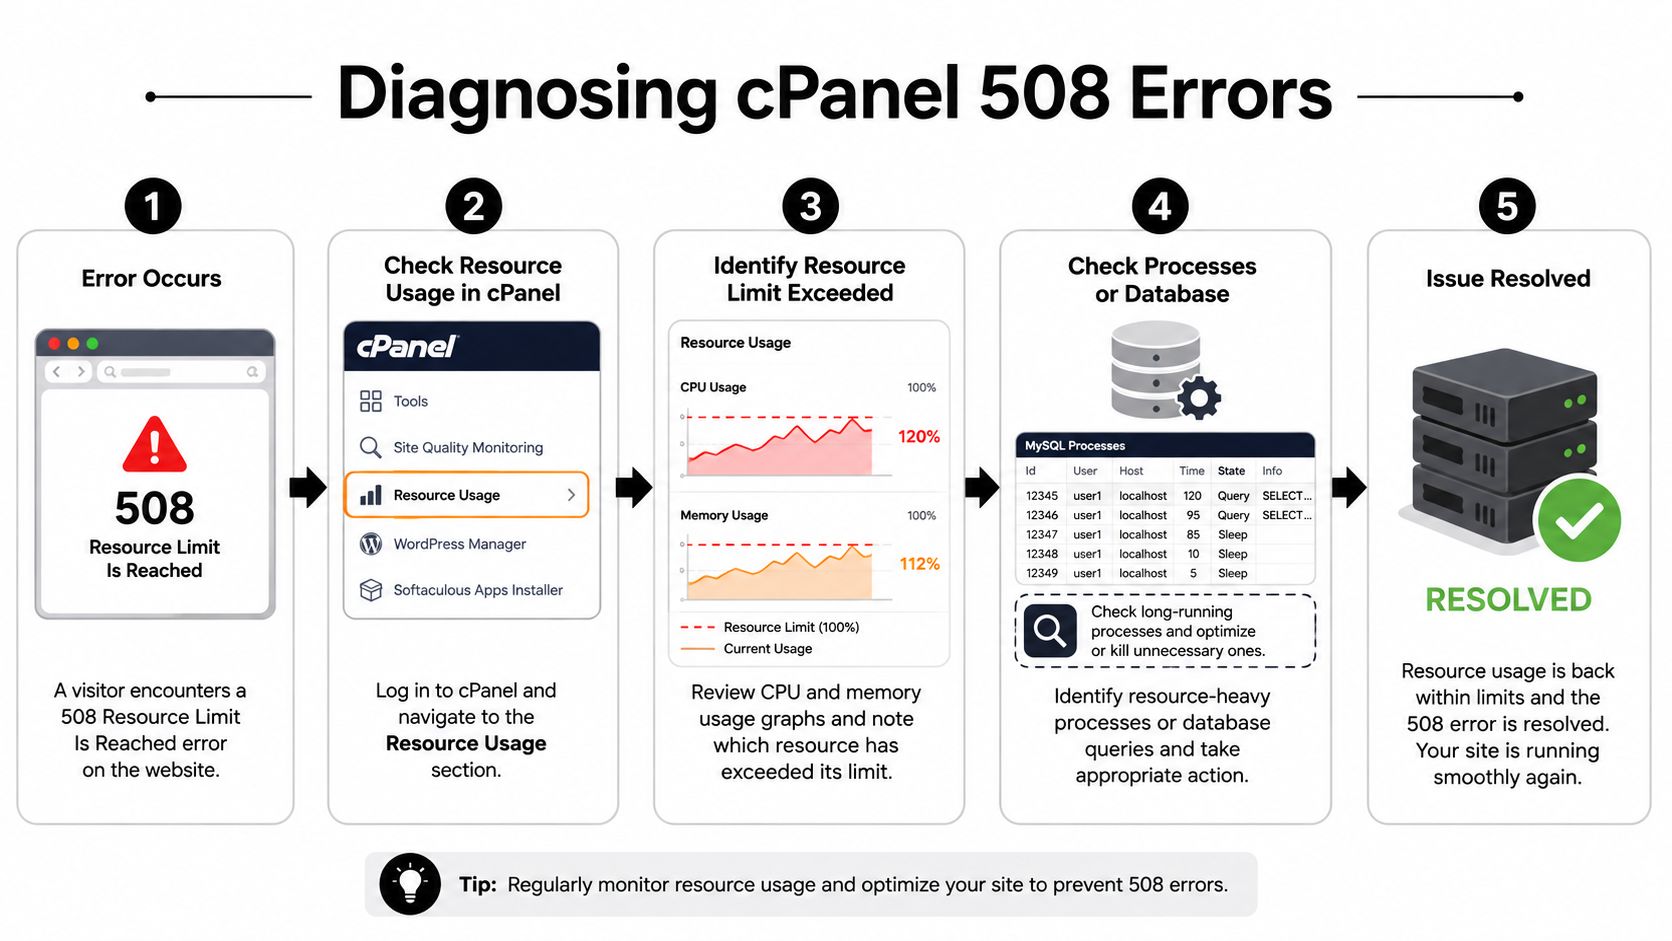
Помилка cPanel 508 зазвичай не є таємницею, коли ви відкриваєте правильну панель. Ключ - перестати дивитися на середнє використання і перевірити саме вікно збою. Керівництво з хостингу рекомендує перейти до cPanel → Metrics → Resource Usage, потім перевірити історичні графіки для CPU, RAM, I/O та Entry Processes і співставити ці точки з логами та точним часом, коли стався збій (діагностика Resource Usage cPanel).
Читайте збої, а не лише середні показники
Середнє використання може приховувати проблему. Сайт може виглядати спокійним протягом дня і все одно накопичувати сплеск збоїв під час піків трафіку, виконання cron або активності ботів. Документація хостингу трактує таблицю faults як корисніше ніж графік середніх значень, бо низька денна лінія все одно може приховувати повторювані збої пам'яті або entry-process під час коротких сплесків.
Це важливо для кампанійного трафіку. Лендінг, на який припадає сплеск від Facebook-реклами, може залишатися під лімітом більшість дня, а потім врізатися в нього, коли кілька PHP-запитів приходять одночасно. Той самий патерн проявляється з редиректами клоакінгу TikTok, викликами admin-ajax або чергою фонових завдань, що прокидаються разом.
Співставте час збою з навантаженням
Отримавши позначку часу, порівняйте її з активністю сайту. Перевірте завдання cron, wp-cron, розклади резервного копіювання, генерацію зображень, створення PDF та сканування безпеки. Керівництва щодо shared-хостингу вказують на ці перехресні завдання як на типові причини стрибків ліміту, особливо коли вони виконуються разом із легітимним трафіком (кроки усунення проблем на shared-хостингу). Якщо збій збігається з періодичним завданням, ймовірний винуватець уже перед вами.
Низьке середнє добове значення не доводить, що сервер здоровий. У cPanel саме короткі стрибки призводять до блокування облікового запису.
Ось чому перший крок зазвичай полягає не в додаванні більшого трафіку чи покупці більшого плану. Він полягає у визначенні, чи одна з цих причин призводить до досягнення граничних значень:
- Стрибки CPU, які вказують на інтенсивну роботу PHP або ресурсномісткі запити.
- Збої RAM, які зазвичай означають плагіни, експорти або скрипти, що споживають багато пам'яті.
- Плато I/O, які часто виникають через резервне копіювання, обертання кешу або завдання, що інтенсивно працюють з файлами.
- Збої Entry Process, які зазвичай означають забагато одночасних PHP-запитів.
Налаштування Linux-серверів та лімітів контейнерів
Після того, як ви залишаєте shared-хостинг, характер збоїв змінюється. Linux-сервери та контейнери не надають вам зручного графіка cPanel, вони застосовують обмеження через ulimits, ліміти файлових дескрипторів та межі ресурсів на основі cgroup. Якщо ви використовуєте сервіси ротації проксі, стеки для фармінгу акаунтів або кілька профілів браузера на VPS, вам потрібно перевіряти ліміти операційної системи безпосередньо, а не гадати.
Перевірте поточні обмеження перед їх зміною
Почніть з ulimit -a, щоб побачити поточні ліміти оболонки. Потім перевірте навантаження на файлові дескриптори за допомогою lsof та /proc/sys/fs/file-nr. Якщо кількість процесів або відкритих файлів постійно зростає під час автоматизації браузера, проблема може бути не в CPU взагалі - можливо, на сервері закінчилися дескриптори для сокетів і файлів.
Для постійних змін підвищіть як м'які, так і жорсткі ліміти в /etc/security/limits.conf. Це файл, який контролює, скільки користувачі та сервіси можуть тримати відкритим після входу або запуску сервісу. Якщо робочий процес залежить від багатьох одночасних екземплярів Chromium, це налаштування часто важить більше, ніж додавання більшої кількості вузлів браузера.
Підходьте до контейнерів інакше, ніж до голого заліза
Docker і Kubernetes додають ще один рівень. Прапорці --ulimit в Docker дозволяють встановлювати специфічні для контейнера обмеження, тоді як Kubernetes використовує requests та limits, щоб під'и не падали під навантаженням. Якщо ваш стек автоматизації працює в под'ах, перезапуск контейнера може виглядати як проблема з проксі, хоча насправді це обмеження пам'яті або процесів.
Тому придбання потужнішого сервера все ще має значення. Якщо ви розраховуєте інфраструктуру для більшого навантаження, правильний каталог обладнання допомагає порівняти варіанти CPU, RAM та сховища перед прийняттям рішення, і каталог серверів Amax IT корисний для такого складання короткого списку.
Для команд, які керують багатьма сесіями браузера, практична послідовність зазвичай виглядає так:
- Виміряйте поточні ліміти оболонки за допомогою
ulimit -a. - Перевірте навантаження на відкриті файли за допомогою
lsofта file-nr. - Підвищте ліміти користувача в
limits.conf. - Встановіть обмеження контейнера за допомогою Docker або Kubernetes.
- Повторно протестуйте під реальним навантаженням, а не тестовим.
Операційна ідея проста. Стек з великою кількістю проксі може зазнати невдачі через відсутність сокетів, файлів або слотів процесів задовго до того, як він насичить CPU. Якщо ви не вимірюєте правильне обмеження, ви продовжуватимете купувати потужність не в тому місці.
Для ширшого планування потужності щодо обсягу запитів та пропускної здатності посібник з інструментів управління пропускною здатністю є корисним довідковим матеріалом.
Вибір правильного типу проксі для вашого навантаження
Обмеження проксі здаються випадковими, поки ви не співставите їх із завданням, яке виконуєте. Резидентські, мобільні, дата-центрові та IPv6 проксі не виходять з ладу однаково, і невірний вибір може призвести до того, що кампанія зламається на половині налаштування. Якщо ви займаєтесь фармінгом акаунтів, клоакінгом або географічно орієнтованими кампаніями через рекламні акаунти Facebook та TikTok, оберіть невірний клас проксі - і ви спалите пул швидше, ніж акаунти встигнуть стабілізуватися.
Зіставте рівень довіри із завданням
Резидентські проксі зазвичай краще підходять для створення акаунтів та чутливих потоків входу, оскільки вони більше схожі на звичайний трафік користувачів. Компроміс полягає в тиску на квоту, оскільки вони, як правило, швидше спалюють ліміт, коли ви робите багато повторних спроб, прогрівань або паралельних сесій. Мобільні проксі, як правило, добре працюють у більш суворих соціальних робочих процесах, особливо там, де має значення довіра платформи, але вони є найдорожчими в експлуатації. Дата-центрові проксі можуть забезпечити вам широку пропускну здатність для скрейпінгу та менш вимогливих навантажень, але соціальні платформи часто блокують їх агресивніше. IPv6 проксі працюють там, де ціль їх підтримує, але багато робочих процесів все ще ламаються, оскільки платформа, застосунок або стек браузера не сприймає це сімейство адрес.
Для команд, які використовують антидетект-браузери, такі як AdsPower, Dolphin Anty, GoLogin, Multilogin або Hidemyacc, цей компроміс є практичним, а не теоретичним. Профіль браузера, який потребує стабільної поведінки входу, зазвичай потребує чогось ближчого до резидентських або мобільних характеристик. Завдання зі скрейпінгу або парсингу може краще толерувати діапазони дата-центрів, особливо якщо мета - це чиста пропускна здатність, а не репутація акаунта.
Порівняння типів проксі для операцій з рекламними акаунтами
| Тип проксі | Рівень довіри | Вартість за ГБ | Найкраще для | Обмеження |
|---|---|---|---|---|
| Резидентські | Вища довіра соціальних платформ | Вища, ніж дата-центрові | Створення акаунтів, прогрів, клоакінг | Квота спалюється швидше |
| Мобільні | Дуже висока довіра для мобільної поведінки | Найвищий практичний ціновий тиск | Рекламні акаунти TikTok, чутливі соціальні процеси | Дорогі та складніші в масштабуванні |
| Дата-центрові | Нижча довіра на соціальних платформах | Найнижчий ціновий тиск | Скрейпінг, масові перевірки, несоціальна автоматизація | Частіше блокуються на рекламних платформах |
| IPv6 | Залежить від платформи | Залежить від провайдера | Специфічні сумісні цілі | Не працює там, де підтримка IPv6 слабка |
Правильний вибір залежить від навантаження. Якщо завдання - це свіжий профіль Facebook з низькою толерантністю до шуму, резидентські або мобільні проксі мають більше сенсу. Якщо завдання - це масове отримання даних або менш чутливий операційний потік, дата-центрові є ефективнішим вибором. Якщо платформа добре підтримує лише один стек, IPv6 все ще може бути прийнятним, але не припускайте сумісності.
Для детальнішого розбору цих класів посібник з типів проксі є найчіткішим довідником для поєднання з цим рішенням. Для партнерських команд Sota Proxy також проводить реферальну програму з комісією до 40%, що має значення, якщо ваша модель маржі включає регулярні витрати на проксі.
Управління пулом проксі та стратегії ротації
Багато помилок "обмеження ресурсів" проксі є самозавданими. Пул не був вичерпаний платформою, його спожила політика ротації, яка змінює IP надто швидко або розподіляє сесії надто тонко. Якщо ви керуєте кількома рекламними акаунтами, особливо всередині AdsPower або GoLogin, шаблон ротації має відповідати завданню, а не просто теорії.
Встановіть ротацію відповідно до робочого процесу, а не за звичкою
Липкі сесії мають сенс для логінів, прогріву профілів і будь-чого, що потребує збереження тієї самої ідентичності. Швидка ротація краще підходить для скрейпінгу, публічних перевірок і короткочасних запитів, які не потребують безперервності. Якщо ви ротуєте занадто агресивно під час налаштування облікового запису, ви змушуєте платформу бачити занадто багато змін ідентичності. Якщо ви залишаєтеся липкими занадто довго під час скрейпінгу, ви марнуєте чисті IP на завдання, яким вони не потрібні.
Розподіл навантаження теж має значення. Не пропускайте кожен обліковий запис через одного провайдера. Розділіть високопріоритетні облікові записи, тестові облікові записи та одноразові дослідницькі завдання на окремі пули, щоб один сплеск не виснажив всю операцію. Це убезпечить виробничу лінію від забруднення невдалим тестовим запуском.
Відстежуйте стан до того, як пул вичерпається
Використовуйте панель керування, яка показує використання в реальному часі, і налаштуйте сповіщення до того, як пул спорожніє. Якщо ви помічаєте виснаження лише після того, як наступний логін не вдається, ви вже відстали. Таргетинг на рівні міста також може зменшити непотрібну ротацію IP, оскільки це звужує цільовий шаблон замість того, щоб змушувати систему постійно шукати нові кінцеві точки.
Ротація - це проблема ємності, а не лише маршрутизації. Якщо графік неправильний, навіть великий пул зникає швидко.
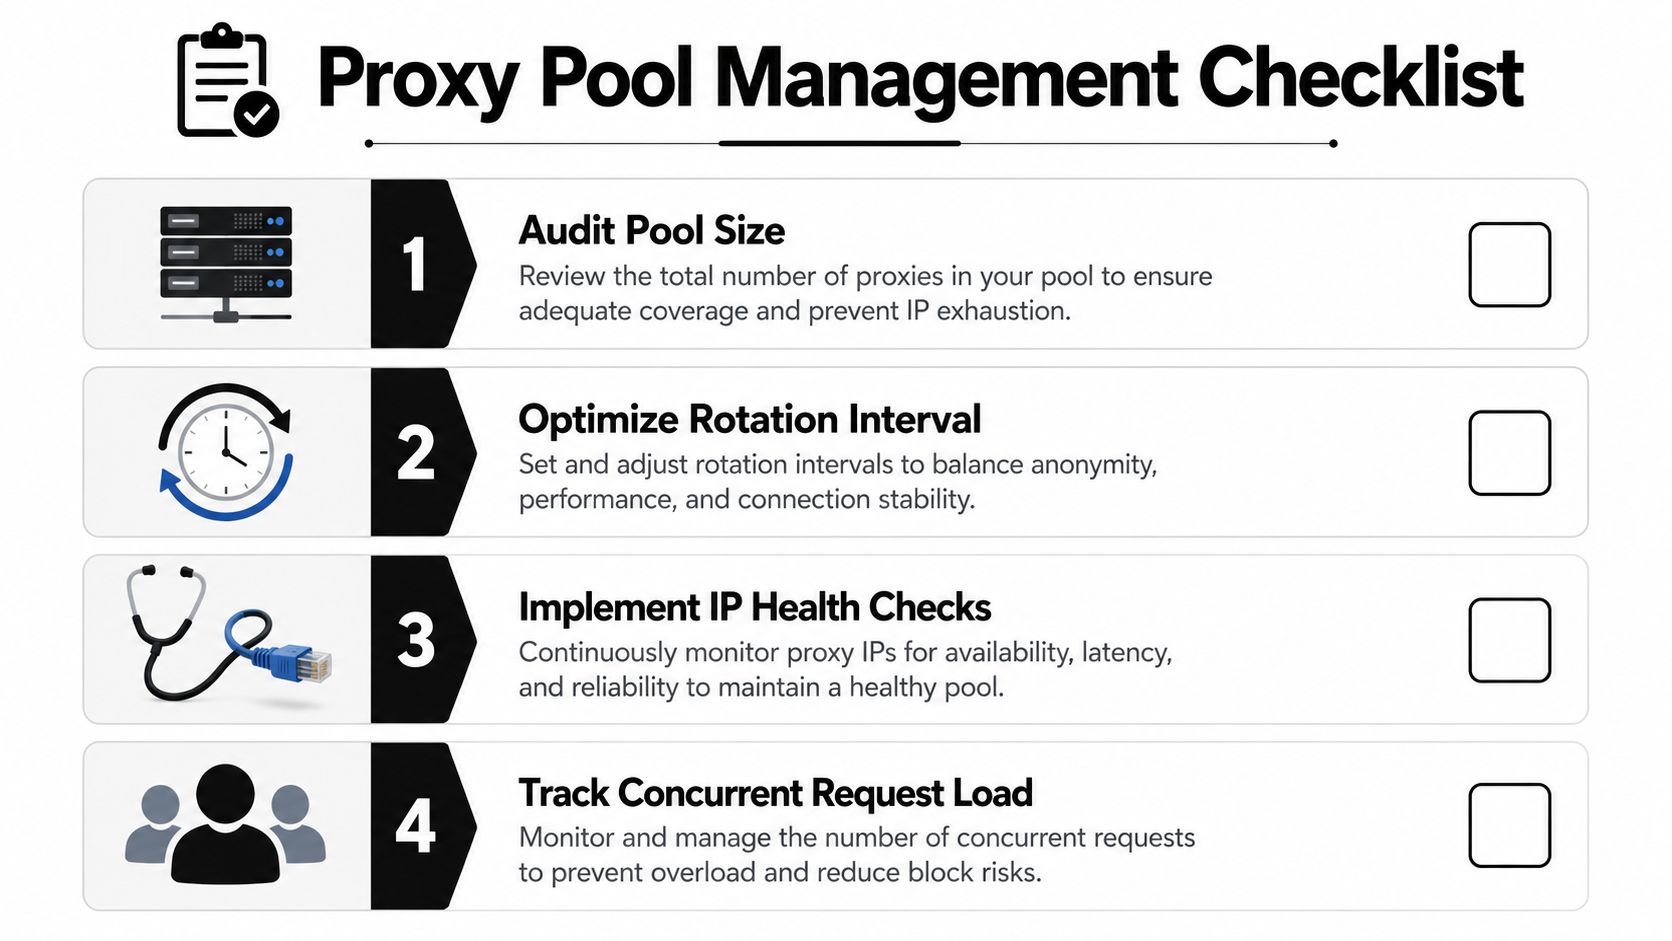
Практична процедура роботи з проксі виглядає так:
- Перевірте розмір пулу відносно одночасних профілів браузера та активних вікон кампаній.
- Узгодьте інтервал ротації з типом завдання: липкий для ідентичності, швидкий для скрейпінгу.
- Перевіряйте стан IP перед повторним використанням адрес у чутливих потоках.
- Відстежуйте навантаження одночасних запитів, щоб одна партія не позбавила ресурсів решту.
Для команд, які займаються фармінгом облікових записів або клоакінгом, прогрів проксі також є частиною рівняння. Поступове збільшення використання робить шаблон трафіку менш синтетичним, ніж раптове різке перемикання. Суть не в тому, щоб обдурити платформу шумом - а в тому, щоб підтримувати робочий процес достатньо стабільним, щоб пул не марнував ємність на запобіжні повторні спроби та скидання.
Для детальнішого вивчення тактик ротації правильним продовженням буде посібник з ротації IP проксі.
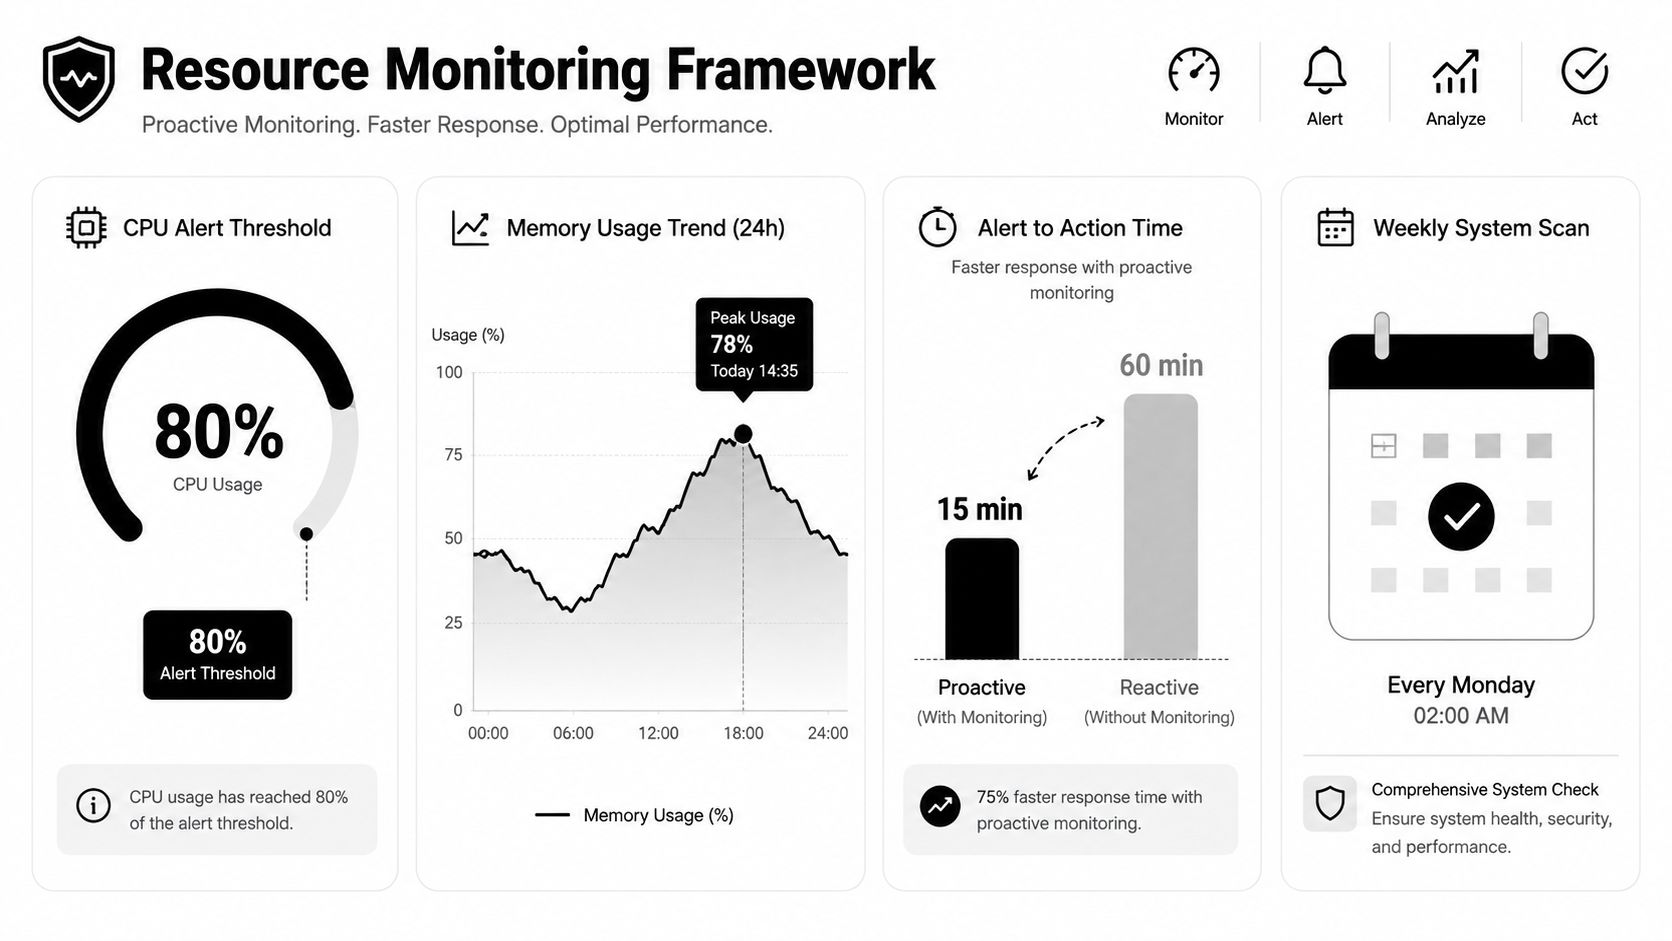
Фреймворк моніторингу та запобігання
Кампанія може виглядати здоровою одну годину і почати збоювати наступну, якщо ви лише стежите за сповіщеннями після того, як користувачі натрапляють на помилки. Запобігання означає відстеження сервера, рівня проксі та рівня API разом, а потім реагування до того, як будь-яка межа стане вузьким місцем. У трафік-арбітражі це важливо, тому що створення облікових записів, клоакінг і запуски кампаній навантажують різні частини стеку в різний час.
Налаштовуйте сповіщення на основі порогів, а не відмов
На стороні сервера стежте за CPU, RAM, процесами входу та файловими дескрипторами. На стороні проксі відстежуйте споживання квоти, час відповіді та показники успішності. На стороні API моніторте обсяг запитів відносно регіональних або сервісних лімітів. Рекомендації Azure щодо квот чітко показують, що ці ліміти часто обмежені регіоном, тому єдине глобальне припущення швидко руйнується (обробка квот Azure).
Сповіщення мають спрацьовувати рано. Якщо обліковий запис або регіон вже відхиляє запити, відновлення займає більше часу, а кампанія втрачає імпульс. Корисна панель керування показує відхилення до збою, а не лише червоний статус після факту.
Використовуйте моніторинг, щоб відокремити нормальне навантаження від поганого
Питання не в тому, чи високий трафік. А в тому, який тип трафіку створює тиск. Сплеск від живої кампанії, шторм повторних спроб від зламаного скрипта та шаблон автоматизації, схожий на бота, - усі вони досягають лімітів по-різному. Рекомендації з хостингу також вказують на cron-завдання, wp-cron та зловмиснихботів як звичайні тригери, що означає, що моніторинг має відокремлювати форму навантаження від чистого обсягу (аналіз шаблонів shared-хостингу).
Практичний фреймворк виглядає так:
- Метрики сервера для ємності та паралелізму.
- Метрики проксі для ротації, вигорання квоти та успішності запитів.
- Метрики API для частоти та регіональних лімітів.
- Теги кампаній, щоб ви могли побачити, чи викликало сплеск створення облікових записів, клоакінг або управління рекламою.
Посібник з метрик продуктивності IT-інфраструктури дає корисну базову лінію для структурування цих вимірювань. Для щоденних операцій мета проста: зробити так, щоб сповіщення спрацювало до того, як обліковий запис почервоніє, а не після того, як кампанія вже зупинилася.
Шляхи ескалації та запити підтримки
Іноді правильне рішення - це не більше налаштувань, а ескалація. Це може означати збільшення квоти, оновлення хостингу, кращий розподіл проксі або структурну зміну в тому, як виконується навантаження. Різниця між швидким схваленням і повільним зазвичай зводиться до якості даних, які ви надсилаєте.
Надайте підтримці те, що їй потрібно, з першого разу
Перш ніж відкривати тікет, зберіть графіки використання ресурсів за останні 7 днів, точні часові мітки помилок, кількість одночасних процесів під час збою та поточні ліміти плану порівняно з тим, що робило навантаження. Це дає підтримці чітку картину того, чи у вас проблема сплеску, хронічна проблема межі, чи неправильна конфігурація. Це також убезпечує вас від повернення назад із загальним "будь ласка, надайте більше деталей".
Якщо ви просите хмарного провайдера більше простору, використовуйте процес квот платформи, а не сперечайтеся про продуктивність. Якщо провайдер документує запит на збільшення квоти, подайте його як запит на ємність, а не звіт про помилку. Якщо проблема специфічна для проксі, наприклад виснаження пулу IP або регіональна доступність, ескалуйте до підтримки проксі з тим самим пакетом доказів і попросіть конкретний шлях розподілу.
Знайте, коли архітектуру треба змінювати
Іноді правильна відповідь - це більший зсув. Shared-хостинг не завжди може поглинути навантаження, яке створює агресивний стек кампаній. У такому випадку перехід на VPS або виділену інфраструктуру чистіший, ніж просити безкінечні виключення. Та сама логіка застосовується до проксі. Якщо пул одного провайдера не може підтримувати ваші шаблони логіну, прогріву та скрейпінгу, розділіть навантаження або змініть мікс провайдерів.
Якщо потрібна допомога з проксі, сторінка цілодобової підтримки - правильний шлях для зв'язку, коли проблема з пулом потребує негайної уваги. Для будь-якого запиту в підтримку тримайте повідомлення коротким і технічним. Вкажіть помилку, часову мітку, робоче навантаження в той момент і точний ліміт, який, на вашу думку, було досягнуто. Це забезпечить швидшу діагностику, ніж будь-яка розпливчаста скарга.
Якщо вам потрібен зручніший спосіб контролювати кампанії, акаунти та використання проксі, відвідайте Sota Proxy і порівняйте типи проксі, локації та варіанти ротації з вашим реальним робочим процесом. Це простий вибір для команд трафік-арбітражу, яким потрібна стабільна інфраструктура під тиском дедлайнів.
Схожі статті
Скільки акаунтів Instagram ви можете мати у 2026 році (і що призводить до їх блокування)
П'ять акаунтів у перемикачі - це обмеження пристрою, а не політики. Ліміти дій Instagram залежать від віку акаунта, способу зв'язування акаунтів, градації покарань та як відновити обмежений акаунт.
Скільки облікових записів можна мати на кожній платформі у 2026 році
Опубліковані ліміти для одинадцяти платформ поруч, чотири різні режими правил, що стоять за ними, та чому число в додатку ніколи не є справжнім обмеженням.
Скільки ви насправді заробляєте на OnlyFans у 2026 році: повний стек комісій
Опублікований розподіл доходів, кожна комісія між доларом фаната та вашим банківським рахунком, коли гроші фактично надходять, та єдина метрика, яка визначає, чи працює просування.
Як протестувати проксі перед покупкою: 10-хвилинний чек-лист
Десять перевірок, які підкажуть, чи варто платити за пробний період проксі: вихідний ASN, ознаки хостингу, поведінка ротації, розподіл підмереж, витоки DNS і WebRTC та показник успішності на вашій цільовій платформі.

Як заробляти на веб-скрапінгу у 2026 році: п'ять моделей з цінами
П'ять способів монетизації скрапінгу, скільки коштує кожен, та реальна вартість виконання скрапінгу, виміряна на реальних сторінках: тільки HTML проти повного рендерингу браузера.

Скільки насправді коштує мультиакаунтинг у 2026 році
Реальні щомісячні витрати на 10, 50 та 200 акаунтів: антидетект-профілі, проксі, номери, хмарні телефони та комісії за картки, з однією статтею витрат, що з'їдає три чверті бюджету.