Оволодіння веб-скрейпінгом на Node: Поглиблена антидетекція 2026
Опануйте веб-скрейпінг на Node у 2026 році! Створюйте промислові інструменти, що охоплюють ротацію проксі, фінгерпринтинг та антидетекцію для видобування даних високої складності.
Більшість порад щодо веб-скрейпінгу на Node створені для демонстрацій, а не для реальної експлуатації. Скрипт, який завантажує кілька сторінок на вашому ноутбуці, нічого не говорить про те, чи зможе він пережити перевірки рекламних акаунтів Facebook, скрейпінг робочих процесів TikTok, конвеєри фармінгу акаунтів, аудити клоакінгу або валідацію геотаргетованих кампаній без втрати IP-адрес і профілів.
Цей розрив має більше значення зараз, оскільки скрейпінг більше не є другорядним завданням. Світовий ринок веб-скрейпінгу, за прогнозами, перевищить 9 мільярдів доларів США до кінця 2025 року з очікуваним зростанням 12–15% CAGR до 2030 року, а скрейпінг заощадив компаніям приблизно 30% часу, що витрачався на ручний збір даних у 2024 році, згідно з прогнозами ринку веб-скрейпінгу та ефективності на 2025 рік. Операційна проблема не в тому, як вибрати DOM-вузол. Вона в тому, як підтримувати стабільність видобування, коли антибот-системи оцінюють кожен запит.
Команди трафік-арбітражу вже знають основи. Складна частина - це запуск Node.js скрейперів поряд з антидетект-браузерами, такими як AdsPower, Dolphin Anty, GoLogin, Multilogin та Hidemyacc, зберігаючи при цьому узгодженість фінгерпринтів, сесій, геолокацій та поведінки проксі. Ось де більшість підручників перестають бути корисними.
Зміст
- Веб-скрейпінг на Node за межами базових знань
- Архітектура вашого інструментарію для скрейпінгу на Node JS
- Обхід блокувань за допомогою поглибленої антидетекції
- Інтеграція проксі для масштабованих операцій
- Створення стійкого та масштабованого скрейпера
- Навігація CAPTCHA та етичні межі
Веб-скрейпінг на Node за межами базових знань
Веб-скрейпінг на Node надто спрощують. Більшість посібників навчають: запит, парсинг, експорт. Це підходить для сторінки каталогу. Але все розсипається, коли ціль чинить опір, коли ваш скрейпер ділить інфраструктуру з операціями рекламних акаунтів Facebook і TikTok, або коли антидетект-профіль має залишатися правдоподібним протягом повторних сесій.
Для операторів мультиакаунтів скрейпінг не ізольований. Він існує поряд з прогрівом акаунтів, перевірками кампаній, тестуванням лендингів, верифікацією клоакінгу та геовалідацією. Збій fetch може змарнувати час покупця. Невідповідність фінгерпринту може зіпсувати профіль, який пізніше використовується в AdsPower або GoLogin. Невдале призначення проксі може викликати проблеми з перевіркою на відфармленому акаунті, який був стабільним ще вчора.
Промислове мислення відрізняється. Ви не запитуєте: «Чи може цей скрипт заскрейпити сторінку?» Ви запитуєте:
- Чи може він підтримувати узгоджену поведінку сесії у робочих процесах фармінгу акаунтів та управління рекламними акаунтами?
- Чи може він розділяти дешеві завдання зі збору та чутливі завдання, пов'язані з акаунтами, щоб одне не забруднювало інше?
- Чи може він безпечно падати, не атакуючи ціль і не пошкоджуючи власні дані?
- Чи може він залишатися правдоподібним, коли повинні збігатися геолокація, часовий пояс, мова та фінгерпринт браузера?
Практичне правило: Якщо скрейпер торкається інфраструктури, яка також торкається рекламних акаунтів, ставтеся до нього як до інфраструктури акаунтів, а не як до одноразового скрипту.
Це означає тісніше ізолювання, кращі логи та чистішу стратегію проксі. Це також означає відкидання початківських припущень, особливо ідеї, що «просто додати Puppeteer» вирішує захищені цілі. Це не так. Це часто полегшує виявлення, якщо браузер, поведінка TLS, часовий пояс та репутація IP не збігаються.
Багато команд виявляють це лише після масштабування. Потім вони починають перебудову навколо пулів проксі, контрольованого паралелізму та потоків запитів, що враховують профілі. Якщо ви виконуєте серйозний збір даних, корисно подивитися на паттерни інфраструктури веб-скрейпінгу, що використовуються для масштабних операцій, з промисловою перспективою з самого початку.
Архітектура вашого інструментарію для скрейпінгу на Node JS
Вибір інструменту визначає витрати, швидкість та поверхню виявлення. Виберіть неправильний стек, і ви або переплатите за браузери, або недобудуєте та будете заблоковані на динамічних цілях.
Виберіть найлегший інструмент, який може виконати завдання
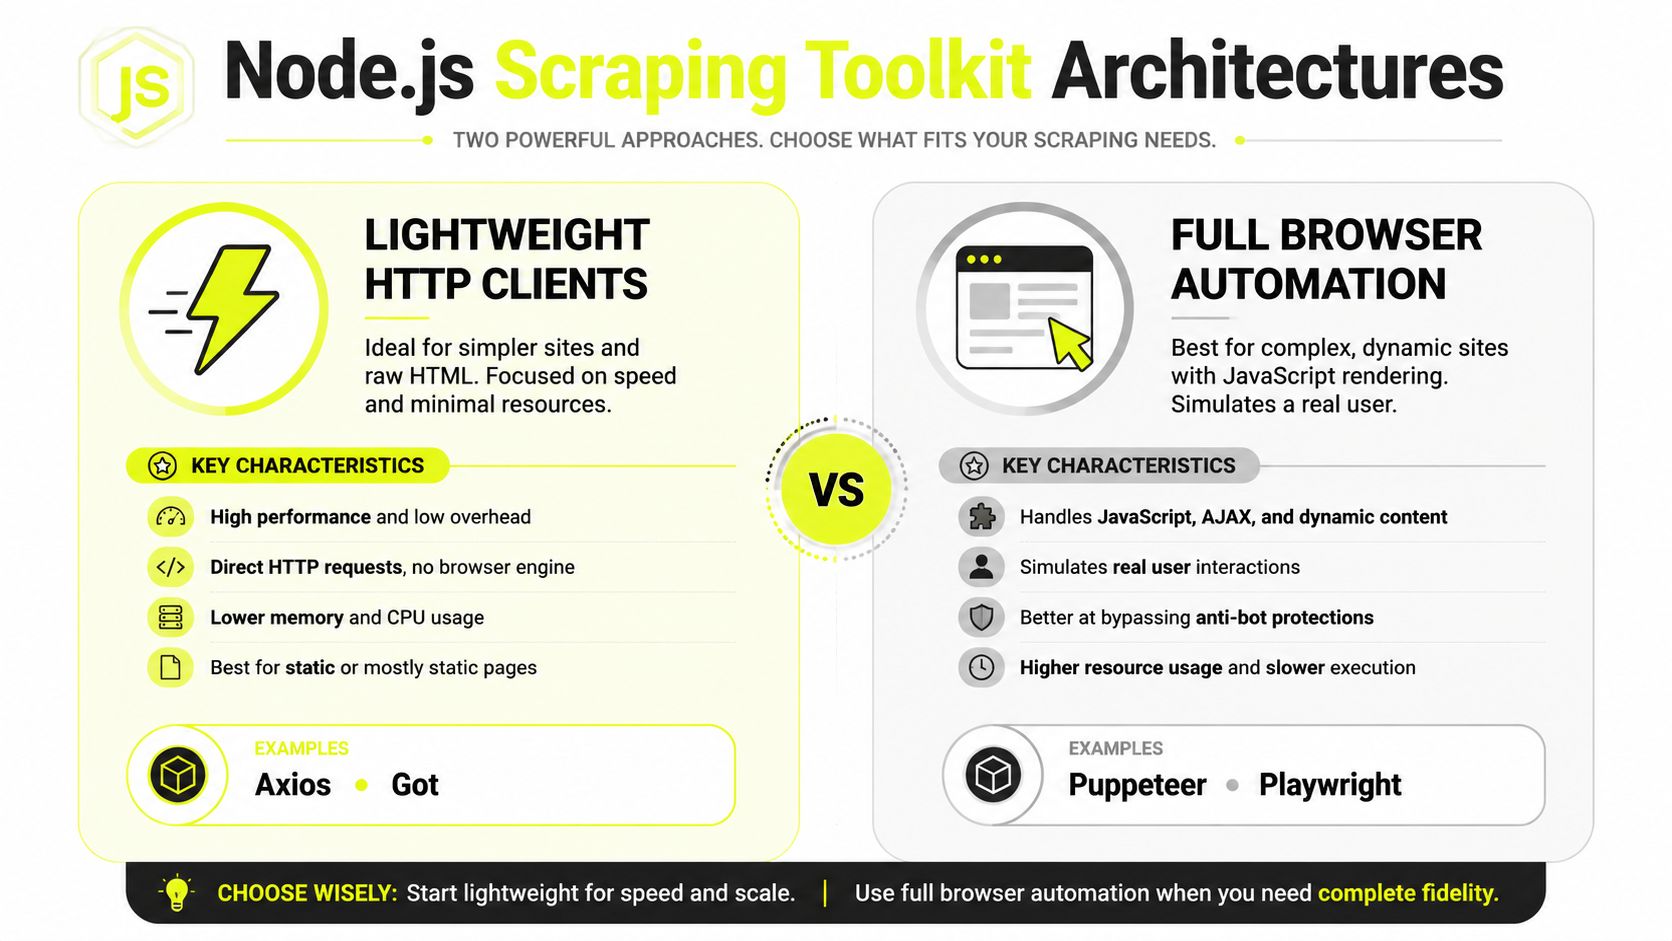
Для статичних сторінок, внутрішніх API та простих серверних цілей HTTP-клієнт плюс парсер досі є найкращим першим кроком. У Node це зазвичай означає Axios або Got для запитів, потім Cheerio для витягування.
Цей стек добре працює, коли потрібна чиста швидкість та низьке використання RAM. Він ідеальний для таких завдань, як:
- Перевірки лендингів у багатьох геолокаціях
- Збір бібліотеки оголошень, де дані знаходяться в передбачуваному HTML або доступних API
- Моніторинг цін або пропозицій для порівняння в арбітражі
- Верифікація клоакінгу на простих ланцюжках редиректів
Перевага - операційна. Ви можете запускати більше воркерів на машину, тримати низькі накладні витрати запитів та налагоджувати на рівні HTTP без шуму браузера. Для трафік-команд це має значення, коли потрібні багато дешевих перевірок замість ідеального рендерингу.
Але цей шлях має обмеження. Він не виконає клієнтський JavaScript. Він не поводиться як повний браузер. Він не несе реалістичного стану браузера, якщо ви не побудуєте багато цієї поведінки самостійно.
Коли автоматизація браузера перестає бути опційною
Playwright та Puppeteer стають необхідними, коли ціль - це JavaScript-важкий додаток або коли стан сторінки з'являється лише після рендерингу та взаємодії. Соціальні платформи, рекламні панелі, SPA електронної комерції та потоки з важким антиботом зазвичай потрапляють сюди.
Багато команд переоцінюють Puppeteer. Запуск Chromium - це не те саме, що злиття з натовпом. Згідно з аналізом інструментів та архітектур скрейпінгу захищених сайтів, headless-браузери, такі як Puppeteer, часто недостатні для сучасних цілей, що використовують canvas-фінгерпринтинг та виявлення ботів на основі штучного інтелекту, на які припадає 73% збоїв корпоративного скрейпінгу у 2025 році, тоді як безсерверна автоматизація браузера може досягати 94% успішності проти захищених сайтів.
Це не робить Playwright або Puppeteer марними. Це означає, що вам потрібно трактувати їх як двигуни виконання, а не рішення для прихованості.
Практичний поділ виглядає так:
- Axios або Got плюс Cheerio для швидкісного збору
- Playwright, коли вам потрібен сильніший контроль над потоками сучасних додатків
- Puppeteer, коли ваш стек залежить від Chromium-специфічного інструментарію або існуючих stealth-екосистем
- Безсерверна автоматизація браузера, коли накладні витрати на управління флотом браузерів починають з'їдати час команди
Де вписуються безсерверні браузери
Керовані платформи браузерів мають сенс, коли ваше вузьке місце - не парсинг. Це операції. Збої браузера, застарілі stealth-патчі, зламані CAPTCHA-потоки та баги невідповідності проксі-браузера споживають більше часу, ніж сама логіка витягування.
Для рекламних операцій основна цінність - узгодженість. Керований рівень браузера може підтримувати версії Chrome, середовища виконання, ротацію проксі та обробку викликів більш стабільно, ніж кастомний флот, склеєний під тиском дедлайну.
Headless-автоматизація - це інструмент рендерингу. Антидетекція все ще залежить від узгодженості фінгерпринтів, геоузгодження та якості проксі.
Якщо ви будуєте власне рішення, тримайте стек модульним. Використовуйте один рівень запитів, один рівень парсера, один рівень браузера та один рівень сесії. Не з'єднуйте все в єдиний скрипт. Це полегшує заміну HTTP-клієнтів на браузери лише там, де потрібно, і легше підключити ваш скрейпер до інтеграцій Node.js, що враховують проксі, створених для автоматизаційних навантажень, коли маршрутизація запитів стає складнішою.
Обхід блокувань за допомогою поглибленої антидетекції
Базові підручники досі просувають ротацію user-agent, ніби цього достатньо. Це не так. Серйозні цілі оцінюють повний фінгерпринт, а не один заголовок.
User-агенти - це проста частина
Зміна User-Agent допомагає лише тоді, коли все інше навколо нього має сенс. Якщо ваш браузер каже одне, ваше TLS-рукостискання каже інше, а ваше проксі виходить з країни, яка не відповідає часовому поясу та мові браузера, запит виглядає фальшивим ще до того, як сторінка завершить завантаження.
Це має велике значення для операторів, які використовують AdsPower, Dolphin Anty, GoLogin, Multilogin або Hidemyacc. Ці інструменти існують для підтримки узгодженості профілю. Якщо ваш Node-скрейпер живить або відображає активність навколо цих профілів, він повинен дотримуватися тих самих правил узгодженості.
Поширені промахи передбачувані:
- Дрейф заголовків, наприклад
accept-language, що не відповідає геолокації - Невідповідність часового поясу між профілем браузера та виходом проксі
- Невідповідність viewport та платформи, що не узгоджується із заявленим пристроєм
- Невідповідність TLS, коли стек запитів виявляє небраузерне рукостискання
- Забруднення сесії, коли один пул проксі обслуговує завдання з різними вимогами до довіри
Узгодьте профіль, а не лише IP
Критичний нюанс, який пропускають більшість посібників, - це невідповідність TLS та фінгерпринту браузера. Згідно з галузевими даними про збої скрейперів, пов'язані з невідповідністю фінгерпринтів, 68% невдалих скрейперів блокуються через невідповідність TLS-рукостискання або часових поясів між проксі та браузером, і ігнорування цього призводить до 30–40% більшого рівня блокувань.
Якщо ви скрейпите навколо управління рекламними акаунтами, це не теоретично. Facebook і TikTok не оцінюють один сигнал. Вони кореляують багато. Акаунт, відкритий через резидентне проксі в одному регіоні, а потім заскрейплений через Node-клієнт з невідповідними локаллю та TLS-ознаками, створює уникний ризик.
Антибот-системі байдуже, що ваш CSS-селектор правильний. Їй важливо, чи виглядає ваш стек запитів як справжній браузер, підключений до справжнього користувача в справжньому місці.
Це змінює рішення щодо реалізації. Іноді чистий HTTP-запит безпечніший, бо не виявляє зламаних headless-артефактів. Іноді повний браузер безпечніший, бо ціль очікує поведінку браузера та оцінює TLS. Неправильний вибір не просто менш ефективний. Він блокує вас швидше.
Як оператори підтримують узгодженість фінгерпринтів
Для чутливих завдань тримайте стек узгодженим на цих рівнях:
Мережева ідентичність
Геолокація проксі, тип ASN та тривалість сесії повинні відповідати цільовій дії. Фармінг акаунтів та повторний доступ до рекламних акаунтів потребують стабільних сесій. Широкі завдання зі збору потребують ширшої ротації.Ідентичність браузера
Узгодьте часовий пояс, мову, метрики екрана, підказки платформи та збірку браузера з профілем. Якщо профіль антидетект-браузера каже Берлін, не дозволяйте скрейперу оголошувати час Маямі.Ідентичність запиту
Тримайте заголовки внутрішньо узгодженими.accept-language, значенняsec-ch-ua, поведінка кодування та навігаційні паттерни повинні відповідати сімейству браузера, яке ви імітуєте.Ідентичність взаємодії
Не запускайте ідеальні інтервали, ідентичні шляхи кліків або неможливі послідовності сторінок. Особливо в робочих процесах, чутливих до перевірок.
Часто багато команд починають використовувати клієнти, що враховують фінгерпринти, або керовані рівні браузерів замість прикручування більшої кількості stealth-плагінів до Puppeteer.
Коротка демонстрація допомагає окреслити різницю між загальною автоматизацією браузера та трафіком, що нагадує стабільну сесію браузера:
Якщо IP-бани вже шкодять вашим завданням, практичні тактики уникнення IP-банів для автоматизаційних стеків зазвичай мають більше значення, ніж черговий рерайт парсера. Блокування часто є інфраструктурними збоями, що носять маску додатку.
Інтеграція проксі для масштабованих операцій
Проксі - це не товарна добавка. Вони визначають довіру, поведінку сесії та економіку одиниці. Якщо ви скрейпите дані для управління рекламними акаунтами, фармінгу акаунтів, перевірок клоакінгу або геотаргетованих кампаній, вибір проксі змінює те, що ви можете робити безпечно.
Оскільки заходи протидії скрейпінгу стають стандартом, проксі стали обов'язковою умовою для великомасштабного скрейпінгу, і аналіз ринку веб-скрейпінгу від Mordor Intelligence повідомляє, що Північна Америка лідирувала з 34,08% частки ринку у 2025 році, тоді як Азіатсько-Тихоокеанський регіон, за прогнозами, покаже найшвидше зростання. Це розширення ринку відстежує те, що оператори вже бачать. Кожен серйозний стек тепер трактує маршрутизацію та IP-стратегію як основну інфраструктуру.
Вибір проксі змінює результат
Дата-центрові, резидентні, мобільні та IPv6 проксі не вирішують одну й ту саму проблему.
Дата-центрові проксі швидкі та дешеві. Вони добрі для високооб'ємних завдань на низькочутливих цілях. Подумайте про публічні сторінки, легке сканування, агрегацію пропозицій або перші перевірки, де індивідуальна довіра запиту не має великого значення. Вони також перші, що позначаються на більш суворих платформах.
Резидентні проксі маршрутизуються через споживчий IP-простір. Вони коштують більше, але краще зливаються на платформах, яким важлива репутація та поведінкова узгодженість. Зазвичай це стандарт для скрейпінгу, прилеглого до логіну, перевірок рекламних акаунтів та повторного доступу, прив'язаного до однієї сесії.
Мобільні проксі - це те, що команди резервують для складніших поверхонь. На чутливих соціальних цілях мобільна довіра корисна, оскільки паттерн трафіку нагадує реальний трафік оператора та спільну поведінку мобільної мережі. Вони повільніші та дорожчі, тому витрачати їх на легкі завдання - це погана операційна практика.
IPv6 проксі можуть бути корисними для масштабування та ефективності витрат там, де ціль чисто приймає IPv6-трафік. Вони не є універсальним обходом. Деякі цілі погано обробляють IPv6, деякі позначають його швидше, і багато чутливих до акаунтів робочих процесів все ще поводяться краще з ретельно обраними IPv4-резидентними або мобільними маршрутами.
Порівняння типів проксі для скрейпінгу на Node.js
| Тип проксі | Найкращий випадок використання | Анонімність/Довіра | Вартість |
|---|---|---|---|
| Дата-центрові | Високооб'ємний збір на низькочутливих цілях, широке сканування, простий моніторинг | Нижча довіра на захищених платформах | Низька |
| Резидентні | Скрейпінг, пов'язаний з акаунтами Facebook і TikTok, геоперевірки, повторні сесії, валідація клоакінгу | Висока довіра для споживчоподібного трафіку | Середня до високої |
| Мобільні | Складні соціальні цілі, фармінг акаунтів, дії, чутливі до перевірок, складні геолокації | Дуже висока довіра | Висока |
| IPv6 | Масштабування з урахуванням вартості, де ціль добре підтримує IPv6, широкі завдання розподілу | Варіюється залежно від цілі та реалізації | Низька до середньої |
Багато збоїв походять від використання одного класу проксі для всього. Це не витримує в промисловості. Дата-центрові для масових операцій. Резидентні для безперервності сесії. Мобільні для складних граничних випадків. IPv6 там, де ціль це терпить.
Дешеві проксі стають дорогими, коли вони спалюють прогріті профілі або змушують до ручного відновлення рекламних акаунтів.
Практичний паттерн проксі для Node.js
У Node.js тримайте обробку проксі поза вашою бізнес-логікою. Вашому парсеру не має бути важливо, який пул обслужив запит. Створіть фабрику запитів, яка приймає цільовий профіль, рівень ризику та політику сесії, а потім вибирає правильний пул.
Мінімальний паттерн виглядає так:
import got from 'got';
import { HttpsProxyAgent } from 'https-proxy-agent';

function buildClient({ username, password, host, port }) {
  const proxyUrl = `http://${username}:${password}@${host}:${port}`;
  const agent = new HttpsProxyAgent(proxyUrl);

  return got.extend({
    agent: {
      http: agent,
      https: agent
    },
    timeout: {
      request: 30000
    },
    retry: {
      limit: 0
    },
    headers: {
      'accept-language': 'en-US,en;q=0.9'
    }
  });
}

const client = buildClient({
  username: process.env.PROXY_USER,
  password: process.env.PROXY_PASS,
  host: process.env.PROXY_HOST,
  port: process.env.PROXY_PORT
});

const html = await client.get('https://example.com').text();
console.log(html.slice(0, 200));
Цей приклад простий навмисне. У промисловості додайте теги сесій, вибір геолокації, набори заголовків для кожної цілі та логування того, який пул обслужив який запит. Ось як ви відстежуєте збої без здогадок.
Для контролю ротації команди зазвичай розділяють політику за завданням:
- Ротаційні сесії для збору на рівні сторінки, де кожен запит може надходити з нового IP
- Липкі сесії для потоків входу, багатокрокових форм, дій фармінгу акаунтів та сесій браузера, які повинні виглядати безперервними
- Геоприв'язані сесії для перевірок попереднього перегляду оголошень та валідації локальних лендингів
- Ізоляція пулів, щоб робота з акаунтами TikTok не ділила поведінку виходу з широкими завданнями скрейпінгу
Ротація та липкі сесії для роботи з акаунтами
Ротація не завжди краща. Для операцій з акаунтами Facebook і TikTok постійна зміна IP може виглядати гірше, ніж стабільна сесія. Прогрітому акаунту часто потрібна правдоподібна, постійна мережева ідентичність. Для широкого скрейпінгу справедливе зворотне. Повторне використання одного й того самого IP занадто довго збільшує бани та дроселювання.
Цей операційний поділ - чому команди відображають політику проксі на робочий процес, а не на кодову базу. Той самий Node-проект може використовувати один маршрут для публічного збору, інший для дій браузера, прив'язаних до акаунту, та інший для геотаргетованих перевірок оголошень.
Якщо ви керуєте налаштуваннями для клієнтів або інших покупців, інфраструктура проксі також може стати частиною вашого стеку доходів. Деякі провайдери проводять партнерські програми. Sota Proxy, наприклад, пропонує реферальну та афілійну програму з до 40% комісії. Це актуально для агентств та операторів, які вже консультують клієнтів щодо вибору та маршрутизації проксі.
Для механіки ротаційних пулів та персистентності сесій паттерни ротації IP проксі для автоматизації та скрейпінгу більш корисні, ніж загальні поради «використовуйте проксі». Політика маршрутизації - це стратегія.
Створення стійкого та масштабованого скрейпера
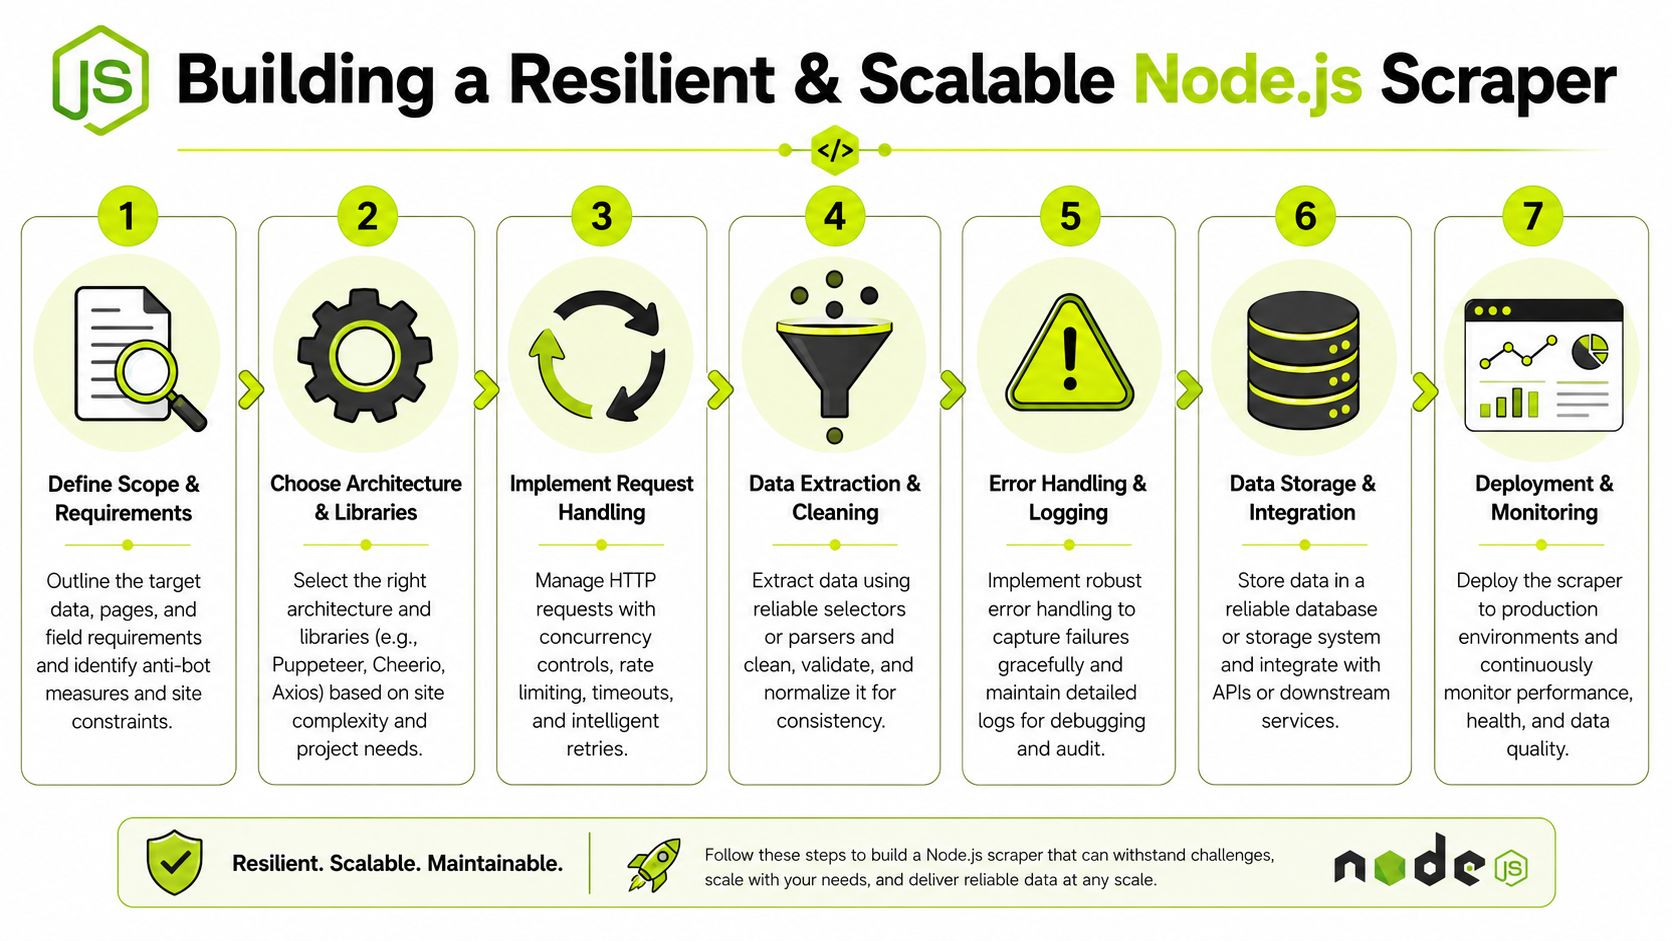
Промислові скрейпери спочатку зазнають невеликих збоїв. Кілька порожніх сторінок. Парсер, який мовчки повертає нуль рядків. Цикл повторних спроб, який продовжує потрапляти на той самий зламаний маршрут. Якщо ви не інструментуєте це рано, завдання виглядає здоровим, поки дані деградують.
Починайте повільніше, ніж хочеться
Найефективніша методологія скрейпінгу на Node.js починається з низького паралелізму, вимірює рівні успішності fetch і парсера, а потім збільшує навантаження лише після підтвердження стабільності, згідно з практичним керівництвом зі скрейпінгу на Node від Context. Це правильна позиція для роботи високих ставок, оскільки збій під навантаженням часто приховує, чи проблема в дрейфі парсера, збої транспорту чи блокуванні.
Починайте з обмеженого паралелізму на хост. Не глобального паралелізму. На хост. Це те, що запобігає одній шумній цілі захоплювати процес.
Корисні метрики включають:
- Рівень успішності fetch для перегляду здоров'я транспорту
- Рівень успішності парсера для виявлення дрейфу макета
- Записів на сторінку, щоб часткові збої не виглядали нормально
- Рівень дублікатів для виявлення проблем пагінації або маршрутизації
- P95 затримка fetch для ідентифікації деградованих пулів до їхнього краху
Зберігайте артефакти збоїв щоразу
Коли скрейпер ламається, зберігайте сирий HTML перед дотиком до парсера. Ця одна звичка усуває години здогадок. Ви можете перевірити, чи змінилася сторінка, чи з'явилася сторінка виклику, чи проксі повернуло щось неочікуване.
Чистий робочий процес збою виглядає так:
- Запит зазнає невдачі або парсер повертає нуль записів.
- Зберегти сире тіло відповіді з міткою часу, ціллю, міткою пулу проксі та тегом сесії.
- Захопити заголовки відповіді та фінальну URL після редиректів.
- Попередити про повторні сторінки з нулем записів перед повторною спробою з вищою складністю.
- Лише тоді вирішити, чи додати рендеринг браузера або інший клас проксі.
Зберігайте сторінку, на якій сталася помилка, а не припущення про те, чому вона сталася.
Повторні спроби також мають значення, але потрібен намір. Використовуйте backoff. Обмежте спроби. Відокремте помилки, що підлягають повторній спробі, від постійних. 429, таймаут або тимчасова проблема шлюзу заслуговують ще однієї спроби. Зламаний селектор - ні.
Моніторте те, що насправді ламається
Стійкий скрейпер діє більше як сервіс, ніж скрипт. У нього є черги, логи, метрики та рівень персистентності, обраний для розміру завдання.
Для зберігання тримайте це просто, коли завдання мале. JSONL або CSV підходить для одноразових зборів та налагодження. Переходьте до PostgreSQL або MongoDB, коли вам потрібна дедуплікація, повторна обробка, об'єднання або подальша звітність для медіабаєрів.
Практичний чеклист для розгортання Node веб-скрейпінгу:
- Дисципліна черги, щоб завдання не вибухали за межі лімітів хоста
- Конфіг для кожної цілі для заголовків, логіки парсера та правил повторних спроб
- Структуроване логування з ID завдання, ID сесії, ціллю та міткою проксі
- Попередження про нуль записів, оскільки мовчазні блокування небезпечніші за жорсткі помилки
- Захоплення фікстур для невдалих сторінок
- Шлях повторної обробки, щоб виправлення парсера не вимагали повного повторного збору
Використовуйте окремі воркери для завдань браузера та простих HTTP-завдань. Змішайте їх, і ви створите шумну затримку, нестабільне використання пам'яті та складніше налагодження. Сторона браузера має бути дорогою та навмисною. HTTP-сторона має бути швидкою та одноразовою.
Навігація CAPTCHA та етичні межі
CAPTCHA зазвичай є симптомом, а не корінною проблемою. Якщо ціль продовжує викликати вас, перше виправлення - краща якість трафіку. Чистіша резидентна або мобільна маршрутизація, узгоджені фінгерпринти та менш агресивна поведінка зменшують частоту викликів ефективніше, ніж кидання розв'язувачів на кожну сторінку.
Коли виклики все ще блокують необхідний потік, команди зазвичай підключають сервіси розв'язувачів, такі як 2Captcha або Anti-CAPTCHA, через виклики API. Це рішення щодо вартості так само, як і технічне. Для фармінгу акаунтів та робочих процесів рекламних акаунтів розв'язувач може підтримувати роботу, але він не відновить зламаний фінгерпринт або брудну сесію.
З боку даних погана інфраструктура може тонко зіпсувати вихід. Згідно зі звітом про точність скрейпінгу та якість інфраструктури, понад 27% заскрейплених даних є дубльованими, неповними або неточними через погану маршрутизацію запитів та нетестовану інфраструктуру проксі. Це і є справжній бізнес-ризик. Ви думаєте, що скрейпер спрацював. Датасет каже інше.
Юридичні та етичні межі також є операційними проблемами. Перевірте Умови використання цілі. Прочитайте robots.txt, навіть якщо це не остаточний юридичний авторитет. Тримайте паралелізм досить низьким, щоб не впливати на продуктивність сайту. Витягуйте лише публічні дані, які вам потрібні. Якщо ваш стек починає викликати скачки навантаження, цикли викликів або побічну шкоду для звичайних користувачів, ви проводите погану операцію.
Для команд, які часто стикаються зі сторінками викликів, корисно тримати загальний словник щодо типів CAPTCHA та рішень щодо обхідних робочих процесів, щоб інженери, покупці та менеджери акаунтів обговорювали той самий режим збою.
Якщо ви виконуєте завдання скрейпінгу, пов'язані з рекламними операціями, фармінгом акаунтів, геоперевірками або високоризиковою автоматизацією, Sota Proxy створений для такого типу навантаження. Він надає командам доступ до резидентних, мобільних, ISP, дата-центрових та IPv6 пулів з широким геопокриттям, з контролем ротації та липких сесій, що відповідають реальним операторським робочим процесам замість іграшкових скриптів.
Схожі статті
Reddit "You've Been Blocked by Network Security": кожна причина та виправлення для кожної
Це не бан, і нема чого оскаржувати. Це походить від edge-сервера Reddit, застосовується до вашого з'єднання і має шість причин. Ось як визначити, яка саме у вас, і скільки триває кожна.
Скільки облікових записів Discord можна мати у 2026 році (на email, телефон, пристрій)
Discord не публікує жодних обмежень на кількість облікових записів. Реальні ліміти: один на email, один номер телефону одночасно без VOIP, і п'ять у перемикачі облікових записів, які Discord може застосовувати глобально.
Автоматизація Telegram з Telegram Expert: що робити, якщо завдання зупинилося на середині
Скільки акаунтів Reddit можна мати у 2026 році (Карма-бар'єри, бани, блокування мережевою безпекою)
Reddit дозволяє мати кілька акаунтів відкрито. Що вас зупиняє - це карма-бар'єри, якість контрибутора, обмеження частоти запитів та одне жорстке правило щодо голосування, плюс три типи банів, як оскаржується кожен, і чому «заблоковано мережевою безпекою» не є баном.
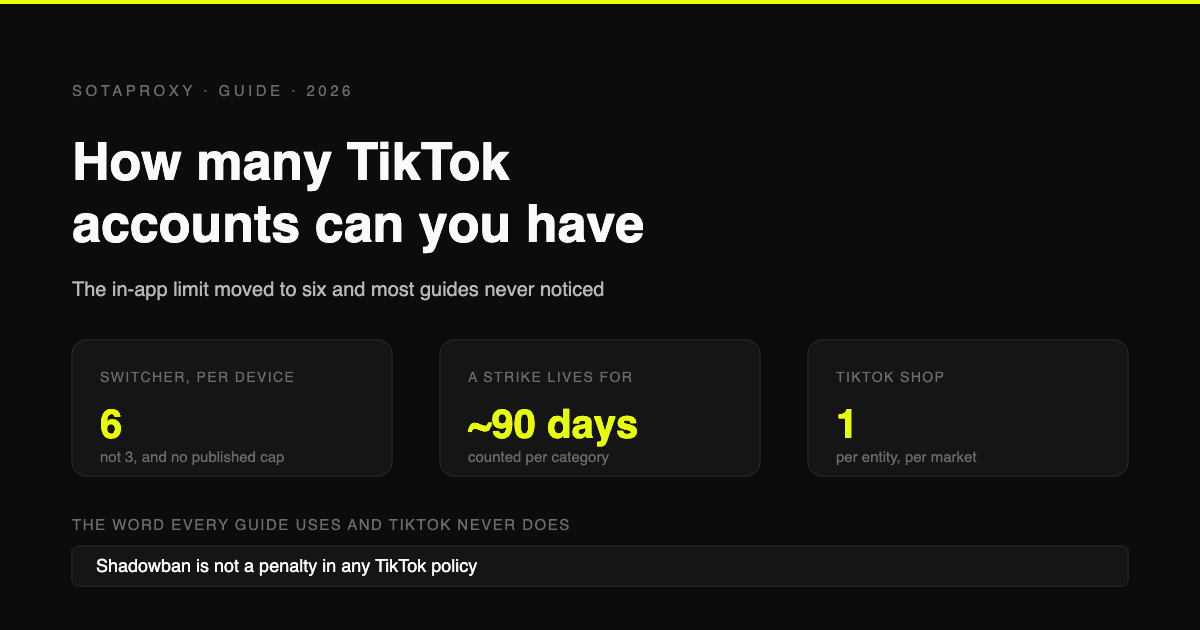
Скільки облікових записів TikTok можна мати у 2026 році (Ліміти, страйки та правила Shop)
Шість облікових записів на пристрій, а не три, і жодного опублікованого ліміту. Правила, які насправді визначають виживання: обмеження дій залежно від віку облікового запису, як закінчується термін дії страйків, що насправді означає shadowban, та один Shop на одну бізнес-одиницю на ринок.
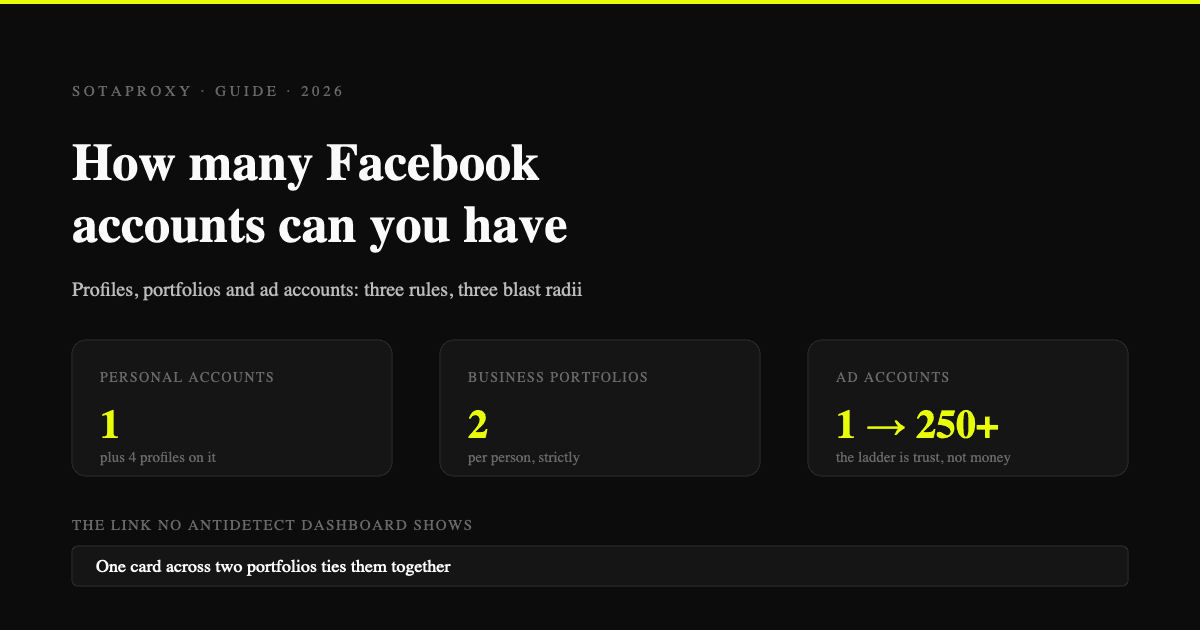
Скільки облікових записів Facebook можна мати у 2026 році (профілі, портфоліо, рекламні акаунти)
Один особистий обліковий запис, чотири додаткові профілі, які поділяють його обмеження, два бізнес-портфоліо на особу та ліміт рекламних акаунтів, який зростає з довірою. Що саме обмежується і в якій послідовності.