Веб-скрапінг на Python: один краулер трьома способами та швидкість кожного
Робочий Python-краулер на requests, потім той самий обхід на asyncio та Scrapy. Усі три варіанти протестовані нами на одному сайті з вимірюванням швидкості. Плюс JavaScript-сторінки, проксі та пастки, що ламають краулери.
Веб-краулер робить те, чого не робить звичайний скрейпер: він сам шукає сторінки. Ви задаєте йому початкову адресу, він переходить за посиланнями, які бачить, і продовжує, доки не закінчиться сайт або не спрацює встановлений вами ліміт. Витягування даних з кожної сторінки - це скрейпінг. Вибір наступної сторінки для завантаження - це кроулінг.
У цьому посібнику ми збудуємо один краулер трьома способами: з requests, з asyncio та зі Scrapy. Усі три варіанти ми запустили на одному сайті 30 вересня 2026 року і заміряли час, тому порівняння в кінці базується на реальних вимірах, а не на чужих цитатах. Мета - books.toscrape.com, тестовий майданчик, створений саме для таких експериментів.
Найпростіший краулер, що працює
Встановіть два пакети:
pip install requests beautifulsoup4Ось увесь краулер:
import time
from collections import deque
from urllib.parse import urljoin, urldefrag, urlparse
from urllib.robotparser import RobotFileParser

import requests
from bs4 import BeautifulSoup

START = "https://books.toscrape.com/"
MAX_PAGES = 300
DELAY = 0.0          # seconds between requests; raise it on real sites
USER_AGENT = "my-crawler/1.0 (+mailto:you@example.com)"

host = urlparse(START).netloc
robots = RobotFileParser(urljoin(START, "/robots.txt"))
robots.read()

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT

queue = deque([START])     # the frontier: URLs waiting to be fetched
seen = {START}             # every URL ever queued, so nothing is fetched twice
pages = 0

while queue and pages < MAX_PAGES:
    url = queue.popleft()
    if not robots.can_fetch(USER_AGENT, url):
        continue
    try:
        r = session.get(url, timeout=15)
    except requests.RequestException as e:
        print("failed", url, e)
        continue
    if r.status_code != 200 or "text/html" not in r.headers.get("Content-Type", ""):
        continue

    pages += 1
    soup = BeautifulSoup(r.text, "html.parser")
    title = soup.title.get_text(strip=True) if soup.title else ""
    print(pages, url, title)

    for a in soup.select("a[href]"):
        link = urldefrag(urljoin(url, a["href"])).url   # absolute, no #fragment
        if urlparse(link).netloc == host and link not in seen:
            seen.add(link)
            queue.append(link)

    time.sleep(DELAY)
Чотири частини роблять будь-який краулер краулером:
- Фронтир (frontier).
queueзберігає адреси, що чекають завантаження. Вибірка з початку дає обхід у ширину, який досягає важливих сторінок сайту раніше, ніж глибоко вкладених. - Набір переглянутих адрес. Без нього краулер знову завантажуватиме головну сторінку кожного разу, коли інша сторінка на неї посилається, і ніколи не закінчить роботу.
- Область обходу. Перевірка хоста утримує краулер на одному сайті. Приберіть її, і ви кроулитимете весь інтернет.
- Ввічливість. Він читає
robots.txt, ідентифікує себе через User-Agent, що вказує, як з вами зв'язатися, і має затримку, яку можна збільшити.
Дві дрібниці допомагають уникнути проблем пізніше. urljoin перетворює відносні посилання на повні адреси, а urldefrag прибирає частину #section, щоб одна сторінка не потрапляла в чергу під кількома іменами. Перевірка Content-Type зупиняє краулер від спроб парсити зображення та PDF як HTML.
Той самий обхід, по десять сторінок одночасно
Перший краулер витрачає майже весь час на очікування мережі, один запит за іншим. Рішення - очікувати кілька одночасно. Ця версія використовує httpx та asyncio з десятьма воркерами, що ділять одну чергу:
pip install httpx beautifulsoup4import asyncio
from urllib.parse import urljoin, urldefrag, urlparse
import httpx
from bs4 import BeautifulSoup
START = "https://books.toscrape.com/"
MAX_PAGES = 300
CONCURRENCY = 10
USER_AGENT = "my-crawler/1.0 (+mailto:you@example.com)"
host = urlparse(START).netloc
async def worker(client, queue, seen, state):
while True:
url = await queue.get()
try:
if state["started"] >= MAX_PAGES:
continue
state["started"] += 1
r = await client.get(url)
if r.status_code != 200 or "text/html" not in r.headers.get("content-type", ""):
continue
state["pages"] += 1
state["bytes"] += r.num_bytes_downloaded
soup = BeautifulSoup(r.text, "html.parser")
for a in soup.select("a[href]"):
link = urldefrag(urljoin(url, a["href"])).url
if urlparse(link).netloc == host and link not in seen:
seen.add(link)
queue.put_nowait(link)
except httpx.HTTPError as e:
print("failed", url, e)
finally:
queue.task_done()
async def main():
queue = asyncio.Queue()
queue.put_nowait(START)
seen = {START}
state = {"started": 0, "pages": 0, "bytes": 0}
async with httpx.AsyncClient(timeout=15, headers={"User-Agent": USER_AGENT}) as client:
workers = [asyncio.create_task(worker(client, queue, seen, state))
for _ in range(CONCURRENCY)]
await queue.join()
for w in workers:
w.cancel()
print(state, "urls discovered:", len(seen))
asyncio.run(main())Логіка залишилась незмінною: фронтир, набір переглянутих адрес, перевірка області. Що змінилось, так це те, що десять воркерів забирають з черги одночасно. CONCURRENCY - параметр, з яким треба бути обережним. Десять - комфортне значення для тестового майданчика. На реальному сайті це десять одночасних відвідувачів з однієї адреси, і багато сайтів це помітять.
Ця версія не включає robots.txt для стислості. Додайте ту саму перевірку RobotFileParser, перш ніж спрямувати його на реальний сайт.
Той самий обхід у Scrapy
Scrapy - це фреймворк, створений для цієї роботи. Фронтир, набір переглянутих адрес, область обходу, robots.txt, повторні спроби та вихідні файли вже є, тому спайдер - це переважно конфігурація:
pip install scrapyfrom scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
class BooksSpider(CrawlSpider):
name = "books"
allowed_domains = ["books.toscrape.com"]
start_urls = ["https://books.toscrape.com/"]
rules = [Rule(LinkExtractor(), callback="parse_page", follow=True)]
custom_settings = {
"USER_AGENT": "my-crawler/1.0 (+mailto:you@example.com)",
"ROBOTSTXT_OBEY": True,
"CONCURRENT_REQUESTS_PER_DOMAIN": 10,
"DOWNLOAD_DELAY": 0,
"CLOSESPIDER_PAGECOUNT": 300,
}```python
def parse_page(self, response):
yield {
"url": response.url,
"title": response.css("title::text").get(default="").strip(),
}
```
Збережіть код у файлі `books_spider.py` і запустіть без створення проєкту:
```
scrapy runspider books_spider.py -O pages.jsonl
```
Результат потрапить до файлу `pages.jsonl`, кожен JSON-об'єкт на окремому рядку. Для справжнього сайту встановіть `DOWNLOAD_DELAY` більше нуля або увімкніть `AUTOTHROTTLE_ENABLED`, щоб краулер сповільнювався, коли сервер починає відповідати повільніше.
## Що ми виміряли
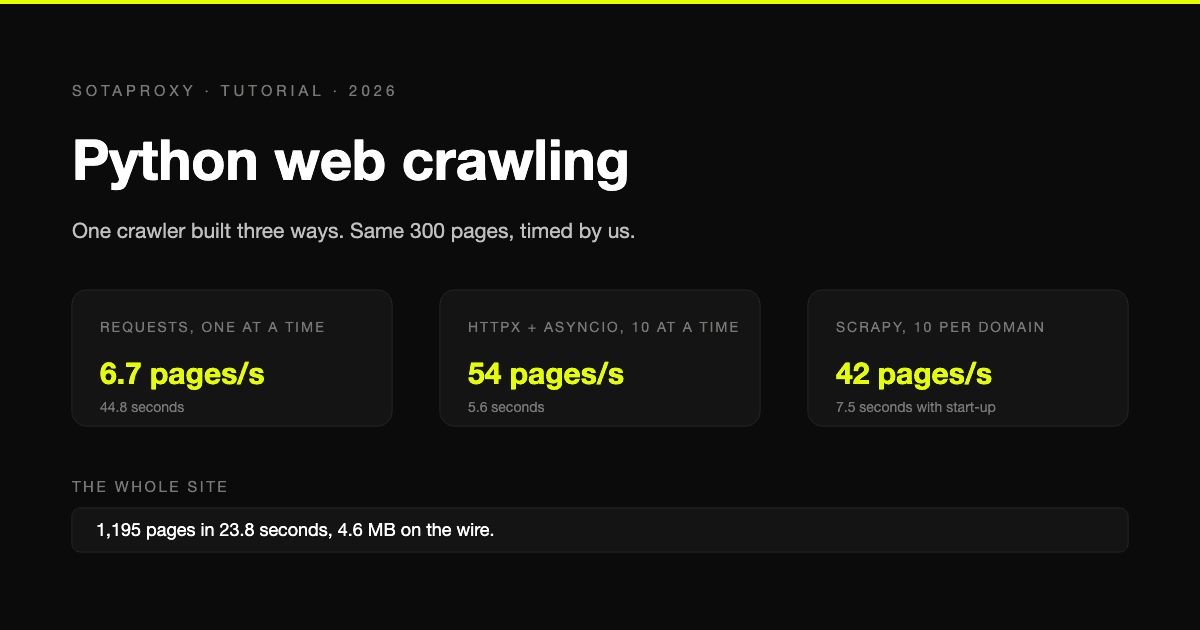
Усі три краулери обійшли один і той самий сайт із одного ноутбука через домашнє з'єднання, без затримок, зупинившись на 300 сторінках.
Краулер Сторінок Реальний час Сторінок за секунду requests, по одному запиту 300 44,8 с 6,7 httpx і asyncio, по 10 одночасно 300 5,6 с 54 Scrapy, 10 на домен 317 7,5 с 42
Версії: Python 3.13, requests 2.34, httpx 0.28, Scrapy 2.19 та BeautifulSoup 4.15.
Що показує таблиця:
- Різниця тільки в конкурентності. Перехід від одного запиту до десяти прискорив краулінг у вісім разів при тому самому коді парсингу.
- Scrapy не такий повільний, як здається. Його власна статистика показала 4,9 секунди краулінгу. Решта з 7,5 секунд, це запуск, а це перестає мати значення при краулінгу будь-якої серйозної довжини. Він перевищив ліміт на 17 сторінок, бо запити, що вже в процесі виконання, завершуються.
- Не чекайте такої швидкості на реальному сайті. Тестовий майданчик не обмежує частоту запитів. На сайті, що обмежує, ваша швидкість буде такою, яку дозволяє сайт, і інструмент ролі не грає.
Ми також дозволили асинхронній версії дійти до кінця. Увесь сайт містить 1 195 сторінок. Краулінг зайняв 23,8 секунди і 4,6 МБ трафіку проти 28,4 МБ HTML після розпакування. Усі три бібліотеки запитують стиснуті відповіді за замовчуванням, і на цьому сайті це скоротило передачу даних у шість разів. Якщо ви платите за проксі-трафік за гігабайт, не вимикайте це.
## Що використовувати
Ситуація Використовуйте Кілька сотень сторінок, одноразово requests. Найпростіший для читання й налагодження Тисячі сторінок, власна логіка httpx з asyncio Краулінг, який запускатиметься повторно, або кілька сайтів Scrapy Сторінки, що порожні доки не виконається JavaScript Браузер через Playwright
## Сторінки, що потребують JavaScript
Деякі сторінки приходять порожньою оболонкою і заповнюються скриптами. Звичайний HTTP-запит не побачить вміст. У тестового майданчика є версія, побудована саме так, і різницю легко показати:
```python
import requests
from bs4 import BeautifulSoup
from playwright.sync_api import sync_playwright
URL = "https://quotes.toscrape.com/js/"
html = requests.get(URL, timeout=15).text
print("requests:", len(BeautifulSoup(html, "html.parser").select(".quote")), "quotes")
with sync_playwright() as p:
browser = p.chromium.launch(channel="chrome") # використовує вже встановлений Chrome
page = browser.new_page()
page.goto(URL)
page.wait_for_selector(".quote")
html = page.content()
browser.close()
print("playwright:", len(BeautifulSoup(html, "html.parser").select(".quote")), "quotes")
```
Коли ми це запустили, requests знайшов 0 цитат, а Playwright знайшов 10. Встановіть Playwright командою `pip install playwright`. Аргумент `channel="chrome"` змушує його керувати Chrome, що вже встановлений, тож окремо завантажувати браузер не потрібно.
Браузер повільний і важкий порівняно із звичайним запитом, тому використовуйте його тільки для сторінок, яким він потрібен. Перевірте спочатку: якщо дані є у відповіді на звичайний запит, браузер вам не потрібен.
## Додавання проксі
Краулеру потрібен проксі, коли сайт обмежує або блокує вашу адресу або коли потрібно бачити сайт так, як його бачить інша країна. Кожен інструмент приймає проксі в трохи іншому місці. Ми перевірили всі чотири форми нижче через логуючий проксі, щоб підтвердити, що запити йдуть через нього.
```python
PROXY = "http://login_c_US:password@proxy.sotaproxy.com:10000"
# requests
session = requests.Session()
session.proxies = {"http": PROXY, "https": PROXY}
# httpx
client = httpx.AsyncClient(proxy=PROXY)
```# Playwright
browser = p.chromium.launch(proxy={
"server": "http://proxy.sotaproxy.com:10000",
"username": "login_c_US",
"password": "password",
})Scrapy читає стандартні змінні оточення, тому в коді павука нічого міняти не потрібно:
https_proxy=http://login_c_US:password@proxy.sotaproxy.com:10000 scrapy runspider books_spider.pyДві речі, які варто знати, перш ніж покладатися на ротацію.
Ротаційний проксі міняє IP на кожне нове з'єднання. Усі три HTTP-клієнти з прикладів вище повторно використовують з'єднання для швидкості, тому краулер може тримати одну й ту саму вихідну адресу набагато довше, ніж ви очікуєте. Як керувати цим за допомогою ідентифікаторів сесій, описано в довідці про ротаційні та фіксовані сесії.
Selenium не приймає логін і пароль проксі через стандартні параметри. Якщо ви прив'язані до Selenium, способи обійти це наведено в розділі автентифікація та білий список IP. У Playwright такої проблеми немає.
Який тип проксі потрібен конкретному сайту і як це визначити за двісті запитів, розглянуто в статті найкращі проксі для веб-скрейпінгу.
Що ламає краулери
- Нескінченні сторінки. Календарі, фільтри та параметри сортування генерують нову адресу для кожної комбінації. Встановіть ліміт сторінок, як у всіх прикладах тут, і подумайте про обмеження глибини обходу.
- Одна сторінка за багатьма адресами. Параметри відстеження та ідентифікатори сесій в адресі руйнують множину переглянутих URL. Прибирайте параметри, які точно є шумом, перш ніж додавати посилання до черги.
- Помилки, які сприймаються як сторінки. Код 429 або 503 означає, що сайт просить вас сповільнитися. Зачекайте і повторіть спробу зі зростаючою паузою, замість того щоб переходити далі:
for attempt in range(4):
    r = session.get(url, timeout=15)
    if r.status_code not in (429, 500, 502, 503, 504):
        break
time.sleep(2 ** attempt)- Код 200, який не є сторінкою. Деякі сайти відповідають на заблокований запит нормальним статус-кодом і сторінкою, яка лише просить спробувати ще раз. Перевіряйте наявність очікуваного контенту, а не лише статус.
Обходьте сайти відповідально
Прочитайте robots.txt сайту та його умови використання перед початком. Чесно ідентифікуйте свій краулер, тримайте частоту запитів достатньо низькою, щоб сайт вас не помічав, і не збирайте персональні дані, які вам не потрібні. Ввічливий краулер також живе довше, бо не дає сайту причин його блокувати.
FAQ
Яка різниця між веб-краулером і веб-скрейпером?
Краулер знаходить сторінки, переходячи за посиланнями. Скрейпер витягує дані зі сторінки. Більшість реальних проєктів робить обидві речі: обходить сторінки, щоб їх знайти, і скрейпить кожну.
Яка найкраща бібліотека Python для веб-краулінгу?
Scrapy для всього, що ви запускатимете більше одного разу. Для разової роботи на кілька сотень сторінок простіше requests з BeautifulSoup. Для власної логіки на великих обсягах httpx з asyncio.
Як швидко може працювати краулер на Python?
У нашому тесті 6,7 сторінок на секунду при послідовних запитах і 54 при десяти одночасних запитах, на сайті без обмежень. На реальному сайті обмеження визначає сам сайт, а не можливості Python.
Чи потрібні проксі для обходу сайту?
Ні, якщо це невеликий ввічливий обхід сайту, який не блокує. Вони потрібні, коли вашу адресу починають обмежувати або блокувати, або коли вам потрібні результати з іншої країни.
Як обходити сайт, який використовує JavaScript?
Рендеріть сторінки в браузері за допомогою Playwright, як у прикладі вище, і тільки ті сторінки, яким це потрібно.
Схожі статті
Reddit "You've Been Blocked by Network Security": кожна причина та виправлення для кожної
Це не бан, і нема чого оскаржувати. Це походить від edge-сервера Reddit, застосовується до вашого з'єднання і має шість причин. Ось як визначити, яка саме у вас, і скільки триває кожна.
Скільки облікових записів Discord можна мати у 2026 році (на email, телефон, пристрій)
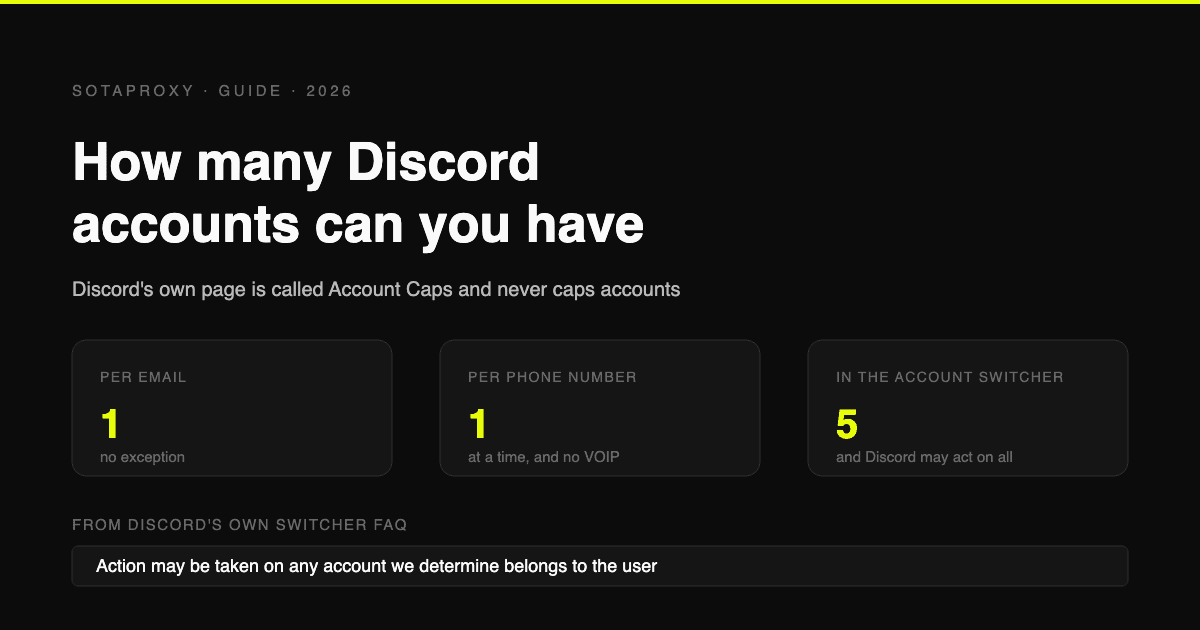
Discord не публікує жодних обмежень на кількість облікових записів. Реальні ліміти: один на email, один номер телефону одночасно без VOIP, і п'ять у перемикачі облікових записів, які Discord може застосовувати глобально.
Автоматизація Telegram з Telegram Expert: що робити, якщо завдання зупинилося на середині
Скільки акаунтів Reddit можна мати у 2026 році (Карма-бар'єри, бани, блокування мережевою безпекою)
Reddit дозволяє мати кілька акаунтів відкрито. Що вас зупиняє - це карма-бар'єри, якість контрибутора, обмеження частоти запитів та одне жорстке правило щодо голосування, плюс три типи банів, як оскаржується кожен, і чому «заблоковано мережевою безпекою» не є баном.
Скільки облікових записів TikTok можна мати у 2026 році (Ліміти, страйки та правила Shop)
Шість облікових записів на пристрій, а не три, і жодного опублікованого ліміту. Правила, які насправді визначають виживання: обмеження дій залежно від віку облікового запису, як закінчується термін дії страйків, що насправді означає shadowban, та один Shop на одну бізнес-одиницю на ринок.
Скільки облікових записів Facebook можна мати у 2026 році (профілі, портфоліо, рекламні акаунти)
Один особистий обліковий запис, чотири додаткові профілі, які поділяють його обмеження, два бізнес-портфоліо на особу та ліміт рекламних акаунтів, який зростає з довірою. Що саме обмежується і в якій послідовності.