Cómo Crear un Scraper de Reseñas de Amazon que Realmente Funcione
Crea un scraper confiable de reseñas de Amazon con tácticas probadas de proxy, anti-bloqueo y análisis. Guía paso a paso para operadores técnicos y agencias.
Si te encuentras frente a un muro de inicio de sesión, algunas reseñas destacadas y un pool de proxies que comienza a agotarse en cuanto escalas más allá del tráfico de prueba, ya conoces el problema. Un scraper de reseñas de Amazon ya no es un simple analizador HTML. Es un pipeline que tiene que sobrevivir al stack anti-bot de Amazon, manejar visibilidad parcial y aún así proporcionar a los analistas algo lo suficientemente limpio como para usar en lecturas de sentimiento, monitoreo de competidores e investigación de productos.
Tabla de Contenidos
- A Qué Se Enfrenta un Scraper de Reseñas de Amazon en 2026
- Construcción del Pipeline de Descubrimiento y Extracción
- Elección de la Clase de Proxy Adecuada para Scraping de Reseñas
- Tácticas Anti-Bloqueo que Resisten Bajo Carga
- Paginación, Análisis y Normalización entre Marketplaces
- Líneas Legales y Éticas que No Puedes Cruzar
- Monitoreo, Almacenamiento y Escalado del Pipeline
A Qué Se Enfrenta un Scraper de Reseñas de Amazon en 2026
Aún puedes obtener una lectura rápida de una página de producto, pero el antiguo flujo de trabajo de "captura las reseñas y sigue adelante" ya no existe. El 5 de noviembre de 2024, Amazon movió casi todas las reseñas detrás de un muro de inicio de sesión, y el endpoint /product-reviews/ ahora redirige el tráfico no autenticado a una página de inicio de sesión. Lo que permanece público suele ser solo de 3 a 8 reseñas destacadas en la página de detalles del producto, además de la calificación agregada, el recuento total y la distribución de 5 estrellas a 1 estrella. Ese cambio transformó el scraping de reseñas de extracción amplia a acceso limitado de datos, especialmente para equipos que hacen análisis de sentimiento, monitoreo de competidores o investigación de productos entre mercados, como se describe en la guía sobre los cambios en el acceso a reseñas de Amazon. Cambios en el acceso a reseñas de Amazon
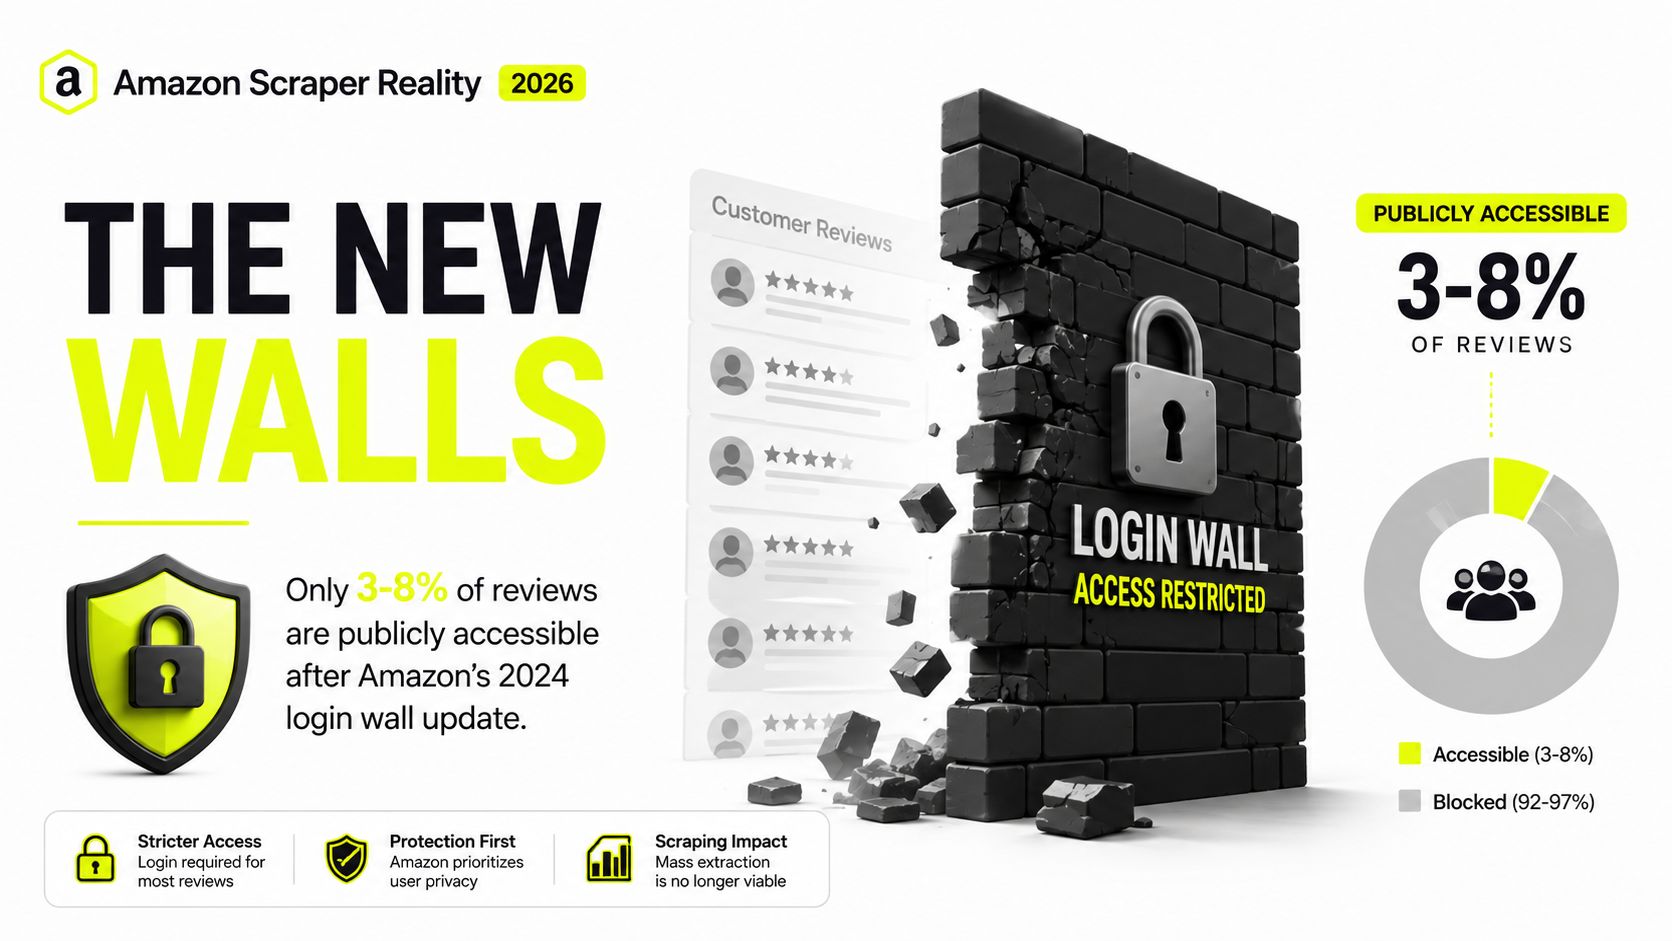
El resultado práctico es feo. Tu primera ejecución se ve bien, luego el mismo ASIN comienza a devolver datos parciales, listas de reseñas vacías o una página de inicio de sesión que tu analizador no fue construido para reconocer. Por eso el flujo de trabajo tiene que tener en cuenta los muros de inicio de sesión, el comportamiento de limitación y la lógica de respaldo desde el principio, en lugar de tratarlos como casos extremos. Si ya estás lidiando con disputas de reseñas en páginas de productos, el recurso sobre cómo eliminar una reseña de Amazon proporciona contexto útil sobre cómo se comporta la superficie de reseñas de Amazon también desde el lado del vendedor.
Regla práctica: si una página de reseñas parece fácil en la primera URL, asume que la ruta más difícil aparece tan pronto como paginas, cambias de configuración regional o reutilizas la sesión.
La trampa más grande es la deriva entre marketplaces. Un pipeline que se ve saludable en un dominio aún puede fallar en el momento en que comparas amazon.com con amazon.co.uk, amazon.fr o amazon.de. Las defensas de Amazon no solo se tratan de bloquear solicitudes, también reformulan qué datos son visibles, dónde aparecen y cuánto trabajo lleva normalizarlos en un conjunto de datos utilizable.
Si necesitas una referencia rápida sobre el comportamiento de detección de bots, la guía interna sobre sistemas anti-bot vale la pena mantener abierta mientras depuras tu scraper. El punto no es solo extraer reseñas. Es extraer el fragmento correcto, en el mercado correcto, antes de que la sesión sea marcada.
Construcción del Pipeline de Descubrimiento y Extracción
Un scraper de reseñas de Amazon de grado de producción no debería comenzar con el análisis. Debería comenzar con el descubrimiento. El playbook de ScrapeOps recomienda un flujo de dos pasos: primero resuelve la URL real de reseñas del producto desde el ASIN o los resultados de búsqueda, luego pagina a través de la sección de reseñas y analiza campos estables como calificación, autor, fecha, cuerpo y bandera de compra verificada. Las páginas de reseñas de Amazon también exponen estos campos en salidas estructuradas que pueden aterrizar limpiamente en CSV o JSON. Flujo de trabajo del scraper de reseñas de Amazon de ScrapeOps
El flujo que sobrevive a cargas de trabajo reales
Trata el ASIN como el punto de entrada, no como el objetivo. El resultado de búsqueda o la página de producto te da la ruta al endpoint de reseñas, y esa ruta puede variar según el marketplace, la configuración regional y el estado de la página. Una vez que tienes la URL de reseñas, el scraper debería recorrer las páginas de reseñas, recopilar campos estables y detenerse limpiamente cuando la paginación termina o la estructura de la página cambia.
import requests
from bs4 import BeautifulSoup

def get_review_page(review_url, headers=None, cookies=None):
    resp = requests.get(review_url, headers=headers, cookies=cookies, timeout=30)
    resp.raise_for_status()
    return resp.text
Primero usa análisis de HTML sin procesar. Cambia al DOM renderizado solo cuando el cuerpo de la página o el contenedor de reseñas deje de aparecer en la respuesta del servidor.
Dónde corresponden los reintentos
Los reintentos deben envolver la obtención de datos, no el analizador. Si una respuesta regresa malformada, bloqueada o redirigida, la capa de obtención decide si rotar el estado de la sesión, cambiar la clase de proxy o retroceder. El analizador solo debe ver una página que ya decidiste que vale la pena procesar.
| Campo | Fuente en la página | Forma de almacenamiento |
|---|---|---|
| Calificación | Elemento de estrellas de la tarjeta de reseña | Entero o cadena |
| Autor | Bloque de nombre de perfil | Texto |
| Fecha | Línea de fecha de reseña | Texto |
| Cuerpo | Contenedor del cuerpo de reseña | Texto |
| Compra verificada | Presencia de insignia | Booleano |
Para equipos que prefieren automatización de navegador, un respaldo con Playwright tiene sentido cuando el DOM necesita renderizado JS o persistencia de cookies. La guía interna de crawling en Python sobre patrones de crawling basados en navegador es un complemento útil si estás conectando requests y respaldo de navegador en el mismo grupo de workers. La parte importante es la separación de responsabilidades: primero el descubrimiento, segundo la extracción, reintentos alrededor del transporte, no alrededor de la lógica de negocio.
Elegir la clase de proxy adecuada para el scraping de reseñas
Amazon no castiga todas las clases de proxy de la misma manera. Los rangos de datacenter e IPv6 son baratos y rápidos, pero se queman rápidamente en las pantallas de bots. Las IPs residenciales duran más porque parecen tráfico doméstico normal, aunque la rotación puede volverse ruidosa si abusas de una subred. Las IPs móviles heredan la confianza del operador y generalmente sobreviven mejor a las páginas más difíciles, lo que importa cuando tu scraper aterriza en flujos de reseñas protegidos por login que siguen generando fricción. La descripción general de taxonomía de proxies sobre tipos de proxy se ajusta perfectamente a esa realidad.
Ajusta el proxy al trabajo
Si la tarea es descubrimiento de ASIN, datacenter aún puede tener sentido porque el riesgo de bloqueo es menor y el costo de página es barato. Si estás extrayendo páginas de reseñas a escala, residencial debe ser el caballo de batalla. Si una familia de productos sigue rebotando en bucles de CAPTCHA, móvil es la capa de rescate. IPv6 aún puede ayudar en herramientas internas controladas, pero las defensas de Amazon generalmente lo convierten en la opción menos tolerante para la recolección de reseñas.
| Clase de Proxy | Mejor carga de trabajo de reseñas | Comportamiento típico de bloqueo | Velocidad |
|---|---|---|---|
| Residencial | Recolección principal de reseñas | Sobrevive más tiempo, aún marcado si los patrones se repiten | Moderada |
| Móvil | ASINs obstinados y páginas adyacentes a login | Mayor confianza, menor fricción en la práctica | Moderada |
| Datacenter | Descubrimiento de ASIN y obtenciones de bajo riesgo | Se quema más rápido en pantallas de bots | Rápida |
| IPv6 | Pruebas controladas limitadas | A menudo inestable contra defensas agresivas | Rápida |
Regla práctica: no uses tu mejor clase de proxy para cada etapa. Gasta los rangos más baratos en descubrimiento, luego reserva el tráfico más fuerte para las obtenciones de reseñas que realmente lo necesitan.
La pila adecuada también depende de cómo ejecutas las sesiones. La asignación fija ayuda cuando un solo ASIN necesita continuidad a través de múltiples páginas. La rotación ayuda cuando Amazon comienza a correlacionar patrones repetidos. Para operadores que ya ejecutan AdsPower, Dolphin Anty, GoLogin, Multilogin, o Hidemyacc, la capa de proxy tiene que ajustarse al mismo modelo de sesión que el perfil del navegador, o perderás confianza antes de que el scraper llegue a la página dos.
Tácticas anti-bloqueo que resisten bajo carga
La ejecución generalmente falla donde los equipos se descuidan. Amazon no necesita bloquear cada solicitud. Solo necesita agregar suficiente fricción para que tu sesión comience a verse programada. El patrón operativo que mejor sobrevive bajo carga usa solicitudes controladas, rotación de proxy en un cronograma, retroceso cuando aumenta el comportamiento de CAPTCHA, proxies residenciales para la ruta principal de obtención, encabezados de navegador sigilosos y cookies que permanecen consistentes dentro de cada sesión. Tácticas de scraping de reseñas de Amazon
Las partes que realmente importan
Las cadenas de user-agent importan menos de lo que muchos operadores esperan. Las huellas de encabezados y las huellas TLS generalmente exponen primero al scraper, especialmente cuando el navegador dice una cosa y la pila de conexión se comporta como otra cosa diferente. Si ya ejecutas cuentas publicitarias de Facebook y TikTok, gestionas farming de cuentas, o usas cloaking para campañas geo-dirigidas, sabes qué tan rápido una huella descalzada puede romper la confianza en un perfil completo.
Las cookies de sesión llevan el resto de la carga. Amazon vincula el comportamiento con la continuidad, por lo que un contenedor de cookies estable puede mantener una sesión coherente lo suficiente para moverse a través de las páginas de reseñas sin forzar una verificación de confianza nueva en cada solicitud. Por eso la elección de proxy y la elección de navegador deben diseñarse juntas, no tratarse como problemas separados.
Mantén la identidad de sesión aburrida. La mayoría de los bloqueos aparecen cuando el scraper cambia demasiado, demasiado rápido.
Dónde encaja Sota Proxy
```Sota Proxy es útil para el control de rotación, el control de sesiones persistentes y la segmentación por ubicación que coincida con el perfil de navegador ya en uso. Esto importa para los compradores de medios que ejecutan campañas geo-segmentadas, e importa tanto como para las agencias que necesitan una pipeline de revisión adjunta a una configuración multi-perfil sin quemar la misma reputación de IP en cada trabajador. Para equipos que desean un control más estricto sobre la rotación de sesiones, la guía de rotación de IP de proxy es el punto de referencia práctico para decidir cuándo mantener una IP persistente y cuándo continuar. Si estás monetizando el flujo de trabajo o pasando la pila a compañeros, el programa de referidos de Sota Proxy, con hasta 40% de comisión, es el tipo de detalle que los equipos discuten después de que los controles técnicos ya están en su lugar.
La regla anti-bloqueo es simple. No luches contra Amazon con volumen bruto de solicitudes. Distribuye la carga, mantén las cookies estables, mueve los proxies según un cronograma, y retrocede en el momento en que el comportamiento de CAPTCHA comience a aumentar.
Paginación, Análisis y Normalización entre Mercados
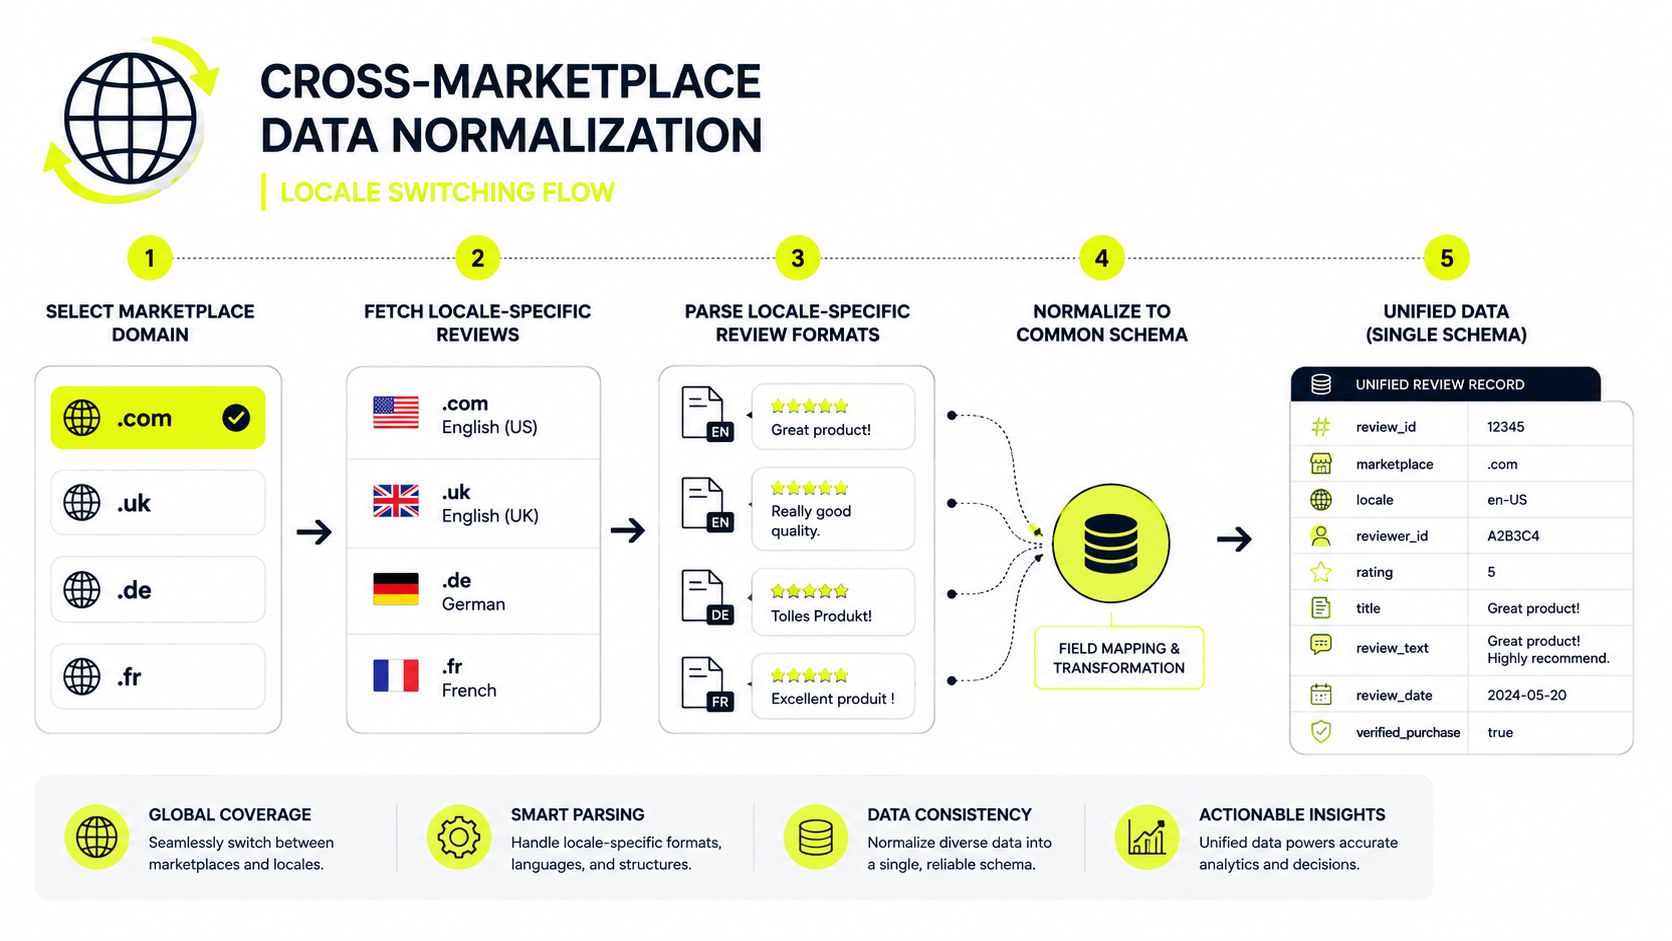
El problema poco discutido no es solo la paginación. Es que los datos de reseñas no se superponen entre mercados como amazon.com, amazon.co.uk, amazon.fr y amazon.de, por lo que scraping de reseñas de Amazon son realmente múltiples conjuntos de datos específicos de cada mercado. El trabajo real es la segmentación de mercado y la normalización, no solo la velocidad de extracción. Contexto de scraper de reseñas entre mercados
Patrones de paginación que realmente verás
Las páginas de reseñas de Amazon tienden a exponer un flujo de número de página, un token de página siguiente, o un bloque destacado limitado que se comporta como una lista pequeña y fija. Tu crawler debe detectar qué patrón tiene, luego moverse a través de la lista sin asumir que la misma estructura existe en cada mercado. Esto importa porque cambiar de región puede cambiar no solo el idioma, sino la forma misma de la página.
Una capa de normalización limpia debe mapear cada reseña en un registro canónico. Mantén el campo de región sin procesar, el dominio del mercado y la cadena de fecha original, luego normaliza posteriormente para el análisis. Esto previene la corrupción silenciosa cuando un mercado formatea las fechas de reseñas o cadenas de calificación de manera diferente a otro.
La segmentación de mercado supera la velocidad bruta cuando el objetivo final es la prueba de creativos de anuncios geo-segmentados o investigación de precios internacional. Un scrape más rápido de la región incorrecta aún te da la respuesta incorrecta.
Qué pertenece a la fila canónica
- Dominio del mercado: Mantén amazon.com, amazon.co.uk, amazon.fr y amazon.de separados en la ingesta.
- Texto de reseña sin procesar: Almacena el texto fuente antes de la traducción o truncamiento.
- Metadatos de región: Preserva el idioma y la región para que los analistas puedan comparar lo comparable.
- Calificaciones y fechas: Normaliza estos después de la ingesta, no durante la obtención.
- Identificador de producto: Mantén el ASIN vinculado al mercado, no como una clave única global.
La decisión de ingeniería que ahorra más problemas es tratar la región como una dimensión de primera clase. Esto permite que una pipeline alimente la investigación de competidores, las pruebas de anuncios y el monitoreo de marca sin mezclar mercados que no deben mezclarse. Si el equipo de informes quiere una vista única, dásela, pero constrúyela a partir de filas conscientes del mercado, no de una mezcla borrosa.
Líneas Legales y Éticas que No Puedes Cruzar
Los términos de Amazon son explícitos. Las Condiciones de Uso prohíben usar "cualquier robot, spider, scraper u otros medios automatizados" para acceder a los Servicios de Amazon sin permiso previo por escrito, y el lenguaje de la política de scraping de Amazon también prohíbe "la minería de datos, robots, screen scraping o herramientas similares de recopilación y extracción de datos." Los datos públicos de productos, precios, calificaciones, resultados de búsqueda y extractos limitados de reseñas se sitúan en el grupo de menor riesgo, mientras que el contenido protegido por inicio de sesión, el historial de pedidos del comprador y Seller Central se mueven a territorio mucho más arriesgado bajo la CFAA. Desglose de la política de scraping de Amazon
La línea que los operadores realmente cruzan
El límite duro no es si una página se ve visible en un navegador. El límite es si tu scraper necesita un muro de inicio de sesión, bypass de CAPTCHA, o una sesión privilegiada para continuar. Una vez que lo hace, la postura de cumplimiento empeora rápidamente, especialmente si estás ejecutando el flujo de trabajo a través de múltiples cuentas de comprador o intentando usar navegadores antidetección para ocultar que el mismo equipo controla el conjunto de sesiones.
Ese es el punto donde los equipos deben desacelerar y reevaluar. Si los datos que necesitas están disponibles como fragmentos públicos, usa los fragmentos públicos. Si necesitas contenido con inicio de sesión, tanto el riesgo como la carga operativa aumentan drásticamente.
Para el trabajo de validación, la guía sobre cómo verificar la autenticidad de reseñas de Amazon es útil porque mantiene la atención en la calidad de la señal, no solo en el volumen de recopilación. La ingesta de reseñas solo es útil si el equipo posterior puede confiar en lo que están viendo.
Si el scraper necesita un inicio de sesión para hacer su trabajo, el riesgo legal y contractual cambia inmediatamente.
La nota interna sobre si el web scraping es legal pertenece al runbook de cada equipo de revisión. No porque dé permiso, sino porque fuerza la pregunta correcta temprano, antes de que la pipeline ya esté en producción y vinculada a un presupuesto de campaña.
Monitoreo, Almacenamiento y Escalado de la Pipeline
Una pipeline de reseñas se rompe en lugares aburridos. El marcado cambia, las tasas de éxito decaen, la frecuencia de CAPTCHA salta, y el equipo solo lo nota después de que el conjunto de datos ya está obsoleto. Un resumen de referencia de 2026 reportó que la tasa de éxito más alta entre los proveedores probados alcanzó el 96% para scraping de reseñas de Amazon, mientras que Decodo registró una tasa de éxito del 11% en Amazon con un tiempo promedio de finalización de 10 segundos en las URLs que procesó. Esa diferencia es un recordatorio de que el anti-bloqueo y la lógica de reintento importan más que el análisis HTML bruto. Resumen de referencia de scraping de reseñas de Amazon
La pila operativa
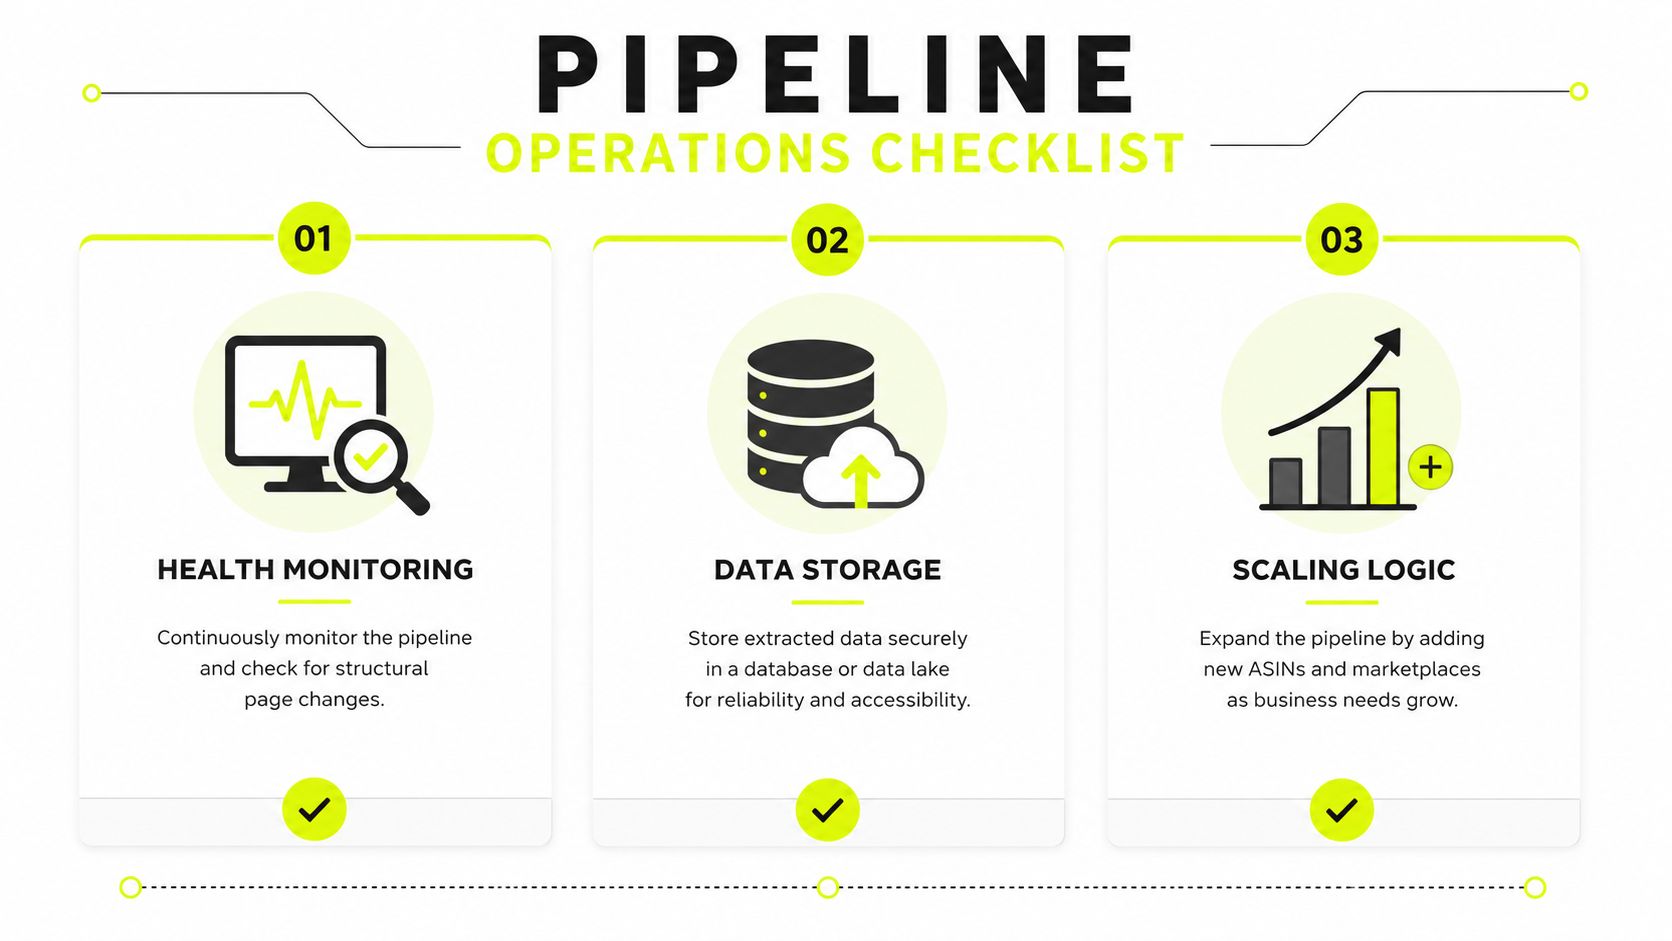
Usa Postgres para filas de reseñas normalizadas, S3 para instantáneas HTML sin procesar, y una cola entre trabajadores para que los reintentos no bloqueen toda la ejecución. Alerta sobre caídas repentinas en obtenciones exitosas, picos de CAPTCHA y cambios en la estructura de la página. Si un mercado comienza a derivar, degrada con gracia en lugar de forzar el mismo analizador en cada región.
Lista de verificación de escalado
- Grupos de workers por ASIN: Mantén los dominios de fallo pequeños para que un producto problemático no contamine todo el lote.
- Buckets de proxies regionales: Divide el tráfico por marketplace y configuración regional en lugar de mezclar todo en un solo pool.
- Diffing estructural: Compara la estructura de la página actual con la última instantánea válida conocida antes de confiar en el parseo.
- Presupuestos de reintentos: Limita los reintentos por ASIN para que una ruta bloqueada no consuma toda la ventana de trabajo.
- Almacenamiento de respaldo: Guarda la página sin procesar incluso cuando falle el parseo, porque el parser puede ponerse al día más tarde.
Si quieres un ejemplo de cómo se ve la escala controlada en un entorno intensivo en datos, el caso de estudio de Xr Voyage con FalkorDB muestra cómo los equipos piensan en el crecimiento sin perder la manejabilidad. La misma disciplina se aplica aquí. Mantén la capa de recolección estrecha, la capa de almacenamiento duradera y la capa de monitoreo lo suficientemente ruidosa como para detectar fallos antes que los clientes.
Si necesitas una infraestructura de proxies diseñada para pipelines de reseñas, cargas de trabajo geo-dirigidas y scraping sensible a sesiones, Sota Proxy te ofrece cobertura residencial, móvil, ISP y de datacenter con opciones sticky y rotativas que se ajustan a este caso de uso. Configúralo para el marketplace y el perfil de navegador que ya estás usando, y luego úsalo para mantener estable tu recolección de reseñas de Amazon en lugar de estar persiguiendo bloqueos todo el día.
Artículos relacionados
Los 10 Mejores Servicios de Proxy para Anuncios, Scraping y Automatización
Compara los mejores servicios de proxy para verificación de anuncios, scraping, operaciones de cuentas y geo-targeting según tipo de IP, precio, tiempo de actividad y controles.
10 Alternativas a Smartproxy para Equipos Técnicos
Compara 10 alternativas a smartproxy según tipo de proxy, calidad de IP, segmentación, rotación, velocidad, precios y caso de uso para equipos técnicos.
10 Alternativas a IPRoyal para Cargas de Trabajo Proxy Serias
Compara 10 alternativas a IPRoyal para scraping, verificación de anuncios, gestión de cuentas, navegadores antidetección, campañas geo, precios, rotación y soporte.
10 Alternativas a Oxylabs para Scraping y Operaciones Publicitarias
Compara 10 alternativas a Oxylabs por tipo de proxy, cobertura geográfica, tiempo de actividad, rotación, precios y caso de uso para scraping, verificación de anuncios y gestión de cuentas.
Mejores Alternativas a Brightdata para Equipos de Proxies en 2026
Descubre las mejores alternativas a Brightdata para scraping, verificación de anuncios y campañas geosegmentadas en 2026, además de consejos de migración.
Se ha alcanzado el límite de recursos: Soluciones para proxies, servidores y más
Aprende cómo solucionar los errores de límite de recursos alcanzado en proxies, servidores y APIs con soluciones prácticas para 2026.