Se ha alcanzado el límite de recursos: Soluciones para proxies, servidores y más
Aprende cómo solucionar los errores de límite de recursos alcanzado en proxies, servidores y APIs con soluciones prácticas para 2026.
Estás en medio de un lanzamiento, un cliente quiere el siguiente lote de cuentas calentadas, y el panel muestra Límite de Recursos Alcanzado otra vez. El sitio funcionaba bien hace diez minutos, el pool de proxies todavía tiene inventario, y la capa de API de repente se niega a cooperar. Ese mensaje parece simple, pero en la práctica suele apuntar a uno de tres topes diferentes, y la solución depende de cuál hayas alcanzado.
Tabla de Contenidos
- Tres Errores Diferentes Detrás del Mismo Mensaje
- Diagnóstico de Fallos de Recursos en cPanel y CloudLinux
- Ajuste de Servidores Linux y Límites de Contenedores
- Elegir el Tipo de Proxy Adecuado para Tu Carga de Trabajo
- Gestión del Pool de Proxies y Estrategias de Rotación
- Marco de Monitoreo y Prevención
- Rutas de Escalamiento y Solicitudes de Soporte
Tres Errores Diferentes Detrás del Mismo Mensaje
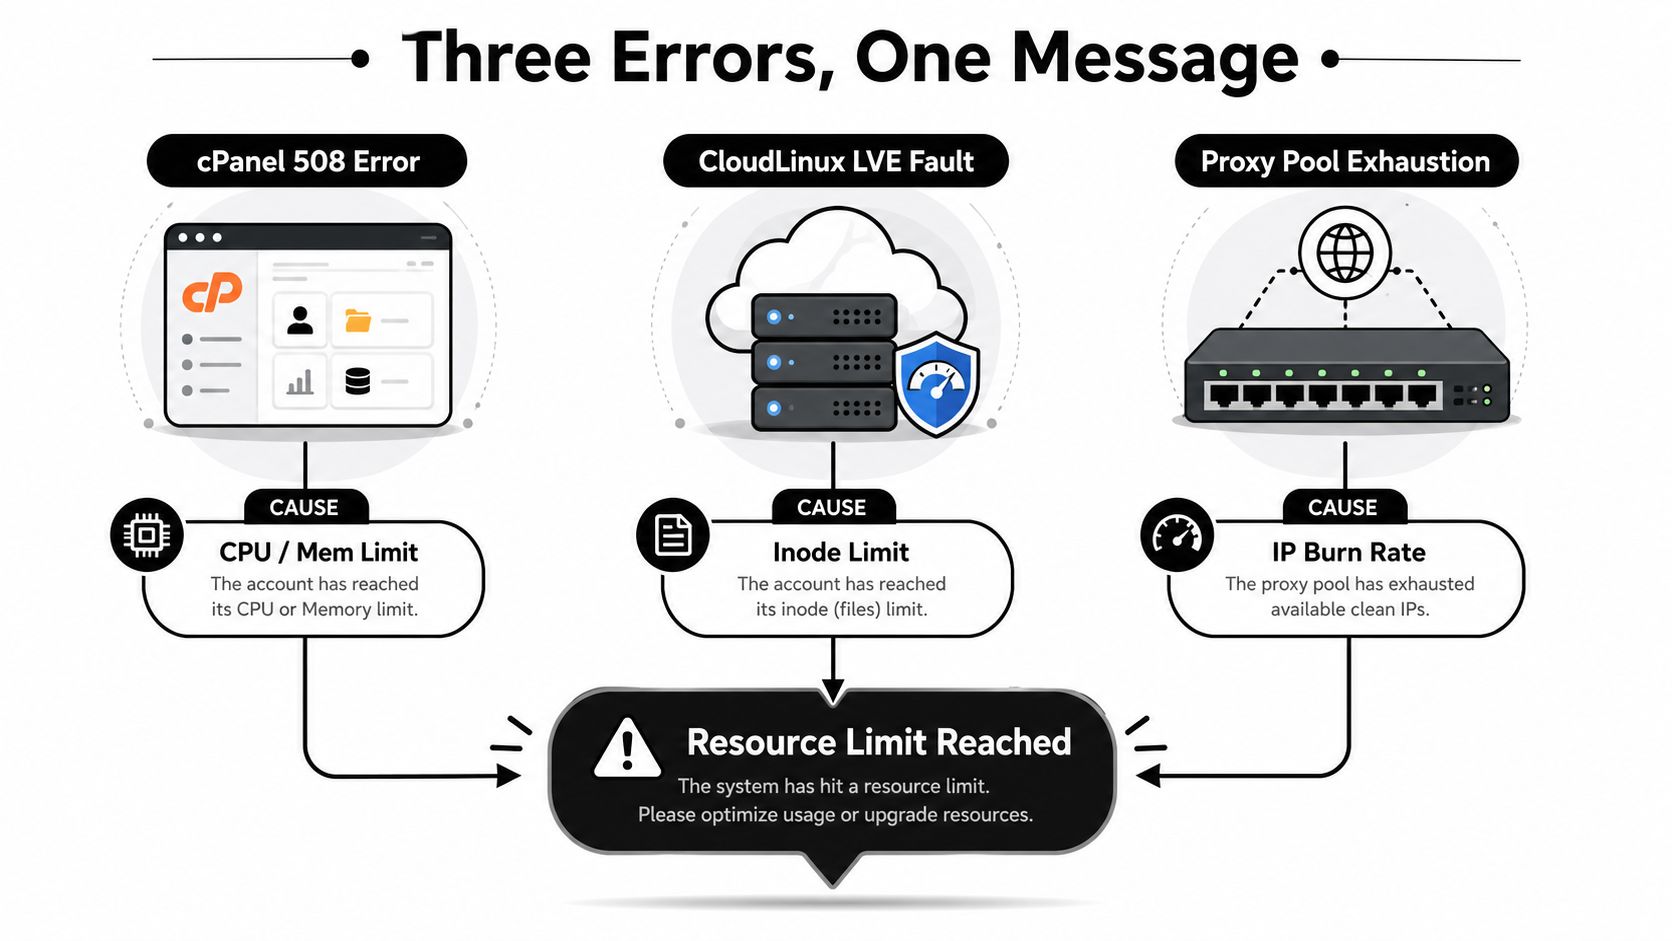
límite de recursos alcanzado no es un solo error. En hosting compartido, a menudo significa que la cuenta ha alcanzado un tope de concurrencia, especialmente en servidores cPanel y CloudLinux donde el limitador rastrea Procesos de Entrada en lugar de tráfico bruto. En sistemas Linux, la misma advertencia puede provenir de ulimits, topes de descriptores de archivo o topes de procesos. En trabajo de nube y plataforma, puede apuntar a un error de cuota o tope de API que requiere una solicitud formal, no un ajuste de rendimiento.
Identifica primero el entorno
Si el mensaje aparece dentro de cPanel, verifica si el fallo coincide con actividad de WordPress, una solicitud de página de destino o un trabajo PHP activado por cron. La primera revisión debe enfocarse en uso de CPU, RAM/memoria física y Procesos de Entrada, porque esos son los contadores que los proveedores de hosting usan para rastrear la ruta del fallo (diagnóstico de recursos del lado del hosting). En configuraciones CloudLinux, el problema generalmente no es "demasiados visitantes" en abstracto, sino demasiados workers PHP intentando ejecutarse al mismo tiempo.
Si el mensaje aparece en Azure, Oracle u otro panel de control, trátalo como un problema de cuota hasta que la evidencia indique lo contrario. La guía de cuotas de Microsoft dirige a los operadores a Uso + cuotas y un flujo de solicitud para elevar el tope, que es una solución diferente a la optimización de caché o limpieza de plugins (manejo de errores de cuota en Azure). El V$RESOURCE_LIMIT de Oracle es otro recordatorio de que los topes de sesión y proceso de base de datos pertenecen a su propia clase de fallo.
Regla práctica: si la solución cambia la concurrencia de solicitudes, es un límite de hosting o servidor. Si la solución pide más asignación en una región o servicio, es un límite de cuota.
Para equipos de arbitraje de tráfico que ejecutan AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc a través de cuentas publicitarias de Facebook y TikTok, esa distinción ahorra tiempo. Un problema de agotamiento del pool de proxies, un 508 de cPanel y un límite de cuota de API pueden parecer todos "el sistema está bloqueado", pero necesitan respuestas diferentes. Si los tratas igual, desperdicias el plazo en la capa equivocada.
El diagnóstico más rápido es directo. Verifica el contexto del error, anota la marca de tiempo y pregunta qué estaba ejecutándose en ese momento. Si fue una ráfaga de inicios de sesión, redirección de cloaking, importación, respaldo o barrido de bots, el problema probablemente sea de concurrencia. Si el panel del proveedor dice cuota, tasa o tope de uso, deja de ajustar la aplicación y ve directo a la gestión de cuotas o al soporte del proveedor. Para una referencia relacionada con códigos de respuesta, consulta la explicación del HTTP 503.
Diagnóstico de Fallos de Recursos en cPanel y CloudLinux
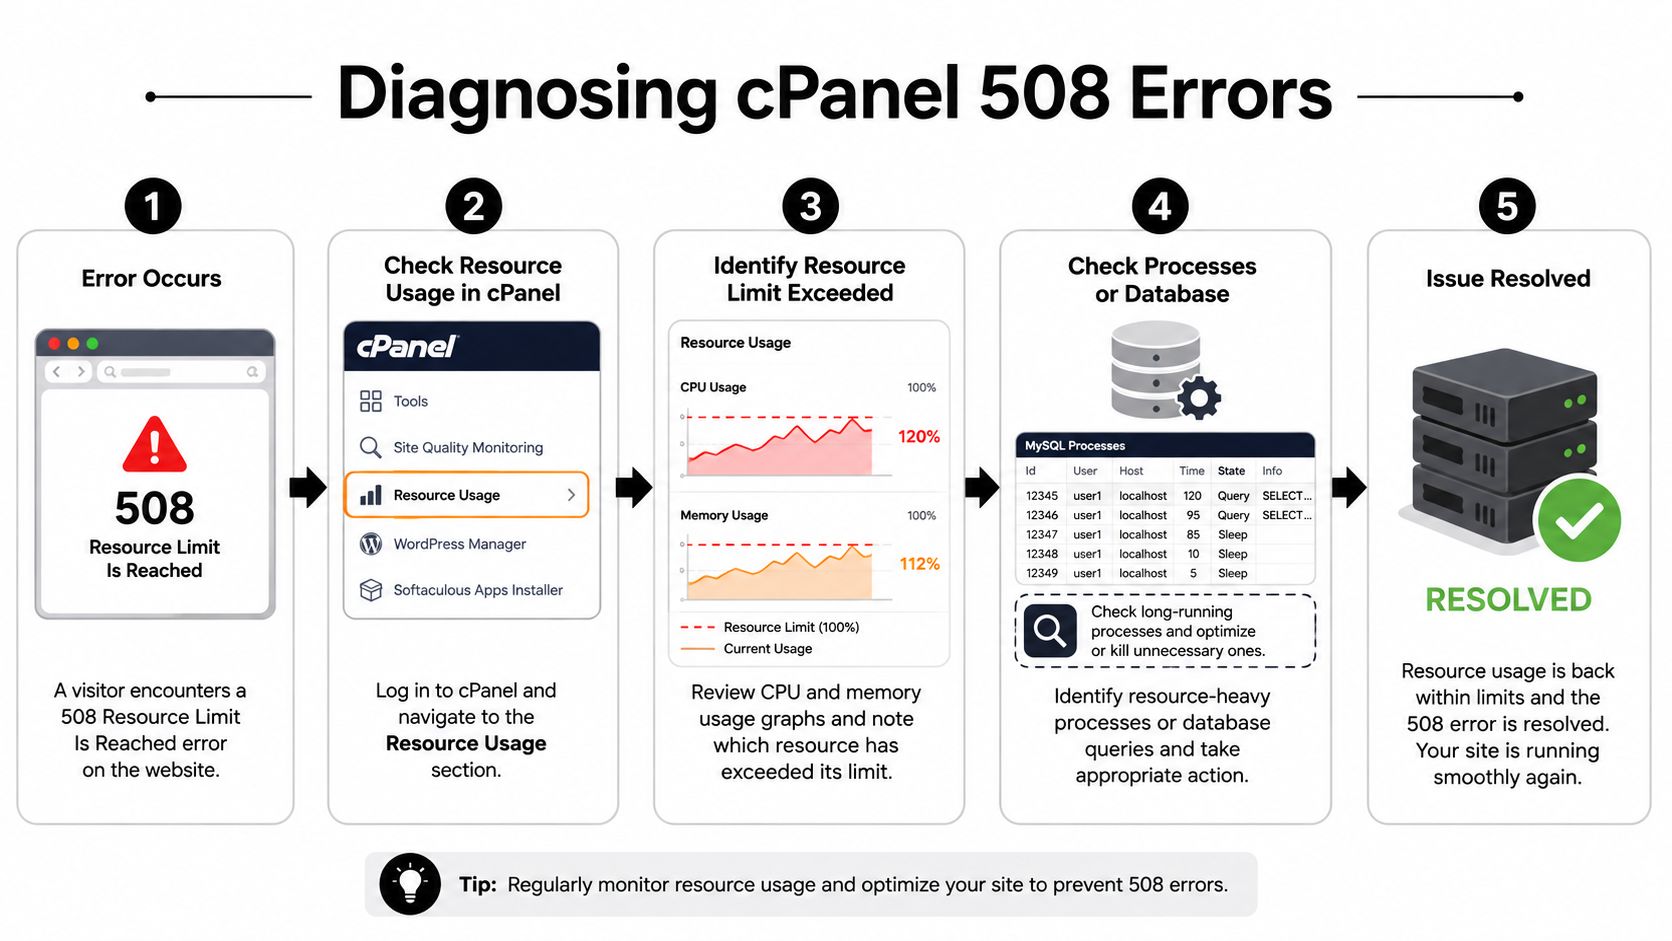
Un 508 de cPanel normalmente no es misterioso una vez que abres el panel correcto. La clave es dejar de mirar el uso promedio e inspeccionar la ventana exacta del fallo. La guía de hosting recomienda ir a cPanel → Métricas → Uso de Recursos, luego revisar los gráficos históricos de CPU, RAM, E/S y Procesos de Entrada, y hacer coincidir esos puntos con los registros y el momento exacto en que ocurrió el fallo (diagnóstico de Uso de Recursos de cPanel).
Lee los fallos, no solo los promedios
El uso promedio puede ocultar el problema. Un sitio puede parecer tranquilo durante el día y aun así acumular una ráfaga de fallos durante picos de tráfico, ejecuciones de cron o actividad de bots. La documentación de hosting trata la tabla de fallos como más útil que el gráfico promedio porque una línea diaria baja aún puede ocultar fallos repetidos de memoria o procesos de entrada durante picos cortos.
Eso importa para el tráfico de campañas. Una página de destino impactada por una ráfaga de anuncios de Facebook puede mantenerse bajo el límite la mayor parte del día, pero chocarlo cuando varias solicitudes PHP llegan a la vez. El mismo patrón se presenta con redirecciones de cloaking de TikTok, llamadas admin-ajax o una cola de tareas en segundo plano que se activan juntas.
Haz coincidir el momento del fallo con la carga de trabajo
Una vez que tengas la marca de tiempo, compárala con la actividad del sitio. Revisa las tareas cron, wp-cron, los horarios de respaldo, la generación de imágenes, la creación de PDF y los escaneos de seguridad. La orientación para hosting compartido señala esas tareas superpuestas como causas comunes de picos de límite, especialmente cuando se ejecutan junto con tráfico legítimo (pasos de remediación en hosting compartido). Si la falla coincide con un trabajo recurrente, el culpable probable ya está frente a ti.
Un promedio diario bajo no demuestra que el servidor esté saludable. En cPanel, los picos cortos son los que rompen la cuenta.
Por eso el primer movimiento generalmente no es agregar más tráfico o comprar un plan más grande. Es identificar si uno de estos está provocando que se alcance el límite:
- Picos de CPU, que apuntan a trabajo pesado de PHP o consultas costosas.
- Fallas de RAM, que generalmente significan plugins hambrientos de memoria, exportaciones o scripts.
- Mesetas de I/O, que a menudo provienen de respaldos, rotación de caché o trabajos intensivos en archivos.
- Fallas de Entry Process, que usualmente significan demasiadas solicitudes PHP concurrentes.
Ajuste de Servidores Linux y Límites de Contenedores
Una vez que dejas el hosting compartido, el modo de fallo cambia. Los servidores Linux y los contenedores no te muestran un gráfico amigable de cPanel, sino que imponen límites mediante ulimits, topes de descriptores de archivo y límites de recursos basados en cgroups. Si estás ejecutando servicios de rotación de proxies, stacks de creación de cuentas o múltiples perfiles de navegador en un VPS, necesitas verificar los límites del sistema operativo directamente en lugar de adivinar.
Verifica los límites actuales antes de cambiarlos
Comienza con ulimit -a para ver los límites actuales del shell. Luego inspecciona la presión de descriptores de archivo con lsof y /proc/sys/fs/file-nr. Si el conteo de procesos o archivos abiertos sigue aumentando durante la automatización del navegador, el problema podría no ser el CPU en absoluto, podría ser que el servidor se haya quedado sin manejadores para sockets y archivos.
Para cambios persistentes, aumenta tanto los límites soft como hard en /etc/security/limits.conf. Ese es el archivo que controla lo que usuarios y servicios pueden mantener abierto después del inicio de sesión o arranque del servicio. Si el flujo de trabajo depende de muchas instancias simultáneas de Chromium, ese ajuste a menudo importa más que agregar más nodos de navegador.
Trata los contenedores de manera diferente al hardware físico
Docker y Kubernetes añaden otra capa. Las flags --ulimit de Docker te permiten establecer límites específicos por contenedor, mientras que Kubernetes usa requests y limits para evitar que los pods mueran bajo carga. Si tu stack de automatización se ejecuta en pods, un reinicio de contenedor puede parecer un problema de proxy cuando en realidad es un límite de memoria o procesos.
Por eso sigue importando comprar una máquina más potente. Si estás dimensionando infraestructura para una carga de trabajo más pesada, un catálogo de hardware adecuado te ayuda a comparar opciones de CPU, RAM y almacenamiento antes de comprometerte, y el catálogo de servidores Amax IT es útil para ese tipo de preselección.
Para equipos que gestionan muchas sesiones de navegador, la secuencia práctica suele ser esta:
- Medir los límites actuales del shell con
ulimit -a. - Verificar la presión de archivos abiertos con
lsofy file-nr. - Aumentar los límites de usuario en
limits.conf. - Establecer límites de contenedor con Docker o Kubernetes.
- Re-testear bajo carga de trabajo real, no una carga de prueba.
La idea operacional es simple. Un stack pesado en proxies puede fallar porque no tiene más sockets, no tiene más archivos o no tiene más ranuras de proceso mucho antes de saturar el CPU. Si no mides el límite correcto, seguirás comprando capacidad en el lugar equivocado.
Para una planificación de capacidad más amplia en torno al volumen de solicitudes y rendimiento, la guía de herramientas de gestión de ancho de banda es una referencia complementaria útil.
Elegir el Tipo de Proxy Correcto para tu Carga de Trabajo
Los límites de proxy parecen aleatorios hasta que los alineas con el trabajo que estás haciendo. Los proxies residenciales, móviles, de datacenter e IPv6 no fallan de la misma manera, y la elección incorrecta puede hacer que una campaña muera a mitad de la configuración. Si estás haciendo creación de cuentas, cloaking o campañas geo-dirigidas en cuentas publicitarias de Facebook y TikTok, elige la clase incorrecta de proxy y quemarás el pool más rápido de lo que las cuentas pueden estabilizarse.
Ajusta la confianza a la tarea
Los proxies residenciales generalmente se ajustan mejor a la creación de cuentas y flujos de inicio de sesión sensibles porque se parecen más al tráfico normal de usuario. El compromiso es la presión de cuota, ya que tienden a consumir la asignación más rápido cuando haces muchos reintentos, calentamientos o sesiones paralelas. Los proxies móviles tienden a funcionar bien en flujos de trabajo sociales más estrictos, especialmente donde importa la confianza de la plataforma, pero son los más caros operacionalmente. Los proxies de datacenter pueden darte un rendimiento amplio para scraping y cargas de trabajo de menor fricción, pero las plataformas sociales a menudo los bloquean de manera más agresiva. Los proxies IPv6 funcionan donde el objetivo los soporta, pero muchos flujos de trabajo aún fallan porque la plataforma, app o stack de navegador no acepta la familia de direcciones.
Para equipos que usan navegadores antidetección como AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc, ese compromiso es práctico, no teórico. Un perfil de navegador que necesita comportamiento de inicio de sesión estable generalmente quiere algo más cercano a características residenciales o móviles. Un trabajo de scraping o parseo puede tolerar rangos de datacenter mejor, especialmente si el objetivo es rendimiento bruto en lugar de reputación de cuenta.
Comparación de tipos de proxy para operaciones de cuentas publicitarias
| Tipo de Proxy | Nivel de Confianza | Costo por GB | Mejor Para | Limitaciones |
|---|---|---|---|---|
| Residencial | Mayor confianza con plataformas sociales | Mayor que datacenter | Creación de cuentas, calentamiento, cloaking | La cuota se quema más rápido |
| Móvil | Confianza muy fuerte para comportamiento móvil | Mayor presión de costo práctica | Cuentas publicitarias de TikTok, flujos sociales sensibles | Caro y más difícil de escalar |
| Datacenter | Menor confianza en plataformas sociales | Menor presión de costo | Scraping, verificaciones masivas, automatización no social | Se bloquea más a menudo en plataformas publicitarias |
| IPv6 | Dependiente de la plataforma | Varía según el proveedor | Objetivos específicos compatibles | Falla donde el soporte IPv6 es débil |
La elección correcta es específica de la carga de trabajo. Si el trabajo es un perfil nuevo de Facebook con baja tolerancia al ruido, residencial o móvil tiene más sentido. Si el trabajo es extracción masiva o un flujo de operaciones menos sensible, datacenter es la elección más eficiente. Si la plataforma solo soporta bien un stack, IPv6 todavía puede estar bien, pero no asumas compatibilidad.
Para un desglose más profundo de estas clases, la guía de tipos de proxy es la referencia más clara para combinar con esta decisión. Para equipos de afiliados, Sota Proxy también tiene un programa de referidos con hasta 40% de comisión, lo cual importa si tu modelo de margen incluye gasto recurrente en proxies.
Gestión de Pools de Proxies y Estrategias de Rotación
Muchos errores de "límite de recursos" de proxy son autoinfligidos. El pool no fue agotado por la plataforma, fue consumido por una política de rotación que quema IPs demasiado rápido o distribuye las sesiones de manera muy dispersa. Si ejecutas múltiples cuentas publicitarias, especialmente dentro de AdsPower o GoLogin, el patrón de rotación necesita coincidir con la tarea, no solo con la teoría.
Configura la rotación según el flujo de trabajo, no por hábito
Las sesiones persistentes tienen sentido para inicios de sesión, calentamiento de perfiles y cualquier cosa que necesite que la misma identidad se mantenga en su lugar. La rotación rápida tiene más sentido para scraping, verificaciones públicas y solicitudes de corta duración que no necesitan continuidad. Si rotas demasiado agresivamente durante la configuración de cuenta, obligas a la plataforma a ver demasiados cambios de identidad. Si te mantienes persistente demasiado tiempo durante el scraping, desperdicias IPs limpias en tareas que no las necesitan.
La distribución de carga también importa. No ejecutes todas las cuentas a través del mismo proveedor. Divide las cuentas de alta prioridad, cuentas de prueba y trabajos de investigación desechables en grupos separados para que una sola ráfaga no drene toda la operación. Esto evita que una prueba fallida contamine el carril de producción.
Monitorea la salud antes de que el pool se agote
Usa un panel de control que muestre el uso en tiempo real y configura alertas antes de que el pool esté vacío. Si solo notas el agotamiento después de que falle el siguiente inicio de sesión, ya estás atrasado. La segmentación a nivel de ciudad también puede reducir la rotación innecesaria de IP porque reduce el patrón objetivo en lugar de obligar al sistema a seguir buscando nuevos endpoints.
La rotación es un problema de capacidad, no solo un problema de enrutamiento. Si el cronograma está mal, incluso un pool grande desaparece rápido.
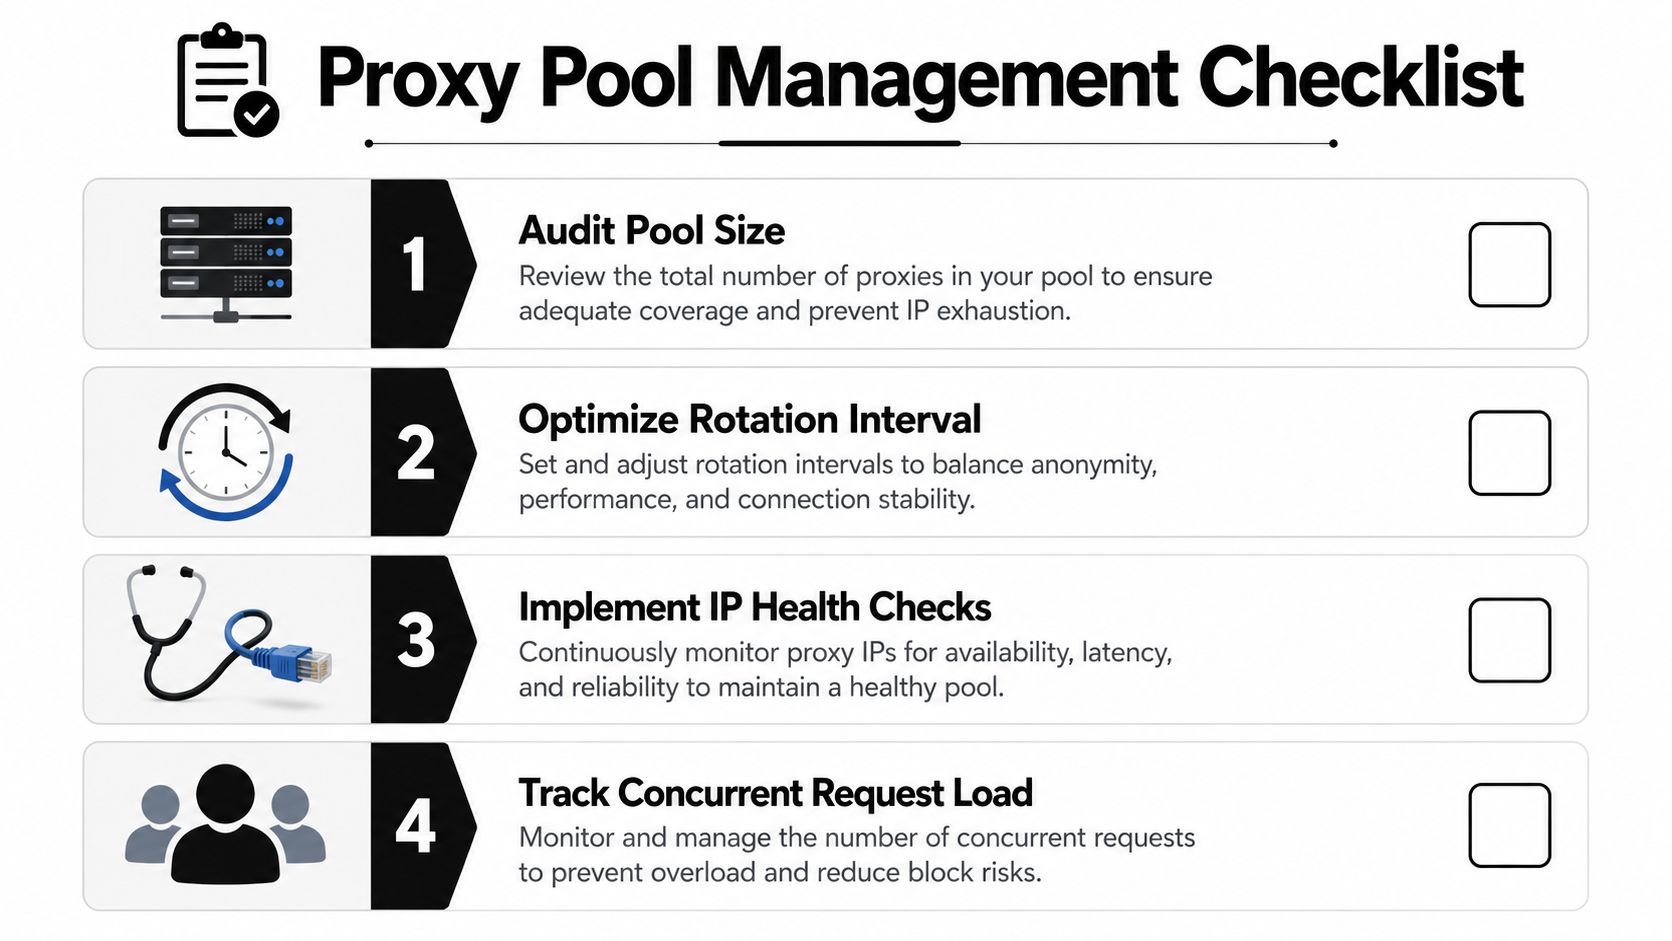
Una rutina práctica de proxies se ve así:
- Audita el tamaño del pool contra los perfiles de navegador concurrentes y las ventanas de campaña activas.
- Ajusta el intervalo de rotación al tipo de tarea: persistente para identidad, rápida para scraping.
- Verifica la salud de la IP antes de reutilizar direcciones en flujos sensibles.
- Rastrea la carga de solicitudes concurrentes para que un lote no prive al resto.
Para equipos que hacen account farming o cloaking, el calentamiento de proxies también es parte de la ecuación. Aumentar gradualmente el uso hace que el patrón de tráfico parezca menos sintético que un cambio repentino. El punto no es engañar a la plataforma con ruido, es mantener el flujo de trabajo lo suficientemente estable para que el pool no desperdicie capacidad en reintentos y reinicios evitables.
Para tácticas de rotación más detalladas, la guía de rotación de IP de proxy es el seguimiento adecuado.
Marco de Monitoreo y Prevención
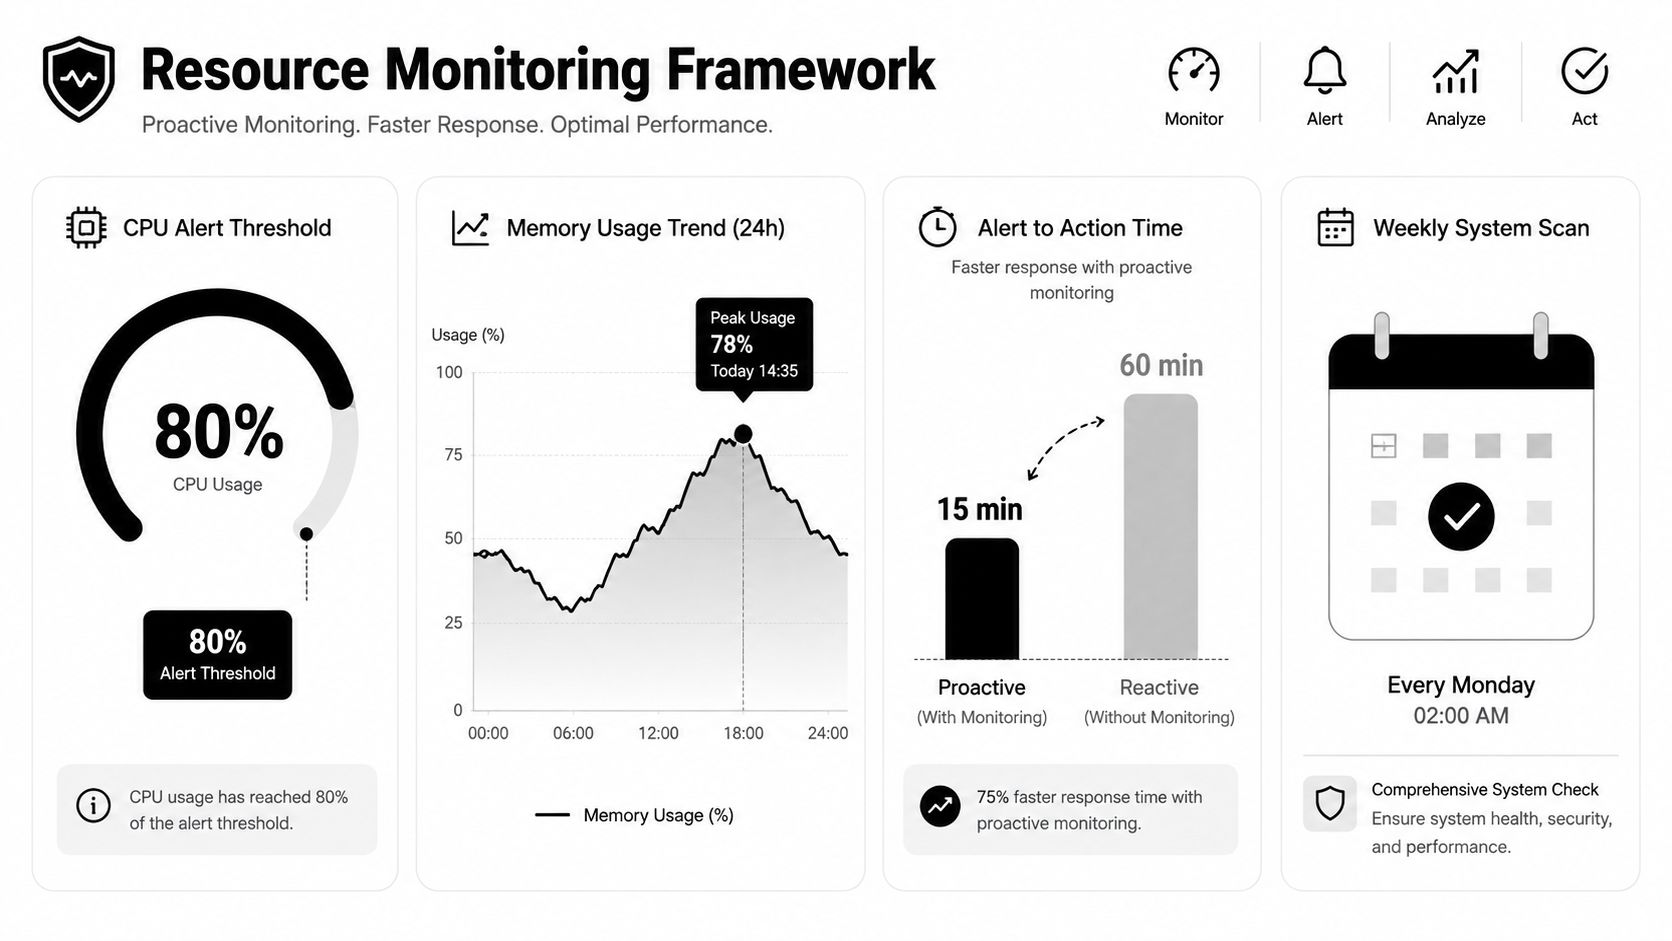
Una campaña puede parecer saludable una hora y comenzar a fallar la siguiente si solo observas las alertas después de que los usuarios encuentren errores. La prevención significa rastrear el servidor, la capa de proxy y la capa de API juntos, y luego reaccionar antes de que cualquier techo se convierta en el cuello de botella. En el arbitraje de tráfico, esto importa porque la creación de cuentas, el cloaking y los lanzamientos de campañas estresan diferentes partes del stack en diferentes momentos.
Construye alertas en torno a umbrales, no interrupciones
En el lado del servidor, observa CPU, RAM, procesos de entrada y descriptores de archivos. En el lado del proxy, rastrea consumo de cuota, tiempos de respuesta y tasas de éxito. En el lado de la API, monitorea el volumen de solicitudes contra límites regionales o específicos del servicio. La guía de cuotas de Azure deja claro que estos límites a menudo están delimitados por región, por lo que una sola suposición global se desmorona rápidamente (manejo de cuotas de Azure).
Las alertas necesitan activarse temprano. Si la cuenta o región ya está rechazando solicitudes, la recuperación lleva más tiempo y la campaña pierde impulso. Un panel de control útil muestra la desviación antes del fallo, no solo un estado rojo después del hecho.
Usa el monitoreo para separar carga normal de carga mala
La pregunta no es si el tráfico es alto. Es qué tipo de tráfico está creando la presión. Una ráfaga de una campaña en vivo, una tormenta de reintentos de un script roto y un patrón de automatización tipo bot golpean los límites de diferentes maneras. La guía de hosting también señala los trabajos cron, wp-cron y bots abusivos como desencadenantes comunes, lo que significa que el monitoreo debe separar la forma de la carga de trabajo del volumen bruto (análisis de patrones de hosting compartido).
Un marco práctico se ve así:
- Métricas del servidor para capacidad y concurrencia.
- Métricas de proxy para rotación, consumo de cuota y éxito de solicitudes.
- Métricas de API para límites de tasa y regionales.
- Etiquetas de campaña para que puedas ver si la creación de cuentas, cloaking o gestión de anuncios causó el pico.
La guía de métricas de rendimiento de infraestructura IT proporciona una línea base útil sobre cómo estructurar esas mediciones. Para operaciones del día a día, el objetivo es simple: hacer que la alerta se active antes de que la cuenta se ponga roja, no después de que la campaña ya se haya estancado.
Rutas de Escalamiento y Solicitudes de Soporte
A veces la solución correcta no es más ajustes, es el escalamiento. Eso podría significar un aumento de cuota, una actualización de hosting, una mejor asignación de proxies o un cambio estructural en cómo se ejecuta la carga de trabajo. La diferencia entre una aprobación rápida y una lenta generalmente se reduce a la calidad de los datos que envías.
Envía al soporte lo que necesita en el primer intento
Antes de abrir un ticket, recopila los gráficos de recursos de los últimos 7 días, las marcas de tiempo exactas del error, el recuento de procesos concurrentes en el momento del fallo y los límites del plan actual versus lo que hizo la carga de trabajo. Eso le da al soporte una imagen clara de si tienes un problema de ráfaga, un problema de techo crónico o una configuración incorrecta. También evita que te reboten con un genérico "por favor proporciona más detalles".
Si le estás pidiendo a un proveedor de nube más margen, usa el proceso de cuota de la plataforma en lugar de discutir sobre el rendimiento. Si el proveedor documenta una solicitud de aumento de cuota, preséntala como una solicitud de capacidad, no como un reporte de error. Si el problema es específico del proxy, como agotamiento del pool de IP o disponibilidad regional, escala al soporte de proxies con el mismo paquete de evidencia y solicita una ruta de asignación concreta.
Sabe cuándo la arquitectura tiene que cambiar
A veces la respuesta correcta es un cambio mayor. El hosting compartido no siempre puede absorber la carga de trabajo que crea un stack de campaña agresivo. En ese caso, moverse a VPS o infraestructura dedicada es más limpio que pedir excepciones interminables. La misma lógica se aplica a los proxies. Si el pool de un proveedor no puede sostener tus patrones de inicio de sesión, calentamiento y scraping, divide la carga de trabajo o cambia la mezcla de proveedores.
Para ayuda específica sobre proxies, la página de soporte al cliente 24/7 es el canal de contacto adecuado cuando un problema del pool necesita atención inmediata. Para cualquier solicitud de soporte, mantén el mensaje breve y técnico. Indica el error, la marca de tiempo, la carga de trabajo que se estaba ejecutando en ese momento y el límite exacto que crees que se alcanzó. Eso te conseguirá un diagnóstico más rápido que cualquier queja vaga.
Si necesitas una forma más clara de mantener bajo control las campañas, cuentas y el uso de proxies, visita Sota Proxy y compara los tipos de proxy, ubicaciones y opciones de rotación con tu flujo de trabajo real. Es una solución directa para equipos de arbitraje de tráfico que necesitan infraestructura estable bajo presión de plazos.
Artículos relacionados
Cuántas Cuentas Puedes Tener en Cada Plataforma en 2026
Límites publicados para once plataformas comparados lado a lado, los cuatro regímenes de reglas diferentes detrás de ellos, y por qué el número en la aplicación nunca es la restricción real.
Cuánto Ganas Realmente en OnlyFans en 2026: La Estructura Completa de Comisiones
La distribución publicada de ganancias, cada recorte entre el dólar de un fan y tu cuenta bancaria, cuándo llega realmente el dinero y la única métrica que decide si la promoción funciona.
Cómo Probar un Proxy Antes de Comprarlo: Lista de Verificación de 10 Minutos
Diez comprobaciones que te indican si un proxy de prueba vale la pena: ASN de salida, indicadores de hosting, comportamiento de rotación, distribución de subredes, fugas de DNS y WebRTC, y tasa de éxito en tu objetivo específico.

Cómo Ganar Dinero con Web Scraping en 2026: Cinco Modelos, con Precios
Cinco formas en que los scrapers generan ingresos, cuánto cobra cada uno y cuánto cuesta realmente ejecutar un scraping, medido en páginas reales: solo HTML versus renderizado completo del navegador.

Lo que realmente cuesta un stack de multi-accounting en 2026
Cifras mensuales reales para 10, 50 y 200 cuentas: perfiles antidetect, proxies, números, teléfonos en la nube y comisiones de tarjetas, con la partida que se come tres cuartas partes del presupuesto.

Balanceo de Carga de Proxies Explicado para Profesionales
Aprende cómo funciona el balanceo de carga de proxies para Facebook, TikTok y flujos de trabajo con múltiples cuentas. Cubre algoritmos, arquitecturas y mejores prácticas.