Cómo Evitar CAPTCHA en Flujos de Trabajo Automatizados
Aprende cómo evitar CAPTCHA en flujos de trabajo automatizados con tácticas de proxies, navegadores antidetección, control de ritmo de solicitudes y respaldos de resolución diseñados para operadores reales.
Tu campaña está activa, el gasto avanza y entonces el flujo de inicio de sesión se detiene tras otro CAPTCHA. Una cuenta necesita un desafío de imagen. Una segunda solicita verificación telefónica. Por la mañana, el mismo grupo de proxies ha empujado múltiples IDs de Facebook Business Manager a revisión, mientras que los perfiles de TikTok comienzan a solicitar verificaciones adicionales. La reacción obvia es buscar un solucionador más rápido. En producción, ese suele ser el primer movimiento equivocado.
Evitar CAPTCHAs es principalmente un problema de huella digital y puntuación de confianza. Las plataformas evalúan todo el contexto de la solicitud, incluyendo la red, el perfil del navegador, el historial de sesión, el tiempo y el patrón de interacción. Una solución limpia del rompecabezas no puede reparar una identidad dañada. Esta guía se centra en reducir desafíos innecesarios en AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc, con consideraciones prácticas para cuentas publicitarias de Facebook y TikTok, cultivo de cuentas, cloaking y campañas geosegmentadas.
Tabla de Contenidos
- Por Qué los CAPTCHAs Siguen Afectando Tus Flujos de Trabajo
- Elegir el Tipo de Proxy Adecuado para Reducir los Activadores de CAPTCHA
- Configurar Navegadores Antidetección para Huellas Digitales Estables
- Ritmo de Solicitudes e Higiene de Sesión Que Reduce los Desafíos
- Elegir Entre APIs de Solución de CAPTCHA y Solucionadores Humanos
- Patrones de Monitoreo y Respaldo Cuando los CAPTCHAs Aumentan
- Consideraciones Legales, Éticas y de Riesgo de Plataforma
Por Qué los CAPTCHAs Siguen Afectando Tus Flujos de Trabajo
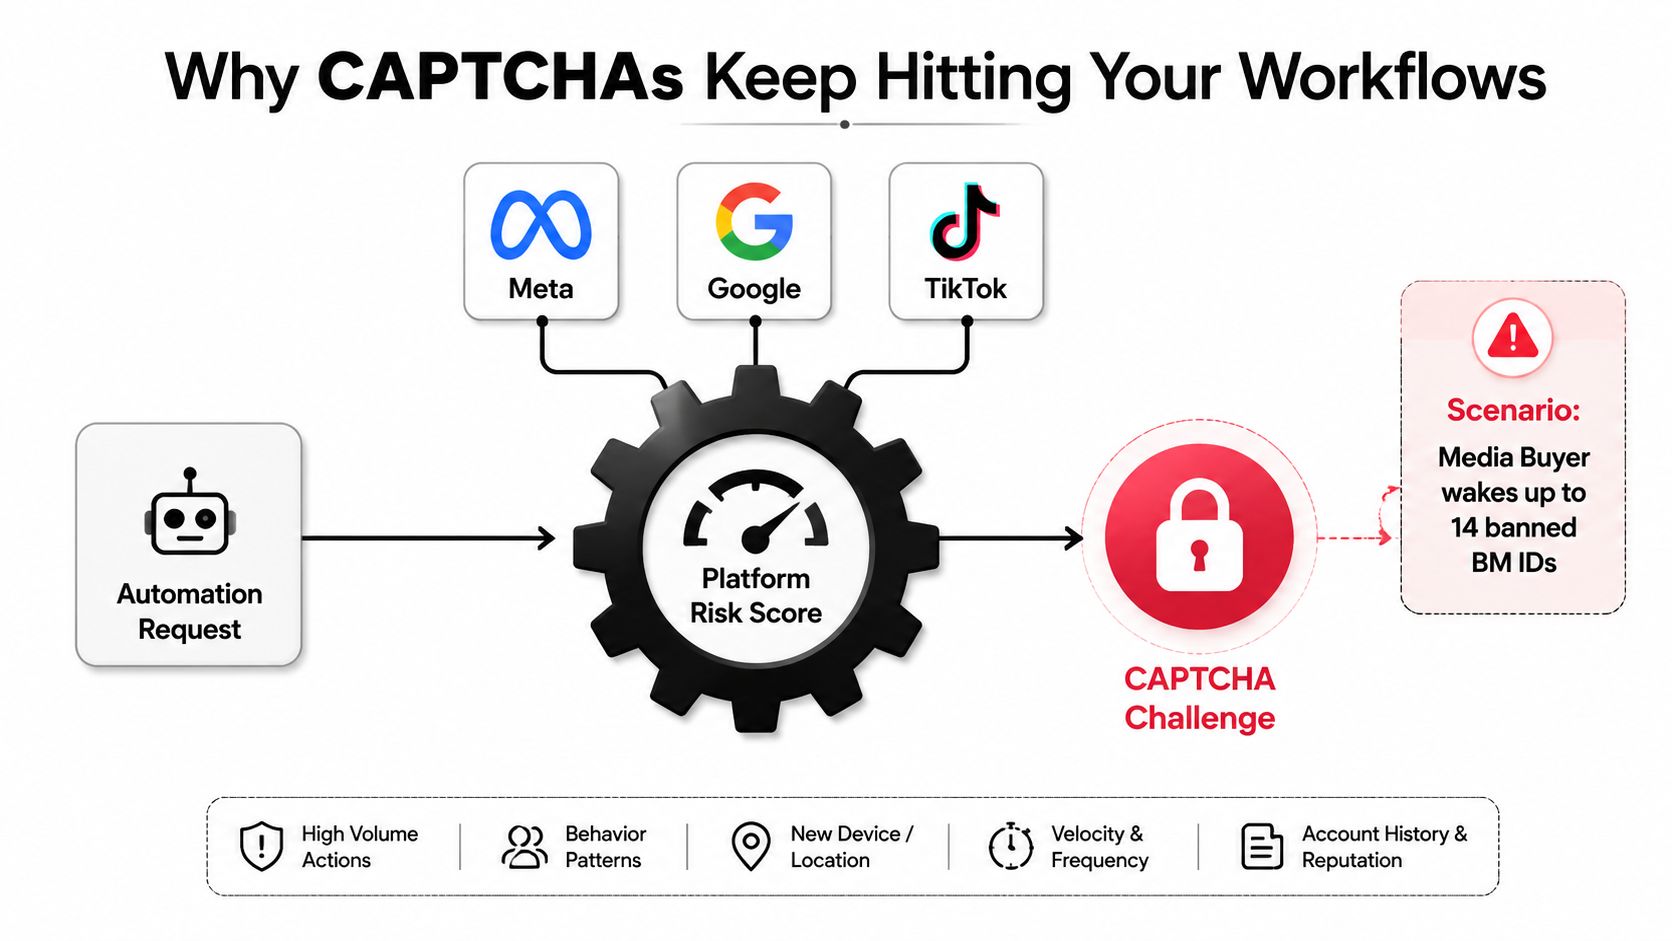
Un comprador de medios abre el panel de control y encuentra un conjunto de cuentas atascadas en verificación. El equipo no necesariamente implementó un nuevo script. Un grupo de proxies se degradó, un perfil de navegador cambió su salida WebGL, o varias identidades iniciaron sesión desde el mismo patrón de red. La plataforma ve la señal combinada, reduce su confianza y añade fricción.
Cloudflare informó que el 31.2% del tráfico de aplicaciones fue tráfico de bots en su actualización de 2024, mientras que el 93% de los bots identificados no estaban verificados y eran potencialmente maliciosos (informe de seguridad de aplicaciones de Cloudflare). Ese entorno obliga a las plataformas a clasificar solicitudes continuamente. Un CAPTCHA a menudo aparece después de que el clasificador detecta una combinación sospechosa, no porque una visita aislada a la página demuestre automatización.
Las señales que reducen la confianza
Las señales prácticas son familiares para cualquiera que gestione múltiples identidades:
- Reputación de IP: Un nodo de salida previamente abusado puede activar un desafío antes de que el navegador cargue el flujo de trabajo.
- Deriva de huella digital: Canvas, WebGL, audio, fuentes, dimensiones de pantalla y client hints deben permanecer coherentes entre sesiones.
- Cadencia de solicitudes: Ráfagas paralelas y tiempos idénticos no se parecen a la navegación ordinaria.
- Antigüedad de cookies: Un perfil nuevo sin historial de sesión significativo tiene menos confianza que una identidad establecida y consistente.
- Biometría del comportamiento: Profundidad de desplazamiento, cambios de enfoque, orden de navegación y tiempo entre acciones contribuyen a la clasificación.
Cada señal tiene un control correspondiente. Mejora la red en lugar de cambiar repetidamente las salidas. Mantén el perfil antidetección estable en lugar de regenerar huellas digitales. Dosifica las acciones y preserva las sesiones en lugar de martillear reintentos. Haz coincidir la zona horaria y el idioma con la ubicación del proxy en lugar de presentar geografía contradictoria.
Una introducción útil sobre terminología de CAPTCHA y tipos de desafíos ayuda a separar los rompecabezas visibles de los sistemas de riesgo en segundo plano. Para pruebas legítimas y automatización autorizada, la guía sobre cómo eludir CAPTCHAs legalmente es una mejor referencia que los foros que prometen evasión universal.
Regla de producción: Trata una tasa creciente de CAPTCHA como una alarma de puntuación de confianza. No la trates como una cola de rompecabezas.
El objetivo no es burlar un desafío indefinidamente. Es reducir los falsos positivos en un clasificador propiedad de alguien más. Eso significa menos cambios abruptos de identidad, menos ráfagas sospechosas y mayor alineación entre el perfil, el proxy y el flujo de trabajo.
Elegir el Tipo de Proxy Adecuado para Reducir los Activadores de CAPTCHA
La selección de proxy cambia la reputación inicial de cada identidad. No reparará una huella digital de navegador contradictoria o un patrón de solicitudes abusivo, pero una mala elección de red puede hacer que todas las demás optimizaciones sean irrelevantes. La distinción principal es cómo se origina la dirección y cómo las plataformas interpretan su historial.
Los proxies móviles usan redes de operadores. Sus direcciones a menudo pertenecen a grupos más pequeños gestionados por operadores y tienden a ajustarse a los patrones de tráfico asociados con usuarios móviles ordinarios. Eso puede hacerlos útiles para operaciones sensibles de cuentas de Facebook y TikTok, especialmente cuando la geografía del perfil y el modelo del dispositivo tienen sentido juntos. La rotación aún necesita control. El cambio frecuente entre ubicaciones distantes crea su propia anomalía.
Los proxies residenciales provienen de asignaciones de ISP de consumidores. Los rangos limpios con sesiones estables generalmente funcionan mejor que la infraestructura en la nube de baja calidad para gestión de cuentas, verificación de anuncios y verificaciones de campañas geosegmentadas. Son adecuados para flujos de trabajo que necesitan una presencia regional realista sin las restricciones de un grupo de operadores.
Los proxies de datacenter provienen de infraestructura alojada en la nube. Ofrecen velocidad y disponibilidad predecible, pero los rangos económicos a menudo llevan una reputación que las plataformas ya asocian con la automatización. Son adecuados para recopilación de menor riesgo, verificaciones de páginas públicas y cargas de trabajo donde un desafío no amenaza una cuenta.
Los proxies IPv6 amplían el espacio de direcciones disponible, pero el protocolo por sí solo no otorga confianza. Una asignación nueva puede funcionar bien cuando el proveedor upstream mantiene un historial limpio. También puede funcionar mal cuando la red emisora tiene un historial de abuso o la plataforma objetivo maneja ese rango agresivamente.
| Tipo de Proxy | Nivel de Reputación IP | Frecuencia de Activación CAPTCHA | Mejor Caso de Uso |
|---|---|---|---|
| Móvil | A menudo fuerte cuando está alineado con operadora | A menudo menor para flujos sensibles a la identidad | Acceso a cuentas de Facebook y TikTok, perfiles tipo móvil |
| Residencial | Variable, más fuerte con rangos ISP limpios | Usualmente moderado a bajo con sesiones estables | Campañas geo-dirigidas, verificación de anuncios, operaciones de cuentas |
| Datacenter | Variable, a menudo más débil en rangos económicos | A menudo mayor en plataformas protegidas | Datos públicos, verificaciones rápidas, infraestructura de bajo riesgo |
| IPv6 | Totalmente dependiente del historial upstream | Puede ser bajo o alto dependiendo de la reputación del rango | Expansión de direcciones y cargas de trabajo regionales especializadas |
Mantén cada cuenta en una sesión persistente de menos de diez minutos cuando el flujo de trabajo necesite continuidad, luego rota antes de que la salida acumule comportamiento sospechoso. Limita el número de identidades que usan un mismo ASN. Haz coincidir el país y ciudad del proxy con la zona horaria, configuración regional e idioma del perfil antidetect. Rota los nodos de salida antes de que la confianza decaiga, no inmediatamente después de cada solicitud.
Las defensas de las plataformas también cambian cómo tratan los rangos de direcciones, por lo que los equipos deben comprender el bloqueo automático de IP para 2026 antes de construir un pool alrededor de un proveedor o ASN. Un desglose más detallado de los tipos de proxy y sus diferencias operativas ayuda al asignar capacidad móvil, residencial, datacenter e IPv6 a diferentes flujos de trabajo.
Configuración de Navegadores Antidetect para Huellas Digitales Estables
Los navegadores antidetect no crean confianza por sí mismos. Te dan control sobre la superficie de identidad. El error es cambiar cada parámetro disponible hasta que un perfil parezca inusual. Una salida estable e internamente consistente supera a la aleatorización agresiva.
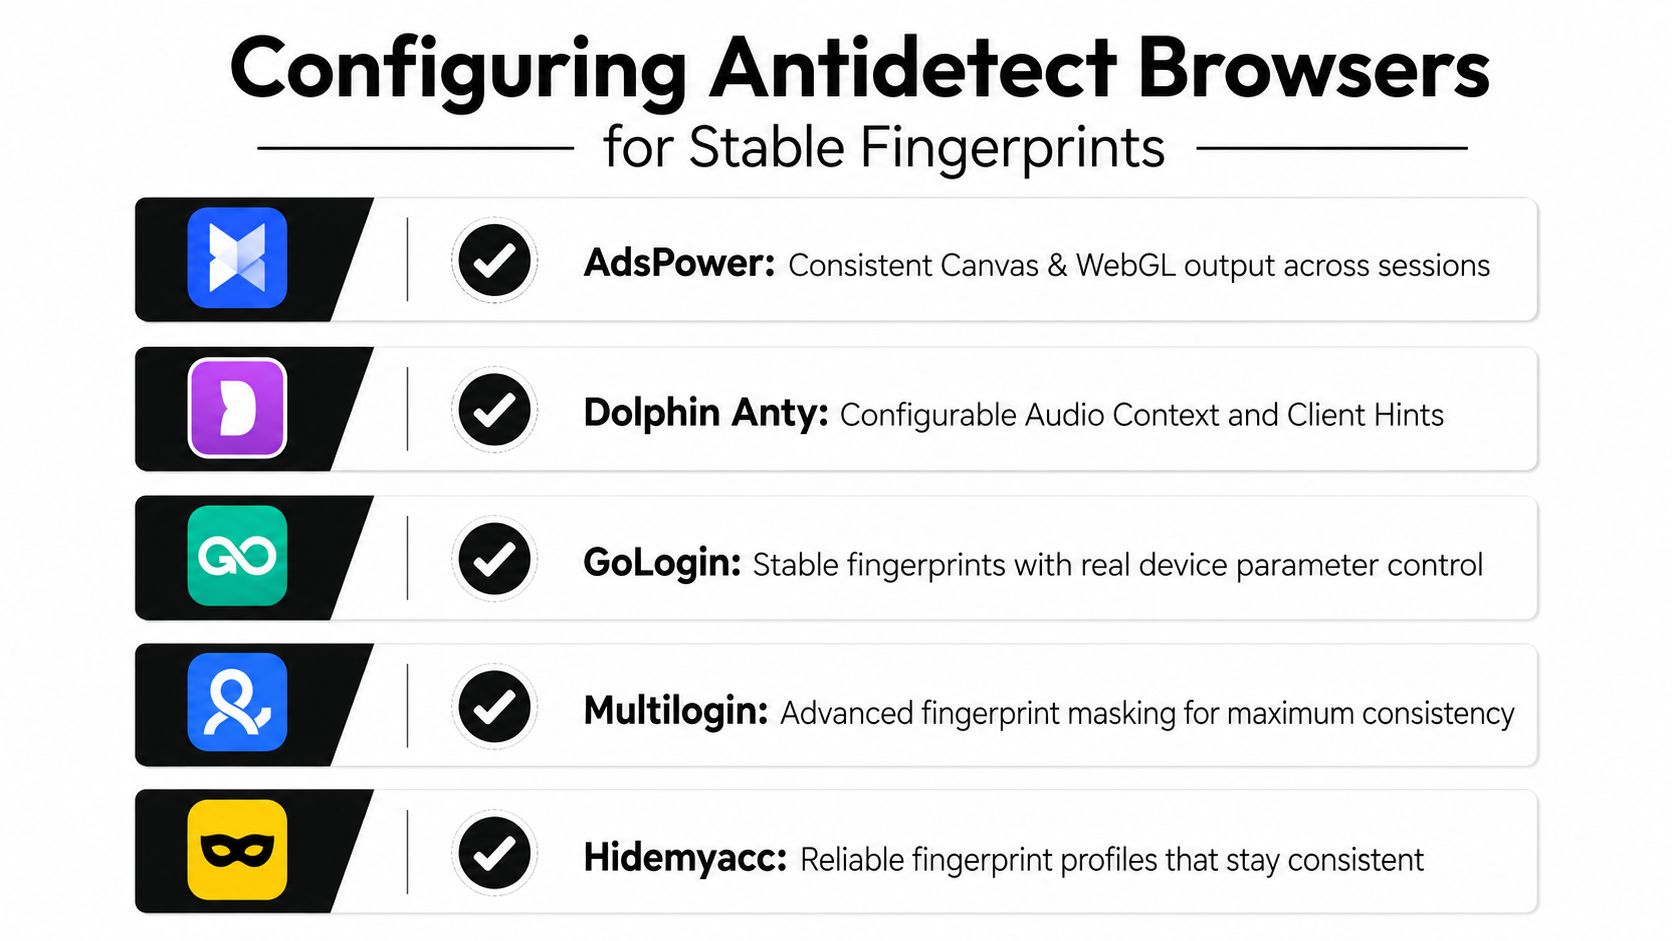
AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc exponen diferentes controles, pero la lógica de configuración sigue siendo similar.
Construye una identidad de dispositivo coherente
Comienza con el sistema operativo y la versión del navegador. Un perfil que declara un SO mientras expone una versión de Chrome incompatible crea una contradicción evitable. Mantén la versión del navegador actualizada y alinea el user agent, client hints, valor de plataforma y comportamiento de renderizado.
El ruido de Canvas y WebGL debe permanecer estable para ese perfil. Lo mismo aplica para la salida de AudioContext y client rect. Aleatorizar estos valores en cada inicio crea deriva de huella digital, lo que puede parecer menos protección de privacidad y más cambio de identidad.
La zona horaria, configuración regional e idioma deben coincidir con la geografía del proxy. Una configuración regional francesa, una zona horaria de Europa del Este y una salida residencial norteamericana forman una combinación sospechosa a menos que el flujo de trabajo tenga una razón legítima para ello. El perfil también debe exponer un tamaño de pantalla plausible, memoria del dispositivo y número de núcleos de CPU para la clase de dispositivo declarada.
Elimina las filtraciones comunes
Fija las fuentes a la plataforma seleccionada. Deshabilita las rutas WebRTC que pueden revelar la dirección de salida. Verifica que el perfil no exponga un dispositivo de audio, renderizador o capacidad de medios diferente cada vez que se inicia.
Antes de usar un perfil para una cuenta de anuncios de Facebook, cuenta empresarial de TikTok, flujo de trabajo de cultivo de cuentas o ejecución de QA de cloaking, valídalo fuera de la plataforma objetivo:
- Revisa la salida de huella digital del navegador con un verificador de detección reputado.
- Ejecuta una revisión cover-your-tracks para WebRTC, canvas, WebGL, fuentes y client hints.
- Confirma que la zona horaria, idioma y geografía del proxy coincidan.
- Realiza un inicio de sesión de prueba sin ediciones de campaña ni navegación rápida.
- Registra el estado del perfil, luego evita cambiarlo sin una razón documentada.
El glosario de huellas digitales de navegador es útil cuando tu equipo necesita terminología consistente entre constructores de perfiles y registros de QA. No confundas más suplantación con mejor suplantación. Cada inconsistencia adicional expande la superficie que un motor de riesgo puede comparar.
Ritmo de Solicitudes e Higiene de Sesión que Reduce Desafíos
El moldeado de tráfico usualmente produce resultados más confiables que la escalada de solucionadores. Un flujo de trabajo que envía solicitudes en paralelo, repite la misma secuencia y rota su salida después de cada acción crea un patrón reconocible incluso cuando la huella digital del navegador parece plausible.
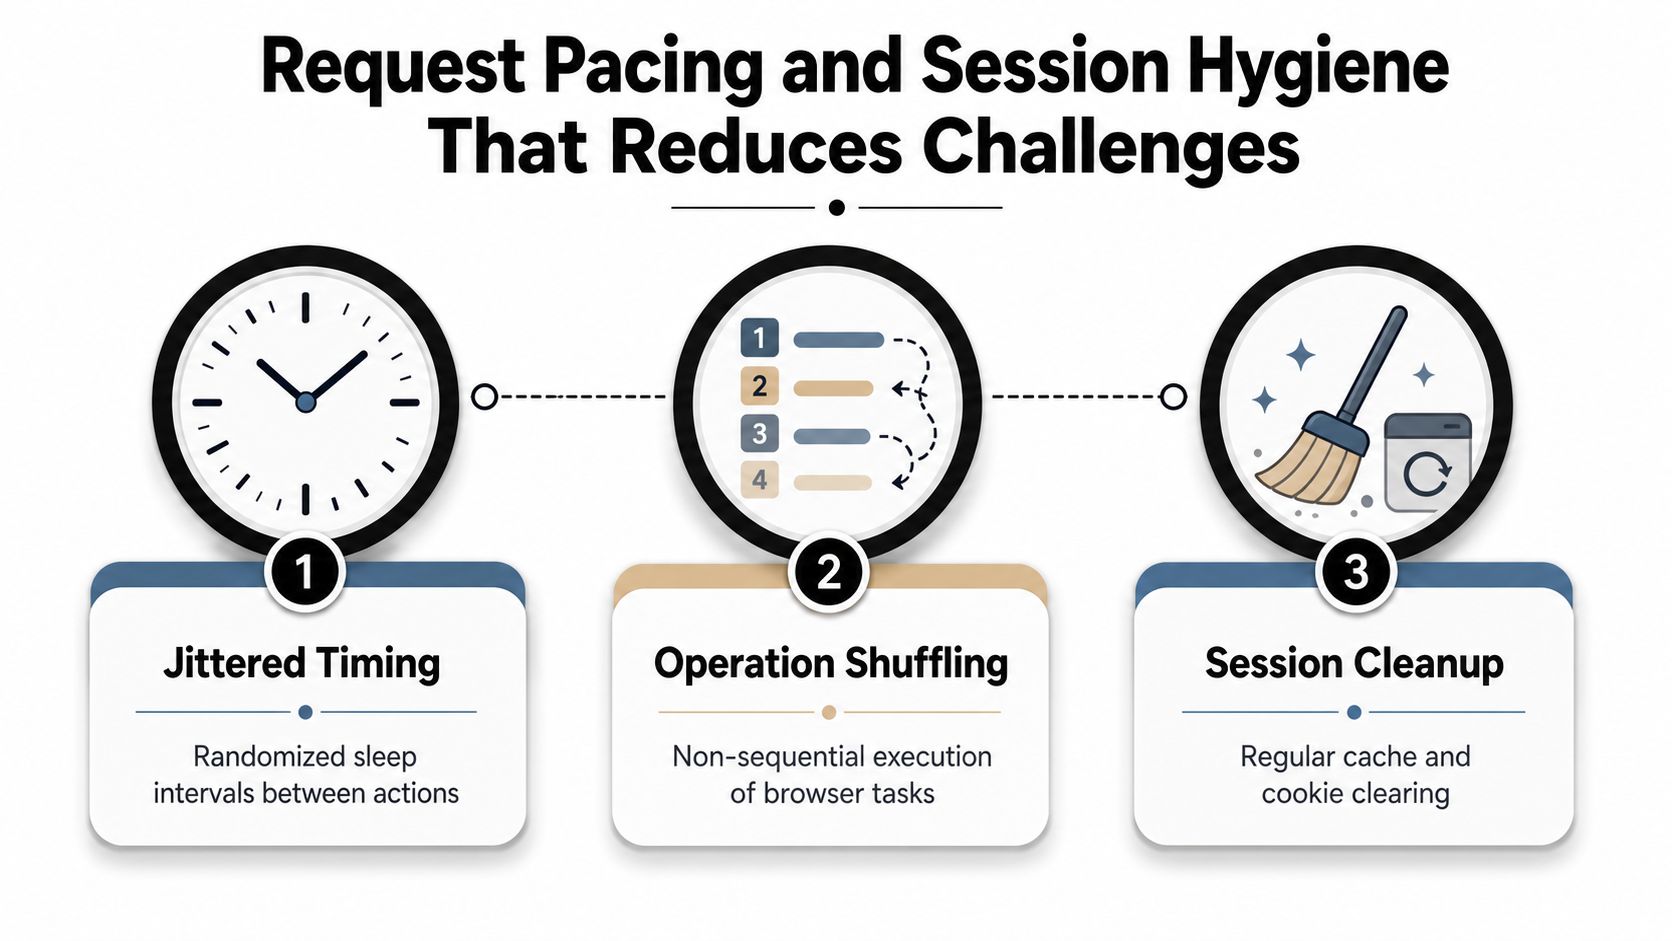
Usa jitter, no un tiempo de espera fijo. Varía el retraso entre cargas de página, clics, campos de formulario y ediciones de campaña dentro de un rango de flujo de trabajo sensato. El tiempo aleatorio por sí solo no hará legítimo un proceso abusivo, pero los intervalos fijos facilitan la clasificación.
Mezcla las operaciones donde la aplicación lo permita. Un usuario podría abrir notificaciones, inspeccionar una campaña, visitar facturación y regresar a la cuenta. Un script que inicia sesión, edita el mismo campo, actualiza y repite en cada identidad crea una firma de máquina limpia.
Mantén las sesiones deliberadas
Usa sesiones persistentes para proxies residenciales y móviles cuando una secuencia dependa de la continuidad. La rotación agresiva puede ser peor que una salida estable porque cada nueva dirección obliga a la plataforma a reevaluar la identidad. Rota cuando la sesión se vuelva poco saludable, no porque un temporizador diga que cada solicitud necesita una nueva IP.
Establece límites a nivel de cuenta para operaciones sensibles. Las nuevas identidades necesitan un período de calentamiento con actividad ordinaria de bajo volumen antes de manejar cambios complejos de campaña o acciones de alto valor. Evita ejecutar todas las cuentas al mismo momento. Escalonea el trabajo en la granja para que la red no produzca una ráfaga sincronizada.
TLS y encabezados también importan. Tu cliente debe parecerse al perfil del navegador en lugar de un valor predeterminado de cURL. Mantén la huella digital TLS, orden de encabezados, user agent, Accept-Language y encabezados de navegación coherentes. No reutilices un user agent en perfiles de dispositivos y dominios no relacionados.
Evita estos patrones:
- Ráfagas paralelas: Muchas identidades realizando la misma acción simultáneamente.
- Intervalos idénticos: Solicitudes que llegan con un ritmo fijo.
- Idioma contradictorio: Idioma del navegador que no coincide con la región declarada.
- User agents compartidos: Una firma de dispositivo copiada en perfiles no relacionados.
- Limpieza descontrolada: Borrar cookies después de cada acción y destruir el historial de sesión útil.
Para equipos de implementación, las prácticas de persistencia de sesión proporcionan un marco práctico para decidir qué cookies y sesiones deben sobrevivir entre tareas.
Elegir entre APIs de resolución de CAPTCHA y resolvedores humanos
Un resolvedor pertenece al final de la pila de control, no al principio. Si cada inicio de sesión requiere un token, el flujo de trabajo tiene un problema de red, huella digital o comportamiento. Los resolvedores pueden manejar desafíos inevitables en flujos de trabajo autorizados, pero no reparan una identidad que las plataformas ya desconfían.
Las opciones comunes de API incluyen 2Captcha, Anti-Captcha y CapSolver. Los servicios orientados a humanos como Kolotibablo usan un modelo operativo diferente. Los proveedores de API ofrecen integración y automatización basada en colas. Los servicios humanos pueden ser útiles para tareas de imagen donde el juicio visual importa, pero introducen variabilidad en disponibilidad y manejo.
No inventes expectativas de rendimiento a partir de las páginas de destino de los proveedores. Mide tu propio costo por resolución exitosa, latencia de cola, tasa de fallas y comportamiento de reintentos por tipo de desafío. Un servicio puede parecer económico mientras desperdicia tiempo en fallas repetidas o crea exposición operativa a través de reintentos no controlados.
| Proveedor | Costo por 1000 | Latencia promedio | Riesgo de detección | Mejor caso de uso |
|---|---|---|---|---|
| 2Captcha | Validar precios actuales de cuenta | Medir por tipo de desafío | Depende de la integración y el objetivo | Cobertura amplia de API en flujos de trabajo establecidos |
| Anti-Captcha | Validar precios actuales de cuenta | Medir latencia de cola y tarea | Depende de la integración y el objetivo | Manejo de desafíos de propósito general |
| CapSolver | Validar precios actuales de cuenta | Medir latencia de token y tareas de navegador | Depende de la integración y el objetivo | Flujos de trabajo basados en API que requieren tipos de tareas flexibles |
| Kolotibablo | Validar precios actuales de cuenta | Dependiente de cola humana | Perfil operativo diferente a las APIs | Desafíos de imagen que requieren revisión humana |
Enrutar según desafío y valor de cuenta
Un enrutador híbrido puede enviar tareas de imagen de bajo riesgo a una cola humana y reservar capacidad de API para desafíos basados en tokens. reCAPTCHA v3 no presenta un rompecabezas de imagen convencional, por lo que enviar tokens repetidamente sin corregir la puntuación subyacente puede producir un bucle de fallas. Cloudflare Turnstile necesita una ruta de resolvedor diseñada para esa implementación, no un endpoint genérico de imagen.
Las integraciones de API también crean trabajo de mantenimiento. Los tokens, tareas de navegador, vinculación de proxies, cambios de proveedor, controles de facturación y manejo de tareas fallidas necesitan monitoreo. Las colas humanas eliminan algunas preocupaciones de huella digital de API pero agregan preguntas de latencia, privacidad y consistencia. No envíes desafíos de banca, salud u otros dominios sensibles a una cola externa a menos que tengas autorización explícita y una base clara de manejo de datos.
Una útil opción de automatización de CAPTCHA con IA puede evaluarse junto a esos proveedores, pero las decisiones de producción deben provenir de resultados medidos y tolerancia al riesgo de la cuenta. Un flujo de trabajo público de bajo valor puede tolerar más latencia que una identidad publicitaria de alto valor. El resolvedor más seguro es el que rara vez necesitas.
Monitoreo y patrones de respaldo cuando los CAPTCHA aumentan
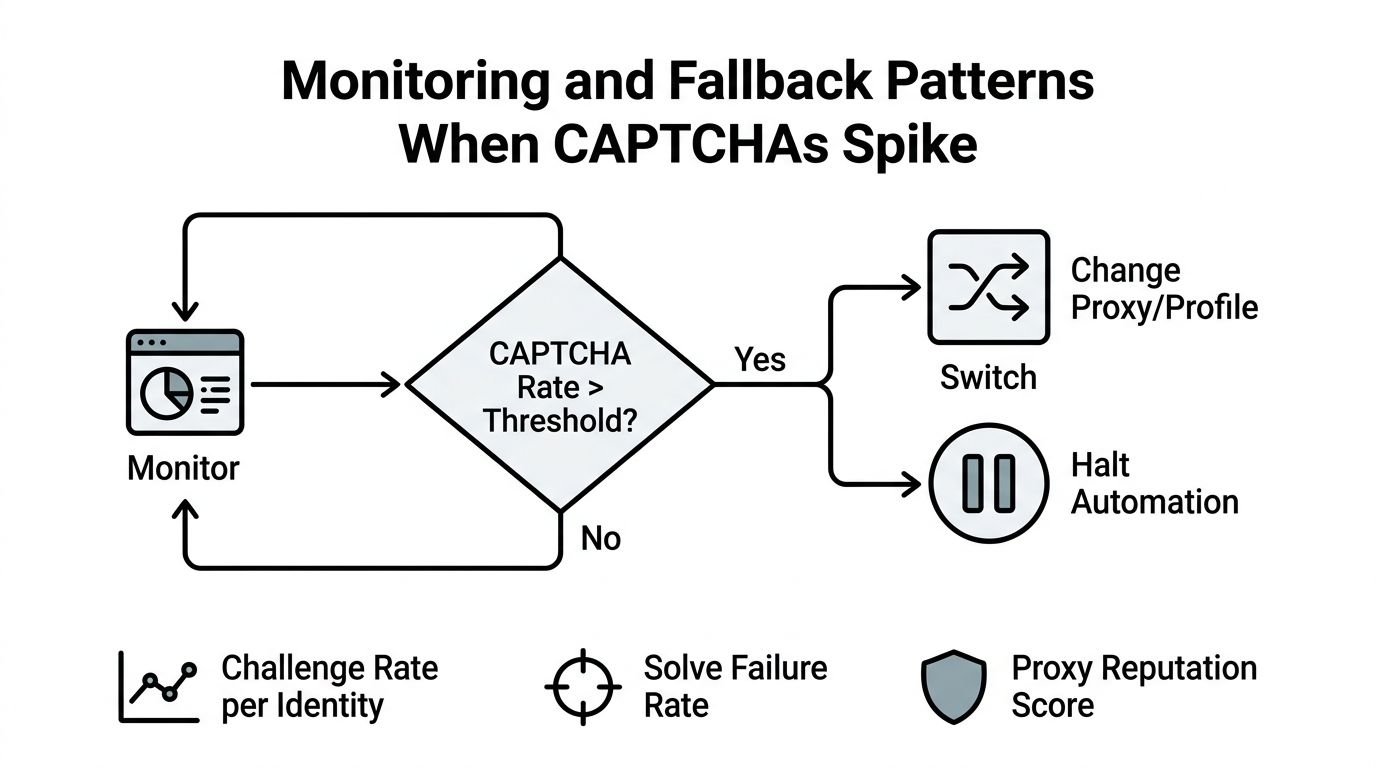
Un aumento de CAPTCHA a menudo llega antes de una restricción de cuenta. Regístralo como una métrica de salud operativa, no como una molestia que el equipo despeja manualmente.
Registra la tasa de desafíos por identidad por hora, tasa de fallas de resolución, tipo de desafío, salida de proxy, ASN, perfil de navegador, acción objetivo y marca de tiempo. Redacta credenciales, tokens, datos personales y cookies de sesión completas. Necesitas suficiente contexto para correlacionar fallas sin convertir los registros en un segundo riesgo de seguridad.
Usar degradación controlada
Establece una línea base interna para cada flujo de trabajo, luego alerta cuando la tasa se mueva materialmente por encima de su nivel normal. Un solo desafío puede ser normal. Desafíos repetidos en varias identidades usando un grupo de proxies apuntan hacia reputación de red. Desafíos limitados a un perfil de navegador apuntan hacia deriva de huella digital o estado de sesión corrupto.
Usa estas acciones de respaldo:
- Enfriar la identidad: Detén acciones cuando la frecuencia de desafíos aumente en lugar de reintentar inmediatamente.
- Cambiar una variable: Prueba una nueva salida o un perfil conocido como bueno, pero no rotes todo a la vez.
- Ralentizar el flujo de trabajo: Reduce la concurrencia y amplía la variación de tiempos.
- Poner en cuarentena el proxy: Compara sus resultados con otras salidas de la misma geografía.
- Escalar manualmente: Revisa el estado de la cuenta de Facebook o TikTok antes de reanudar operaciones de campaña.
Las fallas consecutivas de resolución deberían activar una pausa, no un presupuesto mayor de resolvedor. Si varios perfiles fallan en el mismo objetivo mientras usan diferentes redes, investiga la construcción del navegador, cambio de flujo de trabajo o actualización de política del lado de la plataforma. Si solo fallan las salidas de un proveedor, el proveedor puede ser la causa raíz.
Mantén los registros lo suficientemente inmutables para comparar cambios a lo largo del tiempo. Un panel útil separa salud de identidad, salud de proxy y salud de resolvedor. Esa separación evita que los equipos culpen al CAPTCHA cuando el defecto real está en una plantilla de huella digital compartida o un ASN degradado.
Consideraciones legales, éticas y de riesgo de plataforma
La pregunta más inteligente no es cómo superar cada desafío. Es si el flujo de trabajo debería generar ese desafío en absoluto. Los sistemas CAPTCHA protegen formularios de inicio de sesión, flujos de pago, creación de cuentas y otras superficies donde el abuso automatizado puede perjudicar a los usuarios. Derrotarlos repetidamente puede violar los términos de una plataforma, desencadenar aplicación de cuenta o crear exposición legal.
Meta puede solicitar verificación adicional de identidad o negocio cuando detecta comportamiento potencialmente sospechoso o inauténtico, y el fracaso en completar ese proceso puede restringir o suspender una cuenta publicitaria (guía de verificación de Meta para anunciantes). El flujo de verificación empresarial de TikTok requiere que los anunciantes envíen las cuentas que desean verificar, haciendo de la verificación parte de los controles a nivel de cuenta en lugar de un evento solo de registro (documentación de verificación empresarial de TikTok).
Esto importa para el cultivo de cuentas, ocultamiento, compra de medios de alta rotación y campañas geolocalizadas. Un resolvedor puede limpiar una pantalla mientras deja el comportamiento más amplio de la cuenta sin cambios. No uses colas de resolución de terceros para portales bancarios o de salud, y no automatices acciones que imiten señales de fraude sin autorización.
| Nivel | Caso de Uso | Nivel de Riesgo | Mitigación |
|---|---|---|---|
| Verde | Datos públicos con límites de tasa claros | Menor | Seguir robots, términos, límites de tasa y reglas de minimización de datos |
| Amarillo | Scraping autenticado con consentimiento | Moderado | Obtener permiso, proteger credenciales, limitar la recopilación y documentar el propósito |
| Rojo | Actividad que imita fraude o elude controles de cuenta | Alto | Detenerse, obtener autorización explícita o rediseñar el flujo de trabajo |
Los datos públicos no significan automáticamente automatización sin restricciones. Los datos personales pueden crear obligaciones adicionales, y el acceso autenticado eleva las apuestas. En Estados Unidos, la Computer Fraud and Abuse Act puede volverse relevante cuando el acceso excede la autorización. El Artículo 32 del GDPR puede importar cuando el procesamiento de datos personales requiere seguridad apropiada. Las preocupaciones sobre la UK Computer Misuse Act pueden surgir cuando la automatización se convierte en acceso no autorizado o elusión de seguridad.
Verificación de calibración: Si el flujo de trabajo necesita reintentos constantes de solucionadores, identidades desechables y geografías contradictorias para funcionar, reduce el alcance antes de escalarlo.
Usa menos cuentas, calentamiento más largo, sesiones residenciales o móviles estables que coincidan con la geografía real del usuario, y permiso explícito de la plataforma cuando sea necesario. Para portales gubernamentales o de salud, el farming de CAPTCHA puede tener consecuencias más allá de una violación de términos de servicio. La implementación más segura reduce las solicitudes, preserva el consentimiento y se detiene cuando la plataforma señala que la actividad no es bienvenida.
Sota Proxy proporciona opciones de proxy residenciales, móviles, de centro de datos, ISP e IPv6 con controles de rotación y sesión persistente para flujos de trabajo autorizados que necesitan acceso regional consistente. Visita Sota Proxy para comparar tipos de proxy, ubicaciones y configuraciones de sesión antes de reconstruir tu stack de automatización de Facebook o TikTok.
Artículos relacionados
10 Alternativas a IPRoyal para Cargas de Trabajo Proxy Serias
Compara 10 alternativas a IPRoyal para scraping, verificación de anuncios, gestión de cuentas, navegadores antidetección, campañas geo, precios, rotación y soporte.
10 Alternativas a Oxylabs para Scraping y Operaciones Publicitarias
Compara 10 alternativas a Oxylabs por tipo de proxy, cobertura geográfica, tiempo de actividad, rotación, precios y caso de uso para scraping, verificación de anuncios y gestión de cuentas.
Mejores Alternativas a Brightdata para Equipos de Proxies en 2026
Descubre las mejores alternativas a Brightdata para scraping, verificación de anuncios y campañas geosegmentadas en 2026, además de consejos de migración.
Segmentación por Código Postal para Campañas Publicitarias: Guía Práctica
Segmentación por código postal explicada para compradores de medios y equipos de arbitraje de tráfico. Cubre configuración de proxies, reglas de plataformas publicitarias, riesgos de detección y mejores prácticas.
Qué es un Forward Proxy: Guía completa para 2026
Aprende qué es un forward proxy, cómo funciona para el tráfico saliente y por qué los equipos lo usan con navegadores antidetección para Facebook, TikTok y web scraping.
Para Qué Se Usa un Proxy: Guía de Arbitraje 2026
Para qué se usa un proxy - Descubre para qué se utiliza un proxy en 2026, desde mejorar la seguridad hasta gestionar operaciones multiaccount para equipos de arbitraje