Web scraping con Node.js: antidetección avanzada en 2026
Web scraping con Node.js en 2026: cómo montar herramientas de nivel producción con rotación de proxies, huellas coherentes y antidetección para extraer datos en entornos exigentes.
Casi todos los consejos sobre web scraping con Node están pensados para demos, no para operaciones reales. Que un script descargue unas cuantas páginas desde tu portátil no dice nada sobre si aguantará las revisiones de cuentas publicitarias de Facebook, el scraping de flujos de TikTok, los pipelines de farmeo de cuentas, las auditorías de cloaking o la validación de campañas geolocalizadas sin quemar IPs y perfiles.
Esa brecha importa más que nunca, porque el scraping ya no es una tarea secundaria. Se prevé que el mercado global de web scraping supere los 9.000 millones de USD a finales de 2025, con un crecimiento estimado de entre el 12% y el 15% CAGR hasta 2030, y en 2024 el scraping ahorró a las empresas en torno al 30% del tiempo que dedicaban a la recopilación manual, según las proyecciones de mercado y eficiencia del web scraping para 2025. El problema operativo no es cómo seleccionar un nodo del DOM. Es cómo mantener estable la extracción cuando los sistemas antibot puntúan cada solicitud.
Los equipos de arbitraje de tráfico ya dominan lo básico. Lo difícil es ejecutar scrapers en Node.js junto a navegadores antidetección como AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc, manteniendo alineados huellas, sesiones, GEOs y comportamiento de los proxies. Ahí es donde la mayoría de los tutoriales dejan de servir.
Índice
- Web scraping con Node más allá de lo básico
- Cómo diseñar tu kit de scraping en Node.js
- Cómo evitar bloqueos con antidetección avanzada
- Integrar proxies para operar a escala
- Cómo construir un scraper resiliente y escalable
- CAPTCHAs y límites éticos
Web scraping con Node más allá de lo básico
El web scraping con Node se suele simplificar en exceso. La mayoría de las guías enseñan a hacer la petición, parsear y exportar. Para la página de un catálogo vale. Pero se desmorona cuando el sitio se defiende, cuando tu scraper comparte infraestructura con las operaciones de cuentas publicitarias de Facebook y TikTok, o cuando un perfil antidetección tiene que seguir pareciendo creíble sesión tras sesión.
Para quienes gestionan muchas cuentas, el scraping no va por separado. Convive con el calentamiento de cuentas, las revisiones de campañas, el QA de landings, la verificación de cloaking y la validación por GEO. Un fallo de descarga puede hacer perder tiempo al media buyer. Una huella incoherente puede contaminar un perfil que luego se usa en AdsPower o GoLogin. Un proxy mal asignado puede provocar revisiones en una cuenta farmeada que ayer estaba estable.
La mentalidad de producción es otra. No te preguntas «¿puede este script scrapear la página?». Te preguntas:
- ¿Mantiene un comportamiento de sesión coherente en los flujos de farmeo de cuentas y gestión de cuentas publicitarias?
- ¿Separa las tareas baratas de recopilación de las tareas sensibles ligadas a cuentas para que unas no contaminen a las otras?
- ¿Falla de forma segura, sin martillear al objetivo ni corromper tus propios datos?
- ¿Sigue resultando creíble cuando GEO, zona horaria, idioma y huella del navegador tienen que cuadrar?
Regla práctica: si un scraper toca infraestructura que también toca cuentas publicitarias, trátalo como infraestructura de cuentas, no como un script desechable.
Eso implica más aislamiento, mejores logs y una estrategia de proxies más limpia. También implica abandonar supuestos de principiante, sobre todo la idea de que «basta con añadir Puppeteer» para los sitios protegidos. No basta. A menudo facilita la detección si el navegador, el comportamiento TLS, la zona horaria y la reputación de la IP no coinciden.
Muchos equipos lo descubren solo al escalar. Entonces empiezan a reconstruirlo todo alrededor de pools de proxies, concurrencia controlada y flujos de peticiones que tienen en cuenta el perfil. Si haces recopilación de datos en serio, conviene revisar desde el primer día los patrones de infraestructura de web scraping para operaciones a gran escala con esa mirada de producción.
Cómo diseñar tu kit de scraping en Node.js
La elección de herramientas determina el coste, la velocidad y la superficie de detección. Si eliges mal el stack, o gastarás de más en navegadores o te quedarás corto y te bloquearán en los sitios dinámicos.
Elige la herramienta más ligera que resuelva la tarea
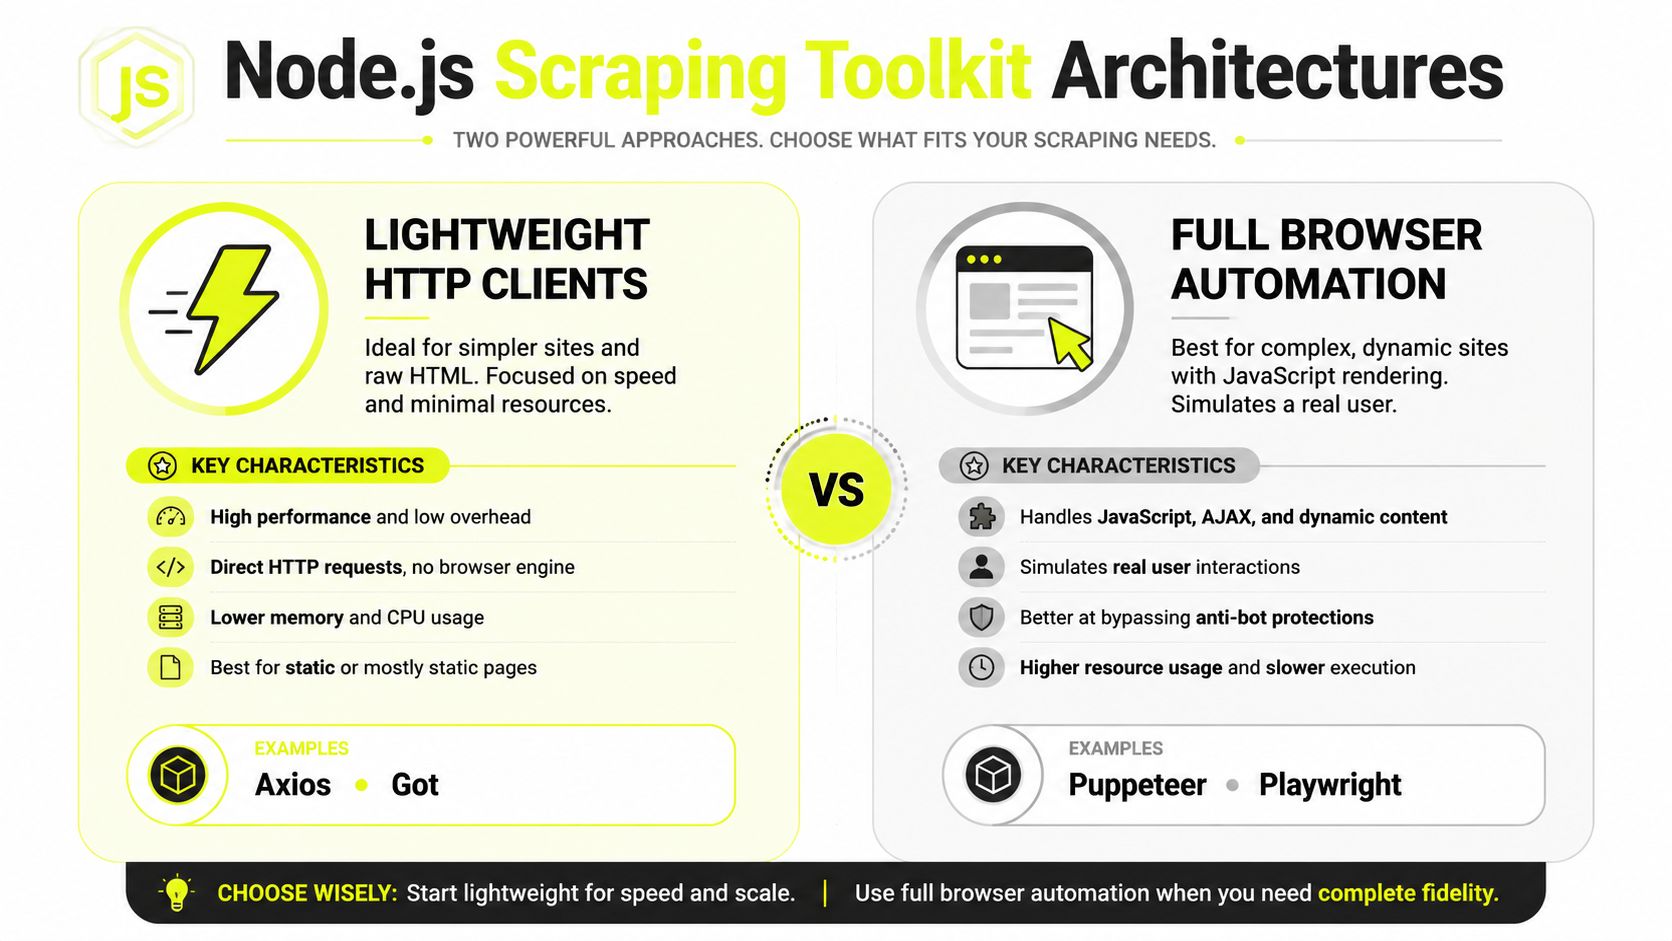
Para páginas estáticas, APIs internas y sitios sencillos renderizados en servidor, un cliente HTTP más un parser sigue siendo el mejor primer paso. En Node eso suele significar Axios o Got para las peticiones y Cheerio para la extracción.
Este stack funciona bien cuando necesitas velocidad pura y poco consumo de RAM. Es ideal para tareas como:
- Revisiones de landings en muchos GEOs
- Recopilación de bibliotecas de anuncios cuando los datos están en HTML predecible o en APIs accesibles
- Monitorización de precios u ofertas para comparativas de arbitraje
- Verificación de cloaking en cadenas de redirección sencillas
La ventaja es operativa. Puedes ejecutar más workers por máquina, mantener bajo el coste de cada petición y depurar en la capa HTTP sin el ruido del navegador. Para los equipos de tráfico, esto cuenta cuando necesitas muchas comprobaciones baratas en lugar de un renderizado perfecto.
Pero este camino tiene límites. No ejecuta JavaScript del lado del cliente. No se comporta como un navegador completo. No arrastra un estado de navegador realista a menos que construyas tú mismo gran parte de ese comportamiento.
Cuándo la automatización del navegador deja de ser opcional
Playwright y Puppeteer se vuelven necesarios cuando el objetivo es una aplicación cargada de JavaScript o cuando el estado de la página solo aparece tras renderizar e interactuar. Redes sociales, paneles publicitarios, SPAs de e-commerce y flujos con mucha protección antibot suelen caer aquí.
Muchos equipos sobrestiman Puppeteer. Lanzar Chromium no es lo mismo que pasar desapercibido. Según un análisis de herramientas y arquitecturas para scrapear sitios protegidos, los navegadores headless como Puppeteer a menudo no bastan frente a objetivos modernos que usan canvas fingerprinting y detección de bots basada en IA, responsables del 73% de los fallos de scraping empresarial en 2025, mientras que la automatización con navegadores serverless puede alcanzar tasas de éxito del 94% en sitios protegidos.
Eso no convierte a Playwright o Puppeteer en inútiles. Significa que hay que tratarlos como motores de ejecución, no como soluciones de sigilo.
Un reparto práctico sería este:
- Axios o Got con Cheerio para recopilación donde prima la velocidad
- Playwright cuando necesitas más control sobre los flujos de aplicaciones modernas
- Puppeteer cuando tu stack depende de herramientas específicas de Chromium o de ecosistemas stealth ya existentes
- Automatización con navegadores serverless cuando gestionar una flota de navegadores empieza a comerse el tiempo del equipo
Dónde encajan los navegadores serverless
Las plataformas de navegadores gestionados tienen sentido cuando tu cuello de botella no es el parseo, sino la operación. Los cuelgues del navegador, los parches stealth desactualizados, los flujos de CAPTCHA rotos y los bugs por desajuste entre proxy y navegador consumen más tiempo que la propia lógica de extracción.
Para las operaciones publicitarias, el valor principal es la consistencia. Una capa de navegador gestionada puede mantener las versiones de Chrome, los entornos de ejecución, la rotación de proxies y la gestión de desafíos más estables que una flota casera montada a contrarreloj.
La automatización headless es una herramienta de renderizado. La antidetección sigue dependiendo de la coherencia de la huella, la alineación con el GEO y la calidad del proxy.
Si lo construyes internamente, mantén el stack modular. Una capa de peticiones, una de parseo, una de navegador y una de sesiones. No lo cablees todo en un único script. Así es más fácil sustituir clientes HTTP por navegadores solo donde haga falta, y conectar tu scraper con integraciones de Node.js con soporte de proxies pensadas para cargas de automatización cuando el enrutamiento de peticiones se complique.
Cómo evitar bloqueos con antidetección avanzada
Los tutoriales básicos siguen vendiendo la rotación de user agents como si fuera suficiente. No lo es. Los objetivos serios puntúan la huella completa, no una sola cabecera.
El user agent es la parte fácil
Cambiar el User-Agent solo ayuda cuando todo lo demás encaja. Si el navegador dice una cosa, el handshake TLS dice otra y el proxy sale por un país que no coincide con la zona horaria y el idioma del navegador, la petición parece falsa antes incluso de que termine de cargar la página.
Esto es clave para quienes usan AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc. Esas herramientas existen para mantener coherente un perfil. Si tu scraper en Node alimenta o replica actividad alrededor de esos perfiles, tiene que respetar las mismas reglas de coherencia.
Los fallos habituales son previsibles:
- Cabeceras desalineadas, por ejemplo un
accept-languageque no corresponde al GEO - Zona horaria distinta entre el perfil del navegador y la salida del proxy
- Viewport y plataforma incoherentes con el dispositivo que se declara
- TLS incoherente, cuando el stack de peticiones delata un handshake que no es de navegador
- Contaminación de sesiones cuando un mismo pool de proxies atiende tareas con distintos requisitos de confianza
Alinea el perfil, no solo la IP
Un matiz crítico que la mayoría de guías pasa por alto es el desajuste entre TLS y huella del navegador. Según datos del sector sobre fallos de scrapers por incoherencias de huella, el 68% de los scrapers que fallan son bloqueados por incoherencias en el handshake TLS o por diferencias de zona horaria entre proxy y navegador, e ignorarlo lleva a tasas de bloqueo entre un 30% y un 40% más altas.
Si haces scraping alrededor de la gestión de cuentas publicitarias, esto no es teoría. Facebook y TikTok no evalúan una sola señal. Correlacionan muchas. Una cuenta abierta con un proxy residencial en una región y luego scrapeada con un cliente de Node que presenta un locale y unos rasgos TLS que no cuadran genera un riesgo evitable.
Al sistema antibot le da igual que tu selector CSS sea correcto. Le importa si tu stack de peticiones parece un navegador real usado por una persona real en un lugar real.
Eso cambia las decisiones de implementación. A veces una petición HTTP pura es más segura porque no expone artefactos headless rotos. A veces un navegador completo es más seguro porque el objetivo espera comportamiento de navegador y puntúa el TLS. Elegir mal no solo es menos eficiente: hace que te bloqueen antes.
Cómo mantienen los operadores la coherencia de las huellas
Para tareas sensibles, mantén el stack alineado en estas capas:
Identidad de red
El GEO del proxy, el tipo de ASN y la duración de la sesión deben ajustarse a la acción. El farmeo de cuentas y el acceso repetido a cuentas publicitarias necesitan sesiones estables. Las tareas de recopilación amplia necesitan más rotación.Identidad del navegador
Haz coincidir zona horaria, idioma, métricas de pantalla, pistas de plataforma y build del navegador con el perfil. Si el perfil del navegador antidetección dice Berlín, que tu scraper no anuncie la hora de Miami.Identidad de la petición
Mantén las cabeceras coherentes entre sí. Los valores deaccept-languageysec-ch-ua, el comportamiento de codificación y los patrones de navegación deben corresponder a la familia de navegador que imitas.Identidad de interacción
Nada de intervalos perfectos, recorridos de clics idénticos ni secuencias de páginas imposibles. Sobre todo en flujos sensibles a revisiones.
Con frecuencia, muchos equipos pasan a usar clientes conscientes de la huella o capas de navegador gestionadas en lugar de seguir añadiendo plugins stealth a Puppeteer.
Una breve demo ayuda a ver la diferencia entre la automatización genérica del navegador y un tráfico que se parece a una sesión de navegador estable:
Si los baneos de IP ya están afectando a tus tareas, las tácticas prácticas para evitar baneos de IP en stacks de automatización suelen importar más que reescribir otra vez el parser. Los bloqueos a menudo son fallos de infraestructura disfrazados de problemas de la aplicación.
Integrar proxies para operar a escala
Los proxies no son un complemento intercambiable. Definen la confianza, el comportamiento de las sesiones y la economía unitaria. Si scrapeas datos para gestión de cuentas publicitarias, farmeo de cuentas, revisiones de cloaking o campañas geolocalizadas, el tipo de proxy cambia lo que puedes hacer con seguridad.
A medida que los controles antiscraping se generalizan, los proxies se han vuelto imprescindibles para el scraping a gran escala, y el análisis del mercado de web scraping de Mordor Intelligence indica que Norteamérica lideró con el 34,08% de la cuota de mercado en 2025, mientras que se espera que Asia-Pacífico registre el crecimiento más rápido. Esa expansión coincide con lo que ya ven los operadores: todo stack serio trata hoy el enrutamiento y la estrategia de IPs como infraestructura central.
El tipo de proxy cambia el resultado
Los proxies de centro de datos, residenciales, móviles e IPv6 no resuelven el mismo problema.
Los proxies de centro de datos son rápidos y baratos. Sirven para tareas de gran volumen en objetivos poco sensibles: páginas públicas, crawling ligero, agregación de ofertas o comprobaciones iniciales donde la confianza de cada petición importa poco. También son los primeros en ser marcados en las plataformas más estrictas.
Los proxies residenciales salen por rangos de IP de usuarios domésticos. Cuestan más, pero se camuflan mejor en plataformas que valoran la reputación y la coherencia del comportamiento. Suelen ser la opción por defecto para scraping cercano a logins, revisiones de cuentas publicitarias y accesos repetidos ligados a una misma sesión.
Los proxies móviles son los que los equipos reservan para los frentes más duros. En objetivos sociales sensibles, la confianza móvil es útil porque el patrón de tráfico se parece al de una operadora real y al comportamiento compartido de las redes móviles. Son más lentos y más caros, así que gastarlos en tareas fáciles es mala operación.
Los proxies IPv6 pueden ser útiles para escalar con buen coste cuando el objetivo acepta bien el tráfico IPv6. No son un bypass universal. Algunos objetivos gestionan mal IPv6, otros lo marcan antes, y muchos flujos sensibles a las cuentas siguen funcionando mejor con rutas residenciales o móviles IPv4 bien elegidas.
Comparativa de tipos de proxy para scraping con Node.js
| Tipo de proxy | Mejor caso de uso | Anonimato/confianza | Coste |
|---|---|---|---|
| Centro de datos | Recopilación masiva en objetivos poco sensibles, crawling amplio, monitorización sencilla | Confianza más baja en plataformas protegidas | Bajo |
| Residencial | Scraping ligado a cuentas de Facebook y TikTok, revisiones por GEO, sesiones repetidas, validación de cloaking | Alta confianza para tráfico de tipo doméstico | Medio a alto |
| Móvil | Objetivos sociales difíciles, farmeo de cuentas, acciones sensibles a revisiones, GEOs complicados | Confianza muy alta | Alto |
| IPv6 | Escala con control de costes donde el objetivo soporta bien IPv6, tareas de distribución amplia | Varía según el objetivo y la implementación | Bajo a medio |
Muchos fallos vienen de usar una sola clase de proxy para todo. Eso no aguanta en producción. Centro de datos para el volumen. Residencial para la continuidad de sesión. Móvil para los casos límite difíciles. IPv6 donde el objetivo lo tolera.
Los proxies baratos salen caros cuando queman perfiles calentados u obligan a recuperar cuentas publicitarias a mano.
Un patrón práctico de proxies en Node.js
En Node.js, saca la gestión de proxies fuera de la lógica de negocio. A tu parser no le debe importar qué pool sirvió la petición. Construye una fábrica de peticiones que reciba el perfil del objetivo, el nivel de riesgo y la política de sesión, y que elija el pool adecuado.
Un patrón mínimo se ve así:
import got from 'got';
import { HttpsProxyAgent } from 'https-proxy-agent';

function buildClient({ username, password, host, port }) {
  const proxyUrl = `http://${username}:${password}@${host}:${port}`;
  const agent = new HttpsProxyAgent(proxyUrl);

  return got.extend({
    agent: {
      http: agent,
      https: agent
    },
    timeout: {
      request: 30000
    },
    retry: {
      limit: 0
    },
    headers: {
      'accept-language': 'en-US,en;q=0.9'
    }
  });
}

const client = buildClient({
  username: process.env.PROXY_USER,
  password: process.env.PROXY_PASS,
  host: process.env.PROXY_HOST,
  port: process.env.PROXY_PORT
});

const html = await client.get('https://example.com').text();
console.log(html.slice(0, 200));
El ejemplo es sencillo a propósito. En producción, añade etiquetas de sesión, selección de GEO, conjuntos de cabeceras por objetivo y logs de qué pool atendió cada petición. Así rastreas los fallos sin adivinar.
Para controlar la rotación, los equipos suelen separar la política por tarea:
- Sesiones rotativas para recopilación a nivel de página, donde cada petición puede salir por una IP nueva
- Sesiones sticky para logins, formularios de varios pasos, acciones de farmeo de cuentas y sesiones de navegador que deben parecer continuas
- Sesiones fijadas a un GEO para revisar previsualizaciones de anuncios y validar landings locales
- Aislamiento de pools para que el trabajo con cuentas de TikTok no comparta comportamiento de salida con las tareas de scraping masivo
Rotación y sesiones sticky para trabajar con cuentas
Rotar no siempre es mejor. En las operaciones con cuentas de Facebook y TikTok, un cambio constante de IP puede parecer peor que una sesión estable. Una cuenta calentada suele necesitar una identidad de red creíble y persistente. En el scraping masivo pasa lo contrario: reutilizar la misma IP demasiado tiempo aumenta los baneos y el throttling.
Por esa división operativa los equipos asignan la política de proxies según el flujo de trabajo, no según el código. Un mismo proyecto de Node puede usar una ruta para la recopilación pública, otra para las acciones de navegador ligadas a cuentas y otra para las revisiones de anuncios por GEO.
Si gestionas montajes para clientes u otros compradores, la infraestructura de proxies también puede formar parte de tus ingresos. Algunos proveedores tienen programas de partners. Sota Proxy, por ejemplo, ofrece un programa de referidos y afiliados con hasta un 40% de comisión. Esto interesa a agencias y operadores que ya asesoran a sus clientes sobre la elección de proxies y el enrutamiento.
Para la mecánica de los pools rotativos y la persistencia de sesión, los patrones de rotación de IPs de proxy para automatización y scraping son más útiles que el consejo genérico de «usa un proxy». La política de enrutamiento es la estrategia.
Cómo construir un scraper resiliente y escalable
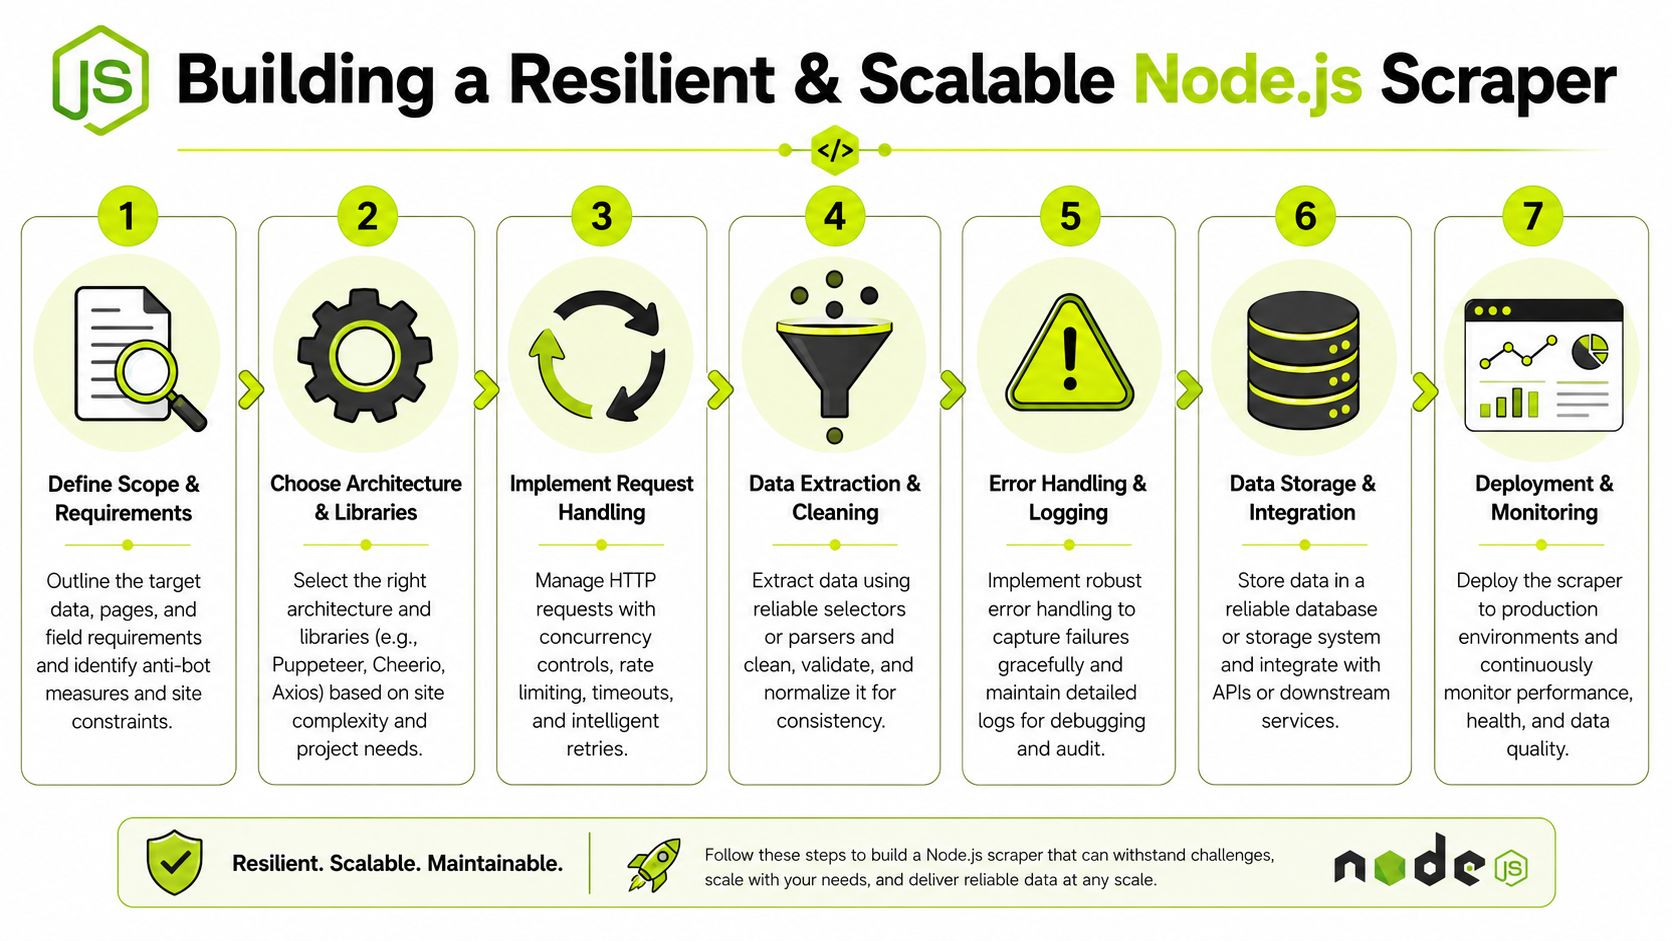
Los scrapers en producción primero fallan en pequeño. Unas cuantas páginas vacías. Un parser que devuelve cero filas sin avisar. Un bucle de reintentos que sigue golpeando la misma ruta rota. Si no lo instrumentas pronto, la tarea parece sana mientras los datos se degradan.
Empieza más despacio de lo que te gustaría
La metodología de scraping en Node.js más eficaz empieza con baja concurrencia, mide las tasas de éxito de descarga y de parseo, y solo aumenta la carga cuando se confirma la estabilidad, según la guía práctica de scraping con Node de Context. Es la postura correcta para trabajos de alto riesgo, porque un fallo bajo carga suele ocultar si el problema es un cambio en el layout, un fallo de transporte o un bloqueo.
Empieza con concurrencia limitada por host. No global. Por host. Eso evita que un objetivo ruidoso se apodere del proceso.
Métricas útiles:
- Tasa de éxito de descarga para ver la salud del transporte
- Tasa de éxito del parser para detectar cambios de layout
- Registros por página para que los fallos parciales no parezcan normales
- Tasa de duplicados para detectar problemas de paginación o enrutamiento
- Latencia P95 de descarga para identificar pools degradados antes de que colapsen
Guarda siempre los artefactos de cada fallo
Cuando un scraper se rompe, guarda el HTML en bruto antes de tocar el parser. Ese hábito te ahorra horas de conjeturas. Puedes comprobar si la página cambió, si apareció una página de desafío o si un proxy devolvió algo inesperado.
Un flujo limpio ante fallos se ve así:
- La petición falla o el parser devuelve cero registros.
- Guarda el cuerpo de la respuesta en bruto con marca de tiempo, objetivo, etiqueta del pool de proxies y etiqueta de sesión.
- Captura las cabeceras de la respuesta y la URL final tras las redirecciones.
- Lanza una alerta ante páginas repetidas con cero registros antes de reintentar con más complejidad.
- Solo entonces decide si añadir renderizado en navegador o cambiar de clase de proxy.
Guarda la página que falló, no la suposición sobre por qué falló.
Los reintentos también importan, pero necesitan intención. Usa backoff. Limita los intentos. Separa los errores reintentables de los permanentes. Un 429, un timeout o un fallo pasajero del gateway merecen otro intento. Un selector roto, no.
Monitoriza lo que de verdad se rompe
Un scraper resiliente se parece más a un servicio que a un script. Tiene colas, logs, métricas y una capa de persistencia elegida según el tamaño del trabajo.
Para el almacenamiento, sé sencillo cuando el trabajo es pequeño. JSONL o CSV bastan para recopilaciones puntuales y depuración. Pasa a PostgreSQL o MongoDB cuando necesites deduplicar, reprocesar, hacer joins o generar informes para los media buyers.
Checklist práctico para desplegar web scraping con Node:
- Disciplina de colas para que las tareas no superen en ráfagas los límites de cada host
- Configuración por objetivo para cabeceras, lógica del parser y reglas de reintento
- Logs estructurados con ID de tarea, ID de sesión, objetivo y etiqueta del proxy
- Alertas de cero registros, porque los bloqueos silenciosos son más peligrosos que los errores visibles
- Captura de fixtures de las páginas que fallan
- Ruta de reprocesado para que arreglar el parser no obligue a recopilarlo todo de nuevo
Usa workers separados para las tareas con navegador y las de HTTP puro. Si los mezclas, tendrás latencias ruidosas, un uso de memoria inestable y una depuración más difícil. La parte de navegador debe ser cara e intencionada. La parte HTTP, rápida y desechable.
CAPTCHAs y límites éticos
Los CAPTCHAs suelen ser un síntoma, no el problema de fondo. Si el objetivo te desafía una y otra vez, lo primero es mejorar la calidad del tráfico. Un enrutamiento residencial o móvil más limpio, huellas coherentes y un comportamiento menos agresivo reducen la frecuencia de los desafíos más que lanzar solvers a cada página.
Cuando los desafíos siguen bloqueando un flujo necesario, los equipos suelen integrar servicios como 2Captcha o Anti-CAPTCHA mediante API. Es una decisión de costes tanto como técnica. En el farmeo de cuentas y los flujos de cuentas publicitarias, un solver puede mantener la tarea en marcha, pero no arregla una huella rota ni una sesión sucia.
En cuanto a los datos, una mala infraestructura puede corromper el resultado sin que se note. Según un informe sobre la precisión del scraping y la calidad de la infraestructura, más del 27% de los datos scrapeados están duplicados, incompletos o son inexactos por un mal enrutamiento de las peticiones y una infraestructura de proxies sin probar. Ese es el verdadero riesgo de negocio. Crees que el scraper funcionó. El dataset dice lo contrario.
Los límites legales y éticos también son una cuestión operativa. Revisa los Términos de Servicio del objetivo. Lee el robots.txt, aunque no sea la autoridad legal definitiva. Mantén la concurrencia lo bastante baja para no afectar al rendimiento del sitio. Extrae solo los datos públicos que necesitas. Si tu stack empieza a provocar picos de carga, bucles de desafíos o daños colaterales a los usuarios normales, estás haciendo una mala operación.
Para los equipos que se topan a menudo con páginas de desafío, ayuda tener un vocabulario común sobre los tipos de CAPTCHA y las decisiones sobre cómo sortearlos, para que ingenieros, media buyers y account managers hablen del mismo tipo de fallo.
Si ejecutas tareas de scraping ligadas a operaciones publicitarias, farmeo de cuentas, revisiones por GEO o automatización de alto riesgo, Sota Proxy está hecho para ese tipo de carga. Da a los equipos acceso a pools residenciales, móviles, ISP, de centro de datos e IPv6 con amplia cobertura geográfica, y a controles de rotación y sesiones sticky que se adaptan a flujos de trabajo reales, no a scripts de juguete.
Artículos relacionados
Reddit "You've Been Blocked by Network Security": Todas las causas y la solución para cada una
No es un baneo y no hay nada que apelar. Proviene del edge de Reddit, se aplica a tu conexión y tiene seis causas. Aquí te mostramos cómo identificar cuál tienes y cuánto dura cada una.
Cuántas Cuentas de Discord Puedes Tener en 2026 (Por Email, Por Teléfono, Por Dispositivo)
Discord no publica ningún límite en las cuentas. Los límites reales son uno por email, un número de teléfono a la vez sin VOIP, y cinco en el Cambio de Cuentas, que Discord indica que puede hacer cumplir de forma general.
Automatización de Telegram con Telegram Expert: qué hacer si la tarea se detuvo a la mitad
Cuántas Cuentas de Reddit Puedes Tener en 2026 (Barreras de Karma, Baneos, Bloqueos de Seguridad de Red)
Reddit permite múltiples cuentas abiertamente. Lo que te detiene son las barreras de karma, calidad del colaborador, límites de tasa y una regla estricta sobre votación, además de los tres tipos de baneo, cómo se apela cada uno, y por qué "bloqueado por seguridad de red" no es ninguno de ellos.
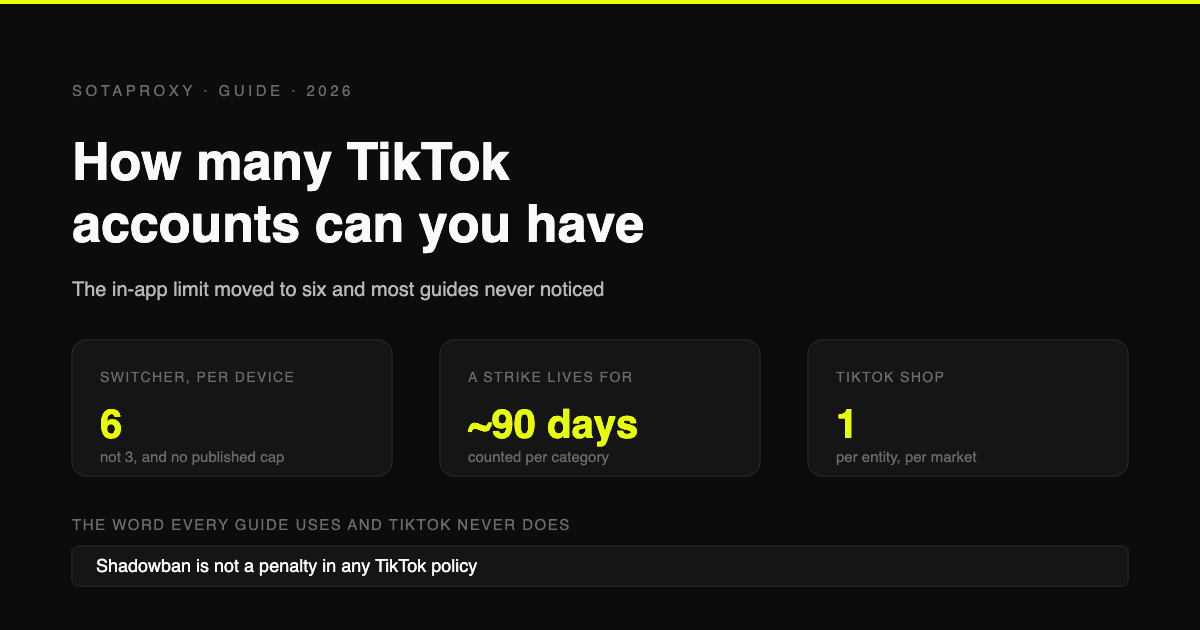
Cuántas Cuentas de TikTok Puedes Tener en 2026 (Límites, Strikes y Reglas de Shop)
Seis cuentas por dispositivo, no tres, y sin límite publicado. Las reglas que realmente deciden la supervivencia: límites de acción según la antigüedad de la cuenta, cómo expiran los strikes, qué es realmente un shadowban y una Shop por entidad comercial por mercado.
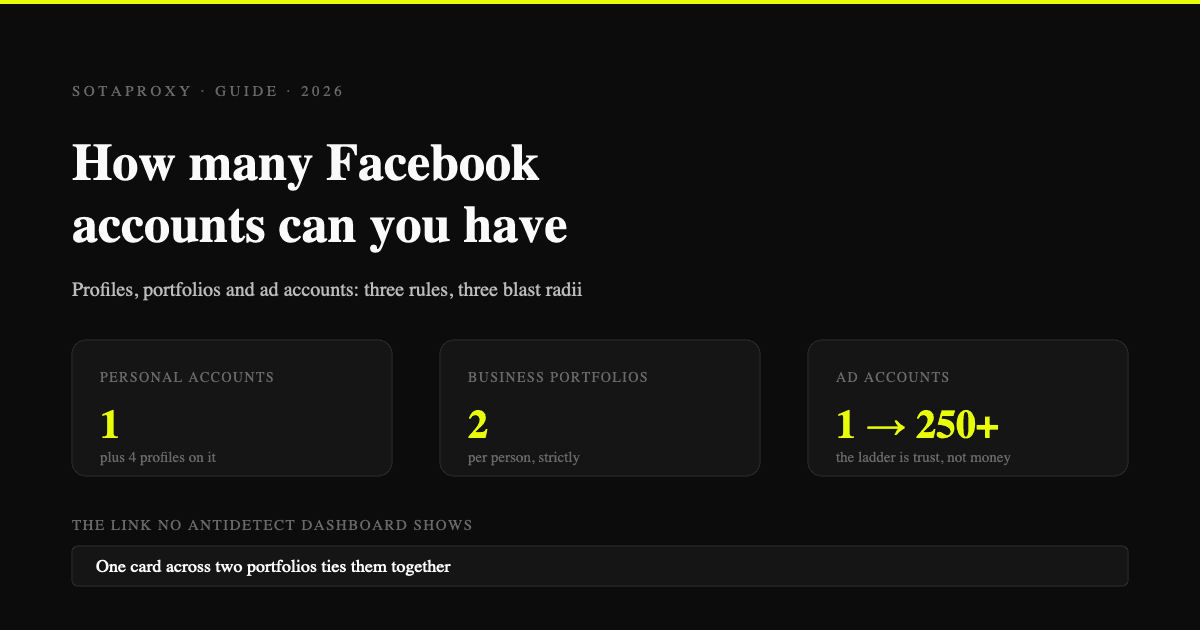
Cuántas Cuentas de Facebook Puedes Tener en 2026 (Perfiles, Portafolios, Cuentas Publicitarias)
Una cuenta personal, cuatro perfiles adicionales que comparten su enforcement, dos portafolios de negocios por persona, y un límite de cuentas publicitarias que crece con la confianza. Qué se restringe realmente y en qué orden.