Освоение XML и Python для автоматизации рекламных аккаунтов
Научитесь работать с XML и Python для рекламных технологий. В этом руководстве показано, как парсить, запрашивать и модифицировать XML для рекламных аккаунтов Facebook/TikTok и фарминга аккаунтов.
Вы получаете фид от партнёрской сети, ожидаете чистый список товаров, а получаете раздутый XML-документ с вложенными офферами, географическими правилами, параметрами трекинга и наполовину задокументированными полями. Затем вам нужно загрузить эти данные в рабочие процессы Facebook и TikTok, разделить креативы по странам, синхронизировать настройки уровня аккаунта в AdsPower или Multilogin и поддерживать стабильность всего этого в десятках или сотнях профилей.
Вот где XML и Python всё ещё имеют значение. Не в ностальгическом смысле устаревших систем. В практическом, production-ориентированном смысле. Команды арбитража трафика всё ещё сталкиваются с XML в партнёрских фидах, SOAP-эндпоинтах, экспортах из офисных программ, подписанных корпоративных данных и конфигурационных файлах, связанных с автоматизацией. Если вы управляете рекламными аккаунтами, настройками фарминга аккаунтов, правилами клоакинга или геотаргетированными кампаниями, вам нужен парсер, который не разваливается, когда фид становится странным.
Python остаётся одним из самых чистых способов справиться с этой работой. Его встроенные инструменты XML дают вам достаточно для парсинга, модификации и записи XML без добавления зависимостей для базовых задач, а его более широкая экосистема предоставляет более мощные опции, когда фиды становятся большими, запросы усложняются или входным данным нельзя доверять.
Содержание
- Почему вам всё ещё нужно освоить XML в 2026 году
- Выбор правильного XML-парсера для Python
- Парсинг и запрос XML-данных с помощью XPath
- Модификация и запись XML для задач автоматизации
- Оптимизация производительности с помощью стриминга и прокси
- Безопасная работа с XML и лучшие практики
Почему вам всё ещё нужно освоить XML в 2026 году
Байер запускает кампанию в 2 часа ночи. Ставки актуальны, креативы одобрены, логика таргетинга выглядит чистой в вашем дашборде. Затем партнёрский фид обновляется в формате XML, одно вложенное поле сдвигается, и половина правил в вашей автоматизационной цепочке перестаёт совпадать. Это всё ещё нормально в рекламных технологиях.
Арбитражные команды наследуют XML через старые партнёрские системы, эндпоинты комплаенса, экспорты биллинга, шаблоны профилей устройств и SOAP API, которые никогда не заменялись. JSON работает во множестве современных инструментов, но системы вокруг него часто всё ещё говорят на XML. В арбитраже трафика это обычно означает одну Python-задачу, вытягивающую метаданные офферов, другую переписывающую конфиги аккаунта или браузера, и третью, проверяющую правила гео или редиректа перед запуском бюджета.
Команды, которые хорошо с этим справляются, относятся к XML как к операционной зависимости, а не к устаревшему курьёзу. Если вы управляете мультиаккаунтными настройками, рабочими процессами фарминга аккаунтов, слоями клоакинга или запусками кампаний на основе фидов, ошибки XML - это не абстрактная проблема. Они приводят к неправильным редиректам, сломанному маппингу выплат, неправильному таргетингу по странам и незаметному дрейфу конфигурации в десятках или сотнях аккаунтов.
Где XML всё ещё встречается в рекламных операциях
В production XML обычно появляется в нескольких повторяющихся местах:
- Партнёрские фиды: каталоги офферов, капы, изменения выплат, блокировки стран и правила конверсий.
- Инфраструктура аккаунтов: экспорты профилей браузеров, шаблоны автоматизации, конфиги запуска и специфичные для инструментов настройки.
- Комплаенс и верификация: снимки проверок, карты редиректов, проверки локализованного контента и нагрузки для аудита.
- Устаревшие коннекторы: SOAP-сервисы, подписанные данные идентификации, финансовые экспорты и внутренние системы, которые так и не перешли на JSON.
AWS отмечает, что XML всё ещё широко используется для межсистемного обмена данными, публикации и рабочих процессов конфигурации в своём обзоре XML. Это соответствует повседневным рекламным операциям. XML выживает там, где дисциплина схем, совместимость и предсказуемая вложенность всё ещё важнее предпочтений разработчиков.
Ручная обработка XML быстро ломается. Быстрый патч с regex работает один раз, затем падает на пространствах имён, повторяющихся узлах, смешанном содержимом или отсутствующем опциональном поле от одного партнёра. Я видел, как небольшие ошибки фидов каскадом превращались в баги распределения бюджета, диагностировать которые занимало дольше, чем предотвратить с помощью правильного парсинга и валидации.
Python остаётся полезным здесь, потому что позволяет командам создавать процессоры фидов, трансформеры конфигов и задачи валидации достаточно быстро для реальных операций. Для арбитражных групп, получающих фиды через ротируемую инфраструктуру, сбор данных - это только одна часть пайплайна. Парсинг должен быть столь же надёжным. Команды, уже работающие с ротацией IP прокси для автоматизационных рабочих процессов, обычно узнают это после того, как первая задача удалённого фида успешно выполняется на сетевом уровне и падает внутри хрупкого XML-парсера.
Практическое правило простое. Если внешние фиды влияют на биддинг, маршрутизацию, настройку аккаунта или логику клоакинга, XML должен входить в ваш базовый набор навыков.
Выбор правильного XML-парсера для Python
Не каждая задача XML заслуживает одинакового парсера. Правильный выбор зависит от размера файла, сложности запросов, уровня доверия к источнику и частоты запуска скрипта.
Для многих задач ElementTree достаточно. Встроенная поддержка XML в Python сделала его языком по умолчанию для XML-скриптинга, потому что вы можете парсить, обходить, извлекать и записывать XML без сторонних пакетов, как описано в документации Python для ElementTree. Это полезно, когда вам нужен скрипт, развёртываемый где угодно, на ферм-боксе, раннере кампаний или узле управления с минимальными зависимостями.
Выбор парсера в зависимости от задачи
RealPython разграничивает push-парсинг с xml.sax и pull-парсинг с xml.etree.ElementTree, отмечая, что pull-парсинг может показать до 35% более высокую эффективность производительности для сложных наборов данных и критичен для обработки многогигабайтных файлов без переполнения памяти в требовательных рабочих процессах, как рассмотрено в его руководстве по XML-парсерам Python. Для арбитражных команд это разница между парсером, который справляется с некрасивыми партнёрскими фидами, и тем, который становится узким местом.
Вот практическое сравнение.
| Библиотека | Лучше всего для | Ключевое преимущество | Основной недостаток |
|---|---|---|---|
xml.etree.ElementTree |
Стандартный парсинг фидов, редактирование конфигов, базовая автоматизация | Встроен в Python и прост в развёртывании | Ограниченная поддержка XPath и меньше продвинутых функций |
lxml |
Тяжёлые запросы, большие сложные фиды, документы с большим количеством пространств имён | Сильная поддержка XPath и зрелый набор функций | Дополнительная зависимость и больше дисциплины в настройке |
xmltodict |
Небольшие конфигурационные файлы и быстрые трансформации | Быстро преобразует простой XML в dict-подобные структуры | Разваливается, когда структура становится глубокой или смешанное содержимое становится беспорядочным |
Где каждый парсер работает хорошо
ElementTree - это выбор по умолчанию, когда задача проста. Прочитать фид. Извлечь теги. Обновить значения. Записать файл обратно. Это хороший вариант для редактирования гео-правил в конфиге клоакинга, загрузки шаблонов аккаунтов или трансформации партнёрского экспорта перед передачей его в другой внутренний инструмент.
lxml - это то, что я бы использовал, когда важна логика выбора. Если вам нужен XPath, который может нацелиться на конкретный набор кампаний, сопоставить вложенные атрибуты или чисто обработать пространства имён, lxml экономит время. Это важно, когда один XML-документ содержит множество маппингов рекламных аккаунтов Facebook и TikTok, вариантов креативов, правил лендингов и переопределений ставок для разных гео.
xmltodict удобен для небольших файлов, где структура XML предсказуема, и вы хотите немедленного доступа в стиле словаря. Это нормально для лёгких настроек. Это не то, чему я бы доверял для сложного фида, который управляет расходами.
Если фид контролирует деньги, одобрения, редиректы или состояние аккаунта, используйте парсер, который делает структуру явной. Удобство перестаёт быть преимуществом, как только начинается отладка.
Есть также угол рабочего процесса. Команды, уже выполняющие веб-краулинг на Python для сбора данных, часто пытаются обрабатывать XML-фиды как полуструктурированный текст. Это работает до тех пор, пока не появятся пространства имён, повторяющиеся теги-сиблинги или глубокая вложенность. XML - это не скрейпинг HTML. Он вознаграждает более строгую обработку.
Простое правило принятия решения помогает:
- Используйте
ElementTreeдля встроенной надёжности и развёртывания без зависимостей. - Используйте
lxml, когда важна точность XPath и лучшая эргономика XML. - Используйте
xmltodictтолько для небольших, простых, доверенных входных данных.
Избегайте xml.sax, если только вы уже не знаете, почему вам нужны событийно-управляемые коллбэки. Для большинства рекламных технологий автоматизации он добавляет сложность без достаточного преимущества.
Парсинг и запрос XML-данных с помощью XPath
Команда арбитража трафика обычно замечает плохую логику выбора XML в самый неподходящий момент. Партнёрский фид поступает за минуты до запуска, один XPath пропускает пространство имён, половина кампаний для Германии никогда не направляется в правильный пул аккаунтов, и оператор видит это только после начала расходов.
XPath - это то, что не даёт этому превратиться в ручную задачу очистки. Он позволяет Python выбирать именно те узлы, которые управляют маршрутизацией, назначением аккаунтов, проверками ставок и правилами клоакинга, без написания вложенных циклов для каждого варианта фида.
Реалистичный пример фида кампании
Предположим, партнёр или внутренний генератор даёт вам XML вот так:
from lxml import etree

xml_data = """
<campaigns>
    <campaign id="fb-de-01" platform="facebook" status="active">
        <geo>DE</geo>
        <account>farm_batch_12</account>
        <creative>
            <name>de_video_a</name>
            <bid>1.80</bid>
        </creative>
    </campaign>
    <campaign id="tt-us-02" platform="tiktok" status="paused">
        <geo>US</geo>
        <account>farm_batch_22</account>
        <creative>
            <name>us_ugc_b</name>
            <bid>1.20</bid>
        </creative>
    </campaign>
    <campaign id="fb-de-03" platform="facebook" status="active">
        <geo>DE</geo>
        <account>agency_pool_4</account>
        <creative>
            <name>de_static_c</name>
            <bid>1.55</bid>
        </creative>
    </campaign>
</campaigns>
"""

root = etree.fromstring(xml_data)
Теперь запросите его с помощью XPath:
germany_campaigns = root.xpath("//campaign[geo='DE']")
for campaign in germany_campaigns:
    print(campaign.get("id"), campaign.get("platform"))
Это даёт вам кампании для Германии без дополнительного кода обхода. Ужесточите фильтр, когда фид контролирует бюджет или состояние аккаунта:
high_bid_facebook = root.xpath(
    "//campaign[@platform='facebook' and @status='active' and creative/bid > 1.50]"
)

for campaign in high_bid_facebook:
    print(campaign.get("id"))
В production такие запросы обычно находятся внутри задач маршрутизации, которые разделяют трафик по странам, отправляют кампании в отдельные группы аккаунтов Facebook или TikTok, сопоставляют лендинги с профилями клоакинга или проверяют, что фарм-аккаунты получают только одобренные гео. Если операторы также поддерживают специфичные для браузера конфиги запуска, полезно поддерживать логику маппинга аккаунтов в соответствии с рабочим процессом настроек прокси в браузере Firefox команды, чтобы выбор кампании и маршрутизация браузера не расходились.
Использование XPath для выбора кампаний
XPath зарабатывает своё место, когда правило выбора сложнее самого парсинга.
При ручном обходе дерева фид с вложенными группами аккаунтов, профилями браузеров, правилами редиректов и резервными креативами превращается в циклы внутри циклов плюс много проверок if. Это отнимает время при отладке и делает изменения фида более рискованными. XPath сохраняет правило видимым в одном выражении, что легче проверить перед запуском.
Несколько примеров:
# Все активные кампании
root.xpath("//campaign[@status='active']")

# Все названия креативов для Германии
root.xpath("//campaign[geo='DE']/creative/name/text()")

# Кампании, назначенные на конкретный пул аккаунтов
root.xpath("//campaign[account='farm_batch_12']")
Используйте XPath, когда операторам нужно ответить на бизнес-вопрос напрямую из XML. Какие активные кампании могут пойти в прогретый пул аккаунтов? Какие креативы относятся к DE и проходят минимальную ставку? Какие записи следует исключить из набора клоакированных лендингов? Эти вопросы чётко отображаются на XPath, и эта ясность снижает количество ошибок.
Пространства имён и отсутствующие узлы
Две вещи постоянно ломают XML-скрипты в рекламных операциях. Пространства имён и опциональные элементы.
Пространства имён появляются в партнёрских экспортах, подписанных нагрузках, XML, сгенерированном офисными программами, и фидах на основе схем. Когда findall() или XPath ничего не возвращает, хотя теги есть в файле, причина часто в пространстве имён.
Пример:
xml_ns = """
<ns:campaigns xmlns:ns="http://example.com/campaigns">
    <ns:campaign id="1">
        <ns:geo>DE</ns:geo>
    </ns:campaign>
</ns:campaigns>
"""

root = etree.fromstring(xml_ns)
ns = {"ns": "http://example.com/campaigns"}

campaigns = root.xpath("//ns:campaign[ns:geo='DE']", namespaces=ns)
Игнорируйте карту пространств имён, и запрос незаметно провалится. Вот как скрипт проходит тестирование на вчерашнем файле-образце и падает на сегодняшней ревизии фида.
Отсутствующие узлы XML вызывают другой класс сбоев. Руководство FreeCodeCamp по парсингу XML в Python без внешних библиотек предупреждает о небезопасных паттернах доступа, таких как вызов .text на отсутствующем результате от find(). В рекламных фидах это проявляется, когда у кампании отсутствует ставка, у профиля браузера нет кода страны или в правиле клоакинга опущен опциональный параметр.
Используйте защитное извлечение:
campaign = root.find(".//campaign")
geo = campaign.find("geo") if campaign is not None else None

if geo is not None and geo.text:
    print(geo.text)
else:
    print("missing geo")
Или с lxml и XPath:
geo_values = root.xpath("//campaign[@id='fb-de-01']/geo/text()")
geo = geo_values[0] if geo_values else None
Отсутствующие узлы нормальны в production-фидах. Обрабатывайте каждое опциональное поле как nullable, валидируйте перед доступом и падайте с логированием, которое сообщает оператору, какой ID кампании, партнёрский источник или пул аккаунтов вызвал проблему. Это не даёт ошибкам парсера превратиться в незаметную неправильную маршрутизацию.
Модификация и запись XML для задач автоматизации
Чтение XML - это только половина работы. Команды, которые управляют аккаунт-фермами, геотаргетированными редиректами или шаблонами профилей браузеров, обычно должны изменять XML и возвращать его обратно.
Это может означать замену целевой страны, вставку токена трекинга, удаление устаревшего правила или генерацию конфигурационных файлов для конкретного аккаунта перед запуском.
Редактирование шаблона клоакинга или кампании
Начните с простого шаблона XML:
import xml.etree.ElementTree as ET

xml_data = """
<campaign_config>
    <target_country>US</target_country>
    <platform>facebook</platform>
    <tracking_param>old_value</tracking_param>
    <obsolete_flag>1</obsolete_flag>
</campaign_config>
"""

root = ET.fromstring(xml_data)
Теперь измените его в памяти:
country = root.find("target_country")
if country is not None:
    country.text = "DE"

tracking = root.find("tracking_param")
if tracking is not None:
    tracking.text = "de_launch_batch_7"

obsolete = root.find("obsolete_flag")
if obsolete is not None:
    root.remove(obsolete)

new_elem = ET.SubElement(root, "browser_profile")
new_elem.text = "multilogin_de_stack"
Этот паттерн полезен, когда вы клонируете один базовый конфиг в несколько вариантов для конкретных рынков. Один скрипт может генерировать отдельные выходы для Германии, Франции или Великобритании, назначать разные профили браузеров и поддерживать согласованность ваших правил кампаний в группах аккаунтов.
Практический пример:
- Экспорт профиля AdsPower или GoLogin: внедрение меток аккаунтов и назначения гео.
- Помощник кампаний Facebook: замена целевой страны и добавление токена трекинга.
- Конфиг клоакинга: удаление устаревших проверок и вставка нового правила для пути лендинга.
Если вам нужно согласование прокси на уровне браузера во время тестирования, команды часто сочетают такую генерацию конфигов с проверками настроек в среде на базе Firefox. Справка по настройкам прокси браузера в Firefox полезна, когда XML-конфиг управляет валидацией, чувствительной к местоположению.
Запись чистого XML обратно на диск
После обновления дерева сериализуйте его:
tree = ET.ElementTree(root)
tree.write("campaign_config_de.xml", encoding="utf-8", xml_declaration=True)
Если сначала нужна строка:
xml_output = ET.tostring(root, encoding="unicode")
print(xml_output)
Несколько правил записи важны в production:
- Сохраняйте обязательные имена тегов: партнёрские системы часто отклоняют небольшие изменения имён.
- Не переупорядочивайте узлы небрежно: некоторые старые потребители хрупкие.
- Храните версии шаблонов отдельно: одна плохая перезапись может сломать несколько путей запуска.
- Валидируйте перед загрузкой: особенно если другой инструмент потребляет модифицированный файл автоматически.
Чистая запись важнее умной записи. Скучный XML-файл, который импортируется правильно, лучше модного конвейера трансформации, который сохраняет некорректный вывод.
Для управления мультиаккаунтами генерация XML часто становится пакетной операцией. Загрузите список аккаунтов, сопоставьте гео и платформу, выведите один конфиг на профиль браузера или кластер кампаний. Python справляется с этим хорошо, потому что API XML остаётся читабельным, даже когда автоматизация вокруг него увеличивается.
Оптимизация производительности с помощью стриминга и прокси
Команда трафика, получающая ежечасные XML-фиды в десятках аккаунтов, обычно сначала сталкивается с одной проблемой. RAM растёт, воркеры зависают, и один слишком большой партнёрский экспорт блокирует остальную часть очереди.
Парсинг всего дерева подходит для небольших документов и одноразовых скриптов. В production-приёме фидов, особенно для синхронизации рекламных кампаний, обновлений инвентаря аккаунтов и задач верификации, он расходует память, которую следует держать доступной для повторов, логирования и последующей нормализации. Более безопасный паттерн - стримить узлы, извлекать то, что важно, и немедленно отбрасывать остальное.
Почему стриминг лучше справляется с нагрузкой
Стриминг подходит для XML-задач, которые выполняют арбитражные команды:
- повторяющиеся узлы кампаний или офферов в больших партнёрских фидах
- геоспецифичные экспорты верификации, получаемые через разные выходы
- инвентари фарминга аккаунтов, объединённые в один документ
- воркеры опроса, которые обрабатывают одну и ту же схему весь день без перезапуска
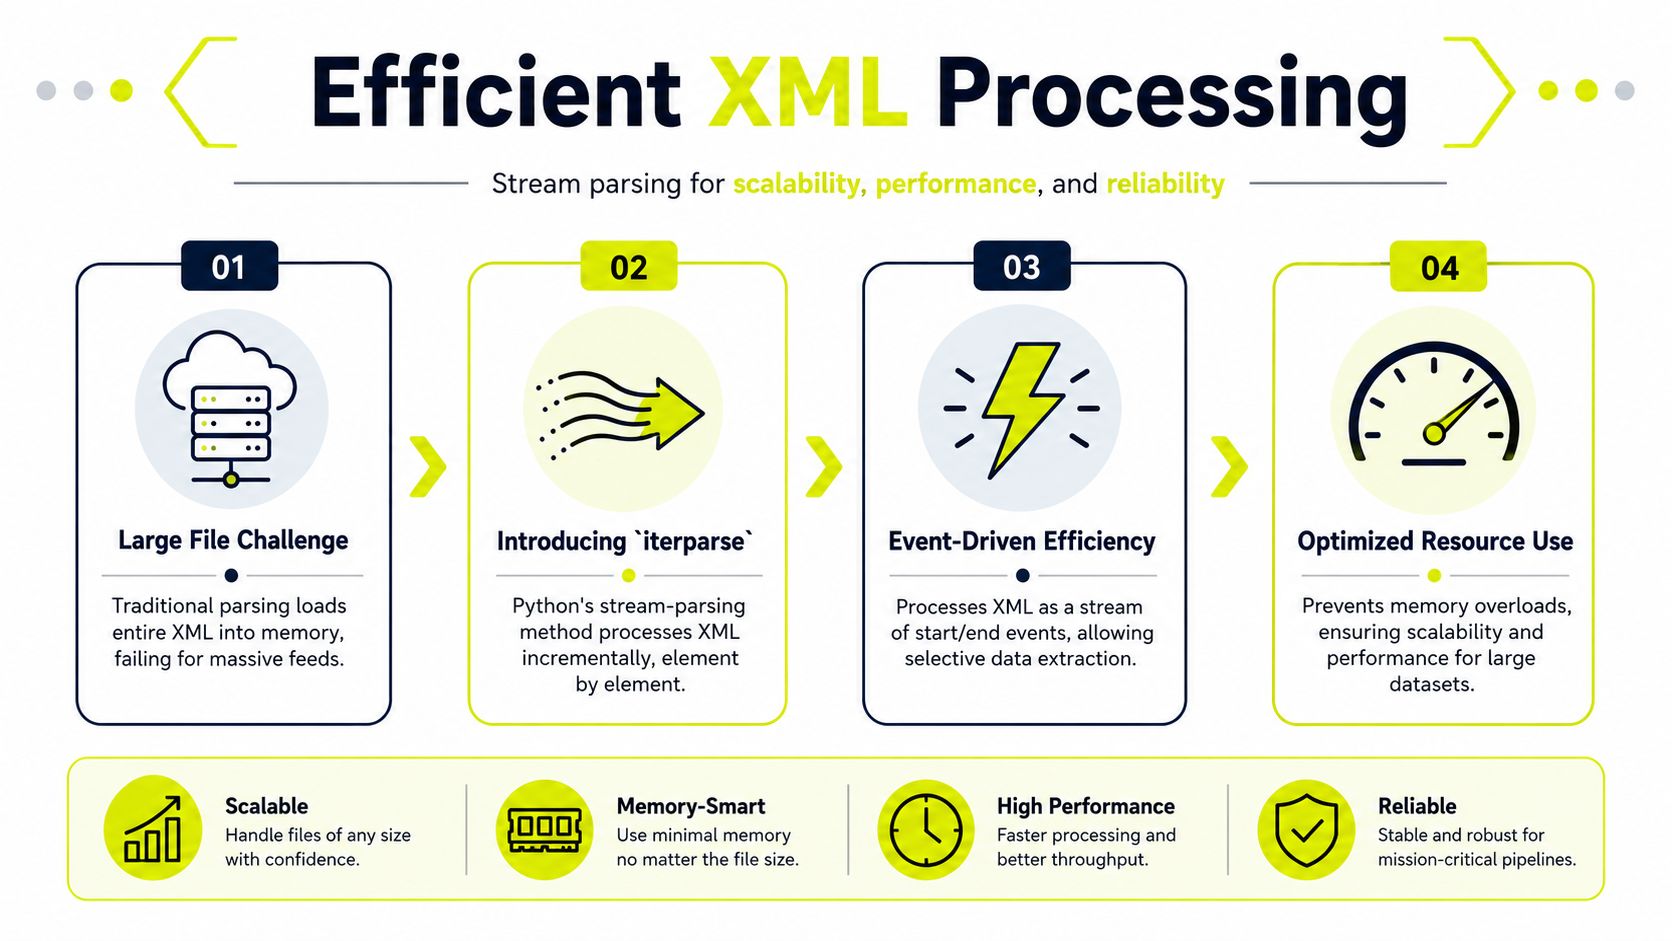
Цель проста. Держать резидентную память предсказуемой, даже когда размер фида непредсказуем.
Использование iterparse для больших удалённых фидов
iterparse - это практичный выбор, когда фид слишком большой, чтобы удобно удерживаться в памяти.
import xml.etree.ElementTree as ET

for event, elem in ET.iterparse("large_feed.xml", events=("end",)):
    if elem.tag == "campaign":
        campaign_id = elem.attrib.get("id")
        geo = elem.findtext("geo")
        platform = elem.attrib.get("platform")

        if geo == "DE" and platform == "facebook":
            print(campaign_id)

        elem.clear()
elem.clear() - это то, что делает этот паттерн полезным. Без него долго работающие воркеры медленно накапливают обработанные узлы и в конечном итоге падают, как парсеры полного дерева.
Для рекламных пайплайнов я доверяю этому подходу для одно-проходных задач. Прочитайте фид, извлеките поля кампании, сопоставьте их во внутренний формат меньшего размера, затем запишите в очередь или базу данных. Если задача требует межзаписных сравнений, делайте это на втором этапе после уменьшения нагрузки.
Подбор прокси под поведение фида
Выбор прокси влияет на качество данных так же сильно, как выбор парсера. Если эндпоинт меняет вывод в зависимости от страны, ASN, мобильного оператора или репутационного профиля, неправильный выход даёт вам чистый парс неправильного фида.
Варианты использования довольно чётко разделяются:
- Датацентровые прокси: хороши для быстрого массового получения из стабильных эндпоинтов, которые не агрессивно локализуются
- Резидентные прокси: лучше для фидов для конкретных стран, региональной валидации и эндпоинтов, которые реагируют на IP-репутацию
- Мобильные прокси: полезны для проверки офферных потоков только для мобильных, редиректов, зависящих от оператора, и клоакированных путей, показываемых модерации или системам обнаружения мошенничества
- IPv6 прокси: стоит использовать, когда цель хорошо обрабатывает IPv6, и ротация адресов важнее широкой совместимости
Поведение TLS тоже имеет значение. Партнёрские эндпоинты часто выдают разные сертификаты, ограничения скорости или правила фильтрации в зависимости от маршрута и региона. Команды, валидирующие зашифрованные фиды через несколько выходов, должны понимать поведение SSL-прокси-сервера для безопасных партнёрских эндпоинтов, прежде чем обвинять логику парсера в плохих данных.
Распространённая production-ошибка - разделять сбор по сети и обработку XML, как если бы это были несвязанные системы. Это один пайплайн. Фид кампании только для Германии, полученный через неправильный регион, может пройти проверки схемы, заполнить вашу базу данных и всё равно отравить биддинг, проверки проверок и верификацию клоакинга в нескольких аккаунтах.
Практическое правило - измерять обе стороны вместе. Отслеживайте задержку получения, размер ответа, время парсинга, использование памяти и правильность страны по группе прокси. Вот как команды сохраняют стабильность приёма, когда синхронизируют много аккаунтов одновременно и не могут позволить себе незаметный дрейф данных.
Безопасная работа с XML и лучшие практики
Парсинг XML из недоверенного источника - это решение о безопасности, а не только о кодировании.
Это важно в рекламных технологиях, потому что команды часто получают файлы из партнёрских сетей, партнёрских API, арендованных инструментов, внутренних загрузок и разовых экспортов от поставщиков. Если вы обрабатываете все эти входные данные как безопасные, вы приглашаете избегаемый риск в ту же среду, которая содержит логику кампаний, маппинги аккаунтов и учётные данные автоматизации.
Почему недоверенный XML - это операционный риск
Сообщество Python явно предупреждает, что его модули обработки XML не безопасны против злонамеренно созданных данных, и для недоверенных источников рекомендуются альтернативы, такие как defusedxml, как обсуждалось в треде сообщества Python о предупреждениях безопасности XML.
Это предупреждение важно, потому что большинство примеров XML онлайн останавливаются на парсинге синтаксиса. Production-команды должны думать о случаях злоупотребления:
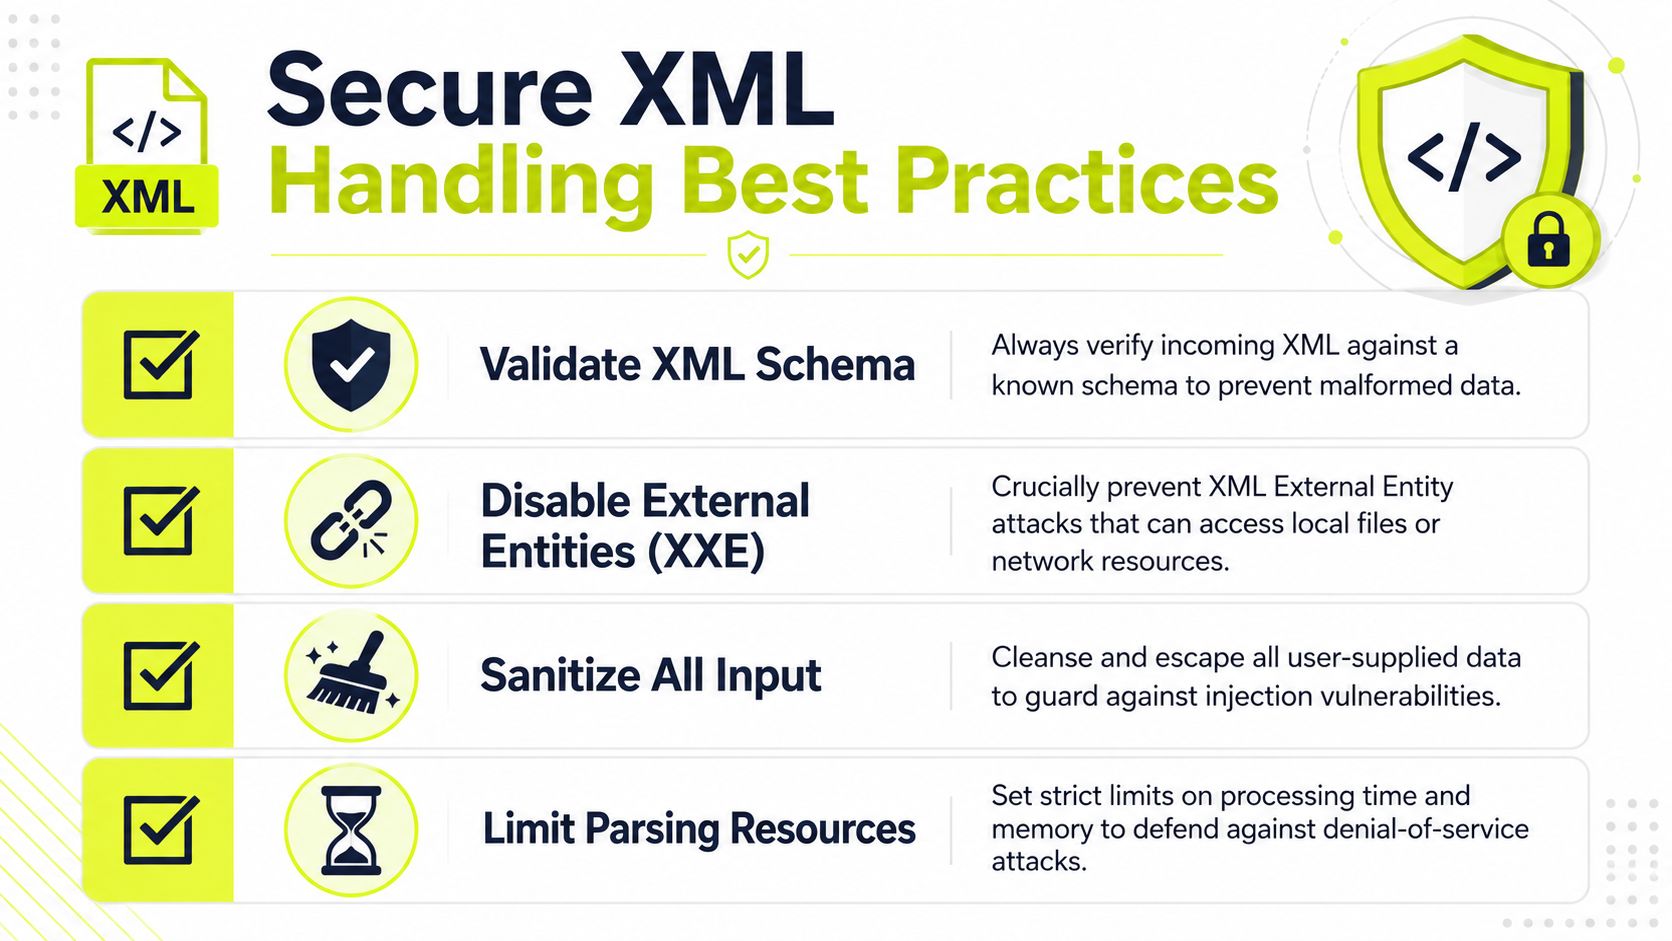
- XXE-атаки: внешние сущности могут быть использованы для доступа к локальным файлам или внутренним ресурсам, если парсер это позволяет.
- Входы отказа в обслуживании: злонамеренно созданный XML может потреблять избыточные ресурсы.
- Небезопасные привычки сериализации: XML, используемый в качестве транспорта для чувствительных структурированных данных, может создать проблемы доверия, если валидация слабая.
Подписанный XML всё ещё актуален в рабочих процессах высокого доверия. SignXML отмечает, что XML Signature по-прежнему используется для SAML 2.0, XAdES, EBICS и WS-Security в своей документации проекта. Вот одна из причин, почему XML не исчез из серьёзных интеграций. Если ваш трафиковый стек касается идентичности, корпоративного биллинга или регулируемых партнёрских данных, безопасная обработка XML не опциональна.
Чек-лист для production
Используйте базовый подход, ориентированный на безопасность, каждый раз:
- Обрабатывайте сторонний XML как враждебный по умолчанию: особенно из загрузок, партнёрских дашбордов или недокументированных эндпоинтов.
- Используйте более безопасные опции парсинга: предпочитайте усиленные библиотеки, такие как
defusedxml, когда источник не полностью доверен. - Валидируйте структуру до запуска бизнес-логики: валидация схемы и строгие проверки полей ловят некорректные данные рано.
- Устанавливайте границы ресурсов: задачи парсинга должны иметь ограничения на время, память и размер файла.
- Разделяйте приём и выполнение: не позволяйте распарсенному XML напрямую запускать чувствительные действия без валидации.
- Аудитируйте поведение DNS в вашем стеке сбора: при проксировании запросов для удалённого XML поймите, как обработка DNS прокси влияет на пути запросов.
Дорогой баг XML обычно не синтаксическая ошибка. Это ошибка доверия.
Это применимо независимо от того, импортируете ли вы подписанную нагрузку, обрабатываете фид для фарминга аккаунтов или валидируете правила клоакинга для геотаргетированных кампаний. Надёжная автоматизация зависит от того, что парсер строгий, защитный и изолирован от недоверенного ввода.
Если вы создаёте XML-управляемую автоматизацию для верификации рекламы, приёма фидов, фарминга аккаунтов или мультиаккаунтных рабочих процессов в браузере, Sota Proxy даёт вам прокси-слой для тестирования геоспецифичных выводов, надёжного получения удалённых фидов и валидации того, что видят трафик Facebook или TikTok в разных регионах. Для команд, которые уже делятся инструментами с другими операторами, его партнёрская программа также предлагает до 40% комиссии.
Похожие статьи

Bing Search API ключ: настройка, тестирование и масштабирование в 2026 году
Получите рабочий Bing Search API ключ в 2026 году, протестируйте запросы, защитите ключ и масштабируйте высоконагруженный скрейпинг без блокировок. Практическое руководство для технических команд.

10 способов сбора качественных данных для медиабайеров
Откройте для себя 10 способов сбора качественных данных от ваших пользователей. Изучите методы, такие как интервью и фокус-группы, для оптимизации использования прокси и стратегии кампаний.
Для чего используется прокси: руководство по арбитражу 2026
Для чего используется прокси - узнайте, для чего применяется прокси в 2026 году: от повышения безопасности до управления мультиаккаунтами для арбитражных команд
ERR_TUNNEL_CONNECTION_FAILED: диагноз содержится в самой ошибке
Chrome попросил прокси открыть CONNECT-туннель, но получил отказ. Это и есть суть ошибки. Откуда берётся прокси, который вы никогда не настраивали, шесть причин, по которым настроенный прокси выдаёт эту ошибку, и почему очистка кеша ничего не решает.
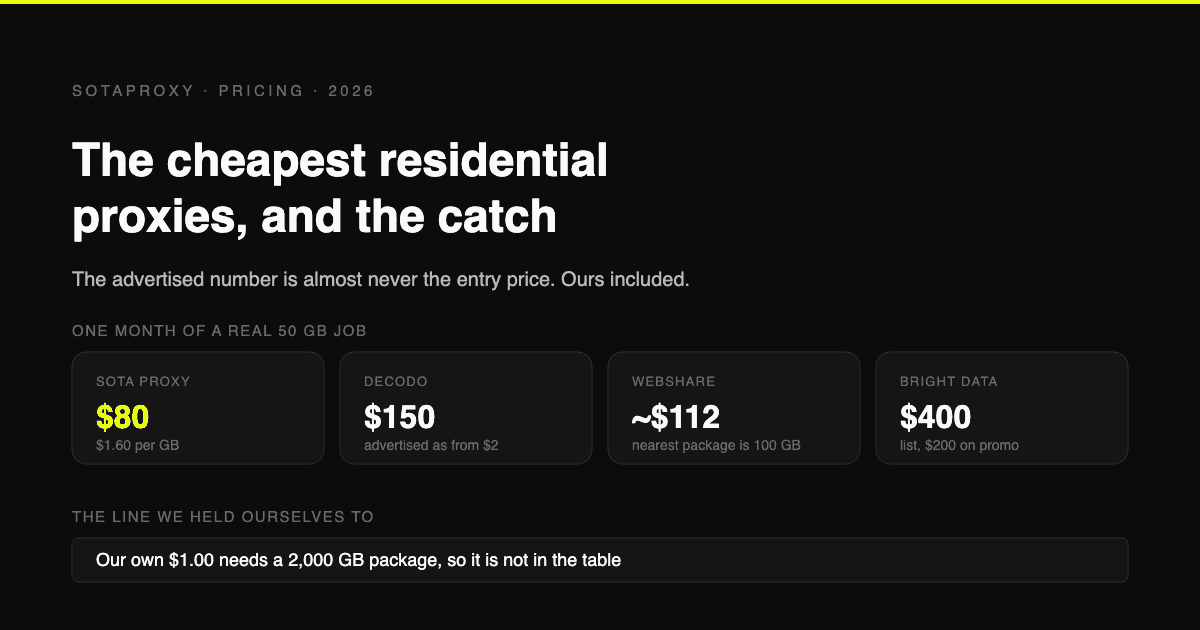
Самые дешёвые резидентные прокси в 2026 году и подводные камни каждого из них
Проверенные цены за гигабайт с сайтов пяти провайдеров, а не из прошлогодних обзоров. Почему заявленная стоимость почти никогда не совпадает с реальной ценой входа, какие провайдеры устанавливают минимальный месячный порог для счёта и как рассчитать настоящую цену за гигабайт.
Сколько аккаунтов Telegram можно иметь в 2026 году (и что на самом деле означает «ограничение»)
Telegram не публикует лимит на количество аккаунтов, один номер на аккаунт, а в официальном FAQ по спаму сказано, что ограниченный аккаунт может писать всем, кто сохранил ваш номер. Что вызывает ограничения, почему виртуальные номера попадают под блок ещё до первого сообщения и почему досрочной разблокировки не существует.