Веб-краулинг на Python: три подхода к одному парсеру и реальная скорость каждого
Рабочий краулер на Python с библиотекой requests, затем тот же сбор данных с asyncio и Scrapy. Замеры скорости на одном и том же сайте. Плюс работа с JavaScript-страницами, прокси и ловушки, которые ломают парсеры.
Веб-краулер делает то, чего не делает обычный скрейпер: он сам находит страницы. Вы даёте ему стартовый адрес, он переходит по встреченным ссылкам и продолжает работу, пока не обойдёт весь сайт или не достигнет заданного вами лимита. Извлечение данных из каждой страницы - это скрейпинг. Решение о том, какую страницу загрузить следующей, - это краулинг.
В этом руководстве мы построим один и тот же краулер тремя способами: на requests, на asyncio и на Scrapy. Все три варианта мы запустили против одного и того же сайта 30 сентября 2026 года и засекли время, так что сравнение в конце основано на реальных измерениях, а не пересказе чужих слов. Цель - books.toscrape.com, песочница, созданная именно для таких экспериментов.
Минимальный рабочий краулер
Установите два пакета:
pip install requests beautifulsoup4Вот и весь краулер:
import time
from collections import deque
from urllib.parse import urljoin, urldefrag, urlparse
from urllib.robotparser import RobotFileParser

import requests
from bs4 import BeautifulSoup

START = "https://books.toscrape.com/"
MAX_PAGES = 300
DELAY = 0.0          # seconds between requests; raise it on real sites
USER_AGENT = "my-crawler/1.0 (+mailto:you@example.com)"

host = urlparse(START).netloc
robots = RobotFileParser(urljoin(START, "/robots.txt"))
robots.read()

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT

queue = deque([START])     # the frontier: URLs waiting to be fetched
seen = {START}             # every URL ever queued, so nothing is fetched twice
pages = 0

while queue and pages < MAX_PAGES:
    url = queue.popleft()
    if not robots.can_fetch(USER_AGENT, url):
        continue
    try:
        r = session.get(url, timeout=15)
    except requests.RequestException as e:
        print("failed", url, e)
        continue
    if r.status_code != 200 or "text/html" not in r.headers.get("Content-Type", ""):
        continue

    pages += 1
    soup = BeautifulSoup(r.text, "html.parser")
    title = soup.title.get_text(strip=True) if soup.title else ""
    print(pages, url, title)

    for a in soup.select("a[href]"):
        link = urldefrag(urljoin(url, a["href"])).url   # absolute, no #fragment
        if urlparse(link).netloc == host and link not in seen:
            seen.add(link)
            queue.append(link)

    time.sleep(DELAY)
Четыре его части - это то, что превращает любой код в краулер:
- Фронтир.
queueхранит адреса, ожидающие загрузки. Извлечение с начала очереди даёт обход в ширину, при котором важные страницы сайта достигаются раньше глубоко вложенных. - Множество посещённых. Без него краулер будет заново загружать главную каждый раз, когда какая-то страница на неё ссылается, и никогда не закончит работу.
- Область обхода. Проверка хоста удерживает краулер в пределах одного сайта. Уберите её, и вы будете обходить весь интернет.
- Вежливость. Краулер читает
robots.txt, идентифицирует себя через User-Agent, в котором указано, как с вами связаться, и имеет задержку, которую можно увеличить.
Две мелкие детали избавляют от проблем в дальнейшем. urljoin превращает относительные ссылки в полные адреса, а urldefrag отбрасывает часть #section, чтобы одна страница не попадала в очередь под разными именами. Проверка Content-Type не даёт краулеру пытаться разобрать картинки и PDF как HTML.
Тот же обход, десять страниц одновременно
Первый краулер почти всё время проводит в ожидании сети, один запрос за другим. Решение - ждать сразу несколько запросов. В этой версии используются httpx и asyncio с десятью воркерами, разделяющими одну очередь:
pip install httpx beautifulsoup4import asyncio
from urllib.parse import urljoin, urldefrag, urlparse
import httpx
from bs4 import BeautifulSoup
START = "https://books.toscrape.com/"
MAX_PAGES = 300
CONCURRENCY = 10
USER_AGENT = "my-crawler/1.0 (+mailto:you@example.com)"
host = urlparse(START).netloc
async def worker(client, queue, seen, state):
while True:
url = await queue.get()
try:
if state["started"] >= MAX_PAGES:
continue
state["started"] += 1
r = await client.get(url)
if r.status_code != 200 or "text/html" not in r.headers.get("content-type", ""):
continue
state["pages"] += 1
state["bytes"] += r.num_bytes_downloaded
soup = BeautifulSoup(r.text, "html.parser")
for a in soup.select("a[href]"):
link = urldefrag(urljoin(url, a["href"])).url
if urlparse(link).netloc == host and link not in seen:
seen.add(link)
queue.put_nowait(link)
except httpx.HTTPError as e:
print("failed", url, e)
finally:
queue.task_done()
async def main():
queue = asyncio.Queue()
queue.put_nowait(START)
seen = {START}
state = {"started": 0, "pages": 0, "bytes": 0}
async with httpx.AsyncClient(timeout=15, headers={"User-Agent": USER_AGENT}) as client:
workers = [asyncio.create_task(worker(client, queue, seen, state))
for _ in range(CONCURRENCY)]
await queue.join()
for w in workers:
w.cancel()
print(state, "urls discovered:", len(seen))
asyncio.run(main())Логика не изменилась: фронтир, множество посещённых, проверка области. Что изменилось, так это то, что десять воркеров берут из очереди одновременно. CONCURRENCY - это параметр, с которым нужно быть аккуратным. Десять удобно для песочницы. На реальном сайте это десять одновременных посетителей с одного адреса, и многие сайты это заметят.
В этой версии опущен robots.txt для краткости. Добавьте ту же проверку RobotFileParser, прежде чем направлять краулер на реальный сайт.
Тот же обход в Scrapy
Scrapy - это фреймворк, построенный для этой задачи. Фронтир, множество посещённых, область обхода, robots.txt, повторы и файлы вывода уже там, поэтому спайдер - это в основном конфигурация:
pip install scrapyfrom scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
class BooksSpider(CrawlSpider):
name = "books"
allowed_domains = ["books.toscrape.com"]
start_urls = ["https://books.toscrape.com/"]
rules = [Rule(LinkExtractor(), callback="parse_page", follow=True)]
custom_settings = {
"USER_AGENT": "my-crawler/1.0 (+mailto:you@example.com)",
"ROBOTSTXT_OBEY": True,
"CONCURRENT_REQUESTS_PER_DOMAIN": 10,
"DOWNLOAD_DELAY": 0,
"CLOSESPIDER_PAGECOUNT": 300,
}```python
def parse_page(self, response):
yield {
"url": response.url,
"title": response.css("title::text").get(default="").strip(),
}
```
Сохраните код в файл `books_spider.py` и запустите без создания проекта:
```
scrapy runspider books_spider.py -O pages.jsonl
```
Результаты окажутся в `pages.jsonl`, по одному JSON-объекту на строку. При работе с реальным сайтом установите `DOWNLOAD_DELAY` больше нуля или включите `AUTOTHROTTLE_ENABLED`, это замедлит сканирование, когда сервер начнёт отвечать медленнее.
## Что мы измерили
Все три краулера обходили один и тот же сайт с одного ноутбука через домашнее подключение, без задержек, останавливаясь на 300 страницах.
| Краулер | Страниц | Время выполнения | Страниц в секунду |
|---------|---------|------------------|-------------------|
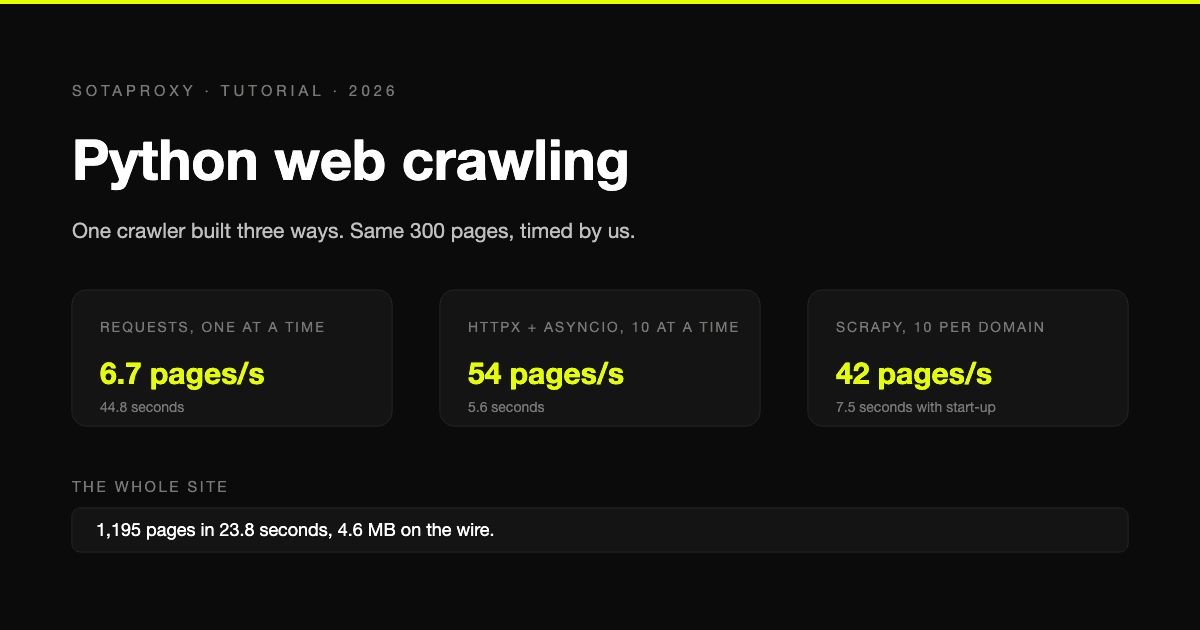
| requests, по одному запросу | 300 | 44,8 с | 6,7 |
| httpx и asyncio, по 10 запросов | 300 | 5,6 с | 54 |
| Scrapy, 10 на домен | 317 | 7,5 с | 42 |
Использовались Python 3.13, requests 2.34, httpx 0.28, Scrapy 2.19 и BeautifulSoup 4.15.
Что показывает таблица:
- **Параллелизм решает всё.** Переход с одного запроса к десяти ускорил сканирование в восемь раз при том же коде парсинга.
- **Scrapy не такой медленный, каким выглядит.** Собственная статистика фреймворка показала 4,9 секунды на сканирование. Остальное из 7,5 секунд ушло на запуск, что перестаёт иметь значение при сколько-нибудь серьёзном объёме работы. Превышение лимита на 17 страниц объясняется тем, что уже запущенные запросы доводятся до конца.
- **На реальном сайте таких скоростей не будет.** Песочница не вводит ограничений по частоте запросов. Если сайт их вводит, ваша скорость равна тому, что сайт допускает, и выбор инструмента роли не играет.
Ещё мы дали версии с asyncio пройти сайт до конца. Всего там 1195 страниц. Процесс занял 23,8 секунды и 4,6 МБ трафика против 28,4 МБ распакованного HTML. Все три библиотеки по умолчанию запрашивают сжатые ответы, и на этом сайте объём передачи сократился в шесть раз. Если вы платите за прокси-трафик за гигабайты, не отключайте эту опцию.
## Что использовать
| Ситуация | Используйте |
|----------|-------------|
| Несколько сотен страниц один раз | requests. Проще всего читать и отлаживать |
| Тысячи страниц, своя логика | httpx с asyncio |
| Сканирование, которое будете повторять, или несколько сайтов | Scrapy |
| Страницы, пустые до выполнения JavaScript | Браузер через Playwright |
## Страницы, которым нужен JavaScript
Некоторые страницы приходят пустой оболочкой и заполняются скриптами. Обычный HTTP-запрос не видит содержимого. У учебного сайта есть версия, построенная таким образом, и разницу легко показать:
```python
import requests
from bs4 import BeautifulSoup
from playwright.sync_api import sync_playwright
URL = "https://quotes.toscrape.com/js/"
html = requests.get(URL, timeout=15).text
print("requests:", len(BeautifulSoup(html, "html.parser").select(".quote")), "quotes")
with sync_playwright() as p:
browser = p.chromium.launch(channel="chrome") # использует уже установленный Chrome
page = browser.new_page()
page.goto(URL)
page.wait_for_selector(".quote")
html = page.content()
browser.close()
print("playwright:", len(BeautifulSoup(html, "html.parser").select(".quote")), "quotes")
```
При запуске requests нашёл 0 цитат, а Playwright нашёл 10. Установите Playwright через `pip install playwright`. Аргумент `channel="chrome"` заставляет библиотеку управлять уже установленным Chrome, не нужно скачивать отдельный браузер.
Браузер медленный и тяжёлый по сравнению с обычным запросом, используйте его только для страниц, которым он действительно нужен. Сначала проверьте: если данные есть в ответе на обычный запрос, браузер не требуется.
## Добавление прокси
Краулеру нужен прокси, когда сайт ограничивает или блокирует ваш адрес или когда надо увидеть сайт так, как его видят из другой страны. Каждый инструмент принимает прокси немного по-своему. Мы проверили все четыре варианта ниже против логирующего прокси, чтобы убедиться, что запросы проходят через него.
```python
PROXY = "http://login_c_US:password@proxy.sotaproxy.com:10000"
# requests
session = requests.Session()
session.proxies = {"http": PROXY, "https": PROXY}
# httpx
client = httpx.AsyncClient(proxy=PROXY)
```# Playwright
browser = p.chromium.launch(proxy={
"server": "http://proxy.sotaproxy.com:10000",
"username": "login_c_US",
"password": "password",
})Scrapy считывает стандартные переменные окружения, так что код паука менять не нужно:
https_proxy=http://login_c_US:password@proxy.sotaproxy.com:10000 scrapy runspider books_spider.pyДва момента, которые нужно учитывать.
Ротирующий прокси меняет адрес на каждое соединение. Все три HTTP-клиента выше переиспользуют соединения ради скорости, поэтому краулер может удерживать один и тот же выходной адрес гораздо дольше, чем вы ожидаете. Как управлять этим через идентификаторы сессий, описано в разделе rotating and sticky sessions.
Selenium не принимает логин и пароль прокси через стандартные опции. Если вы привязаны к Selenium, способы обхода перечислены в authentication and IP whitelisting. У Playwright такой проблемы нет.
Какой тип прокси нужен для конкретного сайта и как это выяснить за двести запросов, рассмотрено в статье best proxies for web scraping.
Что ломает краулеры
- Бесконечная пагинация. Календари, фильтры и варианты сортировки порождают новый адрес на каждую комбинацию. Ставьте лимит по страницам, как это сделано во всех примерах здесь, и подумайте об ограничении глубины обхода.
- Одна страница под множеством адресов. Tracking-параметры и идентификаторы сессий в адресе ломают механизм отслеживания посещённых страниц. Убирайте известные вам шумовые параметры перед добавлением ссылки в очередь.
- Ошибки, обрабатываемые как страницы. 429 или 503 - это просьба сайта замедлиться. Ждите и повторяйте запрос с нарастающей паузой, а не идите дальше:
for attempt in range(4):
    r = session.get(url, timeout=15)
    if r.status_code not in (429, 500, 502, 503, 504):
        break
time.sleep(2 ** attempt)- 200, который не является страницей. Некоторые сайты отвечают на заблокированный запрос нормальным статусным кодом и страницей с просьбой попробовать позже. Проверяйте наличие ожидаемого контента, а не только статус.
Обходите сайты ответственно
Прочитайте robots.txt сайта и его условия использования перед началом работы. Честно идентифицируйте свой краулер, держите частоту запросов настолько низкой, чтобы сайт вас не ощущал, и не собирайте персональные данные, которые вам не нужны. Вежливый краулер живёт дольше, потому что не даёт сайту повода его заблокировать.
FAQ
В чём разница между веб-краулером и веб-скрапером?
Краулер находит страницы, переходя по ссылкам. Скрапер извлекает данные со страницы. Большинство реальных проектов делают и то, и другое: краулят, чтобы найти страницы, и скрапят каждую из них.
Какая Python-библиотека лучше всего подходит для веб-краулинга?
Scrapy - для всего, что вы будете запускать больше одного раза. Для разовой задачи на несколько сотен страниц проще использовать requests с BeautifulSoup. Для кастомной логики на больших объёмах - httpx с asyncio.
Как быстро может работать Python-краулер?
В нашем тесте 6,7 страницы в секунду при одиночных запросах и 54 с десятью конкурентными запросами на сайте без ограничения скорости. На реальном сайте лимит определяется тем, что разрешает сайт, а не тем, что способен Python.
Нужны ли прокси для обхода сайта?
Нет - если это небольшой вежливый обход сайта, который не блокирует. Прокси нужны, когда ваш адрес попадает под ограничение по частоте или блокировку, либо когда нужны результаты из другой страны.
Как обходить сайт, который использует JavaScript?
Рендерите страницы в браузере с помощью Playwright, как в примере выше, и только для тех страниц, которым это необходимо.
Похожие статьи
Reddit «Вы заблокированы сетевой безопасностью»: все причины и решения для каждой
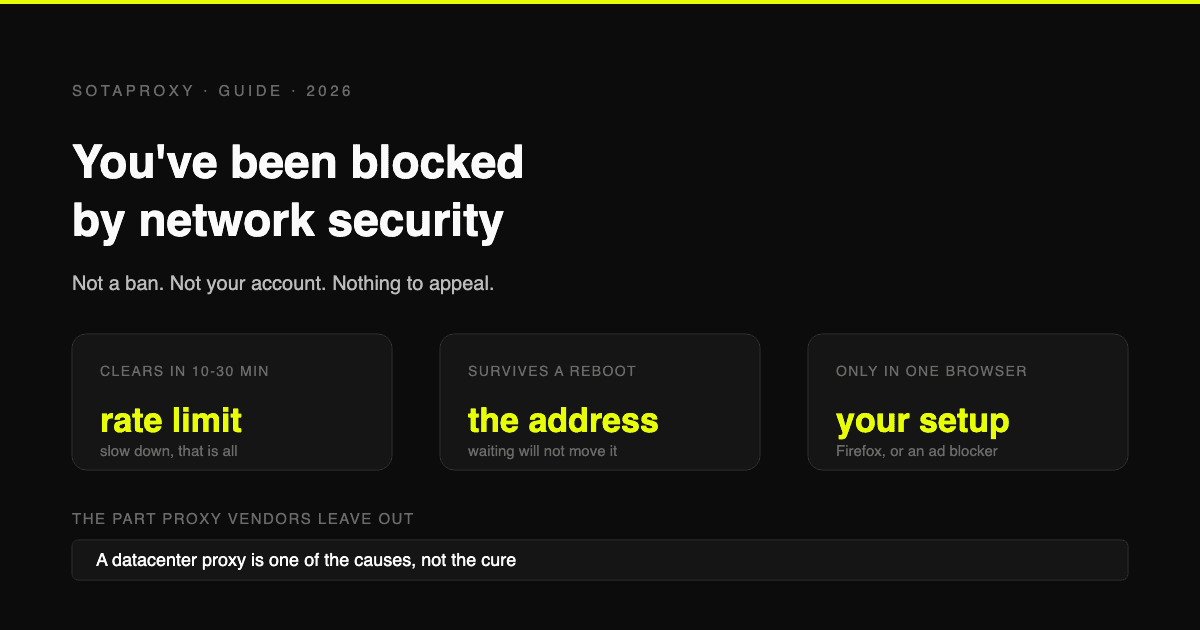
Это не бан, и обжаловать нечего. Блокировка исходит от пограничной инфраструктуры Reddit, применяется к вашему подключению и имеет шесть причин. Вот как определить, какая из них у вас, и как долго длится каждая.
Сколько аккаунтов Discord можно иметь в 2026 году (на email, на телефон, на устройство)
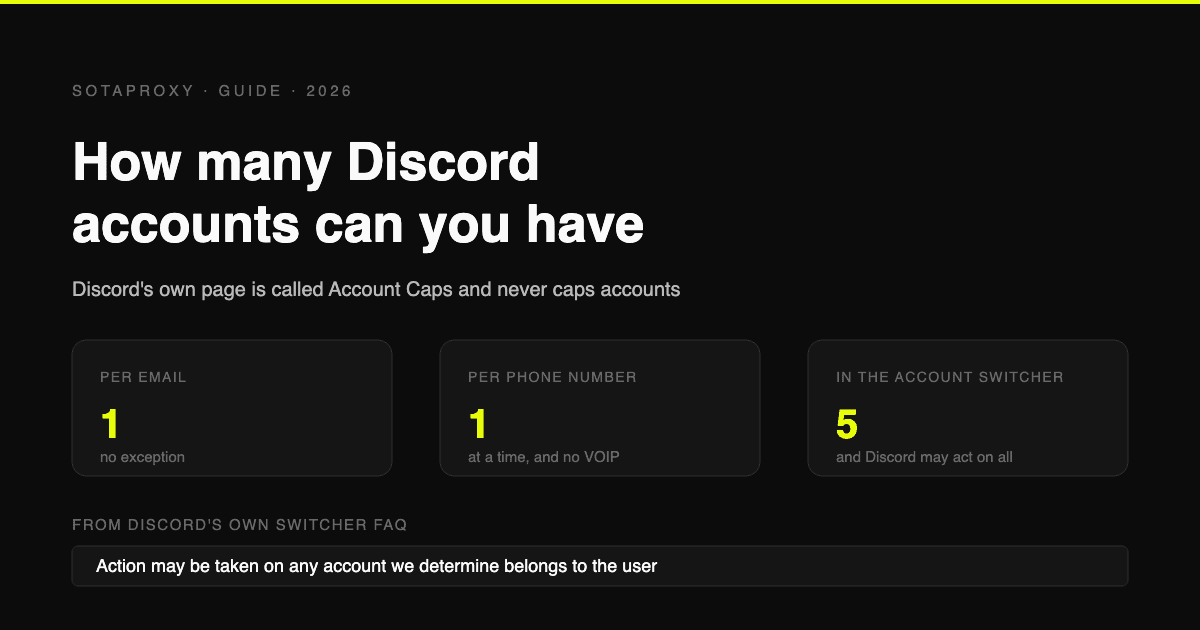
Discord не публикует ограничений на количество аккаунтов. Реальные лимиты: один на email, один номер телефона одновременно без VOIP и пять в переключателе аккаунтов, что Discord может применять глобально.
Telegram-автоматизация с Telegram Expert: что делать, если задача остановилась на середине
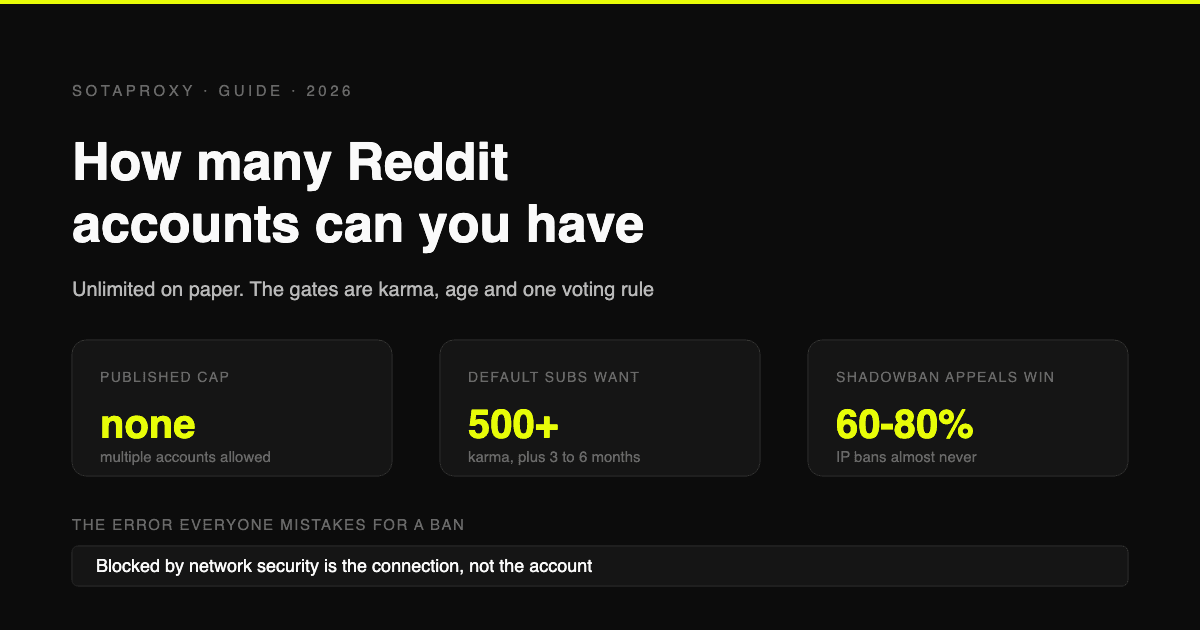
Сколько аккаунтов Reddit можно иметь в 2026 году (ограничения по карме, баны, блокировки сетевой безопасности)
Reddit разрешает иметь несколько аккаунтов напрямую. Что вас останавливает - это ограничения по карме, качество участника, лимиты частоты запросов и одно строгое правило о голосовании, плюс три типа банов, как каждый обжалуется, и почему «заблокировано службой сетевой безопасности» - это не один из них.
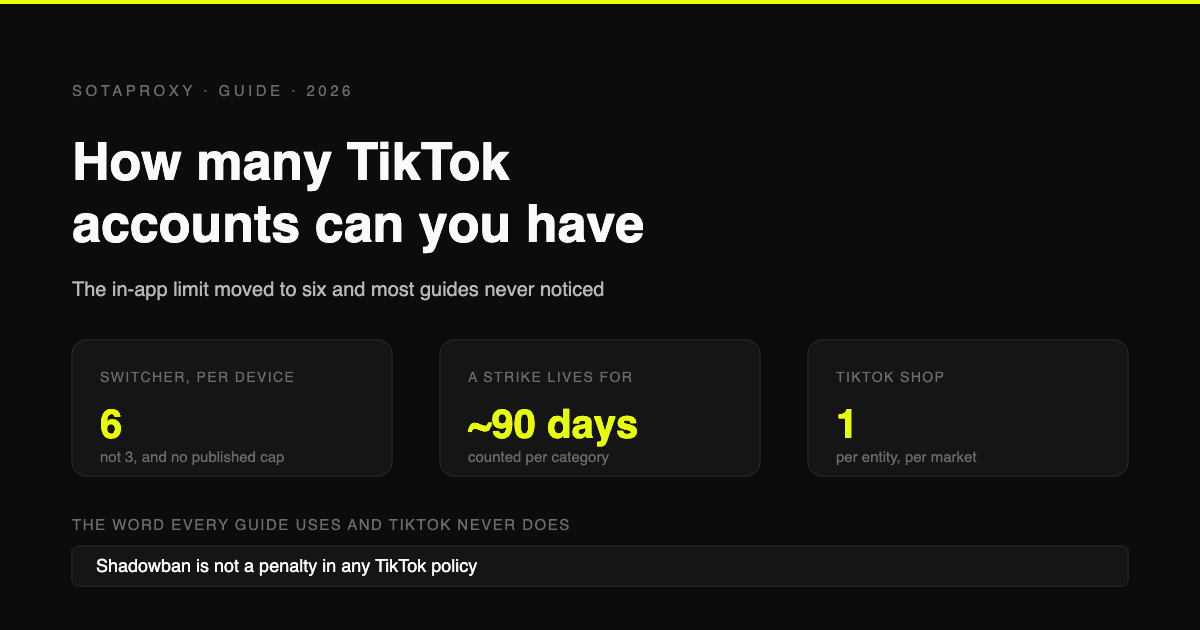
Сколько аккаунтов TikTok можно иметь в 2026 году (лимиты, страйки и правила Shop)
Шесть аккаунтов на устройство, а не три, и без официального ограничения. Правила, которые реально определяют выживание: лимиты действий в зависимости от возраста аккаунта, как истекают страйки, что на самом деле такое shadowban и один Shop на бизнес-субъект на рынок.
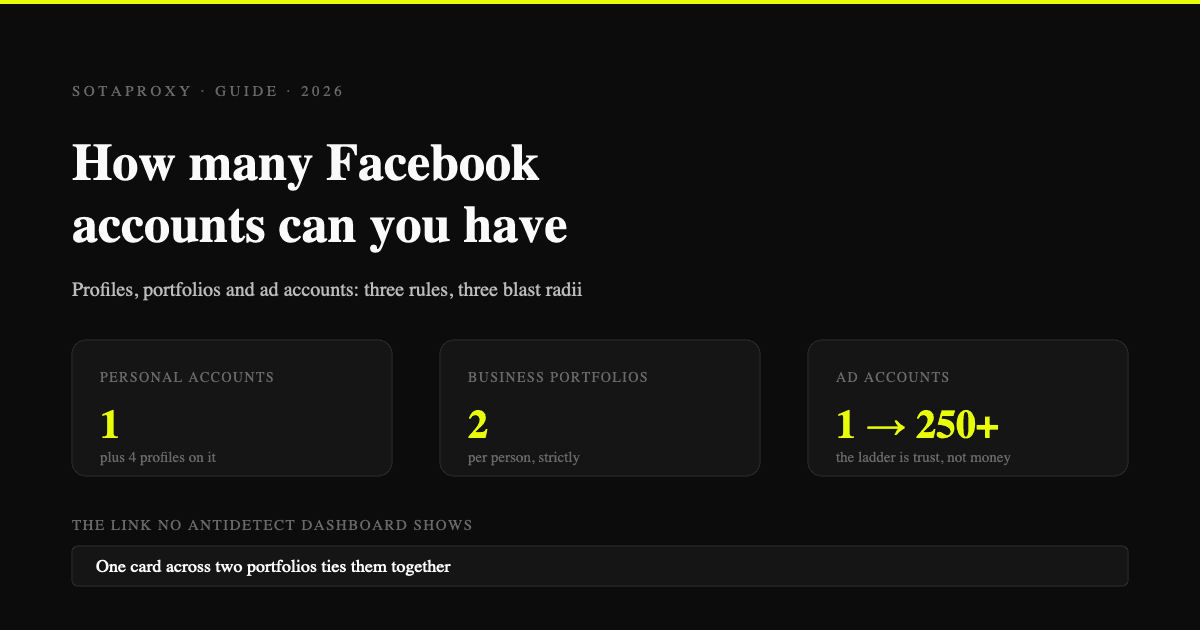
Сколько аккаунтов Facebook можно иметь в 2026 году (профили, портфолио, рекламные кабинеты)
Один личный аккаунт, четыре дополнительных профиля с общими мерами модерации, два бизнес-портфолио на человека и лимит рекламных кабинетов, который растёт с доверием. Что реально ограничивается и в каком порядке.