CSV vs JSON: Практичний посібник для скрейперів та Ad Ops
Порівняння CSV та JSON для технічних команд: структура, швидкість парсингу, вкладені дані та реальний вибір для скрейпінгу, верифікації реклами та автоматизованих конвеєрів.
Багато команд ставлять неправильне питання. CSV проти JSON рідко є однозначним рішенням само по собі, бо формат працює лише тоді, коли він відповідає поточному завданню. Якщо ви запускаєте пайплайни скрейпінгу, завдання з перевірки реклами чи експорти для фармлення акаунтів, ключове дерево рішень - це плоскі таблиці проти вкладених даних, стрімінг проти повного завантаження файлу та візуальний огляд проти машинної обробки.
Ось чому бінарні поради не працюють. CSV досі домінує у плоских табличних експортах, бо RFC 4180 стандартизував загальну модель записів, де кожен рядок містить однакову кількість полів, тоді як JSON-об'єкти можуть відрізнятися за записами й містити вкладену структуру. JSON виграє, коли дані мають ієрархію чи змінні поля. Посередині JSONL часто перемагає обидва для логів і фідів тільки на додавання, а Parquet виграє, коли аналітика й ефективність зберігання важливіші за перегляд сирого тексту.
| Формат | Найкраще підходить | Сильна сторона | Слабке місце |
|---|---|---|---|
| CSV | Плоскі експорти, таблиці, імпорт у SQL | Компактний, легко стрімити, просто порівнювати | Слабкий для вкладеності й змішаних типів |
| JSON | API, вкладені об'єкти, конфігураційні файли | Самоописуваний, гнучка структура | Багатослівний у передачі, повільніше парситься |
| JSONL | Логи, стрімінгові відповіді, фіди тільки на додавання | Обробка рядок за рядком, без повного завантаження файлу | Все ще текст, все ще багатослівний для широких даних |
| Parquet | Сховища, озера даних, великі архіви | Сильне стиснення й ефективність запитів | Не зручний для людей у текстовому редакторі |
Зміст
- Перестаньте питати CSV проти JSON і почніть питати, що вам насправді потрібно
- Структура, схема й типізація поруч
- Розмір, швидкість парсингу та обсяг пам'яті
- Бібліотеки парсингу та фрагменти коду для конвертації
- Вибір формату за використанням у скрейпінгу та рекламних операціях
- Екранування, кодування та пастки безпеки
- Коли JSONL або Parquet перемагають обидва
- Рекомендації за пайплайном і вибором проксі
Перестаньте питати CSV проти JSON і почніть питати, що вам насправді потрібно
Дебати стають заплутаними, бо люди порівнюють CSV і JSON, ніби вони вирішують одну й ту саму проблему. Це не так. CSV - це формат плоских записів. JSON - це формат документів із місцем для вкладених об'єктів, масивів і необов'язкових полів. Якщо ви змушуєте один виконувати роботу іншого, ви в підсумку пишете клей для конвертації, няньчитеся з крайніми випадками й пояснюєте зламані експорти о другій ночі.
Починайте з форми, а не з переваг
Якщо ваше джерело - це рядок на акаунт, рядок на ключове слово чи рядок на подію проксі, CSV зазвичай підходить. Якщо кожен запис містить вкладені креативи, змінні метадані чи граф об'єктів, що змінюється, JSON - це чистіший формат передачі. Якщо джерело - це потік подій, JSONL може уберегти вас від завантаження всього файлу лише для читання рядка 17. Якщо архів призначений для аналітики, Parquet часто є кращим довгостроковим вибором для зберігання, бо колонкові файли підтримують ефективніші подальші запити, ніж рядково-орієнтований текст.
Практичне правило: вибирайте формат за тим, як дані рухаються через пайплайн, а не за тим, що найлегше експортувати із системи-джерела.
Це важливо у рекламних операціях і скрейпінгу, бо та сама команда часто потребує всіх чотирьох форматів у різних місцях. Завдання автоматизації браузера в AdsPower чи Multilogin може видавати структуровані логи. Експорт перевірки реклами з Facebook чи TikTok може чисто згортатися в рядки. Перевірка клоакінгу може створювати вкладені метадані запитів. Завдання для сховища може потребувати стиснутого аналітичного сховища, а не текстового файлу, який хтось відкриває в Excel.
Справжнє дерево рішень
Використовуйте CSV, коли людям потрібна таблиця, коли імпорт у базу даних простий і коли ви хочете компактні експорти. Використовуйте JSON, коли дані вкладені чи змінні. Використовуйте JSONL, коли потрібна обробка тільки на додавання, рядок за рядком. Використовуйте Parquet, коли вихідні дані призначені для аналітики, озер даних чи повторюваних запитів із інтенсивним скануванням. Це дерево рішень корисніше, ніж сперечатися про те, який із двох текстових форматів «кращий». Воно також узгоджується з тим, як сучасні рекомендації з інжинірингу даних розділяють прості експорти, потоковий обмін і аналітичне зберігання на різні категорії, а не на один загальний конкурс форматів файлів.
Структура, схема й типізація поруч
CSV і JSON відрізняються спочатку на рівні форми, потім на рівні схеми, потім на рівні типізації. Це та частина, яку багато хто ігнорує, поки не зламається парсер. CSV дає вам рядки й колонки. JSON дає вам об'єкти й масиви. Один створений для табличних записів. Інший створений для документів.
campaign_id,geo,spend,is_active
1001,US,12.50,true
1002,DE,8.00,false
[
  {"campaign_id": 1001, "geo": "US", "spend": 12.50, "is_active": true},
  {"campaign_id": 1002, "geo": "DE", "spend": 8.00, "is_active": false}
]
Версію CSV легко сканувати, легко імпортувати й легко з'єднувати в SQL. Версія JSON самоописувана, і це важливо, коли ваші записи не всі виглядають однаково. У пайплайні скрейпінгу картка продукту може мати вкладену історію цін, тоді як картка листингу може її не мати. JSON справляється з цим без винаходу порожніх колонок просто для збереження матриці. CSV краще працює, коли кожен рядок повинен мати однакові поля.
| Критерій | CSV | JSON |
|---|---|---|
| Модель даних | Рядки та стовпці | Об'єкти та документи |
| Схема | Неявна, зазвичай зовнішня | Вбудована в структуру |
| Типи | Слабкі, зазвичай переважно рядкові на диску | Нативна підтримка чисел, булевих значень, масивів, об'єктів |
| Вкладені дані | Незручно | Природно |
| Читабельність людиною | Висока для простих таблиць | Висока для малих об'єктів, низька для великих масивів |
| Відповідність електронним таблицям | Відмінна | Погана |
| Відповідність API | Погана | Відмінна |
CSV чітко відповідає робочим процесам електронних таблиць і SQL, оскільки файл вже виглядає як таблиця. JSON відповідає REST API і NoSQL-подібним даним, оскільки записи можуть варіюватися та вкладатися. Ця структурна невідповідність визначає все інше в статті. Якщо ваш кінцевий споживач - це оператор електронних таблиць або завантажувач SQL, CSV зазвичай не заважає. Якщо ваш кінцевий споживач - це API-клієнт або сервіс додатка, JSON зазвичай зменшує тертя.
Для автоматизації на основі проксі ця різниця проявляється негайно. Експорти рекламних акаунтів часто починаються як плоскі таблиці. Логи автоматизації браузера з інструментів, таких як AdsPower, Dolphin Anty, GoLogin, Multilogin або Hidemyacc, часто містять вкладені метадані, які CSV не може представити без рішень про згладжування, про які ви пошкодуєте пізніше. Формат, що відповідає формі даних, заощаджує роботу з очищення пізніше, і саме цю частину команди відчувають у продакшені.
Для ширшого робочого процесу автоматизації управління акаунтами цей посібник з автоматизації проксі знаходиться в тому ж практичному просторі, що й вибір формату, оскільки обробка форматів і обробка трафіку зазвичай збоять разом.
Розмір, Швидкість Парсингу та Споживання Пам'яті
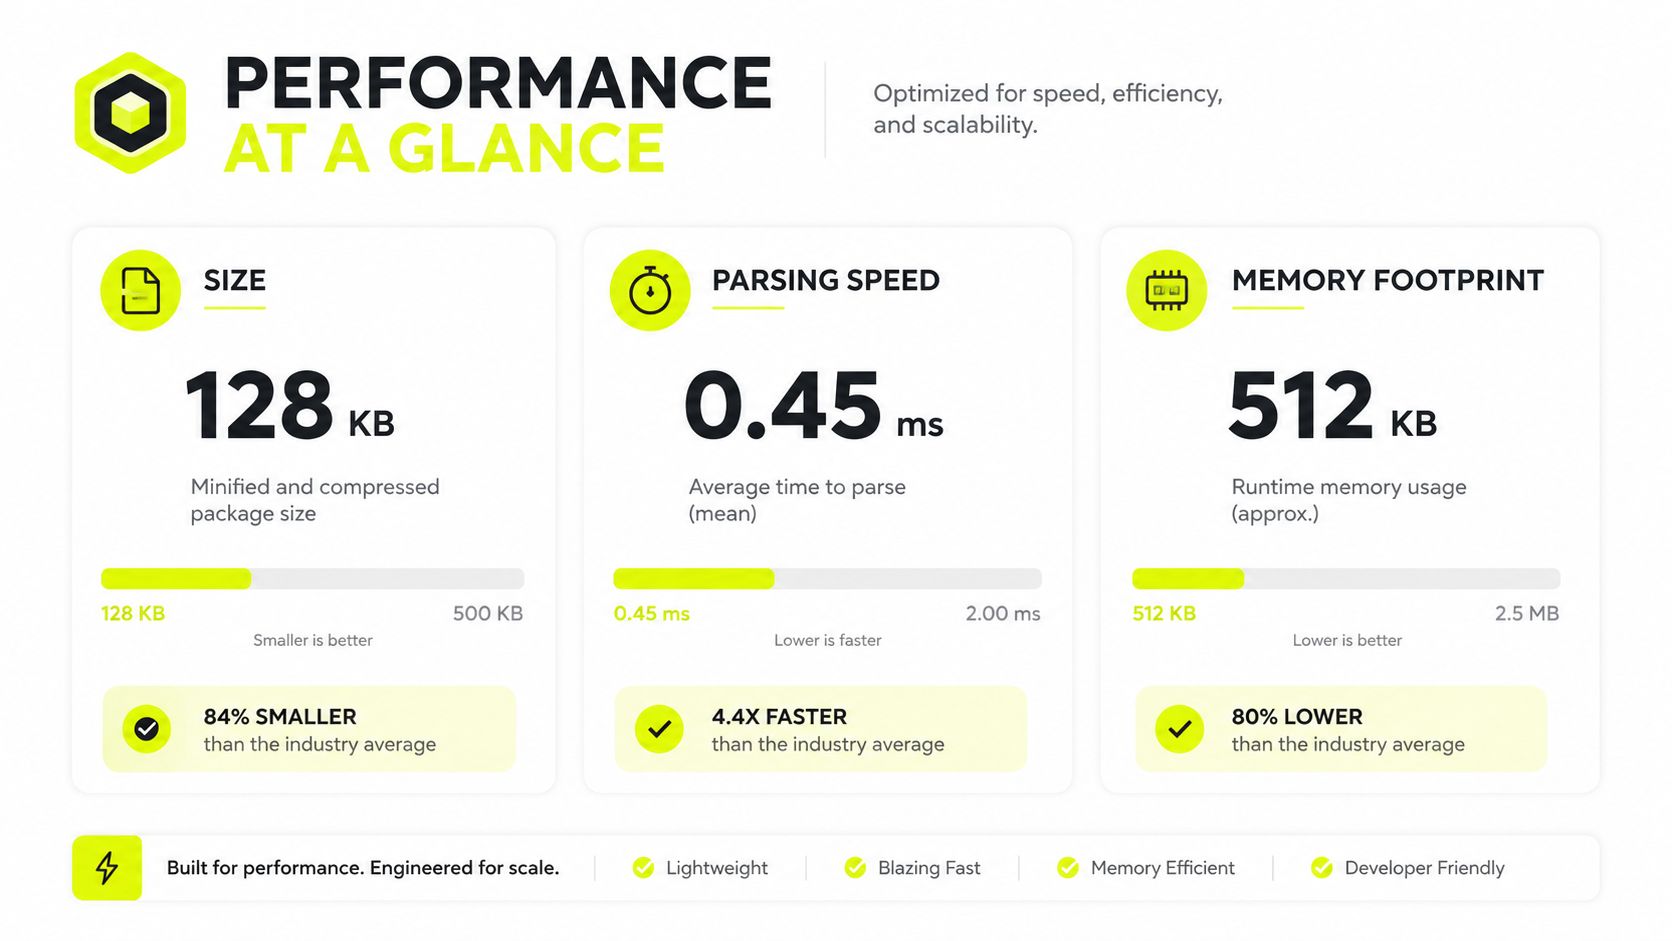
На плоских потоках даних CSV зазвичай перемагає, оскільки залишається меншим і дешевшим для парсингу. Одне опубліковане порівняння на наборі даних з 1 мільйона рядків і 10 стовпцями показало CSV об'ємом 85 МБ і часом парсингу 2,3 секунди при 120 МБ пам'яті проти JSON об'ємом 210 МБ, 5,8 секунди та 340 МБ пам'яті. Той самий бенчмарк також показав швидший парсинг CSV у JavaScript, Python і Java на наборі даних з 100 000 рядків, з утриманням розриву в кожній мові. Цей розрив швидко проявляється в скрейпінгових воркерах, процесорах логів проксі та завданнях обробки фідів кампаній, які працюють цілий день.

Чому CSV зазвичай перемагає на плоских потоках даних
CSV залишається компактним, оскільки не повторює назви полів у кожному рядку. JSON повторює ключі та додає фігурні дужки, квадратні дужки та лапки для кожного запису. Незалежні порівняння часто показують реальні файли JSON у 1,5–3 рази більшими, ніж еквівалентні файли CSV для порівнянних плоских даних, і один часто цитований приклад показує набір даних з 10 000 рядків приблизно 1 МБ як CSV проти 2,5 МБ як JSON. Ця різниця - це накладні витрати на корисне навантаження, а не магія парсера.
Ці накладні витрати мають значення для геотаргетованих фідів кампаній і масових експортів фермерства акаунтів. Кожен додатковий байт все одно повинен пройти через шари зберігання, мережі та парсингу. Якщо ви живите чергу, виконавця завдань або завантажувач сховища, CSV зазвичай дає вам менше тертя. Якщо ви надсилаєте вкладені об'єкти через API, JSON виправдовує своє існування читабельністю та структурою.
Практичне правило: для плоских таблиць використовуйте CSV за замовчуванням, якщо вкладеність або сумісність із наступним ланцюгом не дають вам причини цього не робити.
Стиснення змінює математику
Стиснення звужує розрив, оскільки повторювані ключі JSON добре стискаються. Одне порівняння показує різницю після стиснення приблизно 10–20%. Це не усуває перевагу CSV, але змінює економіку для архівних файлів і довгострокового зберігання. Коли файл знаходиться за gzip-подібним стисненням, сире покарання при передачі зменшується настільки, що ясність схеми може мати більше значення, ніж кількість байтів.
Для конвеєрів науки про дані той самий патерн проявляється і у використанні токенів. Набір даних, орієнтований на LLM, з приблизно 5000 комірок використовував на 56,20% менше токенів у CSV, ніж у JSON, одночасно покращуючи точність і затримку в цьому тесті. Це вузький бенчмарк, але він все одно вказує на той самий операційний результат - плоскі текстові таблиці дешевші для споживання, коли дані плоскі.
Для ширшого розбору компромісів пропускної здатності краулінгу посібник з краулінгу на Python є корисним доповненням до цього рішення щодо формату, оскільки обсяг краулінгу та формат файлу зазвичай стикаються з тими ж вузькими місцями.
Бібліотеки Парсингу та Фрагменти Коду Конвертації
Стандартної бібліотеки Python достатньо для базової роботи в продакшені. Для CSV csv.DictReader і csv.DictWriter покривають більшість плоских експортів. Для JSON json.load, json.dump, json.loads і json.dumps обробляють стандартні випадки. У Node люди зазвичай звертаються до Papa Parse або csv-parse на стороні CSV. У Java OpenCSV є звичайною відправною точкою, коли вам потрібна пряма обробка табличних даних.
Мінімальне читання та запис у Python
import csv
import json

# Читання CSV
with open("input.csv", newline="", encoding="utf-8") as f:
    rows = list(csv.DictReader(f))

# Запис CSV
with open("output.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["campaign_id", "geo", "spend"])
    writer.writeheader()
    writer.writerow({"campaign_id": "1001", "geo": "US", "spend": "12.50"})

# Читання JSON
with open("input.json", encoding="utf-8") as f:
    payload = json.load(f)

# Запис JSON
with open("output.json", "w", encoding="utf-8") as f:
    json.dump(payload, f, ensure_ascii=False, indent=2)
Підступність у тому, що наївна конвертація csv.DictReader в json.dump перетворює все на плоскі рядки, якщо ви явно не приводите типи. Це також втрачає вкладені масиви, якщо ви вже погано згладили їх вище за потоком. Ось так команди отримують зламані булеві значення, рядки дат всюди та "таємничо" відсутню структуру після кроку конвертації.
Чиста конвертація CSV у JSON з вкладеними полями
import csv
import json

def parse_tags(value):
    return [x.strip() for x in value.split("|") if x.strip()]```html
records = []
with open("input.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        records.append({
            "campaign_id": int(row["campaign_id"]),
            "geo": row["geo"],
            "spend": float(row["spend"]),
            "flags": {
                "active": row["is_active"].lower() == "true",
                "tags": parse_tags(row.get("tags", "")),
            }
        })

with open("output.json", "w", encoding="utf-8") as f:
    json.dump(records, f, ensure_ascii=False, indent=2)
Цей підхід кращий, оскільки ви визначаєте типи перед серіалізацією. Він також робить конвертацію явною, що допомагає, коли експорти з фармінгу акаунтів або логи перевірки реклами мають пройти кілька етапів обробки. Для практичного шляху інтеграції з Python цей довідник налаштування відповідає тому самому продакшн-підходу.
Вибір формату за сценарієм використання у скрейпінгу та рекламних операціях
Правильна відповідь залежить від типу завдання. Масовий скрейпінг-фід - це не те саме, що звіт про перевірку реклами, і жоден з них не поводиться як експорт з антидетект-браузера або потік логів проксі. Вибір одного формату для всього зазвичай створює зайві конвертації пізніше.
Масові веб-скрейпінг фіди
Використовуйте CSV, коли скрейпінг видає рядки зі стабільним набором колонок. Фіди продуктів, знімки цін, експорти пошукової видачі та списки лідів зазвичай відповідають цьому шаблону. CSV легше сканувати, легше порівнювати, і менш болісно завантажувати в базу даних чи таблицю.
Якщо скрейпер видає сторінки змішаних даних або потокові події, використовуйте JSONL замість одного JSON-масиву. Це дає вам порядковий парсинг, що краще підходить для довготривалих обходів. Внутрішнє посилання сценарії використання веб-скрейпінгу тут релевантне, оскільки формат файлу та стратегія проксі зазвичай налаштовуються разом.
Звіти перевірки реклами для Facebook і TikTok
Використовуйте JSON, коли звіт включає вкладені метадані креативів, дані розміщень або змінні об'єкти кампаній. Плоскі знімки витрат все ще можуть зберігатися в CSV, особливо коли медіабайерам потрібні швидкі фільтри в Excel або Google Sheets. Важливо не сплющувати вкладені дані креативів лише заради звички працювати з таблицями.
Експорти фармінгу акаунтів для антидетект-браузерів
Для AdsPower, Dolphin Anty, GoLogin, Multilogin і Hidemyacc, CSV зазвичай найкраще працює для масових експортів профілів, відстеження статусу профілів та аркушів передачі. Файл зазвичай орієнтований на рядки, і оператори часто хочуть сортувати, фільтрувати та реімпортувати його без додаткових інструментів. Тримайте кодування суворим, а список колонок стабільним. Фармінг акаунтів швидко ламається, коли "невелика" зміна формату поширюється через спільний аркуш.
Приймання логів проксі
Для високонавантажених логів проксі JSONL або Parquet зазвичай має більше сенсу, ніж звичайний JSON або CSV. JSONL підтримує додавання логів у кінець. Parquet сильніший, коли архів логів перетворюється на проблему запитів до сховища даних. Якщо ви використовуєте резидентські або мобільні проксі для чутливих до довіри завдань, або дата-центри та IPv6 для чистої пропускної здатності, формат файлу має відповідати тій самій операційній меті. Для архітектурної сторони цього рішення цей посібник ETL проти ELT є гарним доповненням.
Екранування, кодування та пастки безпеки
CSV ламається неприємними способами, коли текстові поля містять коми, переноси рядків або лапки. JSON ламається, коли припущення про кодування розходяться, і парсер отримує ворожий або некоректний текст. Обидва формати можуть вибухнути в продакшні, якщо ви ставитеся до них як до "просто тексту" і пропускаєте валідацію.
Пастки CSV, які постійно з'являються
Вбудована кома в назві кампанії може зрушити колонки. Перенос рядка в полі нотаток може розділити один рядок на два. Змішані конвенції цитування можуть зробити файл нечитабельним для одного парсера і "нормальним" для іншого.
- Вбудовані коми та лапки: використовуйте справжній CSV-writer, а не конкатенацію рядків.
- Переноси рядків всередині полів: завжди відкривайте файли з явною обробкою нових рядків і правильно цитуйте поля.
- CSV-ін'єкція: додайте префікс до ризикованих формул електронних таблиць з безпечною стратегією екранування, перш ніж хтось відкриє файл в Excel.
Пастки JSON, які важливі в автоматизації
JSON суворіший щодо структури, але він не захищений від збоїв у продакшні. Припущення щодо UTF-8 все ще можуть порушитися, коли upstream-системи видають некоректні байти. Великі дані також можуть викликати навантаження на пам'ять, якщо ви завантажуєте їх повністю замість потокової обробки.
Парсіть ворожі дані так, ніби вони створені для того, щоб зламати ваш парсер, тому що рано чи пізно хтось дасть вам саме такий файл.
Пастка потокової обробки тут важлива. Файл, який виглядає прийнятним за розміром, все одно може вбити воркер, якщо ви примусово завантажите його повністю в пам'ять. Так скрейпінг перетворюється на OOM-краш. Використовуйте потокові парсери, розбиття на частини або формат, орієнтований на рядки, коли джерело може зростати без попередження.
Для корисного суміжного посилання щодо обробки потоків, вибір між Yellowstone gRPC і розібраними потоками Solana демонструє той самий інженерний інстинкт, а саме вибір транспорту та стратегії парсингу разом, а не окремо.
```Коли JSONL або Parquet краще за обидва
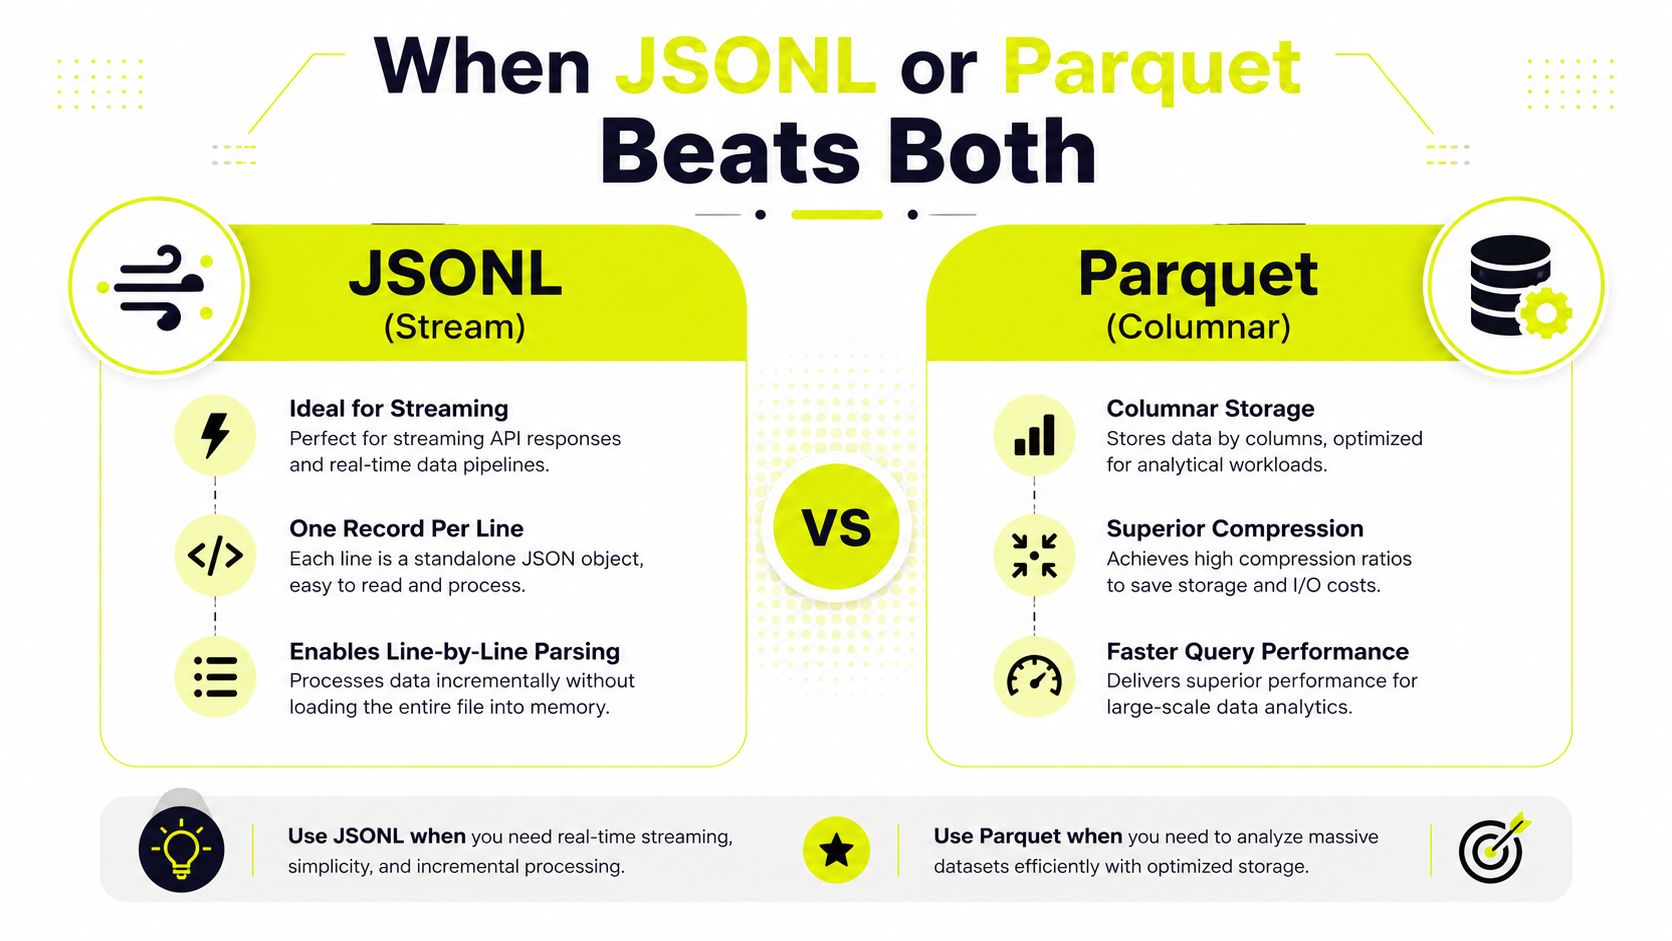
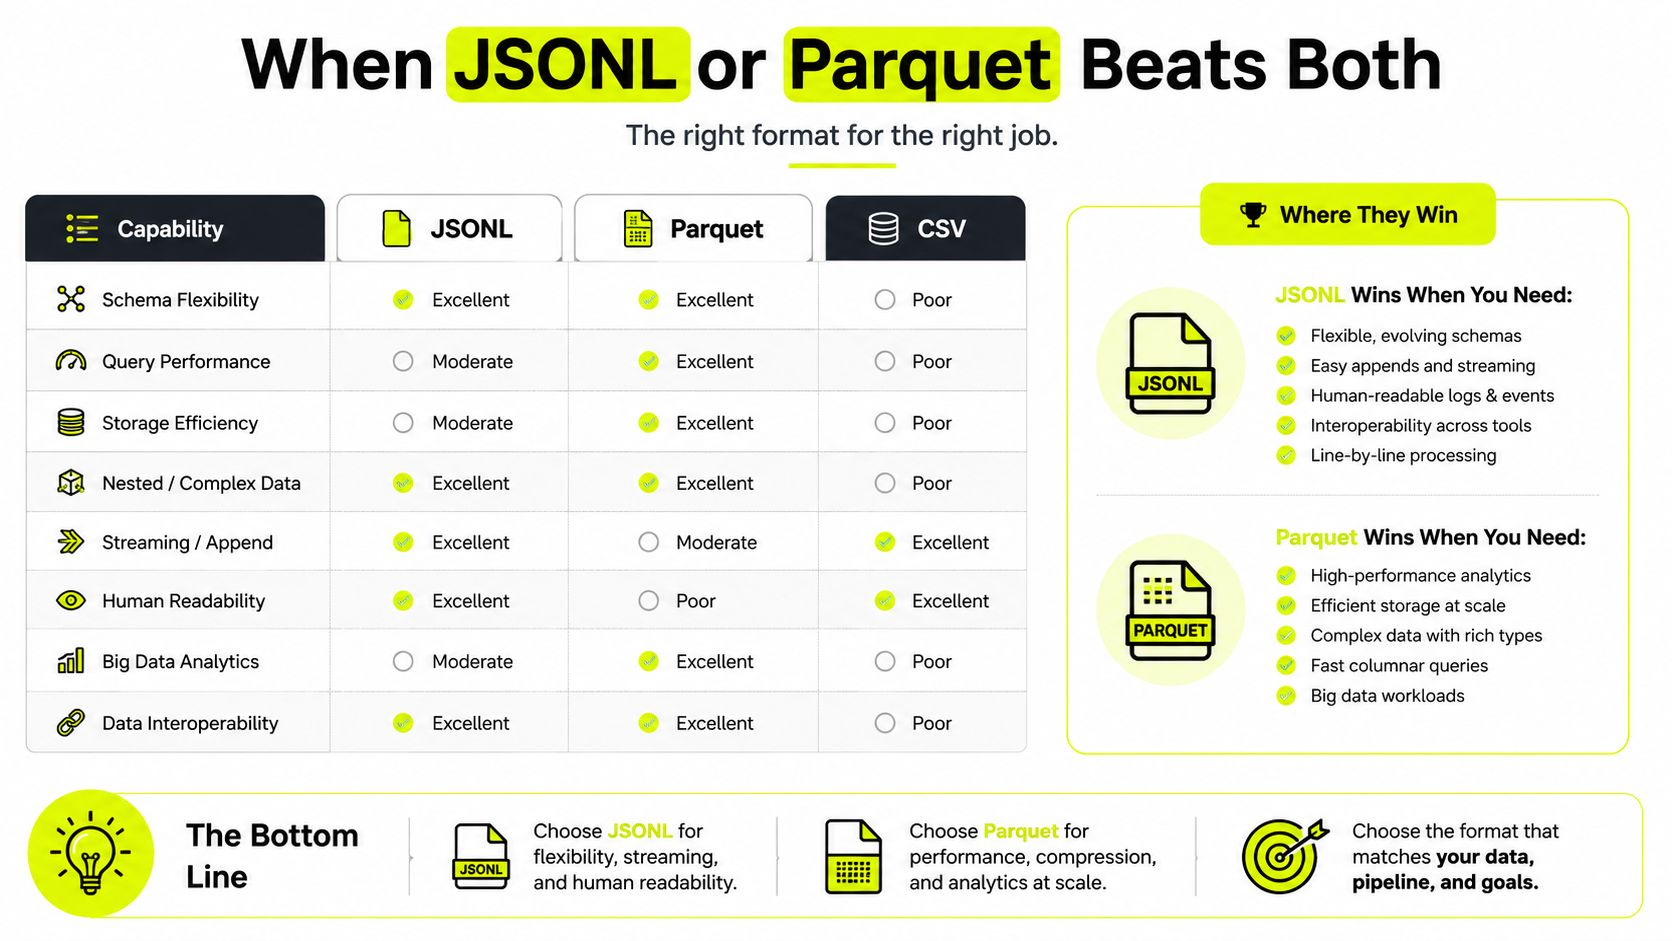
CSV та JSON використовують надто часто, бо вони знайомі, а не тому, що вони завжди правильні. Коли дані перетворюються на потік або завантаження для сховища, кращою відповіддю часто є ні те, ні інше. JSONL вирішує проблему "мені потрібно додавати та читати по одному запису за раз". Parquet вирішує проблему "мені потрібне компактне зберігання та швидке аналітичне сканування".
JSONL для потоків та логів
JSONL зберігає один JSON-об'єкт на рядок. Це робить його ідеальним для конвеєрів логів, потокових відповідей API та стрічок з додаванням. Вам не потрібно завантажувати весь файл перед початком обробки, і ви можете відновити частковий прогрес після збою без повторного відтворення гігантського масиву.
Parquet для аналітики
Parquet - це стовпчастий формат. Ось чому він краще підходить для аналітичних сховищ, озер даних та великих архівів скрейпінгу, ніж текстові файли, орієнтовані на рядки. Стовпчасте зберігання забезпечує кращу компресію та поведінку запитів, коли ви постійно скануєте одні й ті самі поля у великих наборах даних. Останні рекомендації з інженерії даних розглядають Parquet як формат зберігання, до якого слід звертатися, коли ефективність та масштаб важливіші за читабельність для людини.
Правило просте. Експорт з електронної таблиці або SQL - виберіть CSV. REST API або вкладена конфігурація - виберіть JSON. Потокові логи або стрічки з додаванням - виберіть JSONL. Аналітичне сховище - виберіть Parquet. Це відображення кориснiше, ніж робити вигляд, що CSV та JSON покривають усі серйозні завантаження.
Рекомендації за конвеєром та вибором проксі
Конвеєри скрейпінгу повинні починатися з формату, який відповідає режиму збою, який ви бачите в продакшені. Для плоских стрічок CSV все ще найпростіший вибір, оскільки оператори можуть відкрити його, відфільтрувати та передати без додаткового коду парсингу. Коли стрічка перетворюється на потік, або записи надходять по одному і потребують безпечного при перезапусках прийому, JSONL - чистіше рішення. Якщо вихід призначений для зберігання в сховищі, а не для швидкого звіту, Parquet зазвичай варто розглянути, перш ніж фіксувати текстовий архів.
Для звітів верифікації реклами у Facebook та TikTok використовуйте JSON для вкладених креативів, розміщень та деталей аудиту, і залишайте CSV для плоских знімків витрат або статусу. Такий поділ зберігає структуру там, де це важливо, і уникає змушування кожного споживача далі по ланцюгу проходити дерево документа лише для читання кількох полів. Це також залишає медіа-байєрів у електронних таблицях для частин, які вони переглядають щодня.
Для експорту фармінгу акаунтів в AdsPower, Dolphin Anty, GoLogin, Multilogin та Hidemyacc CSV із строгим кодуванням UTF-8 є практичним стандартом. Ці завдання базуються на рядках, і люди, які з ними працюють, зазвичай хочуть щось, що можна сортувати, імпортувати та передавати далі без спеціальних інструментів. Якщо експорт повертається до автоматизації, тримайте схему вузькою, стабільною та нудною. Якщо вам також потрібно налаштувати транспортний шар, спочатку налаштуйте шар проксі, а потім підлаштуйте формат файлу навколо нього.
Для логів проксі JSONL працює краще, коли логи активно доповнюються і потребують парсингу рядок за рядком. Parquet виграє, коли архів стає проблемою аналітики, і швидкість сканування важливіша за читабельність для людини. Резидентські або мобільні проксі підходять для робочих процесів, які залежать від сигналів довіри, особливо в клоакінгу або роботі з великою кількістю акаунтів. Дата-центрові та IPv6 проксі мають більше сенсу, коли пропускна здатність та ротація важливіші за схожість на споживчу мережу.
Якщо ви будуєте партнерський робочий процес навколо інфраструктури проксі, виберіть архітектуру вашого конвеєра даних, перш ніж вирішувати, як файли переміщуються через нього. Ті самі команди, що займаються скрейпінгом, верифікацією реклами та робочими процесами з багатьма акаунтами, часто потребують стабільного постачання проксі, і погане поєднання формату та транспорту швидко перетворюється на безладні повторні спроби. Тримайте шар проксі та шар даних узгодженими, незалежно від того, чи використовуєте ви резидентські, мобільні, дата-центрові, ISP або IPv6 опції.
Схожі статті

7 методів збору даних для медіабаєрів та фармерів акаунтів
Дізнайтеся про найкращі методи збору даних для медіабаєрів. Навчіться використовувати скрейпінг, API та опитування для рекламних акаунтів, фармінгу облікових записів та гео-таргетингу.

7 бюджетних варіантів проксі-серверів у 2026 році
Огляд бюджетних варіантів проксі-серверів. Технічний посібник по дешевих дата-центрових, резидентних та IPv6 тарифах для арбітражу трафіку, скрейпінгу та фармінгу акаунтів.
Таргетинг за поштовими індексами для рекламних кампаній: практичний посібник
Таргетинг за поштовими індексами для медіабаєрів та команд трафік-арбітражу. Охоплює налаштування проксі, правила рекламних платформ, ризики виявлення та найкращі практики.

Цілодобова підтримка клієнтів: що насправді потрібно операторам
Цілодобова підтримка клієнтів для операторів проксі та автоматизації. KPI, SLA, питання до постачальників та реальні процеси ескалації, які скорочують час простою.
Що таке прямий проксі: повний посібник на 2026 рік
Дізнайтеся, що таке прямий проксі, як він працює для вихідного трафіку та чому команди використовують його з антидетект-браузерами для Facebook, TikTok і скрейпінгу.

Bing Search API ключ: налаштування, тестування та масштабування у 2026 році
Отримайте робочий Bing Search API ключ у 2026 році, тестуйте запити, захистіть ключ та масштабуйте високонавантажений скрейпінг без блокувань. Практичний посібник для технічних команд.