Освоєння XML та Python для автоматизації рекламних акаунтів
Навчіться опановувати XML та Python для ad tech. Цей посібник показує, як парсити, запитувати та модифікувати XML для рекламних акаунтів Facebook/TikTok та фармінгу акаунтів.
Ви завантажуєте фід з партнерської мережі, очікуєте чистий список продуктів, а отримуєте роздутий XML-документ із вкладеними офферами, гео-правилами, параметрами трекінгу та напівдокументованими полями. Потім вам потрібно передати ці дані у робочі процеси Facebook і TikTok, розділити креативи за країнами, синхронізувати налаштування на рівні акаунта через AdsPower або Multilogin і підтримувати стабільність усього цього у десятках або сотнях профілів.
Ось де XML та Python все ще мають значення. Не в ностальгічному, застарілому сенсі. У практичному, виробничому. Команди арбітражу трафіку все ще зустрічають XML у партнерських фідах, SOAP-ендпоінтах, експортах з офісних програм, підписаних корпоративних даних та конфігураційних файлах, пов'язаних із стеками автоматизації. Якщо ви керуєте рекламними акаунтами, налаштуваннями фармінгу акаунтів, правилами клоакінгу або геотаргетованими кампаніями, вам потрібен парсер, який не розвалиться, коли фід стане дивним.
Python все ще залишається одним із найчистіших способів впоратися з цією роботою. Його вбудовані інструменти XML дають вам достатньо можливостей для парсингу, модифікації та запису XML без додавання залежностей для базових завдань, а його ширша екосистема надає потужніші опції, коли фіди стають великими, запити складнішими, або вхідним даним не можна довіряти.
Зміст
- Чому вам все ще потрібно освоїти XML у 2026 році
- Вибір правильного Python XML-парсера
- Парсинг та запити XML-даних за допомогою XPath
- Модифікація та запис XML для завдань автоматизації
- Оптимізація продуктивності за допомогою стрімінгу та проксі
- Безпечна обробка XML та найкращі практики
Чому вам все ще потрібно освоїти XML у 2026 році
Байєр запускає кампанію о 2 ночі. Ставки актуальні, креативи схвалені, і логіка таргетингу виглядає чисто у вашій панелі. Потім партнерський фід оновлюється в XML, одне вкладене поле зміщується, і половина правил у вашому ланцюжку автоматизації перестає збігатися. Це все ще нормально в ad tech.
Команди арбітражу успадковують XML через старі партнерські системи, compliance-ендпоінти, експорти біллінгу, шаблони профілів пристроїв і SOAP API, які так і не замінили. JSON керує багатьма сучасними інструментами, але системи навколо нього часто все ще говорять XML. У трафік-арбітражі це зазвичай означає одну Python-роботу, що витягує метадані офферів, іншу, що переписує конфіги акаунтів або браузерів, і третю, що валідує гео-правила або правила редиректів перед тим, як витрати стануть активними.
Команди, які добре з цим справляються, розглядають XML як операційну залежність, а не застарілу цікавість. Якщо ви керуєте налаштуваннями з багатьма акаунтами, робочими процесами фармінгу акаунтів, шарами клоакінгу або запусками кампаній на основі фідів, помилки XML не є академічними. Вони призводять до поганих редиректів, зламаного маппінгу виплат, неправильного таргетингу країн і тихого дрейфу конфігів у десятках або сотнях акаунтів.
Де XML все ще з'являється в рекламних операціях
У виробництві XML зазвичай з'являється в кількох повторюваних місцях:
- Партнерські фіди: каталоги офферів, кепи, зміни виплат, блоки країн і правила конверсій.
- Інфраструктура акаунтів: експорти браузерних профілів, шаблони автоматизації, конфіги запуску та специфічні налаштування інструментів.
- Compliance та верифікація: знімки перевірок, карти редиректів, локалізовані перевірки контенту та аудиторські пейлоади.
- Застарілі конектори: SOAP-сервіси, підписані дані ідентичності, фінансові експорти та внутрішні системи, які так і не перейшли на JSON.
AWS зазначає, що XML все ще широко використовується для обміну даними між системами, публікації та конфігураційних робочих процесів у своєму огляді XML. Це відповідає щоденним рекламним операціям. XML виживає там, де дисципліна схеми, сумісність і передбачувана вкладеність все ще важливіші за уподобання розробників.
Ручна обробка XML швидко ламається. Швидкий патч через регулярний вираз працює один раз, потім не спрацьовує на просторах імен, повторюваних вузлах, змішаному контенті або відсутньому опціональному полі від одного партнера. Я бачив, як дрібні помилки фідів каскадом переростали в помилки розподілу витрат, які діагностувалися довше, ніж можна було запобігти їм належним парсингом та валідацією.
Python залишається корисним тут, тому що він дозволяє командам швидко створювати процесори фідів, трансформери конфігів та завдання валідації для реальних операцій. Для груп арбітражу, що витягують фіди через ротаційну інфраструктуру, збір - це лише одна частина конвеєра. Парсинг має бути настільки ж надійним. Команди, які вже працюють із ротацією проксі IP для робочих процесів автоматизації, зазвичай вчаться цьому після того, як перша робота віддаленого фіду успішна на рівні мережі і не вдається всередині крихкого XML-парсера.
Практичне правило просте. Якщо зовнішні фіди впливають на торги, маршрутизацію, налаштування акаунтів або логіку клоакінгу, XML належить до вашого базового набору навичок.
Вибір правильного Python XML-парсера
Не кожне XML-завдання заслуговує однакового парсера. Правильний вибір залежить від розміру файлу, складності запитів, рівня довіри до джерела та того, як часто виконується скрипт.
Для багатьох робіт ElementTree достатньо. Вбудована підтримка XML у Python зробила його мовою за замовчуванням для XML-скриптингу, тому що ви можете парсити, обходити, витягувати та писати XML без сторонніх пакетів, як описано в документації Python для ElementTree. Це корисно, коли вам потрібен скрипт, який можна розгорнути де завгодно на фарм-боксі, campaign runner або вузлі управління з мінімальними залежностями.
Вибір парсера за навантаженням
RealPython розрізняє push-парсинг з xml.sax і pull-парсинг з xml.etree.ElementTree, зазначаючи, що pull-парсинг може показувати до 35% вищу ефективність продуктивності для складних наборів даних і є критичним для обробки багатогігабайтних файлів без переповнення пам'яті в demanding-робочих процесах, як описано в його посібнику з Python XML-парсера. Для команд арбітражу це різниця між парсером, який переживає брудні партнерські фіди, і тим, що стає вузьким місцем.
Ось практичне порівняння.
| Бібліотека | Найкраще для | Ключова перевага | Основний недолік |
|---|---|---|---|
xml.etree.ElementTree |
Стандартний парсинг фідів, редагування конфігів, базова автоматизація | Вбудований у Python і легкий у розгортанні | Обмежена підтримка XPath та менше розширених функцій |
lxml |
Важкі запити, великі складні фіди, документи з багатьма просторами імен | Сильна підтримка XPath та зрілий набір функцій | Додаткова залежність і більше дисципліни налаштування |
xmltodict |
Невеликі конфігураційні файли та швидкі трансформації | Швидко перетворює простий XML у dict-подібні структури | Розвалюється, коли структура стає глибокою або змішаний контент стає безладним |
Де кожен парсер працює добре
ElementTree є за замовчуванням, коли робота проста. Прочитайте фід. Витягніть теги. Оновіть значення. Запишіть файл назад. Це гарний варіант для редагування гео-правил у конфігурації клоакінгу, завантаження шаблонів акаунтів або трансформації партнерського експорту перед передачею в інший внутрішній інструмент.
lxml - це те, що я б використовував, коли важлива логіка вибору. Якщо вам потрібен XPath, який може націлюватися на конкретний набір кампаній, збігатися з вкладеними атрибутами або чисто обробляти простори імен, lxml економить час. Це важливо, коли один XML-документ містить багато маппінгів рекламних акаунтів Facebook і TikTok, варіанти креативів, правила лендингів і перевизначення ставок для конкретних гео.
xmltodict зручний для невеликих файлів, де структура XML передбачувана, і ви хочете негайно отримати доступ у стилі словника. Це добре для легких налаштувань. Я б не довіряв цьому для складного фіду, який керує витратами.
Якщо фід контролює гроші, схвалення, редиректи або стан акаунта, використовуйте парсер, який робить структуру явною. Зручність перестає бути перевагою, коли починається налагодження.
Є також аспект робочого процесу. Команди, які вже роблять Python web crawling для збору даних, часто намагаються трактувати XML-фіди як напівструктурований текст. Це працює до тих пір, поки не з'являться простори імен, повторювані споріднені теги або глибока вкладеність. XML - це не скрапінг HTML. Він винагороджує суворішу обробку.
Просте правило рішення допомагає:
- Використовуйте
ElementTreeдля вбудованої надійності та розгортання без залежностей. - Використовуйте
lxml, коли важлива точність XPath і краща ергономіка XML. - Використовуйте
xmltodictтільки для невеликих, простих, надійних вхідних даних.
Уникайте xml.sax, якщо ви вже не знаєте, чому вам потрібні колбеки, керовані подіями. Для більшості автоматизації ad-tech він додає складність без достатньої переваги.
Парсинг та запити XML-даних за допомогою XPath
Команда трафік-арбітражу зазвичай помічає погану логіку вибору XML у найгірший можливий час. Партнерський фід надходить за хвилини до запуску, один XPath пропускає простір імен, половина німецьких кампаній ніколи не маршрутизується до правильного пулу акаунтів, і оператор бачить це тільки після початку витрат.
XPath - це те, що утримує це від перетворення на ручну роботу з очищення. Він дозволяє Python вибирати точно ті вузли, що керують маршрутизацією, призначенням акаунтів, перевірками ставок і правилами клоакінгу, без написання вкладених циклів для кожного варіанта фіду.
Реалістичний приклад фіду кампанії
Припустимо, партнер або внутрішній генератор дає вам XML, подібний до цього:
from lxml import etree

xml_data = """
<campaigns>
    <campaign id="fb-de-01" platform="facebook" status="active">
        <geo>DE</geo>
        <account>farm_batch_12</account>
        <creative>
            <name>de_video_a</name>
            <bid>1.80</bid>
        </creative>
    </campaign>
    <campaign id="tt-us-02" platform="tiktok" status="paused">
        <geo>US</geo>
        <account>farm_batch_22</account>
        <creative>
            <name>us_ugc_b</name>
            <bid>1.20</bid>
        </creative>
    </campaign>
    <campaign id="fb-de-03" platform="facebook" status="active">
        <geo>DE</geo>
        <account>agency_pool_4</account>
        <creative>
            <name>de_static_c</name>
            <bid>1.55</bid>
        </creative>
    </campaign>
</campaigns>
"""

root = etree.fromstring(xml_data)
Тепер запитайте його за допомогою XPath:
germany_campaigns = root.xpath("//campaign[geo='DE']")
for campaign in germany_campaigns:
    print(campaign.get("id"), campaign.get("platform"))
Це дає вам німецькі кампанії без додаткового коду обходу. Посильте фільтр, коли фід контролює бюджет або стан акаунта:
high_bid_facebook = root.xpath(
    "//campaign[@platform='facebook' and @status='active' and creative/bid > 1.50]"
)

for campaign in high_bid_facebook:
    print(campaign.get("id"))
У виробництві такі запити зазвичай знаходяться всередині робіт маршрутизації, які розділяють трафік за країною, надсилають кампанії в окремі групи акаунтів Facebook або TikTok, маппують лендинги до профілів клоакінгу або перевіряють, що фармлені акаунти отримують лише схвалені гео. Якщо оператори також підтримують конфігурації запуску для конкретних браузерів, це допомагає тримати логіку маппінгу акаунтів узгодженою з робочим процесом налаштувань проксі браузера Firefox команди, щоб вибір кампанії та маршрутизація браузера не розходилися.
Використання XPath для вибору кампаній
XPath заслуговує свого місця, коли правило вибору складніше за сам парсинг.
З ручним обходом дерева фід із вкладеними групами акаунтів, браузерними профілями, правилами редиректів і запасними креативами перетворюється на цикли всередині циклів плюс багато перевірок if. Це коштує часу під час налагодження та робить зміни фіду ризикованішими. XPath тримає правило видимим в одному виразі, що легше переглядати перед запуском.
Кілька прикладів:
# Усі активні кампанії
root.xpath("//campaign[@status='active']")

# Усі назви креативів для Німеччини
root.xpath("//campaign[geo='DE']/creative/name/text()")

# Кампанії, призначені конкретному пулу акаунтів
root.xpath("//campaign[account='farm_batch_12']")
Використовуйте XPath, коли операторам потрібно відповісти на бізнес-питання безпосередньо з XML. Які активні кампанії можуть піти до прогрітого пулу акаунтів? Які креативи належать до DE і проходять поріг ставки? Які записи повинні бути виключені з набору клоакнутих лендингів? Ці питання чітко маппяться на XPath, і ця ясність зменшує помилки.
Простори імен та відсутні вузли
Дві речі ламають XML-скрипти в рекламних операціях весь час. Простори імен та опціональні елементи.
Простори імен з'являються в партнерських експортах, підписаних пейлоадах, XML, згенерованих офісними програмами, та фідах, керованих схемою. Коли findall() або XPath не повертає нічого, навіть якщо теги є у файлі, простір імен часто є причиною.
Приклад:
xml_ns = """
<ns:campaigns xmlns:ns="http://example.com/campaigns">
    <ns:campaign id="1">
        <ns:geo>DE</ns:geo>
    </ns:campaign>
</ns:campaigns>
"""

root = etree.fromstring(xml_ns)
ns = {"ns": "http://example.com/campaigns"}

campaigns = root.xpath("//ns:campaign[ns:geo='DE']", namespaces=ns)
Ігноруйте карту простору імен, і запит не спрацює непомітно. Ось як скрипт проходить тестування на вчорашньому файлі-зразку і не працює на сьогоднішній ревізії фіду.
Відсутні XML-вузли викликають інший клас збоїв. Посібник FreeCodeCamp про парсинг XML у Python без зовнішніх бібліотек попереджає про небезпечні патерни доступу, такі як виклик .text на відсутньому результаті від find(). У ad-tech фідах це з'являється, коли у кампанії відсутня ставка, у браузерному профілі немає коду країни, або правило клоакінгу пропускає опціональний параметр.
Використовуйте захисне витягування:
campaign = root.find(".//campaign")
geo = campaign.find("geo") if campaign is not None else None

if geo is not None and geo.text:
    print(geo.text)
else:
    print("missing geo")
Або з lxml та XPath:
geo_values = root.xpath("//campaign[@id='fb-de-01']/geo/text()")
geo = geo_values[0] if geo_values else None
Відсутні вузли є нормою у виробничих фідах. Розглядайте кожне опціональне поле як nullable, валідуйте перед доступом і не працюйте з логуванням, яке говорить оператору, який ідентифікатор кампанії, джерело партнера або пул акаунтів спричинив проблему. Це утримує помилки парсера від перетворення на тиху неправильну маршрутизацію.
Модифікація та запис XML для завдань автоматизації
Читання XML - це лише половина роботи. Команди, які керують фармами акаунтів, геотаргетованими редиректами або шаблонами браузерних профілів, зазвичай потребують змінювати XML і повертати його назад.
Це може означати заміну цільової країни, вставку токена трекінгу, видалення застарілого правила або генерацію конфігураційних файлів для конкретних акаунтів перед запуском.
Редагування шаблону клоакінгу або кампанії
Почніть з простого XML-шаблону:
import xml.etree.ElementTree as ET

xml_data = """
<campaign_config>
    <target_country>US</target_country>
    <platform>facebook</platform>
    <tracking_param>old_value</tracking_param>
    <obsolete_flag>1</obsolete_flag>
</campaign_config>
"""

root = ET.fromstring(xml_data)
Тепер змініть його в пам'яті:
country = root.find("target_country")
if country is not None:
    country.text = "DE"

tracking = root.find("tracking_param")
if tracking is not None:
    tracking.text = "de_launch_batch_7"

obsolete = root.find("obsolete_flag")
if obsolete is not None:
    root.remove(obsolete)

new_elem = ET.SubElement(root, "browser_profile")
new_elem.text = "multilogin_de_stack"
Цей патерн корисний, коли ви клонуєте один базовий конфіг у кілька варіантів для конкретних ринків. Один скрипт може генерувати окремі виводи для Німеччини, Франції або Великобританії, призначати різні браузерні профілі і підтримувати ваші правила кампаній узгодженими в групах акаунтів.
Практичний приклад:
- Експорт профілю AdsPower або GoLogin: ін'єкція міток акаунтів і призначення гео.
- Помічник кампанії Facebook: заміна цільової країни та додавання токена трекінгу.
- Конфіг клоакінгу: видалення застарілих перевірок і вставка нового правила для шляху лендингу.
Якщо вам потрібне вирівнювання проксі на рівні браузера під час тестування, команди часто поєднують цей тип генерації конфігурації з перевірками налаштування всередині середовищ на основі Firefox. Посилання на налаштування проксі браузера у Firefox корисне, коли конфігурація XML керує валідацією, чутливою до локації.
Запис чистого XML назад на диск
Після того, як ви оновили дерево, серіалізуйте його:
tree = ET.ElementTree(root)
tree.write("campaign_config_de.xml", encoding="utf-8", xml_declaration=True)
Якщо ви хочете спочатку отримати рядок:
xml_output = ET.tostring(root, encoding="unicode")
print(xml_output)
Кілька правил запису мають значення у виробництві:
- Зберігайте необхідні назви тегів: партнерські системи часто відхиляють невеликі зміни імен.
- Не змінюйте порядок вузлів випадково: деякі старіші споживачі є крихкими.
- Зберігайте версії шаблонів окремо: один поганий перезапис може зламати кілька шляхів запуску.
- Валідуйте перед завантаженням: особливо якщо інший інструмент споживає модифікований файл автоматично.
Чисті записи мають більше значення, ніж хитрі записи. Нудний XML-файл, який імпортується правильно, перемагає витончений конвеєр трансформації, що зберігає деформований вивід.
Для багатоакаунтного управління генерація XML часто стає пакетною операцією. Введіть список акаунтів, маппте гео та платформу, виведіть один конфіг на браузерний профіль або кластер кампаній. Python добре з цим справляється, тому що XML API залишається читабельним, навіть коли автоматизація навколо нього стає більшою.
Оптимізація продуктивності за допомогою стрімінгу та проксі
Команда трафіку, що витягує щогодинні XML-фіди через десятки акаунтів, зазвичай спочатку натикається на ту саму стіну. RAM зростає, воркери зупиняються, і один надмірний партнерський експорт блокує решту черги.
Парсинг повного дерева добре підходить для невеликих документів і разових скриптів. У виробничому інжестінгу фідів, особливо для синхронізації рекламних кампаній, оновлення інвентарю акаунтів і завдань верифікації, він марнує пам'ять, яку ви повинні тримати доступною для повторних спроб, логування та нормалізації нижче за потоком. Безпечніший патерн - стримити вузли, витягувати те, що важливо, і відразу відкидати решту.
Чому стрімінг краще витримує навантаження
Стрімінг підходить для XML-робіт, які виконують команди трафік-арбітражу:
- повторювані вузли кампаній або офферів у великих партнерських фідах
- гео-специфічні експорти верифікації, витягнуті через різні виходи
- інвентарі фармінгу акаунтів, об'єднані в один документ
- polling-воркери, які обробляють ту саму схему весь день без перезапуску
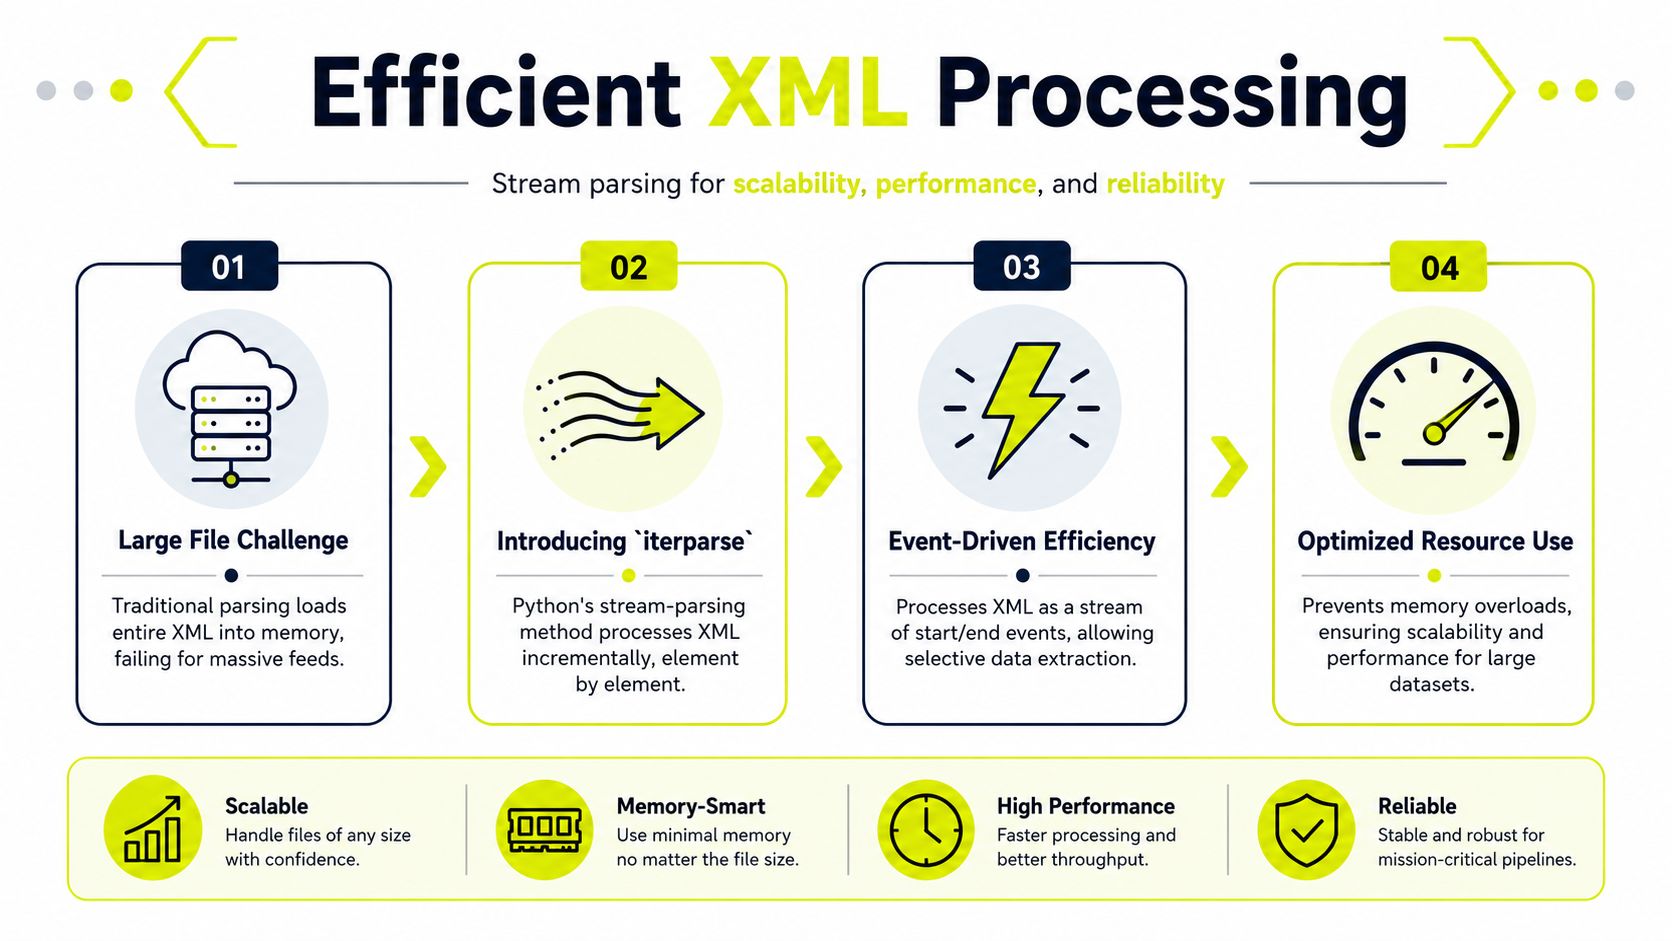
Мета проста. Підтримуйте передбачувану резидентну пам'ять, навіть коли розмір фіду непередбачуваний.
Використання iterparse для великих віддалених фідів
iterparse є практичним вибором, коли фід занадто великий, щоб зручно тримати в пам'яті.
import xml.etree.ElementTree as ET

for event, elem in ET.iterparse("large_feed.xml", events=("end",)):
    if elem.tag == "campaign":
        campaign_id = elem.attrib.get("id")
        geo = elem.findtext("geo")
        platform = elem.attrib.get("platform")

        if geo == "DE" and platform == "facebook":
            print(campaign_id)

        elem.clear()
elem.clear() - це те, що робить цей патерн корисним. Без нього довготривалі воркери повільно накопичують оброблені вузли і врешті-решт не працюють, як парсери повного дерева.
Для ad-tech конвеєрів я довіряю цьому підходу для одноразових робіт. Прочитайте фід, витягніть поля кампанії, маппте їх у менший внутрішній формат, потім запишіть у чергу або базу даних. Якщо завдання потребує крос-рекордних порівнянь, зробіть це на другому етапі після того, як ви зменшили пейлоад.
Підберіть проксі до поведінки фіду
Вибір проксі впливає на якість даних настільки ж, як і вибір парсера. Якщо ендпоінт змінює вивід за країною, ASN, мобільним оператором або профілем репутації, неправильний вихід дає вам чистий парсинг неправильного фіду.
Кейси використання розбиваються досить чітко:
- Дата-центрові проксі: добре для швидких масових витягувань зі стабільних ендпоінтів, які не локалізуються агресивно
- Резидентні проксі: краще для фідів для конкретних країн, регіональної валідації та ендпоінтів, які реагують на репутацію IP
- Мобільні проксі: корисні для перевірки потоків офферів тільки для мобільних пристроїв, редиректів, залежних від оператора, і клоакнутих шляхів, показаних модерації або fraud-системам
- IPv6 проксі: варто використовувати, коли ціль добре обробляє IPv6 і ротація адрес важливіша за широку сумісність
Поведінка TLS також має значення. Партнерські ендпоінти часто обслуговують різні сертифікати, обмеження швидкості або правила фільтрації залежно від маршруту та регіону. Команди, що валідують зашифровані фіди через кілька виходів, повинні розуміти поведінку SSL-проксі сервера для безпечних партнерських ендпоінтів перед тим, як звинувачувати логіку парсера в поганих даних.
Поширена виробнича помилка - розділяти збір мережі та обробку XML так, ніби це не пов'язані системи. Це один конвеєр. Фід кампанії тільки для Німеччини, отриманий через неправильний регіон, може пройти перевірки схеми, заповнити вашу базу даних і все одно отруїти торги, перевірки на огляд і верифікацію клоакінгу на кількох акаунтах.
Практичне правило полягає у вимірюванні обох сторін разом. Відстежуйте затримку отримання, розмір відповіді, час парсингу, використання пам'яті та правильність країни на групу проксі. Так команди підтримують стабільність інжестінгу, коли вони синхронізують багато акаунтів одночасно і не можуть дозволити собі тихий дрейф даних.
Безпечна обробка XML та найкращі практики
Парсинг XML з ненадійного джерела - це рішення безпеки, а не просто рішення кодування.
Це має значення в ad-tech, тому що команди часто інжестують файли з партнерських мереж, партнерських API, орендованих інструментів, внутрішніх завантажень і разових експортів від постачальників. Якщо ви розглядаєте всі ці вхідні дані як безпечні, ви запрошуєте уникненний ризик у те саме середовище, що містить логіку кампаній, маппінги акаунтів та облікові дані автоматизації.
Чому ненадійний XML є операційним ризиком
Спільнота Python явно попереджає, що її XML-обробні модулі не є безпечними проти зловмисно створених даних, і для ненадійних джерел рекомендуються альтернативи, такі як defusedxml, як обговорюється в обговоренні спільноти Python про попередження безпеки XML.
Це попередження має значення, тому що більшість XML-прикладів онлайн зупиняються на парсингу синтаксису. Виробничі команди повинні думати про випадки зловживання:
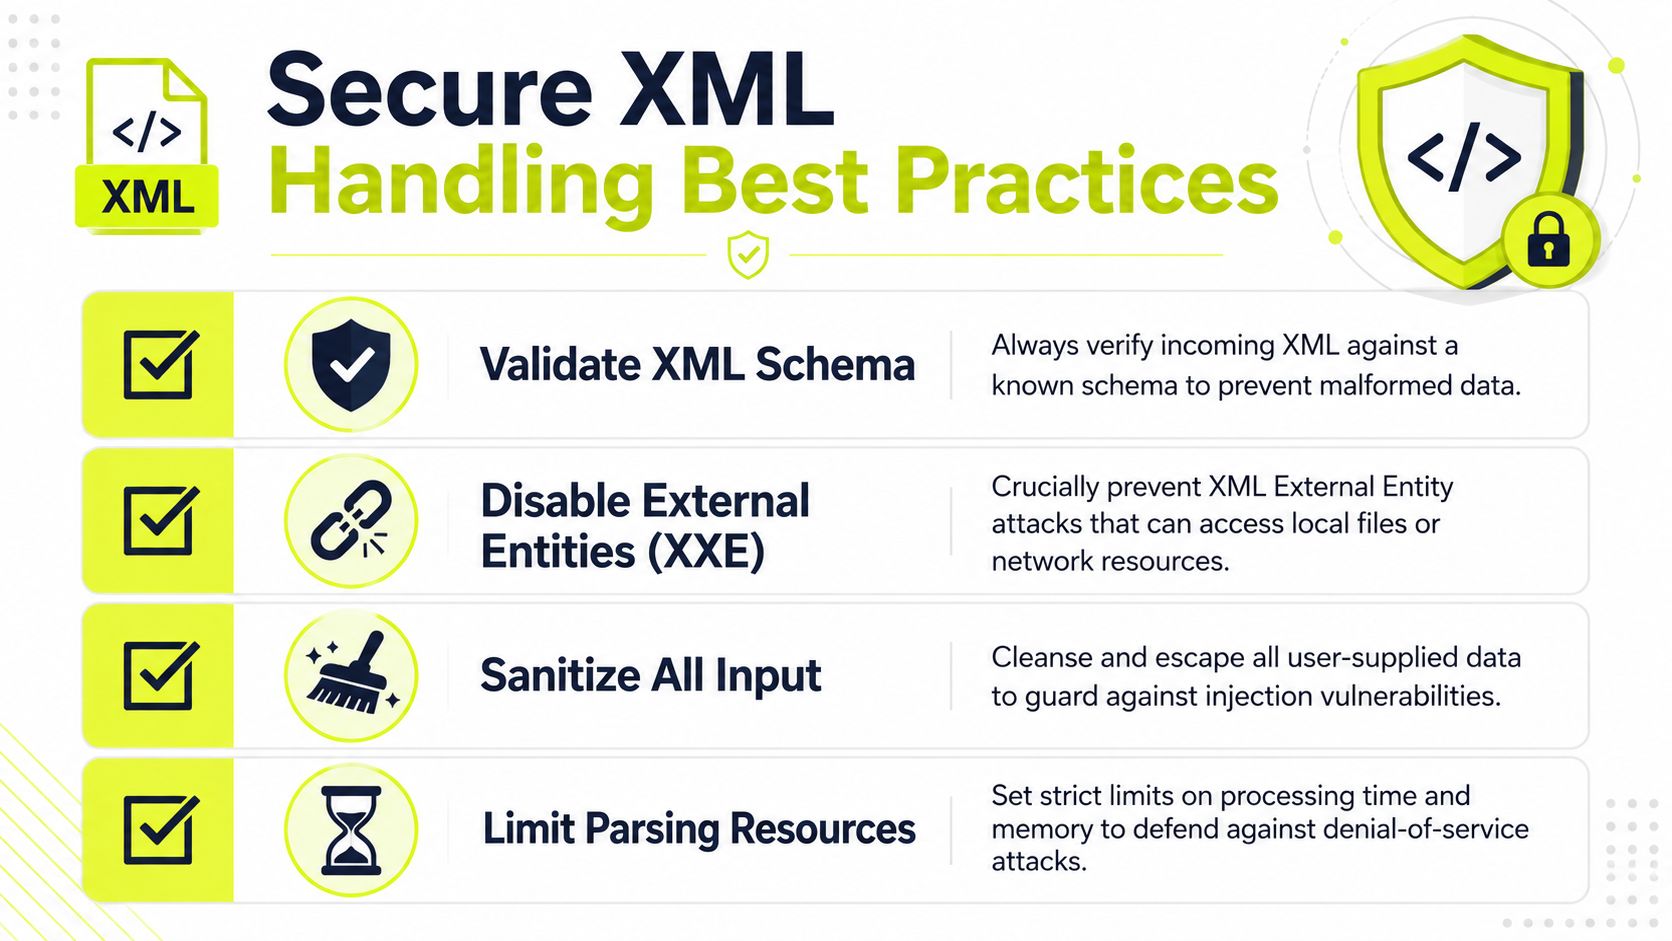
- XXE-атаки: зовнішні сутності можуть бути зловживані для доступу до локальних файлів або внутрішніх ресурсів, якщо парсер це дозволяє.
- Denial-of-service входи: зловмисно створений XML може споживати надмірні ресурси.
- Небезпечні звички серіалізації: XML, що використовується як транспорт для чутливих структурованих даних, може створити проблеми довіри, якщо валідація слабка.
Підписаний XML все ще актуальний у робочих процесах високої довіри. SignXML зазначає, що XML Signature залишається використовуваним для SAML 2.0, XAdES, EBICS та WS-Security у своїй документації проекту. Це одна з причин, чому XML не зник із серйозних інтеграцій. Якщо ваш трафік-стек торкається ідентичності, корпоративного біллінгу або регульованих партнерських даних, безпечна обробка XML не є опціональною.
Виробничий чеклист
Використовуйте базову лінію, орієнтовану на безпеку, кожного разу:
- Розглядайте сторонній XML як ворожий за замовчуванням: особливо з завантажень, партнерських панелей або недокументованих ендпоінтів.
- Використовуйте безпечніші опції парсингу: надавайте перевагу зміцненим бібліотекам, таким як
defusedxml, коли джерело не повністю надійне. - Валідуйте структуру перед запуском бізнес-логіки: валідація схеми та строгі перевірки полів виявляють деформовані дані рано.
- Встановлюйте межі ресурсів: робота парсингу повинна мати обмеження за часом, пам'яттю та розміром файлу.
- Відокремлюйте інжестінг від виконання: не дозволяйте парсеному XML безпосередньо запускати чутливі дії без валідації.
- Аудитуйте поведінку DNS у вашому стеку збору: коли проксіюєте запити для віддаленого XML, розумійте, як обробка проксі DNS впливає на шляхи запитів.
Дорога XML-помилка зазвичай не є синтаксичною помилкою. Це помилка довіри.
Це застосовується незалежно від того, чи імпортуєте ви підписаний пейлоад, обробляєте фід для фармінгу акаунтів або валідуєте правила клоакінгу для геотаргетованих кампаній. Надійна автоматизація залежить від того, щоб парсер був строгим, захисним та ізольованим від ненадійного вводу.
Якщо ви будуєте XML-керовану автоматизацію для верифікації реклами, інжестінгу фідів, фармінгу акаунтів або робочих процесів багатоакаунтних браузерів, Sota Proxy надає вам проксі-шар для тестування гео-специфічних виводів, надійного витягування віддалених фідів і валідації того, що трафік Facebook або TikTok бачить у різних регіонах. Для команд, які вже діляться інструментами з іншими операторами, його партнерська програма також пропонує до 40% комісії.
Схожі статті

Bing Search API ключ: налаштування, тестування та масштабування у 2026 році
Отримайте робочий Bing Search API ключ у 2026 році, тестуйте запити, захистіть ключ та масштабуйте високонавантажений скрейпінг без блокувань. Практичний посібник для технічних команд.

10 способів збору якісних даних для медіабаєрів
Відкрийте для себе 10 способів збору якісних даних від ваших користувачів. Вивчіть методи, такі як інтерв'ю та фокус-групи, для оптимізації використання проксі та стратегії кампаній.
Для чого використовується проксі: Гід з арбітражу 2026
Для чого використовується проксі - Дізнайтеся, для чого використовується проксі у 2026 році, від підвищення безпеки до управління мультиакаунтними операціями для арбітражних команд
ERR_TUNNEL_CONNECTION_FAILED: назва помилки вже є діагнозом
Chrome попросив проксі-сервер відкрити CONNECT-тунель, і це не вдалося. Ось і вся помилка. Звідки береться проксі, коли ви його не налаштовували, шість причин, чому налаштований проксі викликає цю помилку, і чому очищення кешу нічого не виправляє.
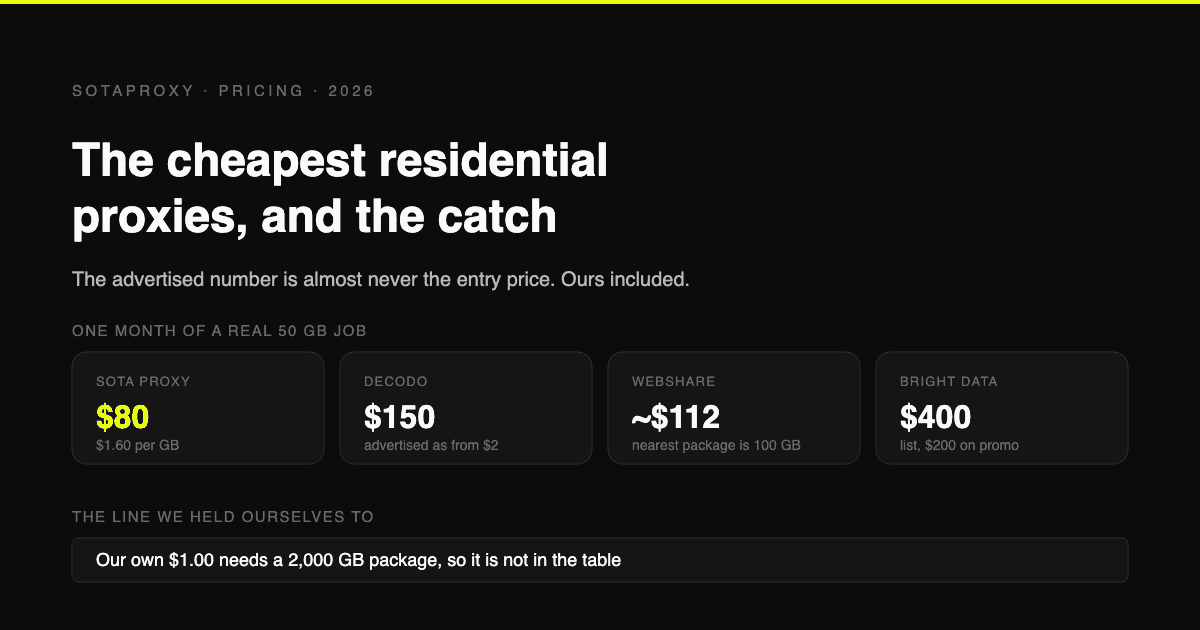
Найдешевші резидентські проксі 2026 року: які підводні камені ховає кожен провайдер
Перевірені ціни за гігабайт з офіційних сторінок п'яти постачальників, а не з торішніх оглядів. Чому заявлена ціна майже ніколи не є вхідною, які провайдери встановлюють мінімальний місячний поріг оплати і як розрахувати реальну вартість гігабайта.
Скільки акаунтів Telegram можна мати у 2026 році (і що насправді означає «обмежений»)
Telegram не публікує ліміту на кількість акаунтів, один номер на акаунт, а власні FAQ про спам стверджують, що обмежений акаунт може писати всім, хто зберіг ваш номер. Що саме провокує обмеження, чому VOIP-номери блокуються ще до першого повідомлення і чому дострокового зняття обмежень не існує.