Проксі для SEO у 2026 році: що насправді бачить scraпер від Google і скільки коштує моніторинг позицій
Більшість SEO-задач не потребує проксі. Для відстеження позицій у Google їх потрібно кілька. Що надсилають Google, Bing і DuckDuckGo нашому скраперу, три способи перевіряти рейтинги з реальними цінами та який проксі підходить для решти SEO-робіт.
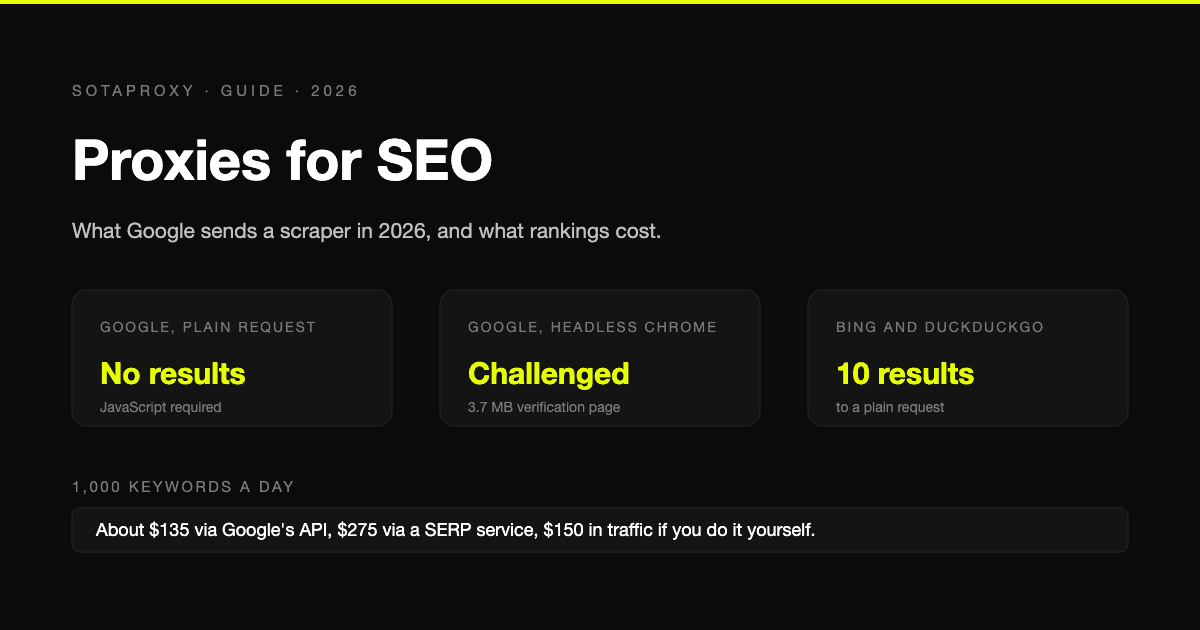
«SEO-проксі» - це пошуковий запит, а не продукт. Більшість завдань у SEO взагалі не потребує проксі, одна їхня частина без проксі неможлива, і саме ця частина за останні два роки змінилася так, що більшість настанов досі не встигла це врахувати. Тож ми почнемо з тесту, який провели 30 вересня 2026 року, і наведемо реальні ціни для кожного варіанта.
Які завдання в SEO потребують проксі
| Завдання | Проксі? | Який тип |
|---|---|---|
| Робота з Search Console, аналітикою, логами | Ні | |
| Сканування власного сайту | Ні | |
| Сканування сайтів конкурентів, перевірка зворотних посилань по багатьох доменах | Так, при великих обсягах | Дата-центрові, кілька виділених адрес |
| Перевірка позицій у Bing або DuckDuckGo | Тільки при великих обсягах | Дата-центрові |
| Перевірка позицій у Google | Так, і це найскладніший випадок | Резидентські, або жодних, див. нижче |
| Локальні результати по містах, локальні блоки, реклама | Так | Резидентські з прив'язкою до міста, через браузер |
Перші два рядки - це те, про що часто забувають згадати. Якщо ваша робота в SEO стосується власного сайту, бюджет на проксі дорівнює нулю.
Що пошукові системи надсилають скраперу
Ми відправили ідентичний запит з домашнього підключення, без проксі, так само, як це зробив би скрапер.
| Система | Звичайний HTTP-запит (curl) | Headless Chrome |
|---|---|---|
| Сторінка на 92 КБ без результатів, «натисніть тут, якщо не відбувається переадресація» | «Наші системи виявили незвичний трафік», сторінка верифікації, передано 3,7 МБ | |
| Bing | 10 результатів, 126 КБ | не потрібно |
| DuckDuckGo (html-ендпоінт) | 12 результатів, включно з рекламою, 47 КБ | не потрібно |
Звідси випливають дві речі.
Google більше не повертає результати нічому, що не виконує JavaScript. Скрапер, побудований на простих запитах (а саме так більшість настанов про SEO-проксі досі це й описує), отримує порожню оболонку з будь-якої адреси, резидентської чи ні. Щоб побачити результати, потрібен справжній браузер, і кожна відрендерена сторінка важить мегабайти замість кілобайтів.
Google перевіряє не лише адресу, а й браузер. Наш headless Chrome зіткнувся з перевіркою через звичайне домашнє підключення вже на першому запиті. Резидентський проксі дає вам домашню адресу, але не дає браузер, якому довіряє Google. Це окрема проблема, і саме тому «просто використовуйте ротацію резидентських проксі» вже не є повною відповіддю.
Bing і DuckDuckGo досі віддають звичайний HTML. Якщо позиції там для вас важливі, їх збирати дешево.
Три способи отримати позиції в Google з цінами
Візьмемо реалістичне завдання: 1000 ключових слів перевіряються раз на день, 30 000 сторінок результатів на місяць.
| Спосіб | Вартість для 30 000 сторінок на місяць | Що ви отримуєте |
|---|---|---|
| Google Custom Search JSON API | 100 запитів на день безкоштовно, далі $5 за 1000: близько $135 | Десять результатів на запит від Programmable Search Engine, а не з живої сторінки. Без локального блоку, без реклами |
| SERP API сервіс | SerpApi: $150 на місяць за 15 000, $275 за 30 000 | Розпарсена жива сторінка з усіма елементами. Блокування - їхня проблема |
| Власний браузер і резидентські проксі | Лише трафік: 30 000 сторінок приблизно по 3 МБ кожна - це близько 90 ГБ, $150 у нас за $1,50 за ГБ, без серверів і без врахування збоїв | Сира сторінка на ваших умовах |
Прочитайте останній рядок чесно. При таких обсягах власний скрапінг коштує приблизно стільки ж лише за трафік, скільки SERP-сервіс коштує загалом, а потім вам ще треба запускати браузери та обробляти кожну сторінку верифікації. Це вигідно, коли вам потрібна сама сторінка (скріншоти локального блоку, позиції реклами, макет), коли обсяги значно більші або коли ви вже запускаєте браузери для чогось іншого.
Ціни взято зі сторінок Google і SerpApi станом на 30 вересня 2026 року. Цифра в 3 МБ - це те, що передав наш єдиний запит з верифікацією. Ми не змогли виміряти сторінку з результатами без верифікації, тому це радше оцінка, ніж точне вимірювання.
Якщо ви скрапите Google самостійно
Параметри, які роблять результати порівнянними між запусками:
| Параметр | Значення | Приклад |
|---|---|---|
hl | Мова інтерфейсу | hl=en |
gl | Країна для результатів | gl=us |
num | Кількість результатів на сторінці | num=10 |
pws=0 | Вимкнути персоналізацію | pws=0 |
uule | Закодована локація для локальних результатів | див. нижче |
uule - це спосіб, яким rank tracker просить Google поводитися так, ніби користувач знаходиться в конкретному місці. Це префікс, символ довжини та назва місця в base64:
import base64

def uele(canonical_name):
    key = "ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789-_"
    b64 = base64.b64encode(canonical_name.encode()).decode().rstrip("=")
    return "w+CAIQICI" + key[len(canonical_name)] + b64
uule("New York,New York,United States")
# w+CAIQICIfTmV3IFlvcmssTmV3IFlvcmssVW5pdGVkIFN0YXRlcw
Назва місця має бути в канонічній формі Google: "Місто,Регіон,Країна". Поєднуйте її з адресою проксі в тій самій країні: uule задає місце, а адреса має зробити це місце правдоподібним.
Три звички з практики:
- Одна адреса на сесію результатів. Друга сторінка має надходити з тієї самої адреси, що й перша, інакше ви склеюєте двох різних користувачів. У нашому шлюзі для цього є суфікс сесії,
login_c_US_s_42_ttl_15m. - Уповільнюйте на адресу, а не загалом. Обмеження Google діють на кожну адресу окремо. Більше адрес з меншою швидкістю кожна живуть довше, ніж мало адрес на високій швидкості.
- Очікуйте сторінку перевірки й логуйте її. Зараховуйте сторінки з викликом як відмови, повторюйте з іншої адреси й стежте за частотою. Коли вона зростає, рішення в темпі, а не в збільшенні трафіку.
Виділені проксі для SEO-інструментів
Багато пошукового трафіку тут йде на "виділені проксі для SEO-ранжування": статичні адреси для інструментів, які самі виконують запити. За цією фразою ховаються два різних інструменти.
Трекери позицій, які самі запитують Google, потребують проксі, бо Google обмежує кожну адресу. Дайте їм резидентські сесії, а не хостингові адреси, по одній на кожен паралельний потік, і запускайте на найповільнішому темпі, який дозволяє інструмент. Автоматичні перевірки Google, за численними свідченнями, найжорсткіше б'ють саме по хостинговим діапазонам, а трекер, що спалює датацентрові адреси на Google, витрачає гроші на збір сторінок з викликами.
Краулери й чекери посилань забирають дані зі звичайних сайтів, а не з Google. Інструмент аудиту сайту, що сканує конкурента, або перевірка бекзлінків, що обходить тисячу реферальних сторінок, чудово працює з кількох виділених датацентрових адрес. У нас вони коштують $1,80 на місяць за одну й $1,35 за кожну від десяти, трафік не лічиться, і більшість інструментів приймає їх у форматі адреса:порт:логін:пароль, по одній на рядок. Тримайте краулінг ввічливим: одна адреса, що б'є на повній швидкості по малому сайту, це спосіб отримати блокування, і це право сайту заблокувати.
Для всього іншого зі списку в матеріалі кращі проксі для веб-скрейпінгу є тест, який покаже, чи потрібні для цілі резидентські адреси взагалі.
Перевірки локального SEO
Локальні результати залежать від трьох речей, які мають збігатися: країна адреси, параметр gl і місце в uule. Німецька адреса з gl=us і нью-йоркським uule повертає щось, що жоден реальний користувач не бачить.
Для роботи на рівні міста підходить резидентський проксі з суфіксом міста, і місто тут переваг, а не гарантія: login_c_US_city_New-York дає Нью-Йорк, коли там онлайн пристрій, і країну в іншому випадку. Синтаксис описаний у довіднику рядків підключення.
FAQ
Що таке SEO-проксі?
Звичайні проксі, куплені для SEO-завдань, здебільшого трекінгу позицій і краулінгу конкурентів. Спеціального SEO-типу не існує. Вибір між резидентськими адресами для Google і датацентровими для всього іншого.
Чи потрібні проксі для відстеження позицій?
Якщо ви перевіряєте ранжування самі через скрейпінг Google, то так, і ще браузер, бо Google не віддає нічого на звичайний запит. Якщо ви користуєтесь API Google або SERP-сервісом, то ні. Для кількох сотень ключових слів API або сервіс зазвичай дешевші за проксі.
Який тип проксі найкращий для SEO?
Резидентські з таргетингом на місто для всього, що стосується Google. Виділені датацентрові адреси для краулінгу сайтів і перевірки бекзлінків. Нічого для роботи на власному сайті.
Скільки проксі потрібно для трекінгу позицій?
Достатньо, щоб кожна адреса залишалася під лімітом Google за вашого темпу. Число залежить від інструмента й темпу, тому починайте з кількох сесій, стежте за часткою сторінок з викликами й додавайте адреси, коли вона зростає, а не вгадуйте наперед.
Чи можна використовувати безкоштовні проксі для SEO?
Для Google ні: це хостингові адреси, спільні з усіма, хто знайшов той самий список, і Google кидає їм виклик першими. Для краулінгу публічного сайту вони ненадійні, але не небезпечні.
Чи дозволено скрейпити Google?
Умови Google забороняють автоматизовані запити, і Google застосовує це технічно, а не юридично для звичайного трекінгу позицій. Офіційний шлях - Custom Search API. Це не юридична консультація.
Схожі статті
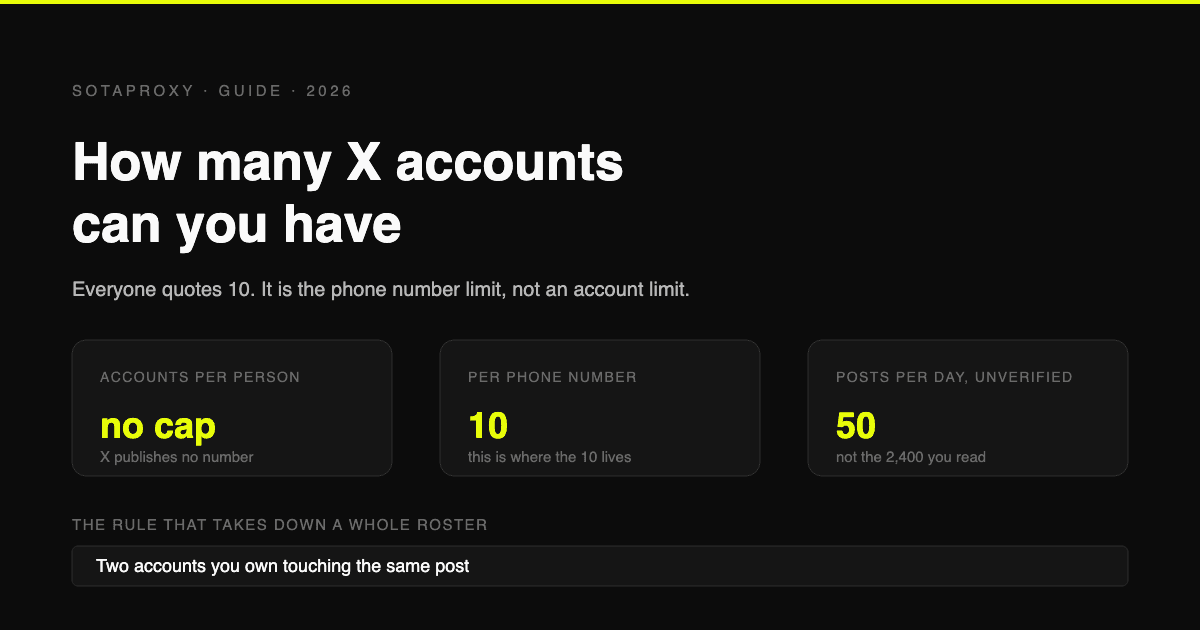
Скільки акаунтів X (Twitter) можна мати у 2026 році (10 - це ліміт на номер телефону, а не на кількість акаунтів)
X не встановлює обмежень на кількість акаунтів для однієї людини. Цифра 10, яку всі цитують, стосується лише кількості акаунтів, які можна прив'язати до одного номера телефону. Справжні обмеження - це 50 постів на день для безкоштовного акаунта, дублювання сценаріїв використання та взаємодія між акаунтами.
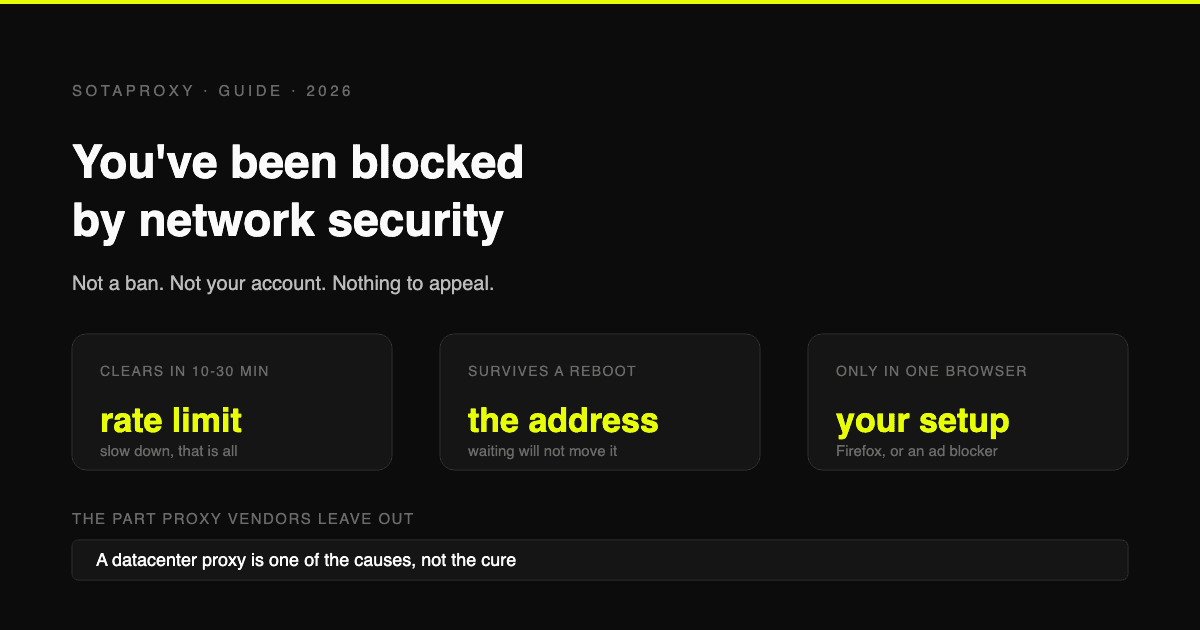
Reddit "You've Been Blocked by Network Security": кожна причина та виправлення для кожної
Це не бан, і нема чого оскаржувати. Це походить від edge-сервера Reddit, застосовується до вашого з'єднання і має шість причин. Ось як визначити, яка саме у вас, і скільки триває кожна.
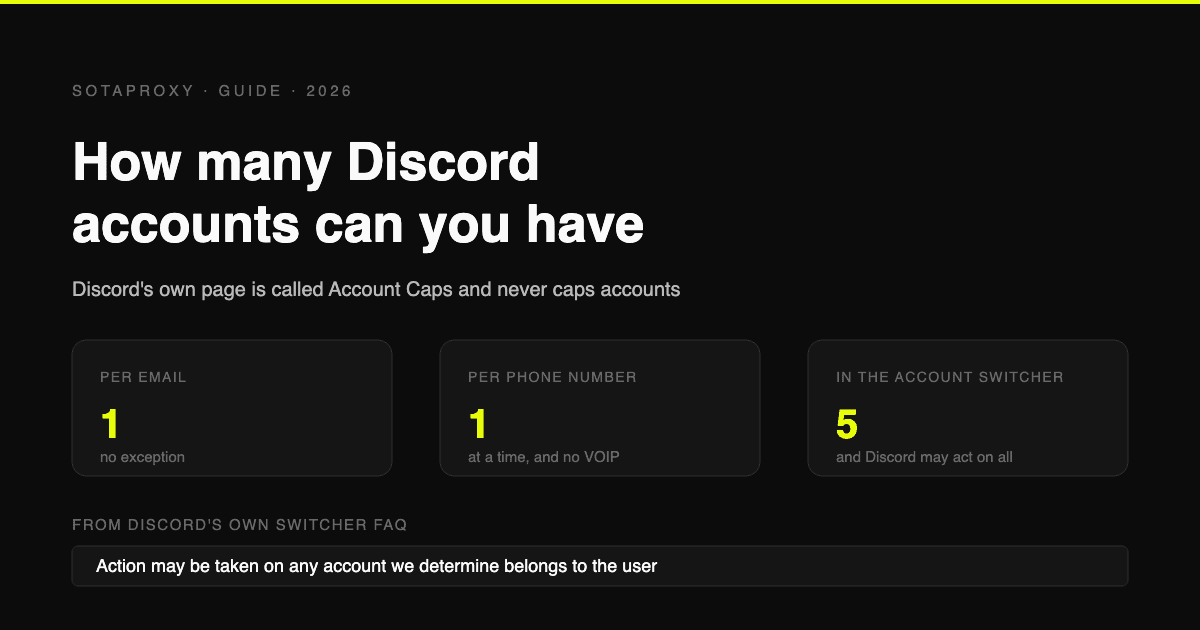
Скільки облікових записів Discord можна мати у 2026 році (на email, телефон, пристрій)
Discord не публікує жодних обмежень на кількість облікових записів. Реальні ліміти: один на email, один номер телефону одночасно без VOIP, і п'ять у перемикачі облікових записів, які Discord може застосовувати глобально.
Автоматизація Telegram з Telegram Expert: що робити, якщо завдання зупинилося на середині
Скільки акаунтів Reddit можна мати у 2026 році (Карма-бар'єри, бани, блокування мережевою безпекою)
Reddit дозволяє мати кілька акаунтів відкрито. Що вас зупиняє - це карма-бар'єри, якість контрибутора, обмеження частоти запитів та одне жорстке правило щодо голосування, плюс три типи банів, як оскаржується кожен, і чому «заблоковано мережевою безпекою» не є баном.
Скільки облікових записів TikTok можна мати у 2026 році (Ліміти, страйки та правила Shop)
Шість облікових записів на пристрій, а не три, і жодного опублікованого ліміту. Правила, які насправді визначають виживання: обмеження дій залежно від віку облікового запису, як закінчується термін дії страйків, що насправді означає shadowban, та один Shop на одну бізнес-одиницю на ринок.