API para redes sociales: Una guía para operadores y desarrolladores
Una guía técnica sobre API para redes sociales. Aprende a usar APIs oficiales, no oficiales y de scraping para gestión de cuentas, automatización y campañas publicitarias.
Ya conoces el modo de fallo. Un comprador ejecuta anuncios de Facebook en AdsPower. Otro lanza campañas de TikTok desde Dolphin Anty. Alguien más calienta cuentas de respaldo en GoLogin. El equipo de farm rota cookies, creativos, proxies y páginas de destino a través de docenas de perfiles. Todo funciona hasta que llega el volumen.
En ese punto, las operaciones manuales dejan de ser molestas y se convierten en el cuello de botella. Las personas pierden comentarios, duplican cargas, queman cuentas publicitarias al iniciar sesión desde el entorno equivocado y pierden el rastro de qué creativo geo-dirigido se publicó dónde. El problema no es el esfuerzo. Es el control.
Ahí es donde una API para redes sociales deja de ser una abstracción de desarrollador y se convierte en infraestructura operativa. Las APIs de redes sociales se volvieron centrales para la automatización de terceros a medida que las plataformas estandarizaron el acceso de desarrolladores a publicaciones, perfiles, comentarios, likes y métricas de engagement, razón por la cual los sistemas modernos de gestión pueden unificar programación, reportes y enrutamiento de mensajes a través de redes desde una sola interfaz, como se describe en la descripción general de APIs de redes sociales de Data365.
Tabla de contenidos
- Escalando operaciones de redes sociales más allá de clics manuales
- Estrategias de APIs oficiales vs no oficiales vs scraping
- Navegando autenticación y límites de tasa de plataforma
- Endpoints principales de API para automatización y gestión
- Mejores prácticas para construir automatización confiable
- El papel de los proxies y soluciones anti-bloqueo
- Restricciones legales y términos de servicio de plataforma
Escalando operaciones de redes sociales más allá de clics manuales
Cinco cuentas publicitarias son manejables. Cincuenta no lo son.
Un equipo de arbitraje de tráfico puede forzar el crecimiento inicial asignando personas a perfiles de navegador, cuentas publicitarias y páginas sociales. Un operador maneja páginas de Facebook en Multilogin. Otro rota cuentas de publicación de TikTok en Hidemyacc. Un tercero verifica si las páginas cloaked se renderizan correctamente para cada país objetivo. Esa configuración funciona durante una semana. Luego los errores se acumulan.
El primer quiebre generalmente no es técnico. Es procedimental. Los equipos publican el creativo equivocado desde la sesión incorrecta, reutilizan un perfil de navegador caliente para una cuenta fría, o pierden eventos de bandeja de entrada que deberían haber activado una respuesta o pausa. Cuando estás haciendo malabares con farming de cuentas, verificación de anuncios, campañas geo-dirigidas y distribución de contenido, los clics manuales no escalan limpiamente.
Por qué colapsan las operaciones manuales
Algunos patrones aparecen cada vez:
- Confusión de sesión: Un operador abre el perfil de AdsPower o GoLogin equivocado y realiza una acción sensible en la cuenta de Facebook o TikTok incorrecta.
- Sin estado central: Nadie tiene una vista confiable de qué se publicó, editó, apeló, pausó o respondió.
- Contratación lineal: Cada lote de cuentas nuevas necesita más personas. Eso no es un sistema. Es un problema de plantilla.
Regla práctica: Si la tarea debe repetirse en muchas cuentas, muchas geos o muchas variantes creativas, pertenece al código.
Una API para redes sociales te da control programático sobre la capa repetitiva. Puedes estandarizar publicación, recopilar señales de engagement, enrutar mensajes, etiquetar fallos y activar alertas sin depender de que los humanos recuerden cada paso. Eso no elimina los navegadores antidetect del stack. Reduce su trabajo a las acciones que aún necesitan una sesión completa de navegador.
Dónde encajan las APIs en un stack real de operador
Para la mayoría de equipos de medios, la división funcional se ve así:
- Usa automatización de navegador para acciones frágiles: creación de cuentas, calentamiento, flujos de apelación, configuración de pago y cualquier cosa que dependa de renderizado en vivo o comportamiento pesado en JS.
- Usa APIs para acciones repetibles: publicación, extracción de métricas, sincronización de estados y manejo de flujos de trabajo de bandeja de entrada o moderación.
- Usa scraping con moderación: principalmente para verificación externa, monitoreo de competidores o cobertura donde faltan superficies oficiales. Si tu equipo hace eso, esta guía sobre Python web crawling para recopilación escalable de datos es un complemento útil.
El punto no es reemplazar todo con una API. El punto es dejar de desperdiciar buenos operadores en trabajo que el software debería poseer.
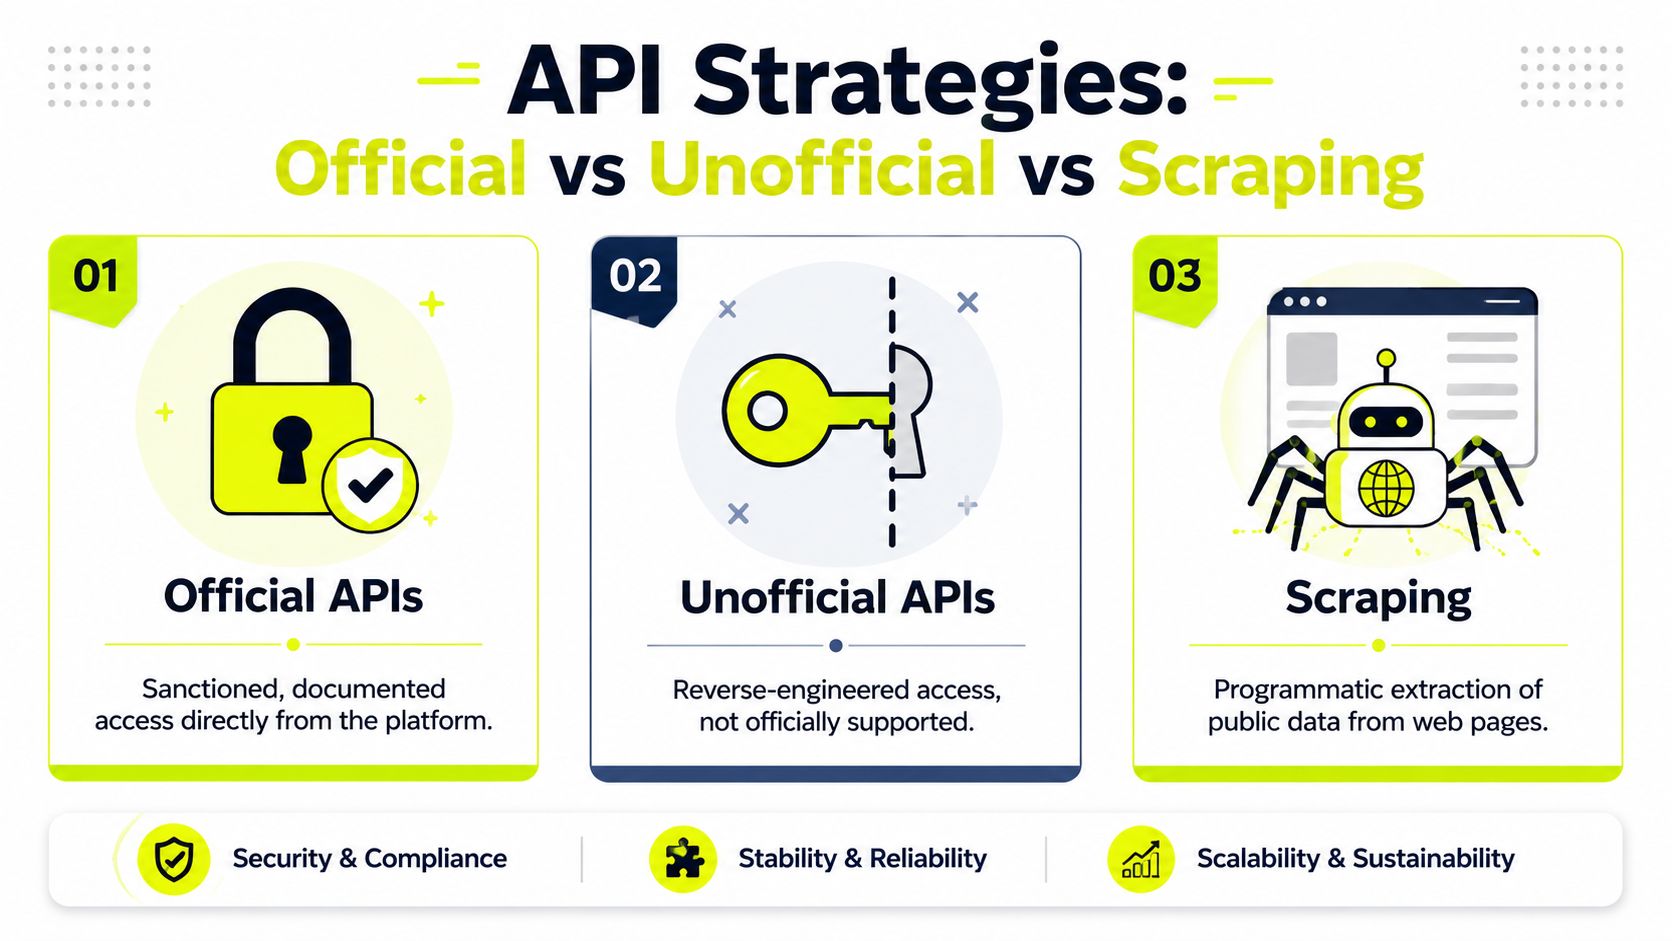
Estrategias de APIs oficiales vs no oficiales vs scraping
Los equipos típicamente no eligen un método de acceso para siempre. Eligen un método principal, luego agregan excepciones cuando las brechas de cobertura o la presión de escalamiento lo fuerzan.
APIs oficiales para supervivencia
Las APIs oficiales son la opción menos emocionante y usualmente la mejor base. Existen por una razón. Las plataformas quieren exponer acceso controlado a publicaciones, medios, analítica, comentarios y superficies de cuenta seleccionadas sin darte alcance ilimitado en sus sistemas.
La ventaja es la estabilidad. Los docs existen. Los flujos de autenticación están documentados. Los modos de fallo son predecibles. Si estás gestionando páginas de Facebook de marca, publicación de contenido TikTok, cargas de YouTube, o extrayendo datos de rendimiento a dashboards internos, las APIs oficiales son el camino más limpio.
La desventaja es el control de acceso y la presión de cuota. No obtienes todo. A menudo no obtendrás la profundidad histórica completa que deseas. La aprobación puede ser lenta, y algunos endpoints están bloqueados detrás de revisiones, verificación de negocio o restricciones de producto.
APIs unificadas para velocidad
Los proveedores de APIs unificadas se sientan entre tu app y cada plataforma. Esa capa intermedia puede ahorrar mucho dolor de ingeniería. Las APIs unificadas de redes sociales reducen la complejidad de integración al exponer un endpoint REST que normaliza formatos específicos de plataforma y maneja autenticación por plataforma. Una aplicación envía una solicitud mientras la capa unificada la mapea a las reglas nativas de cada plataforma, lo cual es altamente eficiente para publicación cross-platform, como se explica en la guía de Zernio sobre APIs de redes sociales.
Ese modelo ayuda cuando tu equipo necesita un programador, un gestor de campañas o un backend de reportes para múltiples redes. También ayuda si estás construyendo herramientas internas rápido y no quieres integraciones separadas para Instagram, LinkedIn, X, Pinterest y YouTube.
Usa el video a continuación si quieres un recorrido visual rápido antes de evaluar detalles de implementación.
Lo que no funciona bien es asumir que una capa unificada te da paridad completa de características. No lo hará. La abstracción es más fuerte para publicación estándar y lecturas comunes. Se debilita cuando necesitas características de anuncios específicas de plataforma, flujos de trabajo de medios extraños o lógica de moderación de casos límite.
APIs no oficiales y scraping para acceso límite
Las APIs no oficiales y el scraping directo existen porque los operadores quieren acceso que la capa oficial no proporciona. Esa es la verdad detrás de la mayoría de configuraciones de farming de cuentas a gran escala, verificación de anuncios y monitoreo de competidores.
Aquí está el trade-off en términos claros:
| Método | Mejor para | Qué funciona | Qué se rompe |
|---|---|---|---|
| API oficial | Seguridad de cuenta a largo plazo | Autenticación estable, endpoints documentados, cumplimiento de plataforma | Cobertura limitada, fricción de aprobación |
| API unificada | Construcciones multi-plataforma más rápidas | Un esquema, menos mantenimiento, publicación cruzada | Dependencia de proveedor, características límite incompletas |
| No oficial o scraping | Brechas de datos y superficies ocultas | Mayor visibilidad, extracción personalizada, flujos más flexibles | Bloqueos, datos falsos, presión de fingerprint, riesgo ToS |
Si estás scrapeando superficies públicas o haciendo ingeniería inversa de llamadas privadas, tu capa anti-bloqueo importa tanto como tu parser. Fingerprints de navegador, timing de solicitudes, consistencia geo, estado de cookie y confianza de IP afectan los resultados. Para equipos probando pipelines de extracción, esta pieza sobre web scraping con PHP bajo condiciones de bloqueo del mundo real es relevante.
Cuanto más valiosos son los datos ocultos, más agresivamente las plataformas defienden el camino hacia ellos.
Para operaciones de anuncios, el patrón usual es simple. Construye tu columna vertebral en acceso oficial. Agrega abstracciones unificadas donde ahorren tiempo de ingeniería. Toca métodos no oficiales solo cuando puedas permitirte el riesgo operacional y de políticas.
Navegando autenticación y límites de tasa de plataforma
Los equipos rara vez pierden acceso a API porque no pueden escribir una solicitud. Lo pierden porque el manejo de tokens es descuidado y los presupuestos de solicitudes no están modelados.
La autenticación falla de formas aburridas
La mayoría de problemas de producción alrededor de autenticación son autoinfligidos. Los tokens expiran. Los flujos de refresco fallan sin ser detectados. Un servicio almacena credenciales correctamente mientras otro las escribe al entorno equivocado. Un worker reintenta con un bearer token viejo hasta que la cuenta es marcada.
Verás los mismos bloques de construcción una y otra vez:
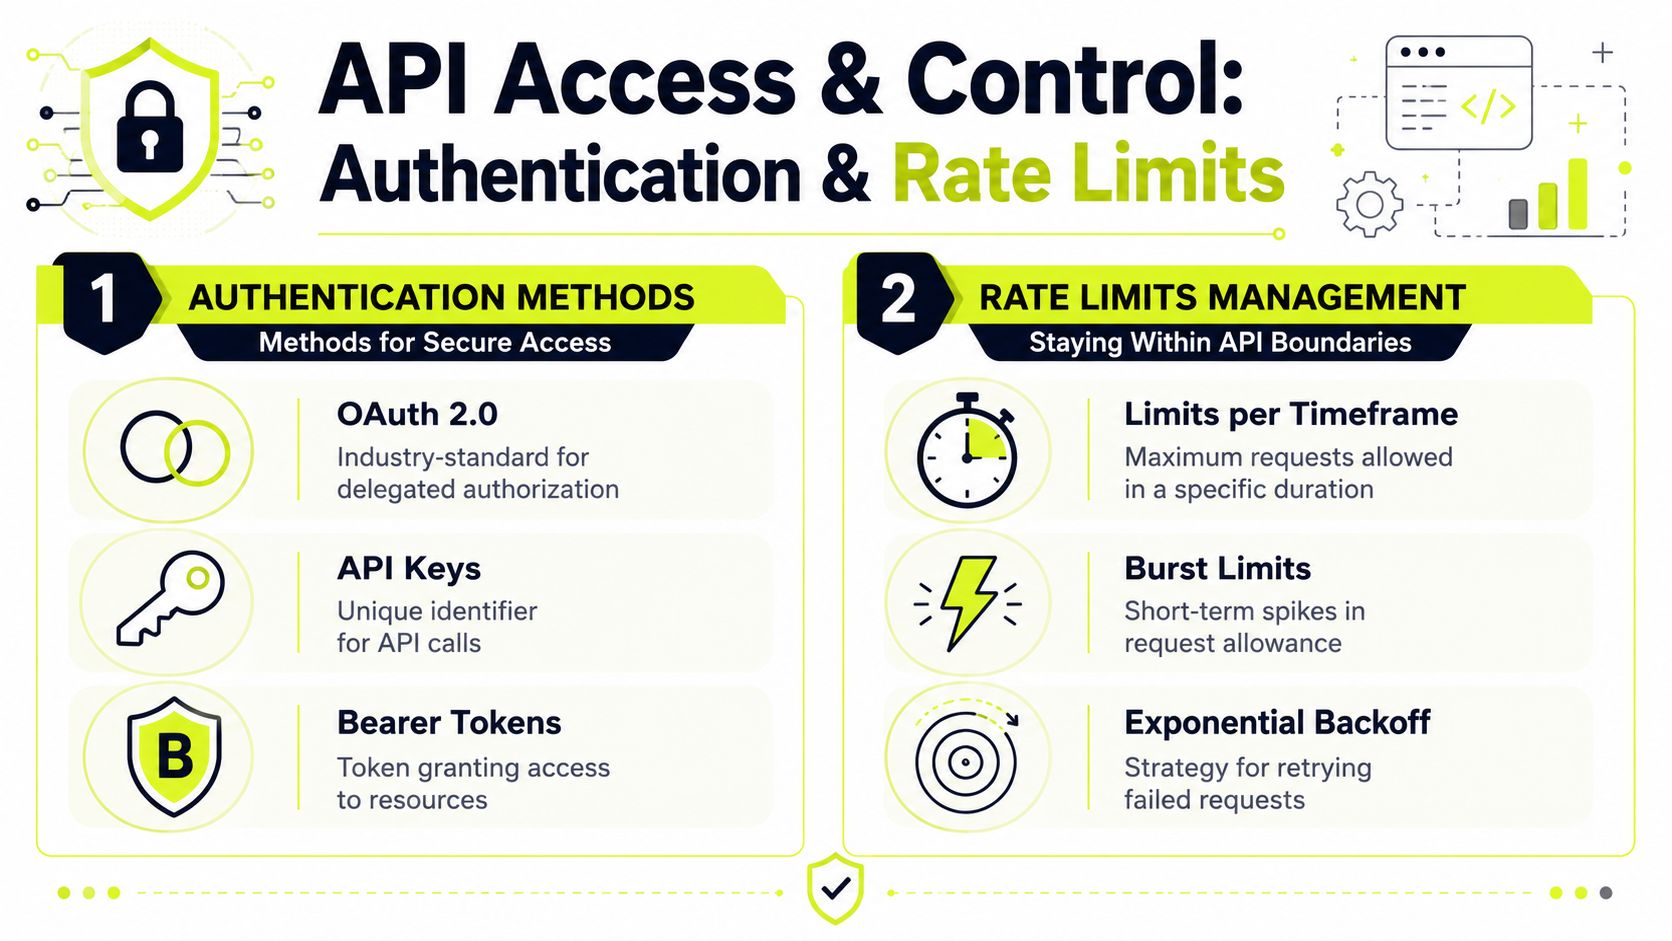
- OAuth 2.0: común cuando los usuarios conectan cuentas y otorgan acceso delegado.
- API keys: útiles para identificación a nivel de app, pero usualmente no suficientes para acciones de usuario protegidas.
- Bearer tokens: estándar para solicitudes autenticadas después del handshake.
Para equipos de arbitraje, la preocupación práctica es mapear tokens a la entidad de cuenta correcta. Si tu sistema interno no separa claramente usuario, workspace, cuenta publicitaria, página, perfil de navegador y asignación geo, eventualmente publicarás desde el activo equivocado o extraerás datos al bucket de cliente incorrecto.
Un segundo problema aparece cuando los equipos mezclan sesiones de navegador y autenticación API descuidadamente. Un operador inicia sesión en un activo de TikTok o Facebook en Dolphin Anty, mientras un trabajo backend usa un estado de token desconectado para el mismo activo. Ese desajuste crea debugging confuso y puede verse sospechoso cuando las acciones no se alinean.
Los límites de tasa deciden el rendimiento
Las APIs de redes sociales están gobernadas por límites estrictos. La Graph API de Meta usa un modelo dinámico, con ejemplos como aproximadamente 200 × número de usuarios y 4,800 × número de impresiones para algunos endpoints de Instagram. X comúnmente aplica límites basados en endpoint sobre ventanas de 15 minutos, con muchos endpoints de lectura alrededor de 300 a 900 solicitudes por ventana. La Data API de YouTube usa una cuota predeterminada de 10,000 unidades por día. Pinterest tiene documentadas 1,000 solicitudes por día para acceso de prueba y hasta 100 solicitudes por segundo por app de usuario para acceso estándar, según el desglose de GetStream sobre límites de API de redes sociales.
Eso significa que el script que funciona en una página puede desmoronarse cuando lo ejecutas a través de muchas cuentas, muchos creativos y muchos trabajos de reportes a la vez.
Consejo operacional: Trata los límites de tasa como asignación de presupuesto, no como errores aleatorios.
Un ciclo de control funcional incluye:
- Lee headers de límite cuando estén disponibles. Almacena presupuesto restante y timing de reset centralmente.
- Encola por familia de endpoint. Publicación, analítica, comentarios y carga de medios no deberían competir en el mismo carril.
- Retrocede antes del fallo duro. Si las llamadas restantes son bajas, ralentiza los workers en lugar de dejarlos martillar contra 429s.
- Separa tareas urgentes de tareas bulk. Moderación de comentarios y pausas de campaña necesitan prioridad sobre trabajos de sincronización histórica.
Los equipos construyendo monitoreo o parsers junto a APIs sociales a menudo se benefician de la misma disciplina usada en pipelines de extracción estructurada. Esta guía sobre flujos de trabajo XML y Python para trabajos de parsing controlado es útil si estás diseñando workers conscientes de presupuesto.
Lo que suele funcionar
El patrón estable es aburrido y confiable. Usa acceso de corta duración donde la plataforma lo espera. Refresca temprano. Registra cada fallo de autenticación con contexto de cuenta. Construye throttlers por plataforma, no un switch de reintento global.
Lo que no funciona es pretender que los límites no importan porque tienes más servidores. Los límites de plataforma no se preocupan por cuántos workers arranques.
Endpoints principales de API para automatización y gestión
Una vez que la autenticación y las cuotas están manejadas, la siguiente pregunta es más simple. ¿Qué endpoints importan para los operadores?
Endpoints de publicación
Los endpoints de publicación son el punto de partida obvio. Estas son las rutas que crean publicaciones, cargan medios, programan contenido y a veces actualizan o eliminan elementos publicados previamente.
Para equipos de tráfico, publicar no es solo programación social. Es infraestructura de soporte para:
- Distribución de campaña geo-dirigida: empujar creativos localizados a páginas o perfiles específicos de región.
- Páginas de soporte de anuncios: mantener páginas de Facebook activas para que las cuentas publicitarias no apunten a activos con apariencia muerta.
- Seeding orgánico de TikTok: alimentar contenido en cuentas calientes vinculadas a embudos pagados.
En la práctica, usualmente enviarás payloads JSON conteniendo texto, referencias de medios, IDs de cuenta objetivo e instrucciones de programación. La parte importante no es el payload en sí. Es construir un mapeador para que cada cuenta obtenga el idioma correcto, variante de landing page y creativo seguro en cumplimiento.
Endpoints de lectura y analítica
Los endpoints de lectura extraen datos de perfil, estado de publicación, comentarios, superficies de seguidores y métricas seleccionadas. Los endpoints de analítica agregan datos de engagement, estado de entrega y señales relacionadas con campañas donde la plataforma las expone.
Esa capa es útil para varios trabajos reales:
- Verificación de publicación: confirmar que el activo se publicó y no falló en procesamiento.
- Enrutamiento de moderación: ingerir comentarios o mensajes y reenviarlos a colas internas.
- Triage creativo: comparar patrones de respuesta a nivel de publicación antes de reutilizar contenido en nuevas cuentas.
No esperes universalidad completa. Cada plataforma expone una porción diferente de la realidad. Algunas devuelven objetos ricos. Otras devuelven solo el mínimo necesario para dashboards simples.
Los webhooks superan el polling constante
El polling funciona a pequeña escala. Luego se vuelve derrochador.
Si la plataforma soporta webhooks, úsalos para eventos como nuevos comentarios, mensajes entrantes y actualizaciones de estado de publicación. Un diseño webhook-first reduce ruido, reduce solicitudes desperdiciadas y da a tu equipo ventanas de reacción más rápidas.
Polleas cuando debas. Suscríbete cuando puedas.
Eso importa cuando una cola de moderación soporta muchas páginas de Facebook, perfiles de TikTok y activos de marca auxiliares. Si tu sistema espera ciclos de polling para descubrir problemas, los operadores reaccionan tarde y las cuentas absorben riesgo innecesario.
Mejores prácticas para construir automatización confiable
La mayoría de automatización rota no fue ambiciosa. Fue subconstruida.
Muchos equipos escriben el happy path, lo prueban en una cuenta, luego lo apuntan a una flota. Ahí es cuando descubren brechas de paginación, tormentas de reintentos, publicaciones duplicadas y concurrencia que convierte throttling menor en disrupción de cuenta amplia.
Paginación primero
Si un endpoint devuelve listas, asume que la primera respuesta está incompleta. Comentarios, historiales de publicaciones, filas de analítica, hilos de bandeja de entrada e inventarios de cuentas casi siempre paginan.
Construye manejo de paginación antes de que te importe la velocidad.
- Flujos basados en cursor: sigue el token next exactamente como se devuelve.
- Flujos offset-limit: protege contra filas saltadas o duplicadas si los registros cambian entre solicitudes.
- Checkpointing: almacena progreso para que sincronizaciones de larga duración puedan reanudarse en lugar de reiniciar.
Esto importa para equipos de arbitraje que auditan muchas páginas de soporte o muchos activos de embudo a la vez. Un dataset parcial puede llevar a decisiones equivocadas, como pensar que una cola de moderación está vacía o que una publicación batch falló cuando las páginas posteriores nunca se obtuvieron.
Lógica de reintentos que no cause más daño
Los reintentos necesitan juicio. Un timeout de red temporal y un error de permiso duro no son lo mismo.
Usa un modelo de clasificación simple:
| Tipo de error | Respuesta correcta |
|---|---|
| Problema temporal de red | Reintentar con delay |
| Respuesta de límite de tasa | Retroceder y reencolar |
| Autenticación inválida | refrescar token o requerir reautenticación |
| Denegación de permiso | detener y escalar |
| Fallo de validación | arreglar payload, no reintentar ciegamente |
El backoff exponencial sigue siendo la regla general más segura. Agrega jitter para que pools grandes de workers no reintenten al unísono. Limita el conteo de reintentos para acciones de escritura. Una lectura de analítica duplicada es molesta. Una publicación duplicada puede crear desastre visible en activos en vivo.
Para equipos luchando contra bloqueos en workloads adyacentes de crawling y verificación, el pensamiento se superpone con práctica anti-ban estándar. Este artículo sobre cómo evitar bans de IP durante actividad automatizada se empareja bien con diseño de reintentos de API porque ambos dependen de pacing y manejo limpio de fallos.
Concurrencia con moderación
La concurrencia es útil hasta que deja de parecer comportamiento normal.
Algunos límites prácticos ayudan:
- Fragmenta por cuenta o workspace: no dejes que un cliente ruidoso muera de hambre a todos los demás.
- Separa lecturas de escrituras: leer métricas y publicar medios crean perfiles de riesgo diferentes.
- Usa claves de idempotencia donde sea posible: especialmente para llamadas de publicación y actualización.
- Throttlea acciones sensibles más duramente: envíos de mensajes, acciones de comentarios y ediciones repetidas activan atención más rápido que lecturas simples.
Lo que funciona es rendimiento medido. Lo que se rompe es intentar forzar a las plataformas sociales a comportarse como microservicios internos. No están construidas para tu conveniencia. Están construidas para proteger la plataforma primero.
El papel de los proxies y soluciones anti-bloqueo
Si estás operando muchas cuentas, la capa de API es solo parte de la imagen. La otra parte es si las plataformas creen que la actividad circundante es consistente.
Por eso los equipos serios separan automatización de API de gestión de identidad. Las APIs manejan el trabajo repetible de máquina. Los navegadores antidetect manejan las acciones que aún necesitan contexto completo de navegador. Los proxies pegan la capa de identidad para que páginas de Facebook, cuentas publicitarias de TikTok, perfiles calientes y activos de soporte no colapsen todos en un patrón de red visible.
Para qué es bueno cada tipo de proxy
Diferentes tipos de proxy resuelven diferentes problemas. Tratarlos como intercambiables es una de las formas más rápidas de quemar cuentas.
| Tipo de Proxy | Caso de uso principal | Score de confianza | Costo | Debilidad clave |
|---|---|---|---|---|
| Residencial | Creación de cuentas, gestión de cuentas, consistencia de login, acceso a cuenta publicitaria | Alto | Mayor | Más caro para trabajos bulk pesados |
| Móvil | Acciones sensibles en Instagram, TikTok y flujos de warm-up de alta fricción | Muy alto | Más alto | Costo y menor control de rendimiento |
| Datacenter | Scraping rápido, verificaciones de baja sensibilidad, herramientas internas, fetches bulk | Menor | Bajo | Más fácil para plataformas clasificar |
| IPv6 | Recolección bulk económica en objetivos que lo soportan | Bajo a medio | Bajo | Muchas plataformas y servicios aún lo tratan inconsistentemente |
Los proxies residenciales son el predeterminado para trabajo de cuentas serio porque las IPs parecen tráfico de usuario real. Si estás gestionando cuentas publicitarias de Facebook, envejeciendo identidades de TikTok, o iniciando sesión en activos a través de AdsPower o Multilogin, residencial suele ser la línea base más segura.
Los proxies móviles son más fuertes para acciones frágiles. Las plataformas a menudo tratan el tráfico de carrier móvil como comportamiento normal de consumidor. Por eso los equipos los usan para warm-up, recuperación o acciones que fallan repetidamente en clases de IP más débiles.
Los proxies de datacenter siguen siendo útiles. Son rápidos, baratos y fáciles de escalar para tareas no sensibles como verificaciones de página pública, QA o recopilación de datos no vinculados a cuenta. Son la herramienta equivocada para la mayoría del farming de cuentas o gestión de cuentas de alto valor.
IPv6 tiene un lugar en trabajo bulk donde el objetivo lo soporta bien. Puede ser rentable para scraping y tareas de cobertura amplia. Rara vez es la primera opción para operaciones de cuenta social sensibles.
Un buen proxy no es el que tiene el mejor marketing. Es el que coincide con los requisitos de confianza de la acción.
Fingerprinting y aislamiento de sesión
Un proxy solo no salvará una configuración mala. Si el fingerprint del navegador, timezone, idioma, comportamiento WebRTC, historial de cookies y geografía IP todos desacuerdan, la cuenta aún se ve mal.
Por eso los operadores emparejan proxies con navegadores antidetect como AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc. Cada cuenta obtiene su propio perfil de navegador, almacenamiento local, cookies, comportamiento de canvas y fingerprint estilo hardware. Hecho correctamente, eso crea entornos aislados para:
- Cuentas publicitarias de Facebook vinculadas a business managers específicos
- Cuentas publicitarias de TikTok adjuntas a pipelines creativos distintos
- Páginas de soporte farmed usadas en cloaking o caminos de aprobación
- Campañas geo-dirigidas que necesitan renderizado y revisión precisa por país
La clave es consistencia. Mantén la geografía IP alineada con el historial de cuenta. No rebotes una cuenta calentada a través de países no relacionados. No abras el mismo activo desde workflows impulsados por API que implican una región y sesiones de navegador que implican otra. No mezcles gestión limpia de página de soporte con scraping agresivo del mismo pool de identidad.
La estrategia de rotación también importa. Las sesiones sticky ayudan cuando la continuidad de cuenta importa. La rotación frecuente ayuda cuando estás recopilando datos públicos a escala. Si tu equipo está ajustando esos trade-offs, esta guía sobre rotación de IP proxy para cargas de trabajo de automatización vale la pena leer.
Algunos operadores también compensan costos de proxy refiriendo a otros equipos una vez que se establecen en un stack de proveedor. Si eso importa en tu modelo de negocio, programas que ofrecen hasta 40% de comisión pueden convertir referencias de infraestructura en una línea de ingresos secundaria. No arreglará operaciones malas, pero puede reducir la presión de costo de herramientas.
Restricciones legales y términos de servicio de plataforma
Muchos operadores piensan que la única pregunta real es si un método funciona. Esa mentalidad es costosa.
La mejor pregunta es si el método funciona lo suficiente, bajo el sobre de riesgo correcto, sin derribar las cuentas, clientes o infraestructura adjunta a él. Farming de cuentas, cloaking, gestión multi-cuenta y extracción de datos agresiva todos se sientan en un espectro de tolerancia de plataforma. Algunas tácticas son meramente frágiles. Otras son violaciones directas de términos.
El método de escalamiento más rápido puede ser el más efímero
El trade-off más difícil en trabajo de API para redes sociales no es técnico. Es acceso versus cumplimiento.
Orientación reciente advierte que obtener datos fuera de canales oficiales de API puede entrar en áreas grises legales y puede violar términos de plataforma, y que los equipos enfrentan cada vez más una elección entre APIs oficiales cumplidas pero limitadas y cobertura más amplia que viene con restricciones de políticas y confiabilidad, según la nota de la Universidad de Bath sobre restricciones de API y acceso de investigación.
Eso importa mucho más allá de la investigación académica. Golpea directamente a operadores comerciales cuando scrapean feeds públicos, hacen ingeniería inversa de endpoints privados o construyen automatización que imita comportamiento de usuario estándar para eludir restricciones publicadas.
Qué consigue que suspendan a los equipos
La mayoría del daño a largo plazo proviene de apilamiento de patrones. Una táctica agresiva podría sobrevivir por sí sola. Varias juntas crean una señal clara.
Los disparadores comunes incluyen:
- Farming de cuentas sin aislamiento: muchas cuentas creadas o gestionadas con señales de dispositivo y red superpuestas.
- Cloaking con caminos de revisión inconsistentes: los revisores ven una experiencia mientras los usuarios de tráfico pagado ven otra.
- Automatización no aprobada de acciones restringidas: especialmente mensajería, inflación de engagement o ediciones repetidas a escala.
- Scraping comercial que ignora límites de plataforma: incluso cuando los datos de front-end parecen públicos.
Si estás ejecutando campañas geo-dirigidas, ten especial cuidado con reglas de privacidad locales y manejo de consentimiento. La automatización social a menudo toca datos de usuario, comentarios, mensajes y metadata de perfil. Tu código no se vuelve cumplidor solo porque el endpoint devuelve un payload.
Si perder el activo dañaría los ingresos, no pruebes límites legales en ese activo.
Los equipos inteligentes aíslan el riesgo por propósito. Mantienen operaciones de anuncios principales más limpias que recopilación de datos experimental. Separan gestión de página de soporte de infraestructura de scraping. Evitan vincular sus cuentas publicitarias de Facebook y TikTok más valiosas a los mismos entornos usados para recopilación de zona gris o flujos de revisión cloaked.
Los equipos que duran no son los que automatizan más. Son los que saben dónde la automatización deja de ser efectiva y comienza a ser evidencia.
Si tu stack depende de IPs estables, geo-targeting limpio y sesiones aisladas a través de navegadores antidetect, Sota Proxy está construido para ese tipo de carga de trabajo. Soporta gestión de cuentas, verificación de anuncios, scraping y operaciones multi-cuenta con opciones residenciales, móviles, ISP, datacenter e IPv6. Si ya trabajas con otros compradores o equipos de farm, Sota Proxy también tiene un programa de afiliados con hasta 40% de comisión por referencias.
Artículos relacionados

Clave API de Bing Search: Configuración, Pruebas y Escalado en 2026
Obtén una clave API de Bing Search funcional en 2026, prueba solicitudes, protege la clave y escala scraping de alto volumen sin bloqueos. Guía práctica para equipos técnicos.

10 Formas de Recopilar Datos Cualitativos para Compradores de Medios
Descubre 10 formas de recopilar datos cualitativos de tus usuarios. Aprende métodos como entrevistas y grupos focales para optimizar el uso de proxies y la estrategia de campañas.
Para Qué Se Usa un Proxy: Guía de Arbitraje 2026
Para qué se usa un proxy - Descubre para qué se utiliza un proxy en 2026, desde mejorar la seguridad hasta gestionar operaciones multiaccount para equipos de arbitraje
ERR_TUNNEL_CONNECTION_FAILED: el nombre del error ya es el diagnóstico
Chrome le pidió a un proxy que abriera un túnel CONNECT y falló. Eso es todo el error. De dónde sale ese proxy cuando nunca configuraste ninguno, las seis razones por las que un proxy configurado puede generar este error, y por qué limpiar la caché no soluciona nada.
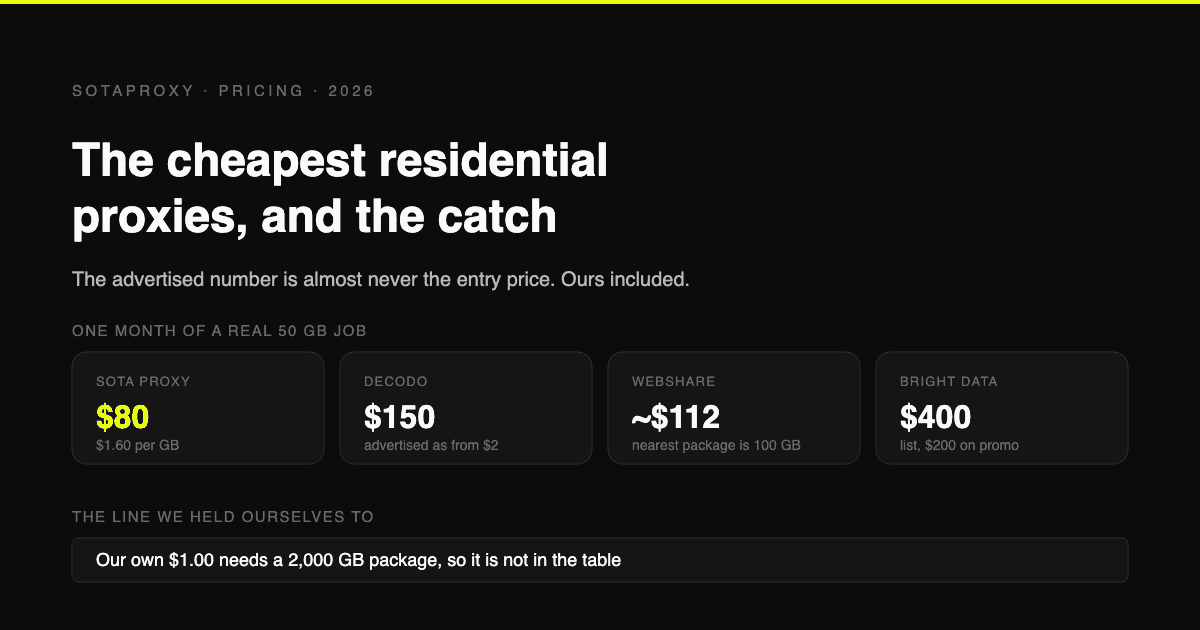
Los proxies residenciales más baratos en 2026 y la trampa que esconde cada uno
Precios verificados por gigabyte directamente de las páginas de cinco proveedores, no de artículos del año pasado. Por qué el precio anunciado casi nunca es el de entrada, qué proveedores te obligan a un mínimo mensual y cómo calcular tu coste real por gigabyte.
¿Cuántas cuentas de Telegram puedes tener en 2026 (y qué significa realmente estar "limitado")?
Telegram no publica un límite oficial de cuentas, exige un número por cuenta, y su propio FAQ de spam indica que una cuenta limitada puede seguir enviando mensajes a quien tenga tu número guardado. Qué activa las restricciones, por qué los números VoIP se bloquean antes de enviar un solo mensaje y por qué no existe liberación anticipada.