Web Scraping PHP: Una Guía para Operadores y Arbitraje
Construye bots confiables de web scraping php para multi-cuentas, verificación de anuncios y cloaking. Aprende a manejar JS, rotar proxies y evadir bloqueos. Para operadores.
Tu scraper PHP probablemente funcionó bien en un sitio de prueba. Luego lo apuntaste a un objetivo real usado para verificación de anuncios, monitoreo de competidores, verificaciones de cloaking o farming de cuentas, y se desmoronó. Obtuviste una página de acceso denegado, marcado semi-renderizado, nodos vacíos o una respuesta de éxito falsa con HTML inútil.
Esa brecha es donde la mayoría de los tutoriales dejan de ser útiles. Los operadores reales que scrapean landing pages, embudos de afiliados, tiendas, superficies de anuncios de Facebook o páginas creativas de TikTok no solo necesitan selectores. Necesitan un flujo de trabajo que sobreviva al renderizado de JavaScript, rotación de proxies, verificaciones de huellas del navegador, respuestas geo-localizadas y límites de velocidad. Si estás ejecutando campañas a través de múltiples cuentas publicitarias en AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc, tu scraper es parte de la misma infraestructura. Tiene que comportarse como tal.
Tabla de Contenidos
- Por Qué Tu Scraper PHP Básico Está Fallando
- Eligiendo Tu Kit de Herramientas de Scraping PHP
- Construyendo la Lógica Central de Scraping
- Manejando Sitios Web Impulsados por JavaScript
- Integrando Proxies para Evasión y Geo-Targeting
- Evasión Avanzada y Contramedidas Anti-Bot
- Escalando Tus Operaciones de Scraping PHP
Por Qué Tu Scraper PHP Básico Está Fallando
Una llamada cruda a file_get_contents() funciona en sitios que te entregan el contenido principal en la primera respuesta HTML. Eso todavía existe, pero no es el entorno en el que operan la mayoría de los equipos de media buying. La primera vez que scrapeas un objetivo vinculado a cuentas publicitarias de Facebook, cuentas publicitarias de TikTok, flujos de farming de cuentas o tiendas geo-localizadas, golpeas sistemas diseñados para clasificar el tráfico rápidamente.
El patrón de fallo es predecible. Tu script busca una página y obtiene una de cuatro cosas: una página de desafío, HTML incompleto, una variante localizada que no esperabas o marcado que solo tiene sentido después de que se ejecute JavaScript del lado del cliente. El scraper no está roto. Tus suposiciones sí.
El código básico de obtener-y-parsear falla porque los objetivos modernos no solo sirven páginas. Evalúan patrones de solicitud, reputación de IP, headers, cookies, comportamiento de sesión y a veces el entorno completo del navegador.
Eso importa para los equipos de arbitraje. Si estás verificando páginas cloakeadas, validando colocaciones de anuncios o monitoreando disponibilidad de ofertas por geo, la respuesta incorrecta es peor que ninguna respuesta. Envenena tus datos y empuja malas decisiones hacia la asignación de gasto.
Qué se rompe primero en producción
- Contenido renderizado por JavaScript aparece vacío en PHP porque el parseo estándar del DOM no ejecuta código del lado del cliente.
- Verificaciones de identidad marcan el tráfico de bot obvio. Una solicitud simple con headers débiles y una IP de datacenter ruidosa se nota rápidamente.
- Verificaciones geo devuelven la versión de mercado incorrecta, lo que arruina precios locales, idioma y verificaciones de cumplimiento.
- Flujos dependientes de sesión se rompen si no persistes cookies o sigues las mismas transiciones de estado que haría un navegador.
Si estás ejecutando configuraciones multi-cuenta en GoLogin, AdsPower, Dolphin Anty, Multilogin o Hidemyacc, ya sabes que la identidad está en capas. Un scraper que ignore esa capa no durará.
Eligiendo Tu Kit de Herramientas de Scraping PHP
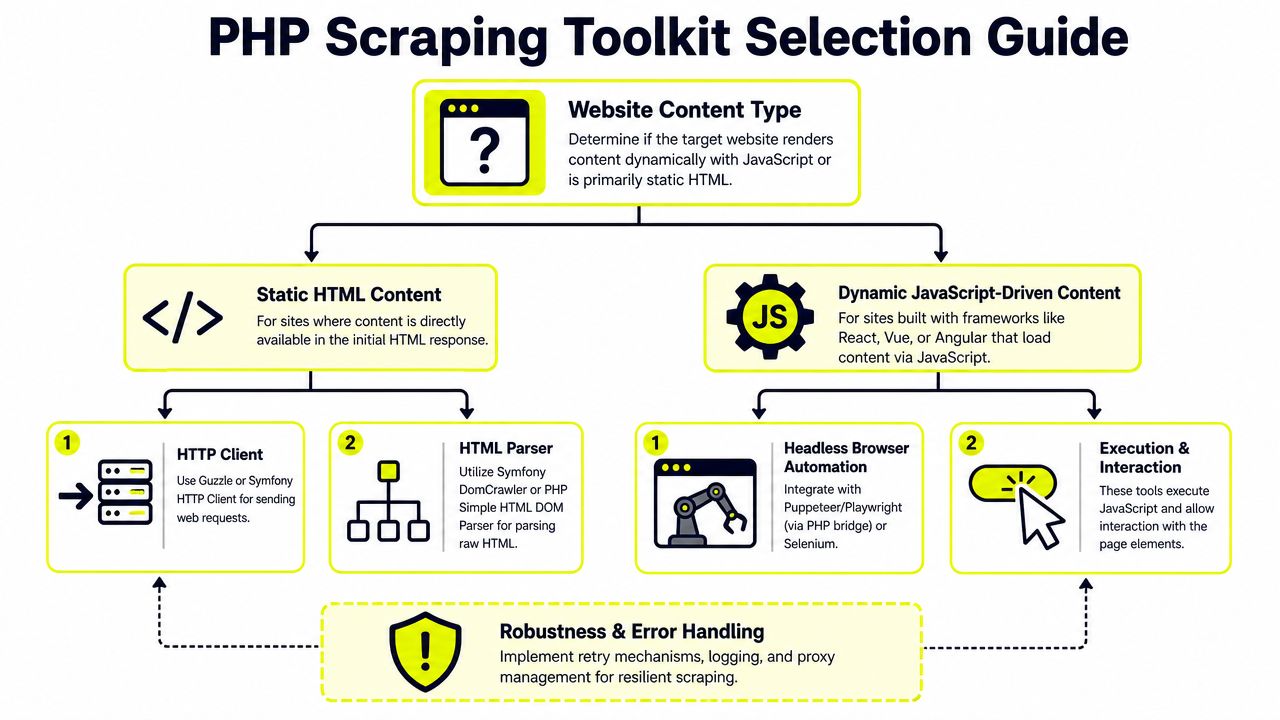
El scraping PHP ha madurado hacia una pila de componentes en lugar de una única librería mágica. En la práctica, el web scraping con PHP funciona mejor cuando divides el trabajo en manejo de solicitudes, parseo y ejecución del navegador cuando sea necesario. Ese cambio desde herramientas todo-en-uno obsoletas como Goutte hacia componentes mantenidos como BrowserKit y DomCrawler está documentado en la descripción general de Firecrawl de pilas modernas de scraping PHP.
Los objetivos estáticos necesitan una separación limpia
Para páginas estáticas, mantén la pila aburrida.
Usa un cliente HTTP para buscar la página. Usa un parser para extraer datos. No mezcles esas preocupaciones a menos que estés escribiendo un script desechable. Las combinaciones confiables en el ecosistema PHP están bien establecidas:
- Guzzle para solicitudes cuando necesitas headers, cookies, timeouts, reintentos y soporte de proxy.
file_get_contents()cuando el trabajo es pequeño y controlas el entorno.- DOMDocument y DOMXPath cuando quieres cero dependencias extras de parser.
- Symfony DomCrawler cuando quieres una API de recorrido más limpia y mejor mantenibilidad a largo plazo.
- Roach PHP cuando el trabajo se parece más a un crawl que a una única búsqueda.
Qué usar y qué dejar atrás
Si estuviera armando una pila de scraping para un equipo de media buying hoy, no comenzaría con viejos wrappers de conveniencia. Usaría Guzzle + DomCrawler para la mayoría de los objetivos estáticos, y solo agregaría automatización del navegador después de probar que el objetivo lo necesita.
Aquí está el desglose práctico:
| Herramienta | Úsala para | Buena en | Punto débil |
|---|---|---|---|
| Guzzle | Solicitudes HTTP | Headers, cookies, config de proxy, control de solicitud | No parsea HTML |
| DOMDocument + DOMXPath | Parseo nativo | Integrado en PHP, funciona bien con XPath | Verboso |
| Symfony DomCrawler | Parseo estructurado | Recorrido más limpio, se integra bien con la pila Symfony | Aún solo parseo estático |
| Roach PHP | Flujos de crawl grandes | Spiders, pipelines, middleware, programación | Más configuración que un scraper de un archivo |
| BrowserKit + DomCrawler | Flujo simulado de navegador en sitios estáticos | Formularios, enlaces, patrones de crawler | Sin ejecución de JS del lado del cliente |
Muchas guías antiguas todavía mencionan Goutte. No construyas trabajo nuevo alrededor de ella. Esa librería se trata como obsoleta en las guías más nuevas de scraping PHP, y el camino mantenido es la pila Symfony BrowserKit más DomCrawler.
Regla práctica: Elige la herramienta más ligera que coincida con el objetivo. Si la respuesta HTML contiene los datos, no lances un navegador. Si la respuesta no contiene los datos, ningún parser te salvará.
Para casos de uso de arbitraje, esa elección importa. Un simple monitor de página de producto para verificaciones de cloaking podría funcionar bien en Guzzle. Un flujo de landing de TikTok con elementos renderizados, localización y puertas de interacción no lo hará.
Construyendo la Lógica Central de Scraping
Para objetivos estáticos, el pipeline central es simple: envía una solicitud GET, parsea el HTML, extrae con selectores, luego avanza a través de la paginación cuidadosamente. Ese flujo de trabajo exacto se muestra en el tutorial de scraping PHP de FreeCodeCamp con loadHTML(), DOMXPath, extracción basada en selectores, sleep(1) y ritmo de reintentos.
Un scraper base que resiste
Comienza con Guzzle para la solicitud. Luego parsea con herramientas DOM nativas o DomCrawler. La ruta nativa es suficiente para muchos trabajos:
<?php

require 'vendor/autoload.php';

use GuzzleHttp\Client;

$client = new Client([
    'timeout' => 20,
    'headers' => [
        'User-Agent' => 'Mozilla/5.0',
        'Accept-Language' => 'en-US,en;q=0.9',
    ],
]);

$response = $client->request('GET', 'https://example.com');
$html = (string) $response->getBody();

libxml_use_internal_errors(true);

$doc = new DOMDocument();
$doc->loadHTML($html);

$xpath = new DOMXPath($doc);

$items = $xpath->query('//article');
foreach ($items as $item) {
    $titleNode = $xpath->query('.//h2', $item)->item(0);
    $priceNode = $xpath->query('.//*[contains(@class, "price")]', $item)->item(0);

    $title = $titleNode ? trim($titleNode->textContent) : null;
    $price = $priceNode ? trim($priceNode->textContent) : null;

    if ($title || $price) {
        print_r([
            'title' => $title,
            'price' => $price,
        ]);
    }
}
La línea libxml_use_internal_errors(true) no es cosmética. Las páginas reales a menudo contienen marcado malformado. Sin ella, loadHTML() puede inundar logs o fallar de maneras que pierden tiempo durante ejecuciones largas.
Muchos equipos omiten esto y solo descubren el problema después de un crash del parser durante una ventana de crawl.
Paginación sin actuar como un inundador
La paginación es donde los scripts principiantes se convierten en riesgo operacional. El patrón común es detectar el formato de URL de la página o seguir el enlace siguiente. Ambos funcionan. Lo que importa es el ritmo, el comportamiento de reintento y la capacidad de reanudación.
Usa algo como esto:
<?php

$nextUrl = 'https://example.com/page/1';
$failed = [];

while ($nextUrl) {
    try {
        $response = $client->request('GET', $nextUrl);
        $html = (string) $response->getBody();

        libxml_use_internal_errors(true);
        $doc = new DOMDocument();
        $doc->loadHTML($html);
        $xpath = new DOMXPath($doc);

        // extraer registros aquí

        $nextNode = $xpath->query('//a[contains(., "Next")]')->item(0);
        $nextUrl = $nextNode ? $nextNode->getAttribute('href') : null;

        sleep(1);
    } catch (\Throwable $e) {
        $failed[] = $nextUrl;
        sleep(2);
        // la lógica de reintento podría continuar con 4 y 8 segundos
        $nextUrl = null;
    }
}
Los hábitos útiles de producción son:
- Registra URLs fallidas para que puedas reanudar en lugar de reiniciar el trabajo completo.
- Usa backoff para fallos temporales. Una secuencia simple de 2, 4 y 8 segundos es suficiente para evitar martillar un objetivo inestable.
- Duerme entre páginas incluso en sitios amigables.
sleep(1)es una línea base normal. - Almacena HTML crudo en fallos del parser para que puedas inspeccionar lo que el objetivo devolvió.
Si quieres más patrones para mantener scrapers después del lanzamiento, el blog de proxies y automatización de Sota Proxy vale la pena mantener en tu lista de referencias.
Más adelante en el flujo de trabajo, cuando te muevas a proxies y manejo de sesiones, esta misma lógica se mantiene. La capa de búsqueda cambia. La disciplina no.
Un tutorial corto ayuda si estás entrenando a un junior en el equipo:
Manejando Sitios Web Impulsados por JavaScript
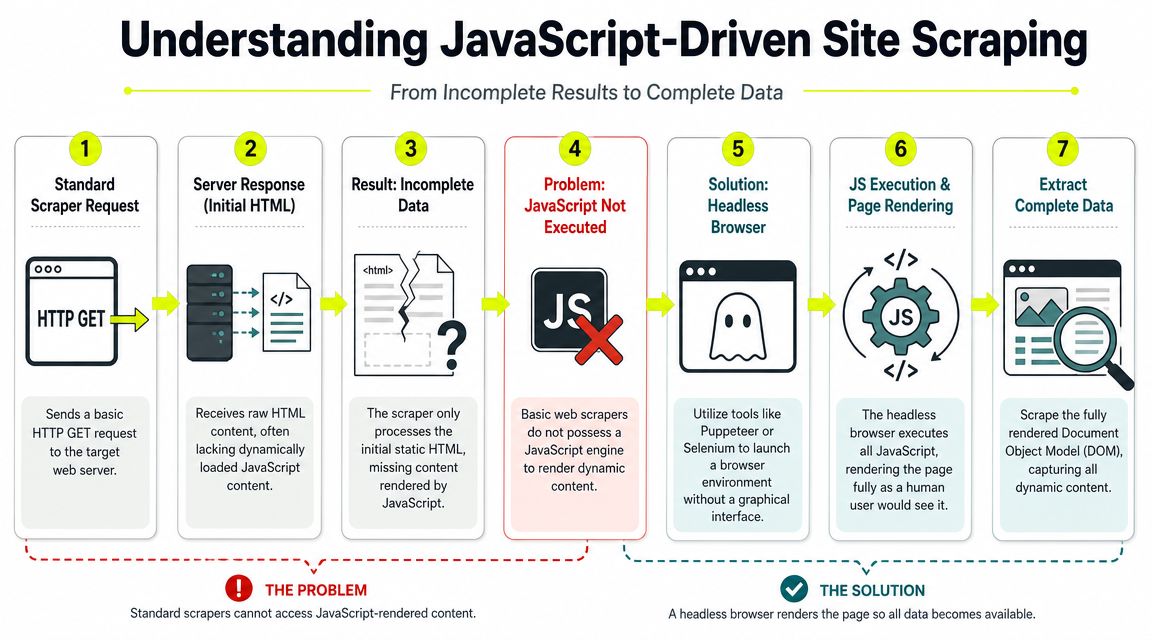
Muchos trabajos fallidos de web scraping PHP no son problemas de parseo. Son problemas de renderizado. Las guías recientes de PHP todavía pasan la mayor parte de su tiempo en HTML estático, aunque muchos objetivos en vivo ahora renderizan contenido a través de JavaScript y requieren una ruta de extracción diferente. Esa brecha se señala en la discusión de Scrape.do sobre scraping PHP avanzado y los límites del parseo DOM simple en sitios pesados en JavaScript.
Cómo saber cuándo PHP solo no funcionará
Abre el objetivo en tu navegador e inspecciona dos cosas:
- Ver fuente, no solo el DOM de devtools.
- Actividad de red después de la carga de la página.
Si los datos que necesitas no existen en el HTML fuente inicial, Guzzle más DOMXPath no los extraerán. Eso es común en sitios React, Vue y Angular. También es común en librerías de anuncios internas, filtros de tiendas, paneles de cuentas y páginas de reseñas cloakeadas.
Signos típicos:
- el HTML inicial contiene marcadores de posición o marcado shell
- el contenido aparece solo después de llamadas XHR o fetch
- la paginación está vinculada a scroll o interacción de botón
- los campos clave llegan a través de solicitudes API en segundo plano
- las verificaciones anti-bot se ejecutan antes de que se muestre el contenido real
Si scrapeas la fuente y obtienes contenedores vacíos, deja de agregar selectores. Estás resolviendo el problema equivocado.
Navegador sin cabeza o capa de renderizado
Tienes dos opciones viables.
La opción uno es automatización del navegador. En PHP, eso generalmente significa Symfony Panther, bindings de Selenium o un puente a Puppeteer o Playwright. Esto te da ejecución de página real, actualizaciones del DOM, clics, esperas, persistencia de cookies e interacción con botones, formularios o contenido de carga diferida.
La opción dos es una capa de renderizado externa. Eso puede ser un servicio de navegador, una API de scraping o un servicio Node dedicado que PHP llama. Esto suele ser más limpio para equipos que ya tienen PHP en producción pero no quieren orquestación de navegador local en cada worker.
Aquí están las compensaciones:
| Método | Buen ajuste | Compensación |
|---|---|---|
| Symfony Panther | Pilas centradas en PHP que necesitan ejecución de navegador real | Más presión de CPU y memoria |
| Puppeteer o Playwright vía puente | Sitios JS complejos con pasos de interacción | Capa de servicio extra y más partes móviles |
| Selenium | Entornos de automatización de navegador existentes | Infraestructura más pesada |
| API de renderizado | Equipos que quieren que PHP permanezca ligero | Menos control sobre el flujo de navegador de bajo nivel |
Para superficies de Facebook y TikTok, generalmente no confío en un parser DOM puro hasta que pruebo que el contenido está en el cuerpo de respuesta. Lo mismo ocurre con flujos de farming de cuentas, verificaciones de perfil y validación de ofertas específicas por geo. Las páginas dinámicas a menudo necesitan ejecución de navegador más una capa de identidad estable. En ese punto, el scraper comienza a parecerse menos a un script y más a un sistema de automatización.
Integrando Proxies para Evasión y Geo-Targeting
Si estás scrapeando más que un puñado de páginas, los proxies dejan de ser opcionales. No son solo para evitar baneos. También son cómo obtienes la versión correcta de la página. Para equipos de arbitraje, eso significa verificar la misma oferta como un usuario en el país objetivo, validar la entrega creativa por región y ver qué embudos de Facebook o TikTok muestran desde ese mercado.
Elige el tipo de proxy por objetivo, no por precio
Los proxies baratos crean datos malos costosos. El proxy correcto depende del objetivo y del patrón de sesión.
| Tipo de Proxy | Caso de Uso Principal | Riesgo de Detección | Rendimiento | Costo |
|---|---|---|---|---|
| Datacenter | Scraping rápido de objetivos de baja sensibilidad, recopilación masiva, páginas públicas | Alto | Alto | Bajo |
| Residencial | Verificación de anuncios, e-commerce, superficies sociales, contenido localizado | Medio | Medio | Más alto |
| Móvil | Plataformas sociales sensibles, flujos tipo app, trabajo de identidad de alta confianza | Menor | Medio | Más alto |
| IPv6 | Tareas de gran volumen en objetivos que aceptan IPv6 limpiamente | Varía según objetivo | Alto | Bajo |
Algunas reglas prácticas importan más que el marketing de proveedores:
- Los proxies de datacenter son rápidos y baratos. Funcionan para sitios estáticos, descubrimiento amplio y objetivos con defensas débiles. Se marcan más rápido en plataformas sociales y objetivos de comercio de alto valor.
- Los proxies residenciales son el predeterminado para scraping serio. Se ven más como tráfico de usuario ordinario y funcionan mejor para campañas geo-localizadas, verificación de anuncios y verificaciones de tiendas.
- Los proxies móviles son útiles cuando la confianza importa más que el rendimiento. Si estás tocando flujos de cuentas de Facebook, verificaciones de cuentas de TikTok o rutinas de farming sensibles, el móvil a menudo sobrevive más tiempo.
- Los proxies IPv6 pueden ser útiles para volumen, pero la compatibilidad del objetivo decide si son prácticos. Algunos sitios los manejan bien. Otros los tratan como tráfico de borde y se comportan de manera diferente.
No incluí proxies ISP en la tabla porque pediste tipos de proxy específicos, pero merecen una mención. Se ajustan bien a sesiones de larga duración. Si necesitas una identidad pegajosa para verificaciones repetidas, los proxies ISP a menudo tienen más sentido que la rotación agresiva.
La rotación residencial suele ser la línea base segura para scrapear páginas vinculadas a geo, comercio o revisión de anuncios. Móvil es para objetivos más difíciles. Datacenter es para velocidad cuando la confianza no importa mucho.
Conectando proxies en Guzzle
La integración en sí es fácil. Las reglas operacionales alrededor de ella son la parte difícil.
<?php

use GuzzleHttp\Client;

$client = new Client([
    'proxy' => 'http://username:password@proxy-gateway:port',
    'timeout' => 30,
    'headers' => [
        'User-Agent' => 'Mozilla/5.0',
        'Accept-Language' => 'en-US,en;q=0.9',
    ],
]);

$response = $client->request('GET', 'https://example.com');
echo (string) $response->getBody();
Lo que necesitas decidir es:
Sesión rotatoria o pegajosa
- rotatoria para crawling amplio, verificaciones de anuncios por muchas regiones y tareas de alta solicitud
- pegajosa para flujos de login, verificaciones de estado de cuenta y cualquier cosa vinculada a cookies
Targeting por país o ciudad
- nivel de país es suficiente para la mayoría de las verificaciones de ofertas
- nivel de ciudad importa cuando la entrega de anuncios o el inventario local cambia por metro
Calidad del pool
- los pools ruidosos se queman más rápido
- los pools limpios importan si estás usando la misma infraestructura tanto para scraping como para automatización del navegador
Para equipos que conectan proxies en flujos basados en navegador, Sota Proxy documenta rutas de integración en su página de integraciones de proxy. Eso es útil si estás dividiendo el trabajo entre buscadores PHP y sesiones de navegador en herramientas antidetect.
También hay un ángulo de negocio que a algunos operadores les importa. Si tu equipo ya recomienda infraestructura a clientes o compradores downstream, Sota Proxy tiene un programa de referidos con hasta 40% de comisión a través de su configuración de afiliados, descrito en los materiales de producto de la compañía. Menciónalo solo si eso se ajusta a tu operación. El punto central sigue siendo el ajuste de infraestructura, no los ingresos secundarios.
Evasión Avanzada y Contramedidas Anti-Bot
Un proxy solo cambia de dónde proviene la solicitud. No arregla una mala historia de navegador. Los objetivos califican el perfil de solicitud completo. Miran headers, idioma, continuidad de sesión, comportamiento de cookies, flujo de navegación y a veces si la huella del navegador coincide con el entorno reclamado.
Headers, cookies y sesiones creíbles
La forma más rápida de ser bloqueado es enviar solicitudes estériles a escala. No rotes solo IPs. Rota el contexto de solicitud de manera controlada.
Usa un conjunto de headers realista:
- User-Agent que coincida con una familia de navegador real y plataforma
- Accept-Language alineado con tu geo de proxy
- Referer cuando el flujo normalmente tiene uno
- Cookies persistidas para visitas repetidas
- Comportamiento de sesión que no restablece la identidad en cada solicitud
Si estás scrapeando un catálogo público, la gestión ligera de headers es suficiente. Si estás verificando flujos de landing de anuncios, embudos cloakeados o páginas vinculadas a cuentas, necesitas continuidad de sesión. Eso significa cookie jars, asignación de proxy estable durante la sesión y menos cambios abruptos.
Una lista de características como la que está en la página de características de la plataforma de Sota Proxy es útil cuando estás emparejando sesiones pegajosas, controles de rotación y targeting de ubicación con un diseño de scraper.
Transferencia a navegador antidetect
Para algunos objetivos, el PHP puro no debería ser la última milla.
Si el trabajo involucra cuentas publicitarias de Facebook, cuentas publicitarias de TikTok, calentamiento de cuentas, farming de cuentas o verificaciones de campañas cloakeadas, un navegador antidetect a menudo necesita poseer la sesión. AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc existen por la misma razón operacional. Le dan a cada perfil de navegador una huella coherente y estado de identidad persistente.
Un patrón práctico se ve así:
- PHP recopila objetivos. URLs, estados de ofertas, listas de regiones, referencias de librería de anuncios.
- La cola envía tareas de alto riesgo a workers de navegador.
- El navegador antidetect abre el perfil asignado con su proxy vinculado.
- La automatización del navegador realiza verificaciones que requieren renderizado, clics, estado de login o confianza de perfil.
- PHP recibe datos de resultado estructurados para almacenamiento y decisiones downstream.
Esta división funciona bien porque PHP sigue siendo excelente en orquestación, parseo, lógica de reintentos y limpieza de datos. Simplemente no debería pretender ser un navegador completo cuando el objetivo claramente se preocupa por la identidad del navegador.
Un scraper puede falsificar solicitudes. Un perfil antidetect mantiene una identidad. Esos son trabajos diferentes.
CAPTCHAs y límites operacionales
Los CAPTCHAs significan que el objetivo ha pasado de la puntuación pasiva al desafío activo. En ese punto, tienes tres opciones:
- Ruta de resolución manual para sesiones raras de alto valor
- Integración de servicio de resolución para manejo repetible de desafíos
- Rediseño del flujo de trabajo para que menos tareas golpeen páginas propensas a desafíos
No trates la resolución de CAPTCHA como la primera solución. Por lo general, la mejor solución está upstream. Reduce el ruido de solicitudes, mejora la calidad de sesión, desacelera, mantén el idioma y geo alineados, y deja de cruzar identidades entre cuentas.
Respeta también los límites técnicos. robots.txt no es un escudo legal ni un token de permiso, pero sigue siendo una señal útil para expectativas de crawl. Más importante es la disciplina simple. No sobrecargues objetivos. No rocíes reintentos ciegamente. No ejecutes lógica de farm y tráfico de scraping a través del mismo pool débil y esperes resultados estables.
Escalando Tus Operaciones de Scraping PHP
Un script PHP es útil. Un sistema de scraping es rentable. La diferencia es el control de trabajos, aislamiento de workers y recuperación de fallos.
Pasa de scripts a workers
A escala, deja de ejecutar bucles largos desde cron y esperar que terminen. Pon trabajos en una cola. Redis y RabbitMQ son opciones comunes porque te permiten desacoplar la programación de la ejecución.
Un diseño limpio se ve así:
- Productor crea trabajos desde necesidades de campaña, listas geo o URLs monitoreadas.
- Cola almacena trabajo en búfer y controla la distribución.
- Workers buscan, parsean, renderizan o transfieren a sesiones de navegador.
- Capa de almacenamiento mantiene respuestas crudas, campos extraídos y logs de fallos separados.
- Supervisor reinicia workers muertos y rastrea fallos repetidos.
Esto importa para operaciones multi-cuenta. Un scrape fallido de página de producto es una cosa. Un trabajo fallido de verificación de Facebook impulsado por navegador vinculado a un perfil calentado es otra. Separa esas cargas de trabajo.
Concurrencia sin caos
PHP puede escalar el rendimiento de solicitudes si usas la concurrencia cuidadosamente. Guzzle admite patrones de solicitud concurrentes, lo cual es suficiente para objetivos estáticos que no requieren ejecución de navegador. Así es como reduces el tiempo de crawl sin abrir cien bucles descontrolados.
Algunas reglas lo mantienen sano:
- Agrupa por lotes por perfil de proxy para que una salida mala no envenene cada solicitud.
- Separa trabajos estáticos y renderizados porque sus costos de recursos son diferentes.
- Reintenta selectivamente en lugar de reproducir el lote completo.
- Rastrea razón de fallo por categoría. Timeout, página de bloqueo, fallo de parser, fallo de JS o desajuste geo.
Roach PHP también vale la pena considerar cuando la carga de trabajo se parece a un crawl real. Agrega spiders, pipelines, middleware y programación, lo que ayuda una vez que tu operación de scraping PHP ha superado los scripts independientes.
El estado final es simple. PHP maneja orquestación, parseo, almacenamiento y lógica de cola bien. Los workers de navegador manejan renderizado y acciones sensibles a la identidad. Los proxies manejan localidad y reputación. Las herramientas antidetect manejan sesiones de alta confianza. Una vez que esos roles están divididos correctamente, toda la pila se vuelve más fácil de mantener.
Si tus trabajos de scraping dependen de IPs geo-localizadas limpias, sesiones pegajosas o rotación que se ajusta a la automatización del navegador y workers PHP, Sota Proxy es una opción para evaluar junto con el resto de tu pila de infraestructura. Cubre tipos de proxy residencial, móvil, ISP, datacenter e IPv6, lo que lo hace utilizable tanto para buscadores PHP ligeros como para flujos de trabajo de navegador antidetect de mayor confianza.
Artículos relacionados

Balanceo de Carga de Proxies Explicado para Profesionales
Aprende cómo funciona el balanceo de carga de proxies para Facebook, TikTok y flujos de trabajo con múltiples cuentas. Cubre algoritmos, arquitecturas y mejores prácticas.
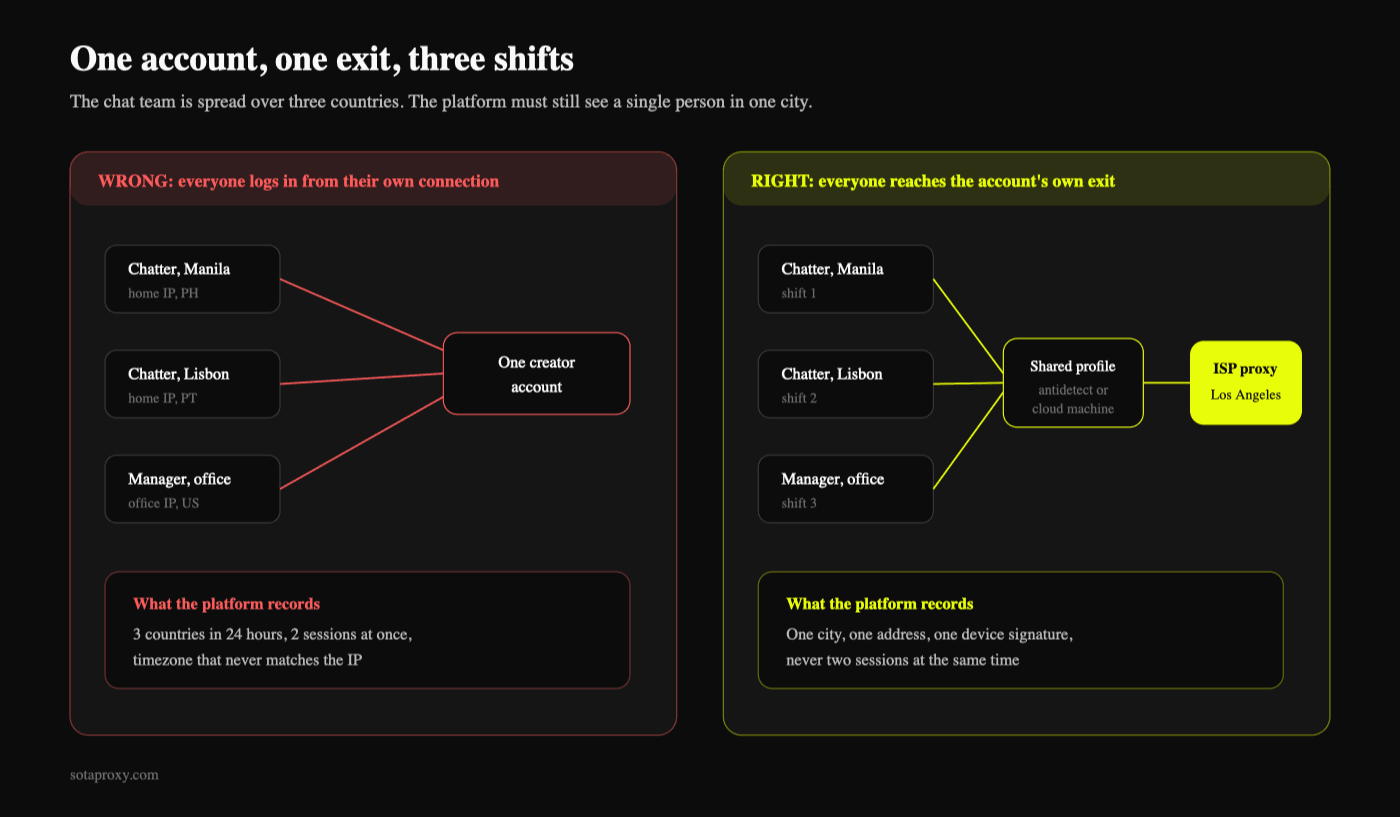
Cómo las agencias de OnlyFans gestionan 20 cuentas de creadores sin vincularlas
Qué vincula realmente las cuentas de creadores, qué tipo de proxy necesita cada una, cómo los chatters en tres países comparten un único inicio de sesión, y cuánto cuesta la capa de aislamiento frente a una comisión de agencia del 20 al 50 por ciento.
Compra Proxies para Geo Surfing que Realmente Funcionan
Aprende cómo comprar proxies para geo surfing de la manera correcta: elige tipos, selecciona ciudades objetivo, configura navegadores antidetect y valida resultados geo.

Cómo construir una infraestructura de protección de tráfico publicitario con Cloaking.House y SotaProxy
Aprende a construir un stack confiable de tráfico publicitario con proxies, perfiles de navegador y cloaking para pruebas GEO, filtrado y resolución de problemas de campañas.
Suplantación de Huella Digital: Métodos, Detección y Uso de Antidetect
Descubre cómo funciona la suplantación de huella digital, los métodos utilizados para eludir la detección y cómo los navegadores antidetect con proxies gestionan operaciones multi-cuenta de forma segura.
Monitoreo en Tiempo Real
Monitoreo en tiempo real. Supervisión en tiempo real para redes de proxies, cuentas publicitarias y stacks de scraping. Métricas, alertas, SLAs y tácticas prácticas