Dominando XML y Python para la Automatización de Cuentas Publicitarias
Aprende a dominar XML y Python para tecnología publicitaria. Esta guía muestra cómo analizar, consultar y modificar XML para cuentas publicitarias de Facebook/TikTok y farming de cuentas.
Descargas un feed de una red de afiliados, esperas una lista de productos limpia y obtienes un documento XML inflado con ofertas anidadas, reglas geográficas, parámetros de seguimiento y campos medio documentados. Luego necesitas enviar esos datos a flujos de trabajo de Facebook y TikTok, dividir creatividades por país, sincronizar configuraciones a nivel de cuenta en AdsPower o Multilogin, y mantener todo estable en docenas o cientos de perfiles.
Ahí es donde XML y Python todavía importan. No de manera nostálgica, como sistemas heredados. De manera práctica, en producción. Los equipos de arbitraje de tráfico todavía encuentran XML en feeds de socios, endpoints SOAP, exportaciones generadas por Office, datos empresariales firmados y archivos de configuración vinculados a stacks de automatización. Si gestionas cuentas publicitarias, configuraciones de farming de cuentas, reglas de cloaking o campañas geosegmentadas, necesitas un parser que no se desmorone cuando el feed se vuelve raro.
Python sigue siendo una de las formas más limpias de manejar ese trabajo. Sus herramientas XML integradas te dan suficiente para analizar, modificar y escribir XML sin agregar dependencias para trabajos básicos, y su ecosistema más amplio te da opciones más potentes cuando los feeds se vuelven grandes, las consultas se vuelven complejas o no se puede confiar en la entrada.
Tabla de Contenidos
- Por Qué Todavía Necesitas Dominar XML en 2026
- Eligiendo el Parser XML de Python Correcto
- Analizando y Consultando Datos XML con XPath
- Modificando y Escribiendo XML para Tareas de Automatización
- Optimizando el Rendimiento con Streaming y Proxies
- Manejo Seguro de XML y Mejores Prácticas
Por Qué Todavía Necesitas Dominar XML en 2026
Un comprador lanza una campaña en vivo a las 2 a.m. Las pujas están actualizadas, las creatividades están aprobadas y la lógica de segmentación se ve limpia en tu dashboard. Luego el feed del socio se actualiza en XML, un campo anidado cambia y la mitad de las reglas en tu cadena de automatización dejan de coincidir. Eso todavía es normal en tecnología publicitaria.
Los equipos de arbitraje heredan XML a través de sistemas antiguos de socios, endpoints de cumplimiento, exportaciones de facturación, plantillas de perfiles de dispositivos y APIs SOAP que nunca fueron reemplazadas. JSON ejecuta muchas herramientas modernas, pero los sistemas alrededor todavía hablan XML con frecuencia. En arbitraje de tráfico, eso generalmente significa un trabajo de Python extrayendo metadatos de ofertas, otro reescribiendo configuraciones de cuentas o navegadores, y un tercero validando reglas geográficas o de redirección antes de que se active el gasto.
Los equipos que manejan esto bien tratan XML como una dependencia operacional, no como una curiosidad heredada. Si ejecutas configuraciones de múltiples cuentas, flujos de trabajo de farming de cuentas, capas de cloaking o lanzamientos de campañas impulsados por feeds, los errores de XML no son académicos. Producen redirecciones incorrectas, mapeo de pagos roto, segmentación geográfica errónea y deriva de configuración silenciosa en docenas o cientos de cuentas.
Dónde todavía aparece XML en operaciones publicitarias
En producción, XML tiende a aparecer en algunos casos recurrentes:
- Feeds de socios: catálogos de ofertas, límites, cambios de pago, bloqueos de países y reglas de conversión.
- Infraestructura de cuentas: exportaciones de perfiles de navegador, plantillas de automatización, configuraciones de lanzamiento y ajustes específicos de herramientas.
- Cumplimiento y verificación: instantáneas de revisión, mapas de redirección, comprobaciones de contenido localizado y payloads de auditoría.
- Conectores heredados: servicios SOAP, datos de identidad firmados, exportaciones financieras y sistemas internos que nunca migraron a JSON.
AWS señala que XML todavía se usa ampliamente para el intercambio de datos sistema a sistema, publicación y flujos de trabajo de configuración en su descripción general de XML. Eso coincide con las operaciones publicitarias del día a día. XML sobrevive donde la disciplina de esquema, la compatibilidad y el anidamiento predecible todavía importan más que la preferencia del desarrollador.
El manejo manual de XML falla rápido. Un parche rápido de regex funciona una vez, luego falla con namespaces, nodos repetidos, contenido mixto o un campo opcional faltante de un socio. He visto pequeños errores de feed convertirse en cascada en errores de asignación de gasto que tomaron más tiempo diagnosticar que prevenir con análisis y validación adecuados.
Python sigue siendo útil aquí porque permite que los equipos construyan procesadores de feeds, transformadores de configuración y trabajos de validación lo suficientemente rápido para operaciones reales. Para grupos de arbitraje que extraen feeds a través de infraestructura rotativa, la recolección es solo una parte del pipeline. El análisis tiene que ser igual de confiable. Los equipos que ya trabajan con rotación de IP de proxy para flujos de trabajo de automatización generalmente aprenden esto después de que el primer trabajo de feed remoto tiene éxito en la capa de red y falla dentro de un parser XML frágil.
La regla práctica es simple. Si los feeds externos influyen en las pujas, el enrutamiento, la configuración de cuentas o la lógica de cloaking, XML pertenece a tu conjunto de habilidades básicas.
Eligiendo el Parser XML de Python Correcto
No todas las tareas de XML merecen el mismo parser. La elección correcta depende del tamaño del archivo, la complejidad de las consultas, el nivel de confianza de la fuente y la frecuencia con la que se ejecuta el script.
Para muchos trabajos, ElementTree es suficiente. El soporte XML integrado de Python lo convirtió en un lenguaje predeterminado para scripting XML porque puedes analizar, recorrer, extraer y escribir XML sin paquetes de terceros, como se describe en la documentación de Python para ElementTree. Eso es útil cuando necesitas un script que se pueda implementar en cualquier lugar en una caja de farm, un ejecutor de campañas o un nodo de gestión con dependencias mínimas.
Elección de parser según la carga de trabajo
RealPython distingue entre push parsing con xml.sax y pull parsing con xml.etree.ElementTree, señalando que el pull parsing puede mostrar hasta un 35% más de eficiencia de rendimiento para conjuntos de datos complejos y es crítico para procesar archivos de múltiples gigabytes sin desbordamiento de memoria en flujos de trabajo exigentes, como se cubre en su guía de parser XML de Python. Para equipos de arbitraje, esa es la diferencia entre un parser que sobrevive feeds feos de socios y uno que se convierte en el cuello de botella.
Aquí está la comparación práctica.
| Biblioteca | Mejor Para | Ventaja Clave | Desventaja Principal |
|---|---|---|---|
xml.etree.ElementTree |
Análisis estándar de feeds, edición de configuración, automatización básica | Integrado en Python y fácil de implementar | Soporte limitado de XPath y menos funciones avanzadas |
lxml |
Consultas pesadas, feeds complejos grandes, documentos con muchos namespaces | Soporte sólido de XPath y conjunto de características maduro | Dependencia adicional y más disciplina de configuración |
xmltodict |
Archivos de configuración pequeños y transformaciones rápidas | Convierte XML simple a estructuras tipo diccionario rápidamente | Se desmorona cuando la estructura se vuelve profunda o el contenido mixto se vuelve desordenado |
Dónde funciona bien cada parser
ElementTree es el predeterminado cuando el trabajo es directo. Lee un feed. Extrae etiquetas. Actualiza valores. Escribe el archivo de vuelta. Es una buena opción para editar reglas geográficas en una configuración de cloaking, cargar plantillas de cuentas o transformar una exportación de socios antes de pasarla a otra herramienta interna.
lxml es lo que yo usaría cuando la lógica de selección importa. Si necesitas XPath que pueda apuntar a un conjunto de campañas específico, coincidir atributos anidados o manejar namespaces de forma limpia, lxml ahorra tiempo. Eso importa cuando un documento XML contiene muchos mapeos de cuentas publicitarias de Facebook y TikTok, variantes de creatividades, reglas de páginas de destino y anulaciones de pujas específicas por geografía.
xmltodict es conveniente para archivos pequeños donde la estructura XML es predecible y quieres acceso estilo diccionario inmediatamente. Eso está bien para configuraciones ligeras. No es lo que confiaría para un feed complejo que impulsa el gasto.
Si el feed controla dinero, aprobaciones, redirecciones o estado de cuenta, usa un parser que haga la estructura explícita. La conveniencia deja de ser una ventaja una vez que comienza la depuración.
También está el ángulo del flujo de trabajo. Los equipos que ya están haciendo rastreo web con Python para recolección de datos a menudo intentan tratar feeds XML como texto semi-estructurado. Eso funciona hasta que aparecen namespaces, etiquetas hermanas repetidas o anidamiento profundo. XML no es scraping de HTML. Recompensa un manejo más estricto.
Una regla de decisión simple ayuda:
- Usa
ElementTreepara confiabilidad integrada e implementaciones sin dependencias. - Usa
lxmlcuando la precisión de XPath y mejor ergonomía XML importan. - Usa
xmltodictsolo para entrada pequeña, simple y confiable.
Evita xml.sax a menos que ya sepas por qué necesitas callbacks impulsados por eventos. Para la mayoría de la automatización de ad-tech, agrega complejidad sin suficiente ventaja.
Analizando y Consultando Datos XML con XPath
Un equipo de arbitraje de tráfico generalmente nota la mala lógica de selección de XML en el peor momento posible. Un feed de socio llega minutos antes del lanzamiento, un XPath pierde un namespace, la mitad de las campañas de Alemania nunca se enrutan al grupo de cuentas correcto, y el operador solo lo ve después de que comienza el gasto.
XPath es lo que evita que eso se convierta en un trabajo de limpieza manual. Permite que Python seleccione exactamente los nodos que impulsan el enrutamiento, la asignación de cuentas, las comprobaciones de pujas y las reglas de cloaking, sin escribir bucles anidados para cada variante de feed.
Un ejemplo realista de feed de campañas
Supón que un socio o generador interno te da XML como esto:
from lxml import etree

xml_data = """
<campaigns>
    <campaign id="fb-de-01" platform="facebook" status="active">
        <geo>DE</geo>
        <account>farm_batch_12</account>
        <creative>
            <name>de_video_a</name>
            <bid>1.80</bid>
        </creative>
    </campaign>
    <campaign id="tt-us-02" platform="tiktok" status="paused">
        <geo>US</geo>
        <account>farm_batch_22</account>
        <creative>
            <name>us_ugc_b</name>
            <bid>1.20</bid>
        </creative>
    </campaign>
    <campaign id="fb-de-03" platform="facebook" status="active">
        <geo>DE</geo>
        <account>agency_pool_4</account>
        <creative>
            <name>de_static_c</name>
            <bid>1.55</bid>
        </creative>
    </campaign>
</campaigns>
"""

root = etree.fromstring(xml_data)
Ahora consúltalo con XPath:
germany_campaigns = root.xpath("//campaign[geo='DE']")
for campaign in germany_campaigns:
    print(campaign.get("id"), campaign.get("platform"))
Eso te da las campañas de Alemania sin código de recorrido adicional. Ajusta el filtro cuando el feed controla presupuesto o estado de cuenta:
high_bid_facebook = root.xpath(
    "//campaign[@platform='facebook' and @status='active' and creative/bid > 1.50]"
)

for campaign in high_bid_facebook:
    print(campaign.get("id"))
En producción, consultas como estas generalmente se encuentran dentro de trabajos de enrutamiento que dividen el tráfico por país, envían campañas a grupos de cuentas separados de Facebook o TikTok, mapean páginas de destino a perfiles de cloaking, o verifican que las cuentas farmeadas solo reciban geografías aprobadas. Si los operadores también mantienen configuraciones de lanzamiento específicas del navegador, ayuda mantener la lógica de mapeo de cuentas alineada con el flujo de trabajo de configuración de proxy del navegador Firefox del equipo para que la selección de campañas y el enrutamiento del navegador no se desalineen.
Usando XPath para selección de campañas
XPath se gana su lugar cuando la regla de selección es más difícil que el análisis en sí.
Con recorrido manual de árbol, un feed con grupos de cuentas anidados, perfiles de navegador, reglas de redirección y creatividades de respaldo se convierte en bucles dentro de bucles más muchas comprobaciones if. Eso cuesta tiempo durante la depuración y hace que los cambios de feed sean más riesgosos. XPath mantiene la regla visible en una expresión, lo que es más fácil de revisar antes de un lanzamiento.
Algunos ejemplos:
# Todas las campañas activas
root.xpath("//campaign[@status='active']")

# Todos los nombres de creatividades para Alemania
root.xpath("//campaign[geo='DE']/creative/name/text()")

# Campañas asignadas a un grupo de cuentas específico
root.xpath("//campaign[account='farm_batch_12']")
Usa XPath cuando los operadores necesiten responder una pregunta de negocio directamente desde el XML. ¿Qué campañas activas pueden ir a un grupo de cuentas preparadas? ¿Qué creatividades pertenecen a DE y superan el piso de puja? ¿Qué registros deben excluirse de un conjunto de páginas de destino con cloaking? Esas preguntas se mapean limpiamente a XPath, y esa claridad reduce errores.
Namespaces y nodos faltantes
Dos cosas rompen los scripts XML en operaciones publicitarias todo el tiempo. Namespaces y elementos opcionales.
Los namespaces aparecen en exportaciones de socios, payloads firmados, XML generado por Office y feeds impulsados por esquemas. Cuando findall() o XPath no devuelve nada aunque las etiquetas estén en el archivo, el namespace es a menudo la razón.
Ejemplo:
xml_ns = """
<ns:campaigns xmlns:ns="http://example.com/campaigns">
    <ns:campaign id="1">
        <ns:geo>DE</ns:geo>
    </ns:campaign>
</ns:campaigns>
"""

root = etree.fromstring(xml_ns)
ns = {"ns": "http://example.com/campaigns"}

campaigns = root.xpath("//ns:campaign[ns:geo='DE']", namespaces=ns)
Ignora el mapa de namespace y la consulta falla sin ser notada. Así es como un script pasa las pruebas en el archivo de muestra de ayer y falla en la revisión del feed de hoy.
Los nodos XML faltantes causan la otra clase de fallas. La guía de FreeCodeCamp sobre analizar XML en Python sin usar bibliotecas externas advierte sobre patrones de acceso inseguros como llamar .text en un resultado faltante de find(). En feeds de ad-tech, eso aparece cuando una campaña está faltando una puja, un perfil de navegador carece de un código de país, o una regla de cloaking omite un parámetro opcional.
Usa extracción defensiva:
campaign = root.find(".//campaign")
geo = campaign.find("geo") if campaign is not None else None

if geo is not None and geo.text:
    print(geo.text)
else:
    print("geo faltante")
O con lxml y XPath:
geo_values = root.xpath("//campaign[@id='fb-de-01']/geo/text()")
geo = geo_values[0] if geo_values else None
Los nodos faltantes son normales en feeds de producción. Trata cada campo opcional como nullable, valida antes de acceder y falla con registro que le diga al operador qué ID de campaña, fuente de socio o grupo de cuentas causó el problema. Eso evita que los errores del parser se conviertan en un mal enrutamiento silencioso.
Modificando y Escribiendo XML para Tareas de Automatización
Leer XML es solo la mitad del trabajo. Los equipos que ejecutan farms de cuentas, redirecciones geosegmentadas o plantillas de perfiles de navegador generalmente necesitan cambiar XML y enviarlo de vuelta.
Eso podría significar intercambiar un país objetivo, insertar un token de seguimiento, eliminar una regla obsoleta o generar archivos de configuración específicos de cuenta antes de un lanzamiento.
Editando una plantilla de cloaking o campaña
Comienza con una plantilla XML simple:
import xml.etree.ElementTree as ET

xml_data = """
<campaign_config>
    <target_country>US</target_country>
    <platform>facebook</platform>
    <tracking_param>old_value</tracking_param>
    <obsolete_flag>1</obsolete_flag>
</campaign_config>
"""

root = ET.fromstring(xml_data)
Ahora cámbialo en memoria:
country = root.find("target_country")
if country is not None:
    country.text = "DE"

tracking = root.find("tracking_param")
if tracking is not None:
    tracking.text = "de_launch_batch_7"

obsolete = root.find("obsolete_flag")
if obsolete is not None:
    root.remove(obsolete)

new_elem = ET.SubElement(root, "browser_profile")
new_elem.text = "multilogin_de_stack"
Ese patrón es útil cuando clonas una configuración base en varias variantes específicas del mercado. Un script puede generar salidas separadas para Alemania, Francia o el Reino Unido, asignar diferentes perfiles de navegador y mantener tus reglas de campaña consistentes en grupos de cuentas.
Un ejemplo práctico:
- Exportación de perfil de AdsPower o GoLogin: inyecta etiquetas de cuenta y asignación geográfica.
- Ayudante de campaña de Facebook: reemplaza el país objetivo y agrega un token de seguimiento.
- Configuración de cloaking: elimina comprobaciones obsoletas e inserta una nueva regla para una ruta de página de destino.
Si necesitas alineación de proxy a nivel de navegador durante las pruebas, los equipos a menudo emparejan este tipo de generación de configuración con comprobaciones de configuración dentro de entornos basados en Firefox. Una referencia sobre configuración de proxy del navegador en Firefox es útil cuando la configuración XML impulsa la validación sensible a la ubicación.
Escribiendo XML limpio de vuelta al disco
Una vez que hayas actualizado el árbol, serialízalo:
tree = ET.ElementTree(root)
tree.write("campaign_config_de.xml", encoding="utf-8", xml_declaration=True)
Si quieres una cadena primero:
xml_output = ET.tostring(root, encoding="unicode")
print(xml_output)
Algunas reglas de escritura importan en producción:
- Preserva los nombres de etiquetas requeridos: los sistemas de socios a menudo rechazan pequeños cambios de nomenclatura.
- No reordenes nodos casualmente: algunos consumidores más antiguos son frágiles.
- Mantén las versiones de plantilla separadas: una mala sobrescritura puede romper múltiples rutas de lanzamiento.
- Valida antes de cargar: especialmente si otra herramienta consume el archivo modificado automáticamente.
Las escrituras limpias importan más que las escrituras inteligentes. Un archivo XML aburrido que se importa correctamente supera un pipeline de transformación elegante que guarda salida mal formada.
Para la gestión de múltiples cuentas, la generación de XML a menudo se convierte en una operación por lotes. Introduce una lista de cuentas, mapea geografía y plataforma, genera una configuración por perfil de navegador o grupo de campañas. Python maneja eso bien porque la API de XML permanece legible incluso cuando la automatización alrededor se vuelve más grande.
Optimizando el Rendimiento con Streaming y Proxies
Un equipo de tráfico que extrae feeds XML por hora en docenas de cuentas generalmente golpea la misma pared primero. La RAM sube, los trabajadores se estancan y una exportación de socio de gran tamaño respalda el resto de la cola.
El análisis de árbol completo está bien para documentos pequeños y scripts únicos. En la ingesta de feeds de producción, especialmente para sincronización de campañas publicitarias, actualizaciones de inventario de cuentas y trabajos de verificación, desperdicia memoria que deberías mantener disponible para reintentos, registro y normalización posterior. El patrón más seguro es transmitir nodos, extraer lo que importa y descartar el resto inmediatamente.
Por qué el streaming resiste mejor bajo carga
El streaming se ajusta a los trabajos XML que ejecutan los equipos de arbitraje de tráfico:
- nodos de campaña u oferta repetidos en feeds grandes de socios
- exportaciones de verificación geoespecíficas extraídas a través de diferentes salidas
- inventarios de farming de cuentas agrupados en un documento
- trabajadores de sondeo que procesan el mismo esquema todo el día sin reiniciar
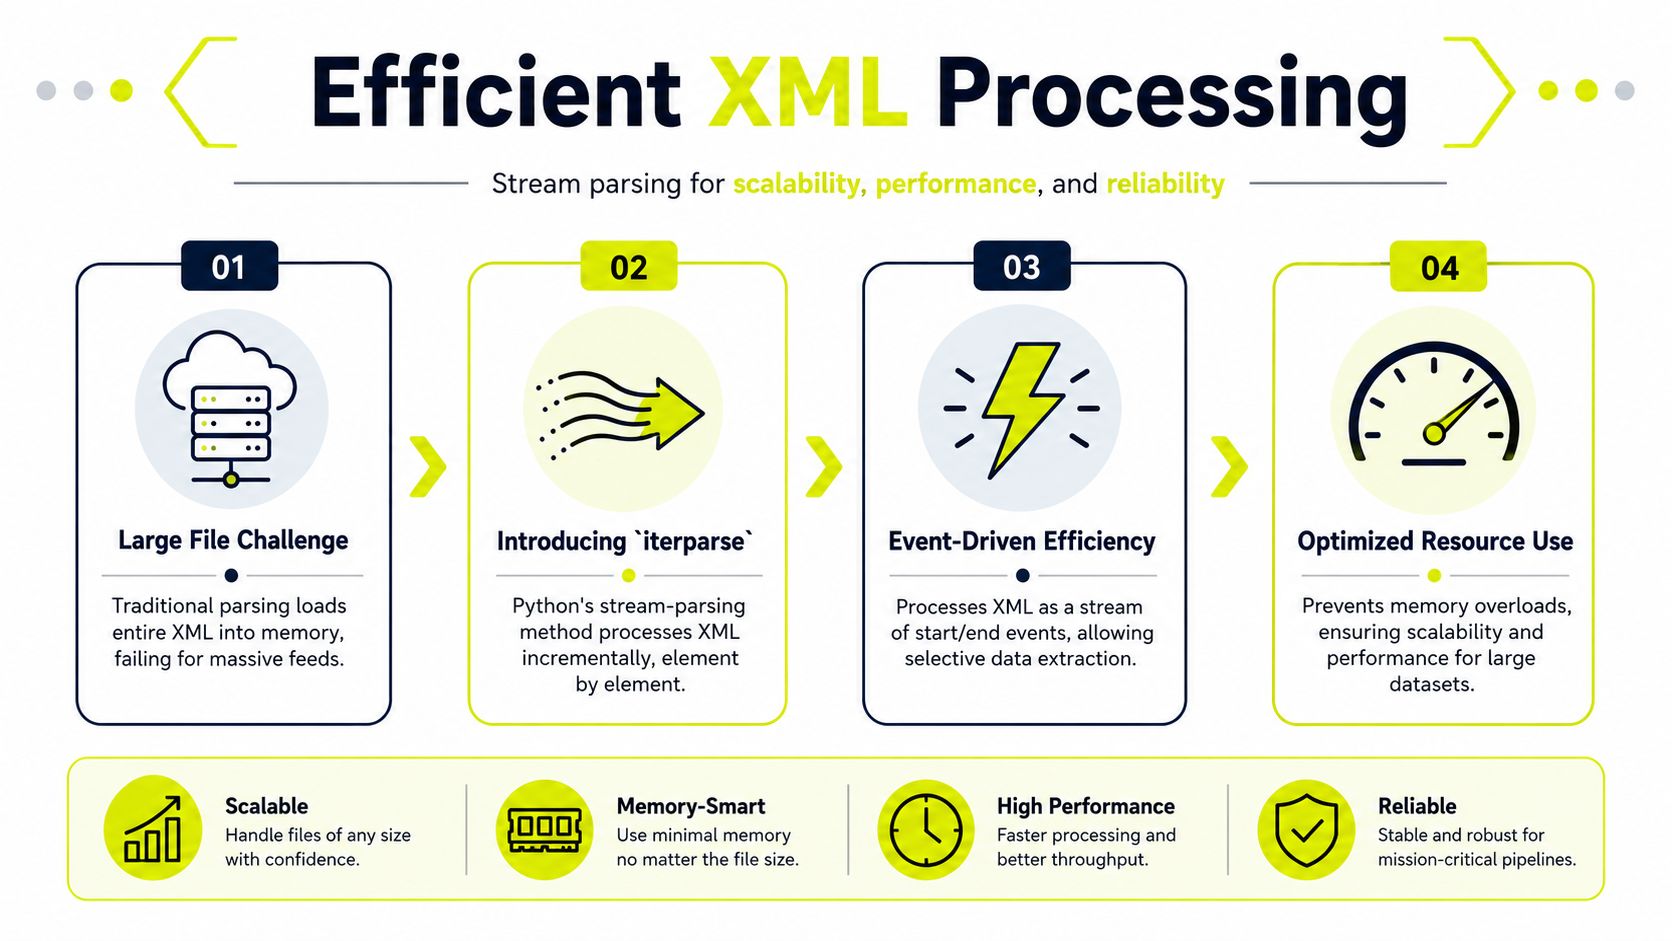
El objetivo es simple. Mantén la memoria residente predecible incluso cuando el tamaño del feed no lo es.
Usando iterparse para feeds remotos grandes
iterparse es la opción práctica cuando el feed es demasiado grande para mantenerlo cómodamente en memoria.
import xml.etree.ElementTree as ET

for event, elem in ET.iterparse("large_feed.xml", events=("end",)):
    if elem.tag == "campaign":
        campaign_id = elem.attrib.get("id")
        geo = elem.findtext("geo")
        platform = elem.attrib.get("platform")

        if geo == "DE" and platform == "facebook":
            print(campaign_id)

        elem.clear()
elem.clear() es lo que mantiene este patrón útil. Sin él, los trabajadores de larga duración acumulan lentamente nodos procesados y terminan fallando como los parsers de árbol completo de todos modos.
Para pipelines de ad-tech, confío en este enfoque para trabajos de un solo paso. Lee el feed, extrae campos de campaña, mapéalos a un formato interno más pequeño, luego escribe a una cola o base de datos. Si la tarea necesita comparaciones entre registros, haz eso en una segunda etapa después de haber reducido la carga.
Ajusta el proxy al comportamiento del feed
La selección de proxy afecta la calidad de los datos tanto como la elección del parser. Si el endpoint cambia la salida por país, ASN, operador móvil o perfil de reputación, la salida incorrecta te da un análisis limpio del feed equivocado.
Los casos de uso se desglosan bastante claramente:
- Proxies de datacenter: buenos para extracciones masivas rápidas de endpoints estables que no se localizan agresivamente
- Proxies residenciales: mejores para feeds específicos de país, validación regional y endpoints que reaccionan a la reputación de IP
- Proxies móviles: útiles para verificar flujos de ofertas solo para móviles, redirecciones dependientes del operador y rutas con cloaking mostradas a sistemas de moderación o fraude
- Proxies IPv6: vale la pena usar cuando el objetivo maneja IPv6 bien y la rotación de direcciones importa más que la compatibilidad amplia
El comportamiento TLS también importa. Los endpoints de socios a menudo sirven diferentes certificados, límites de velocidad o reglas de filtrado dependiendo de la ruta y región. Los equipos que validan feeds encriptados a través de múltiples salidas deben entender el comportamiento del servidor proxy SSL para endpoints de socios seguros antes de culpar a la lógica del parser por datos incorrectos.
Un error común de producción es separar la recolección de red del procesamiento XML como si fueran sistemas no relacionados. Son un solo pipeline. Un feed de campaña solo para Alemania obtenido a través de la región incorrecta puede pasar las comprobaciones de esquema, poblar tu base de datos y aún así envenenar las pujas, las comprobaciones de revisión y la verificación de cloaking en múltiples cuentas.
La regla práctica es medir ambos lados juntos. Rastrea la latencia de obtención, el tamaño de respuesta, el tiempo de análisis, el uso de memoria y la corrección del país por grupo de proxy. Así es como los equipos mantienen la ingesta estable cuando están sincronizando muchas cuentas a la vez y no pueden permitirse una deriva de datos silenciosa.
Manejo Seguro de XML y Mejores Prácticas
Analizar XML de una fuente no confiable es una decisión de seguridad, no solo una decisión de codificación.
Eso importa en ad-tech porque los equipos a menudo ingieren archivos de redes de afiliados, APIs de socios, herramientas alquiladas, cargas internas y exportaciones únicas de proveedores. Si tratas toda esa entrada como segura, estás invitando riesgo evitable al mismo entorno que contiene la lógica de campaña, mapeos de cuentas y credenciales de automatización.
Por qué el XML no confiable es un riesgo operacional
La comunidad de Python advierte explícitamente que sus módulos de procesamiento de XML no son seguros contra datos construidos maliciosamente, y para fuentes no confiables, se recomiendan alternativas como defusedxml, como se discute en el hilo de la comunidad de Python sobre advertencias de seguridad de XML.
Esa advertencia importa porque la mayoría de los ejemplos de XML en línea se detienen en analizar sintaxis. Los equipos de producción necesitan pensar en casos de abuso:
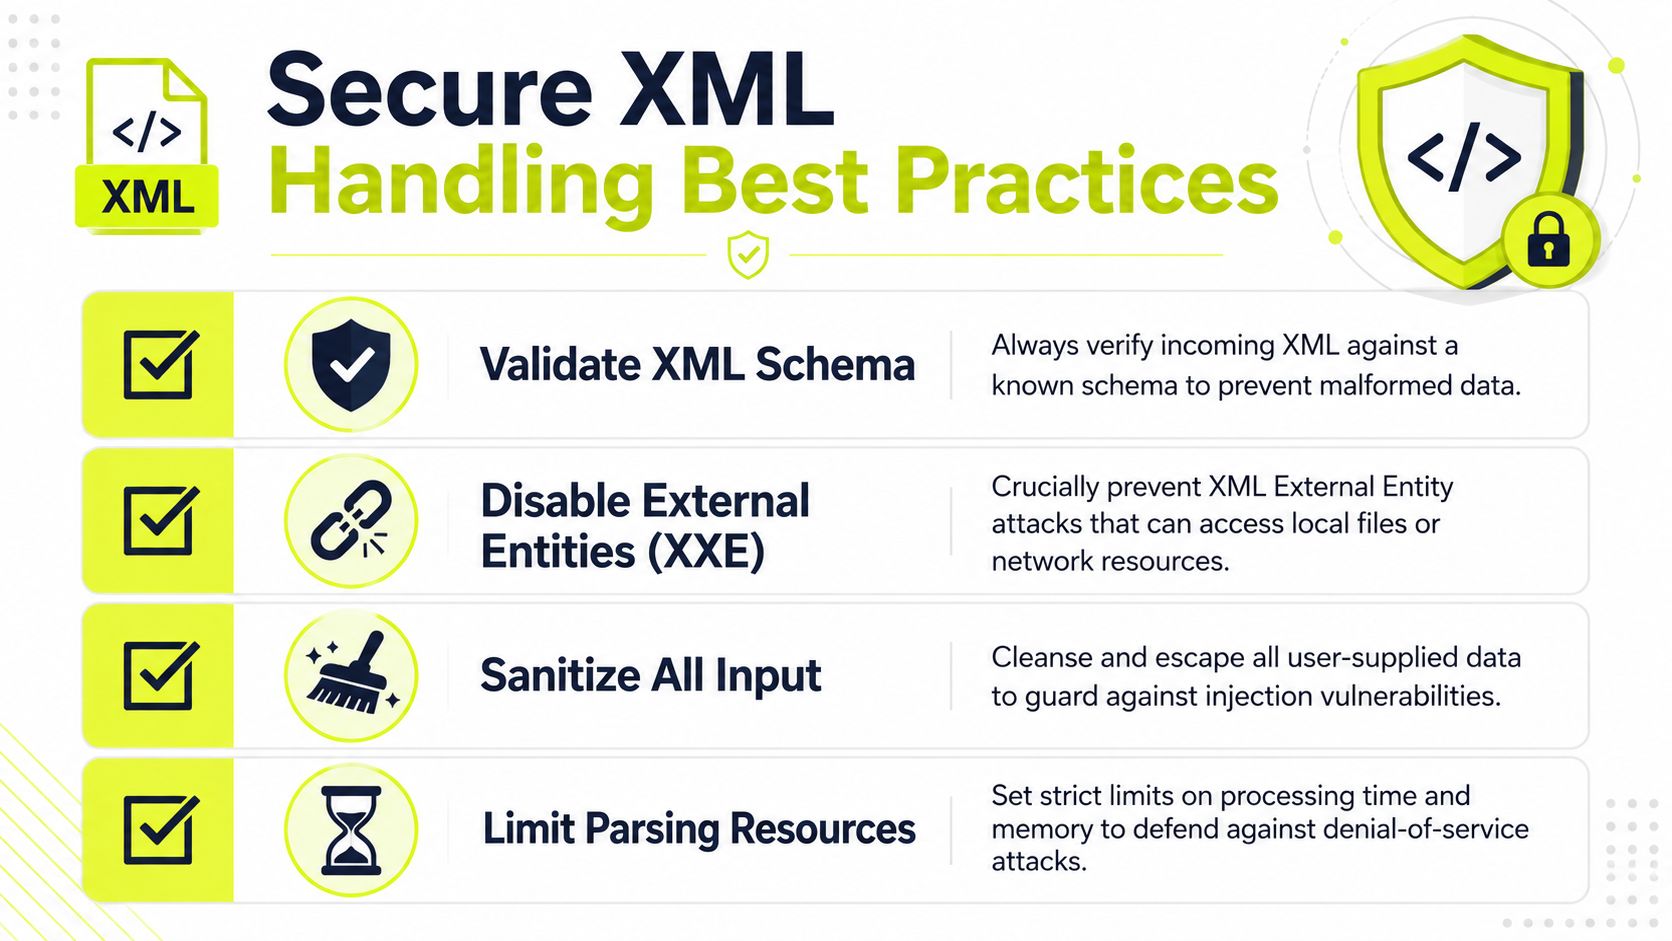
- Ataques XXE: las entidades externas pueden ser abusadas para acceder a archivos locales o recursos internos si el parser lo permite.
- Entradas de denegación de servicio: XML construido maliciosamente puede consumir recursos excesivos.
- Hábitos de serialización inseguros: XML usado como transporte para datos estructurados sensibles puede crear problemas de confianza si la validación es débil.
El XML firmado todavía es relevante en flujos de trabajo de alta confianza. SignXML señala que XML Signature sigue siendo usado para SAML 2.0, XAdES, EBICS y WS-Security en su documentación del proyecto. Esa es una razón por la que XML no ha desaparecido de las integraciones serias. Si tu stack de tráfico toca identidad, facturación empresarial o datos regulados de socios, el manejo seguro de XML no es opcional.
Una lista de verificación para producción
Usa una línea base de seguridad primero cada vez:
- Trata el XML de terceros como hostil por defecto: especialmente de cargas, dashboards de socios o endpoints sin documentar.
- Usa opciones de análisis más seguras: prefiere bibliotecas reforzadas como
defusedxmlcuando la fuente no es totalmente confiable. - Valida la estructura antes de que se ejecute la lógica de negocio: la validación de esquema y las comprobaciones estrictas de campos capturan datos mal formados temprano.
- Establece límites de recursos: los trabajos de análisis deben tener límites para tiempo, memoria y tamaño de archivo.
- Separa la ingesta de la ejecución: no dejes que XML analizado active directamente acciones sensibles sin validación.
- Audita el comportamiento DNS en tu stack de recolección: cuando envíes solicitudes proxy para XML remoto, entiende cómo el manejo de DNS de proxy afecta las rutas de solicitud.
El error costoso de XML generalmente no es un error de sintaxis. Es un error de confianza.
Eso aplica si estás importando un payload firmado, procesando un feed para farming de cuentas, o validando reglas de cloaking para campañas geosegmentadas. La automatización confiable depende de que el parser sea estricto, defensivo y aislado de la entrada no confiable.
Si estás construyendo automatización impulsada por XML para verificación de anuncios, ingesta de feeds, farming de cuentas o flujos de trabajo de navegador de múltiples cuentas, Sota Proxy te da la capa de proxy para probar salidas geoespecíficas, extraer feeds remotos de manera confiable y validar lo que ve el tráfico de Facebook o TikTok en todas las regiones. Para equipos que ya comparten herramientas con otros operadores, su programa de afiliados también ofrece hasta 40% de comisión.
Artículos relacionados

Clave API de Bing Search: Configuración, Pruebas y Escalado en 2026
Obtén una clave API de Bing Search funcional en 2026, prueba solicitudes, protege la clave y escala scraping de alto volumen sin bloqueos. Guía práctica para equipos técnicos.

10 Formas de Recopilar Datos Cualitativos para Compradores de Medios
Descubre 10 formas de recopilar datos cualitativos de tus usuarios. Aprende métodos como entrevistas y grupos focales para optimizar el uso de proxies y la estrategia de campañas.
Para Qué Se Usa un Proxy: Guía de Arbitraje 2026
Para qué se usa un proxy - Descubre para qué se utiliza un proxy en 2026, desde mejorar la seguridad hasta gestionar operaciones multiaccount para equipos de arbitraje
ERR_TUNNEL_CONNECTION_FAILED: el nombre del error ya es el diagnóstico
Chrome le pidió a un proxy que abriera un túnel CONNECT y falló. Eso es todo el error. De dónde sale ese proxy cuando nunca configuraste ninguno, las seis razones por las que un proxy configurado puede generar este error, y por qué limpiar la caché no soluciona nada.
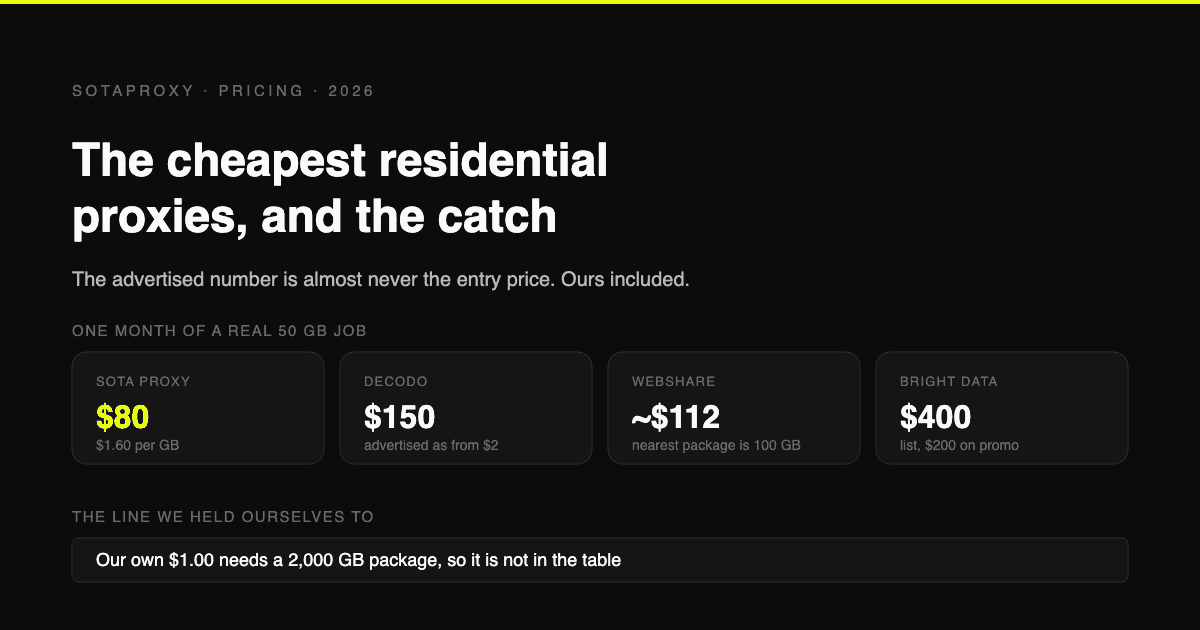
Los proxies residenciales más baratos en 2026 y la trampa que esconde cada uno
Precios verificados por gigabyte directamente de las páginas de cinco proveedores, no de artículos del año pasado. Por qué el precio anunciado casi nunca es el de entrada, qué proveedores te obligan a un mínimo mensual y cómo calcular tu coste real por gigabyte.
¿Cuántas cuentas de Telegram puedes tener en 2026 (y qué significa realmente estar "limitado")?
Telegram no publica un límite oficial de cuentas, exige un número por cuenta, y su propio FAQ de spam indica que una cuenta limitada puede seguir enviando mensajes a quien tenga tu número guardado. Qué activa las restricciones, por qué los números VoIP se bloquean antes de enviar un solo mensaje y por qué no existe liberación anticipada.