Bots para Zapatillas: Guía Técnica para Operadores
Una guía técnica sobre bots para zapatillas. Aprende cómo funcionan, el stack tecnológico necesario y cómo usar proxies para rendimiento optimizado y evitar bloqueos.
Estás mirando un temporizador de lanzamiento con perfiles cargados, tareas preparadas, proxies asignados y ventanas de checkout medidas en segundos. Esa configuración probablemente te resulta familiar si ejecutas cuentas de anuncios de Facebook a escala, cultivas perfiles de TikTok o administras landing pages encubiertas en navegadores antidetección. La mecánica es diferente, pero la mentalidad operativa es la misma. Compites en una ventana comprimida donde la latencia, la calidad de identidad y la distribución del tráfico deciden quién pasa.
Por eso los bots para zapatillas tienen más sentido cuando dejas de tratarlos como un truco de retail y empiezas a tratarlos como un problema de ejecución de alta frecuencia. El bot en sí importa, pero es solo una parte del sistema. La ventaja viene de cómo combinas la orquestación de tareas, proxies, ubicación de servidores, identidad del navegador, pools de cuentas y controles de fallo bajo presión.
Los operadores que vienen del arbitraje de tráfico generalmente entienden esto rápido. Ya sabes que una cuenta de anuncios limpia es útil, pero una flota administrada es lo que escala. Sabes que un perfil de AdsPower o Multilogin con un proxy malo sigue siendo un perfil malo. El botting de zapatillas funciona de la misma manera. Un bot rápido en infraestructura débil quema dinero. Un bot más lento en infraestructura limpia puede seguir imprimiendo porque sobrevive a los filtros el tiempo suficiente para llegar al carrito y al checkout.
F5 Labs documentó cuán industrial se vuelve esto. En un lanzamiento de zapatos observado, el tráfico de bots alcanzó 2,163 veces el nivel del tráfico humano, y la operación usó 1,400 IPs diferentes, 466 números de sistemas autónomos y 125 cadenas de user-agent. F5 también vio más de 2,600 cuentas falsas creadas durante tres semanas, junto con 41,000 cambios de dirección de envío y 278,000 transacciones de checkout en la misma operación, lo que muestra cuán lejos empujan los operadores modernos la automatización de cuentas y checkout a escala (análisis de F5 Labs sobre una operación de bot de zapatillas).
Tabla de Contenidos
- Introducción La Guerra de 90 Segundos
- Deconstruyendo el Stack del Bot de Zapatillas
- El Imperativo de la Infraestructura de Proxies
- Optimizando Tu Entorno Operacional
- Estrategia de Ejecución y Gestión de Riesgos
- Construyendo una Configuración Optimizada para Rendimiento
Introducción La Guerra de 90 Segundos
Un lanzamiento publicitado rara vez falla porque tu bot hizo clic demasiado lento. Falla porque todo el stack se desalineó. El monitor se disparó tarde. Los proxies eran rápidos pero sucios. Las tareas de checkout compartían demasiada identidad. Las cuentas no estaban calentadas. El servidor estaba demasiado lejos del edge objetivo. O la capa anti-bot decidió que el comportamiento de tu navegador parecía sintético antes de que llegaras al pago.
Esa es la parte que los recién llegados pierden. Los bots para zapatillas no son solo scripts de automatización golpeando refresh. Son sistemas coordinados construidos para una ventana de inventario muy corta donde cada solicitud tiene que parecer lo suficientemente plausible para sobrevivir y lo suficientemente rápida para convertir. Wallarm describe los bots de zapatillas como un stack de automatización modular con funciones como scraping de páginas, programación de tareas, agregar al carrito, checkout, rotación de proxies y resolución de CAPTCHA. El efecto práctico es simple. Menor latencia manual e intentos de checkout paralelos aumentan la probabilidad de éxito cuando el inventario es escaso (Wallarm sobre la estructura de bots de zapatillas).
El bot es un motor de flujo de trabajo, no una app mágica
Piensa en el stack de la manera en que un comprador de medios piensa sobre la infraestructura de lanzamiento.
No juzgas una campaña solo por el anuncio. Juzgas la calidad de la cuenta, salud del píxel, lógica de encubrimiento, higiene del proxy, enrutamiento geográfico y qué tan rápido responde el equipo cuando un carril se degrada. Los operadores de zapatillas lidian con las mismas dependencias en capas.
Una configuración funcional generalmente incluye:
- Una capa de monitoreo que observa páginas de productos, feeds o endpoints en busca de señales de lanzamiento.
- Una capa de tareas que inicia, detiene, reintenta y enruta intentos basados en tiempo y comportamiento objetivo.
- Una capa de identidad compuesta por perfiles, cuentas, detalles de envío, instrumentos de pago, cookies y huellas digitales del navegador.
- Una capa de red usando proxies residenciales, ISP, móviles, datacenter o IPv6 según la etapa y el objetivo.
- Una capa de ejecución para agregar al carrito, manejo de colas, resolución de CAPTCHA y envío de checkout.
Regla práctica: Si tu capa de identidad es débil, escalar el conteo de tareas solo escala el fallo.
Donde la mayoría de operadores realmente pierden
Sobrevaloran la velocidad bruta y subvaloran la credibilidad de la sesión.
Ese error es común entre usuarios técnicos que cruzan desde scraping o automatización de crecimiento. Asumen que la jugada ganadora es más hilos, más reintentos, más concurrencia. Eso todavía puede ayudar en objetivos débiles, pero las plataformas de lanzamiento maduras ya no pierden ante el tráfico de fuerza bruta. Evalúan el tiempo de solicitud, distribución de IP, rasgos del navegador, continuidad de cookies y patrones de interacción como un sistema.
La mentalidad correcta está más cerca del arbitraje de campañas que del stress testing. Distribuyes el riesgo. Separas los monitores del tráfico de checkout. Divides las cuentas por clase de proxy y geografía. Decides dónde gastar IPs caras y dónde la velocidad barata es suficiente. Y construyes para resistencia a cancelaciones, no solo velocidad de carrito.
Deconstruyendo el Stack del Bot de Zapatillas
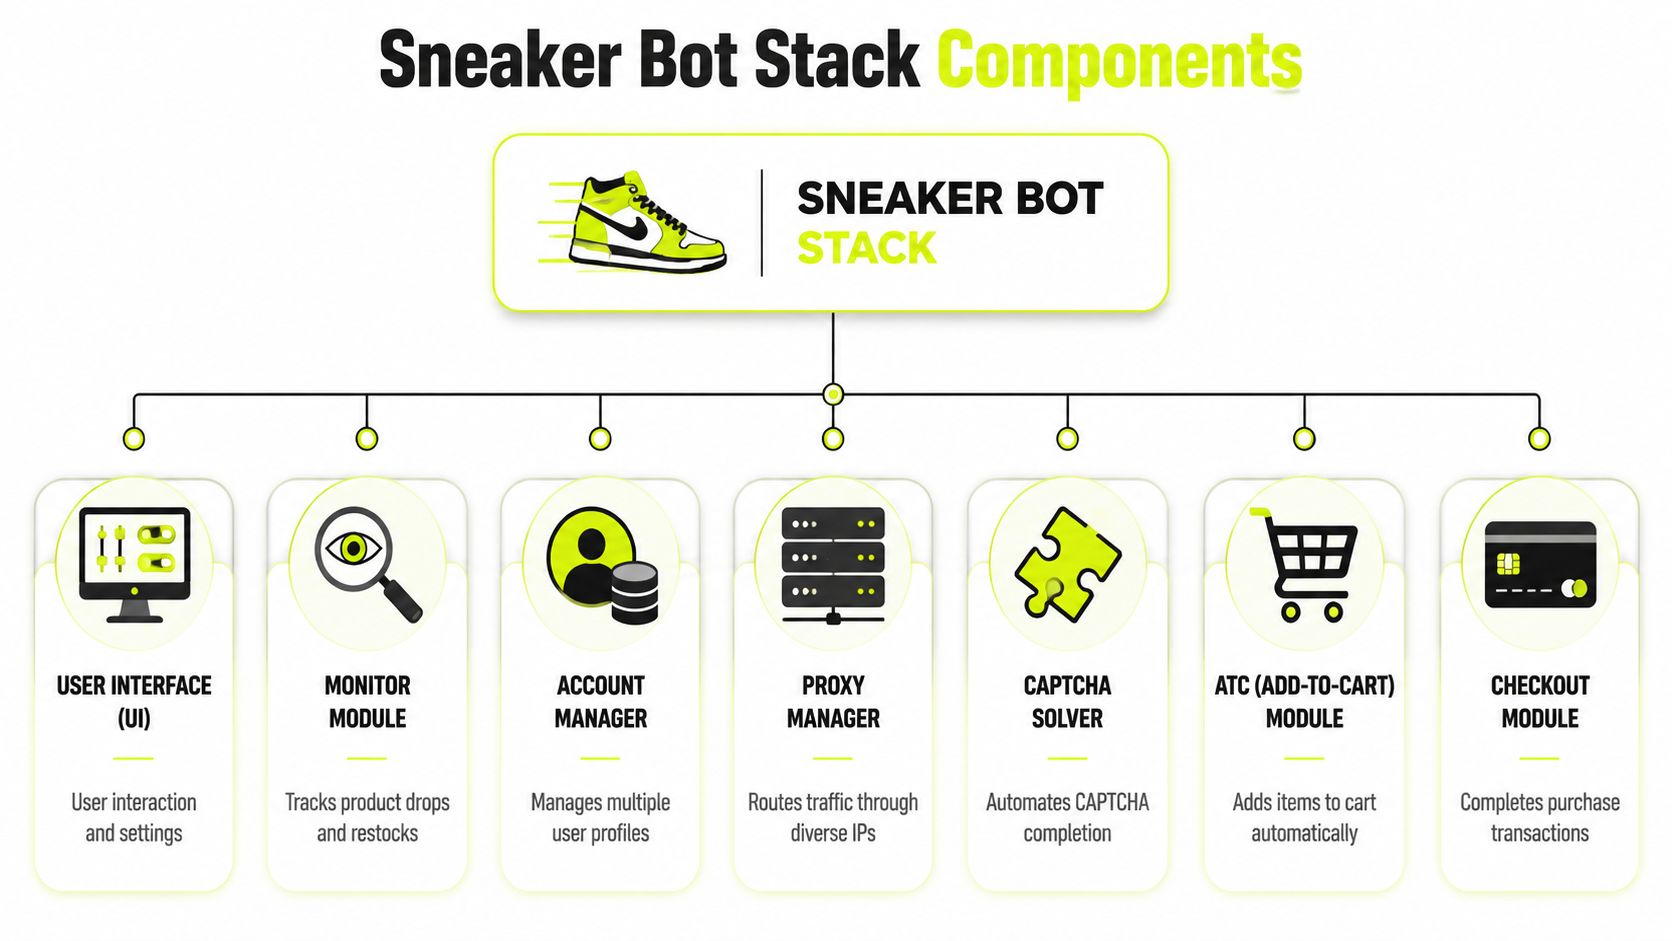
Un bot de zapatillas es realmente una cadena de módulos cooperantes. Si un módulo tiene bajo rendimiento, el resto hereda el daño.
El bot es un motor de flujo de trabajo, no una app mágica
En la parte superior está el programador de tareas. Este es el controlador de tráfico. Decide cuándo comienzan los perfiles, cómo se disparan los reintentos, qué pool de proxies usa cada tarea y cómo reaccionan las tareas a estados de cola, errores o cambios de stock. Una buena programación no se trata solo de ejecución temprana. Se trata de evitar comportamiento sincronizado que hace que tu flota parezca falsa.
Luego tienes el módulo de monitor. Esta pieza observa la publicación de productos, estado de stock o cambios de variante. Para operadores prácticos, los monitores necesitan dos cosas: velocidad y separación. Generalmente no quieres que el mismo pool de IP maneje tanto el monitoreo pesado como el checkout porque crea patrones ruidosos y quema tus carriles de compra antes de que el producto esté en vivo.
El módulo ATC maneja agregar al carrito. Esta fase parece simple hasta que el sitio cambia los endpoints del carrito, incrusta tokens de cola o requiere estado llevado desde interacciones de página anteriores. Los operadores pierden aquí cuando asumen que una solicitud de carrito es suficiente. En objetivos más fuertes, ATC funciona solo si toda la sesión ya parece coherente.
Donde la mayoría de operadores realmente pierden
El módulo de checkout cierra el ciclo. Envía envío, pago y confirmación en una secuencia que el retailer aceptará. Este módulo importa, pero está downstream de la calidad de identidad. Si tu perfil, ruta de pago, lógica de envío y estado de sesión no coinciden, la velocidad de checkout no te salvará.
Luego está el administrador de proxies. Esto no es una casilla de verificación. Decide cómo aparece cada tarea en la red, si las sesiones permanecen persistentes y cómo se distribuye el tráfico entre subredes y geos. La política de proxies a menudo determina si el sitio ve una base de usuarios distribuida o una granja agrupada.
El administrador de cuentas mantiene los perfiles separados. Los operadores serios tratan las cuentas de la manera en que los farmers de cuentas tratan los activos de Facebook o TikTok. Cada perfil lleva su propia historia, cookies, huella digital del navegador y a menudo su propio carril de uso. Mezclarlas descuidadamente causa contaminación cruzada. Así es como un lote sucio se convierte en cancelaciones masivas.
Un stack limpio generalmente se comporta así:
- Monitorea con velocidad barata primero. Usa carriles rápidos para detectar movimiento temprano.
- Promociona tareas calificadas. Solo mueve tareas seleccionadas a carriles premium de proxy y cuenta.
- Preserva la continuidad de la sesión. No intercambies componentes de identidad a mitad de flujo a menos que el objetivo lo tolere.
- Gasta recursos caros tarde. Ahorra capacidad residencial o móvil más limpia para los momentos que importan.
- Registra razones de fallo por etapa. No etiquetes todo como "rechazado" o "fallido". Separa caídas de cola, bloqueos, bucles de CAPTCHA, errores de carrito y fricción de pago.
Un bot de zapatillas no vence un lanzamiento siendo rápido en todas partes. Gana siendo rápido solo donde la velocidad todavía importa.
Esa distinción importa si ya ejecutas campañas geo-dirigidas, flujos de encubrimiento o granjas de cuentas. En esos entornos, ya conoces la verdad operacional. La precisión vence al volumen cuando la plataforma evalúa la calidad antes de la entrega.
El Imperativo de la Infraestructura de Proxies
Los proxies deciden qué partes de tu operación pueden mantenerse agresivas y qué partes necesitan parecer ordinarias. Si el bot es el motor, la capa de proxy es la superficie del camino, el patrón de tráfico y la placa de matrícula.
Cómo se comporta cada tipo de proxy bajo presión de lanzamiento
Los proxies de datacenter son la jugada de velocidad. Son útiles para monitoreo, precargar páginas públicas o probar comportamiento objetivo. Son baratos en relación a IPs de consumidor más limpias y responden rápido. El trade-off es obvio. Los sistemas anti-bot de retail a menudo desconfían de ellos rápidamente, especialmente en flujos de checkout o intensivos en cuentas.
Los proxies residenciales son el caballo de batalla para el tráfico de compra porque se mapean de vuelta a dispositivos de consumidor y redes domésticas. Cuestan más, y la calidad varía mucho según el proveedor, pero se ajustan a objetivos que se preocupan más por la autenticidad que por el rendimiento bruto. Para bots de zapatillas, el tráfico residencial es a menudo la diferencia entre "solicitud aceptada" y "sesión devaluada".
Los proxies móviles están en el extremo caro del espectro de confianza. Son útiles cuando un objetivo favorece fuertemente la reputación de la red móvil o cuando rotaciones repetidas a través de pools de operadores ayudan a romper la correlación. No son una solución universal. La latencia y el precio pueden hacerlos una mala elección para conteos de tareas amplios. Es mejor reservarlos para sitios específicos o acciones de cuenta de alta fricción.
Los proxies ISP se sitúan en un carril medio útil. Típicamente son más estables que sesiones residenciales rotativas y de aspecto más limpio que rangos de datacenter para muchos objetivos. Para flujos basados en cola o sesiones de checkout persistentes, esa estabilidad importa. Muchos operadores usan carriles ISP donde necesitan identidad consistente en el tiempo sin recibir el golpe completo de rendimiento de móvil.
Los proxies IPv6 son situacionales. Pueden funcionar bien donde el objetivo acepta tráfico IPv6 limpiamente y donde necesitas escala a bajo costo. Son menos útiles cuando el stack anti-bot del sitio o los servicios upstream normalizan hacia el comportamiento IPv4, o cuando tus herramientas y flujos de pago están claramente ajustados alrededor de patrones de tráfico de consumidor más estándar.
Comparación de Tipos de Proxy para Botting de Zapatillas
| Tipo de Proxy | Caso de Uso Principal | Velocidad | Riesgo de Bloqueo | Costo |
|---|---|---|---|---|
| Residencial | Checkout, acciones de cuenta, participación en colas | Moderada | Menor cuando la calidad es buena | Mayor |
| Móvil | Objetivos de alta fricción, flujos sensibles a identidad | Variable | Menor en algunos entornos | Más alto |
| Datacenter | Monitoreo, pruebas, scraping de páginas públicas | Rápida | Mayor en flujos de compra | Menor |
| ISP | Sesiones persistentes, colas, carriles de checkout estables | Rápida a moderada | Moderado | Medio a alto |
| IPv6 | Pruebas de escala, objetivos compatibles, distribución amplia | Variable | Dependiente del objetivo | Menor a moderado |
Sesiones persistentes, rotación y riesgo de subred
La política de rotación importa tanto como el tipo de proxy.
Usa sesiones rotativas cuando estés monitoreando, scrapeando endpoints ligeros o distribuyendo solicitudes de etapa temprana que no necesitan continuidad. Usa sesiones persistentes cuando el objetivo espera que un viaje de usuario venga de una fuente estable, especialmente en colas, logins de cuenta y flujos de carrito a checkout.
Los operadores con experiencia en compra de medios generalmente se adaptan rápido a estos tipos de dinámicas. Ya sabes que a una cuenta de anuncios de Facebook no le gusta una historia de dispositivo e IP cambiante. Los sitios de zapatillas aplican la misma lógica. Si una sesión entra a una cola con una identidad y sale con otra, estás pidiendo a la plataforma que te re-evalúe en el peor momento posible.
La política práctica de proxies a menudo se ve así:
- Tráfico de monitoreo pasa por datacenter o carriles rotativos más baratos.
- Logins de cuenta y calentamiento pasan por sesiones residenciales, móviles o ISP persistentes.
- Intentos de checkout usan el pool más limpio que puedas justificar financieramente.
- Campañas geo-dirigidas y lanzamientos con bloqueo regional obtienen IPs coincidentes con país o ciudad, igual que verificación de anuncios localizada o pruebas de escaparate localizado.
- Granjas de cuentas de alto valor permanecen mapeadas a perfiles de navegador estables en herramientas como AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc.
Si estás comparando proveedores o planeando el diseño de tu propio pool, este desglose de cómo se construye y comporta un servidor proxy en la práctica es útil porque enmarca el lado técnico del enrutamiento, asignación y manejo de sesiones en términos de operador.
También hay un ángulo de negocio para operadores de comunidad. Si publicas configuraciones, ejecutas grupos privados o asesoras a otros compradores, la economía de referidos importa. Algunos proveedores de proxies pagan comisiones recurrentes. Sota Proxy, por ejemplo, ofrece un programa de afiliados con hasta 40% de comisión. Eso es relevante si tus recomendaciones de configuración ya impulsan gasto a través de botting, farming de cuentas, verificación de anuncios o flujos de encubrimiento.
Optimizando Tu Entorno Operacional
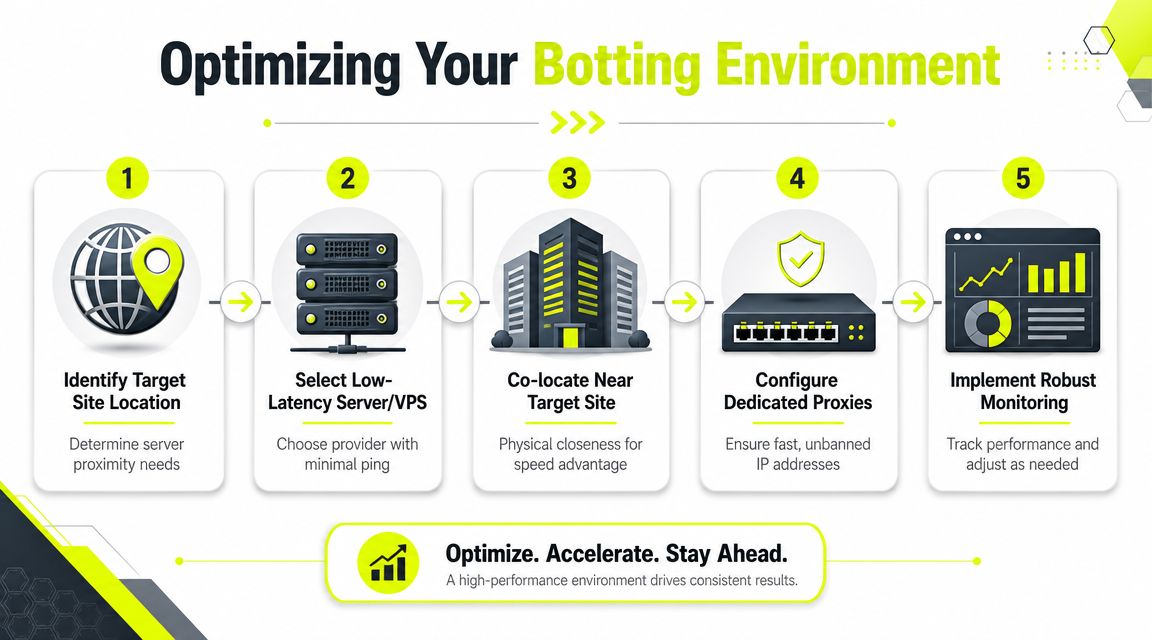
La mayoría de los lanzamientos fallidos vienen de desajuste de entorno, no de una tarea mala. El servidor está demasiado lejos. El perfil del navegador está limpio en el panel antidetección pero sucio en el objetivo. El proxy está bien para navegar pero equivocado para checkout. La cuenta existe, pero no tiene historia creíble.
Los servidores, navegadores y estado de cuenta deben coincidir
Ejecuta bots sensibles al rendimiento cerca de la infraestructura del objetivo. Una máquina doméstica local puede funcionar para jugadas más pequeñas, pero una vez que operas a escala, un VPS de baja latencia o servidor dedicado generalmente tiene más sentido. Quieres comportamiento de red predecible, recursos estables y menos ruido local de actividad de escritorio.
El lado del navegador importa igual. Si estás acostumbrado a escalar cuentas de anuncios de Facebook y TikTok, ya entiendes por qué existen las herramientas antidetección. AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc te permiten mantener identidades de navegador segmentadas, persistir cookies y evitar colisiones de perfil a través de granjas de cuentas. La misma disciplina se aplica a cuentas de zapatillas.
Un perfil debe tener una historia coherente:
- Huella digital consistente que no cambie cada sesión.
- Señales geo coincidentes entre ubicación del proxy, región de cuenta y mercado objetivo.
- Edad de cookies e historial de navegación que hagan que la cuenta parezca usada, no acuñada para el lanzamiento.
- Reglas de reutilización controladas para que un perfil no toque demasiados objetivos demasiado rápido.
La identidad limpia del navegador vence a la concurrencia de fuerza bruta en sitios que evalúan el comportamiento antes del checkout.
Si necesitas mapear el uso de proxies correctamente dentro de flujos de trabajo del navegador, esta guía de configuración de proxy del navegador Firefox es un punto de referencia práctico para manejo de sesiones y lógica de configuración.
CAPTCHA, colas y realismo del navegador
La resolución de CAPTCHA se divide en dos mundos. Uno es cosecha manual, donde un humano resuelve desafíos por adelantado o bajo demanda dentro de un flujo de navegador. El otro es resolución impulsada por API, donde servicios externos procesan el desafío. Los métodos manuales pueden preservar mejor continuidad en algunos objetivos. Los métodos de API escalan mejor, pero también pueden crear problemas de tiempo y calidad si el objetivo es sensible al contexto del desafío.
El manejo de colas es similar. El error es intentar sobrepasar la cola con reintentos. Eso a menudo hace que tu sesión se vea peor, no mejor. Un enfoque más fuerte es mantener las sesiones de cola estables, mantener la continuidad de IP donde sea necesario y evitar reinicios ruidosos a menos que sepas que la implementación de cola del objetivo los tolera.
Los operadores que vienen de encubrimiento o entrega de anuncios geo-dirigida deben pensar en esto como preservación de sesión. Una vez que un carril comienza a obtener confianza, no lo rompas casualmente.
Estrategia de Ejecución y Gestión de Riesgos
Los malos lanzamientos son caros mucho después de que el drop termine. Una subred de proxy quemada, un grupo de cuentas vinculadas o un patrón de pago que comienza a activar revisión puede dañar los próximos cinco lanzamientos, no solo el actual. Los buenos operadores protegen el rendimiento futuro primero, luego persiguen el volumen a corto plazo.
Eso cambia cómo se planifica la ejecución. El objetivo no es el conteo máximo de tareas. El objetivo es rendimiento limpio bajo presión, con suficiente separación entre activos para que un fallo no envenene el resto del stack.
Controles pre-lanzamiento que previenen errores costosos
Trata cada activo por costo de reemplazo y radio de explosión. Las cuentas con antigüedad, rutas de facturación estables y perfiles de navegador con historia creíble toman tiempo reconstruir. Los monitores desechables no. El stack debe reflejar esa diferencia antes del día de lanzamiento, no después de que aparezcan los primeros bloqueos.
Antes de un lanzamiento, verifica:
- Las cuentas están calentadas con navegación creíble, cadencia de login y actividad de bajo riesgo.
- Los perfiles están aislados para que un jar de cookies malo no contamine un pool más grande.
- Los proxies están agrupados por propósito en lugar de volcados en una lista mixta.
- Los datos de pago y envío están mapeados de manera que evite agrupación obvia.
- Las tareas están organizadas por niveles para que no todos los perfiles golpeen el mismo objetivo de la misma manera al mismo tiempo.
Los operadores de granjas de cuentas de Facebook o TikTok ya conocen el patrón. Antigüedad, historia, consistencia geo y comportamiento controlado generalmente vencen a activos frescos empujados a volumen completo. Las plataformas de zapatillas evalúan señales diferentes, pero la lógica operativa es cercana.
Lo que realmente castigan los sistemas anti-bot maduros
Las defensas maduras evalúan sesiones, tiempo, reputación de red y relaciones de checkout juntas. La velocidad de solicitud todavía importa, pero la velocidad sin confianza generalmente solo te bloquea más rápido. Imperva describe la detección de bots de zapatillas como un problema de clasificación de comportamiento, y Nike declara que elimina grandes volúmenes de actividad de bots de lanzamientos SNKRS (Imperva sobre detección de bots de zapatillas y eliminación de bots de SNKRS).
En la práctica, los principales modos de fallo generalmente caen en cuatro cubetas.
Bloqueos de IP y subred
Demasiadas solicitudes relacionadas desde los mismos rangos pueden quemar un carril entero. El conteo de proxies ayuda menos que la calidad del rango y la diversificación.Suspensión de cuenta o evaluación silenciosa
Algunos objetivos no bloquean duramente inmediatamente. Bajan la prioridad de cola, inyectan fricción o te dejan llegar a checkout y perder después.Revisión de pago y pedido
Pasar el carrito significa poco si las señales de facturación, envío, dispositivo y red no se alinean en el momento de la revisión.Correlación entre cuentas
Huellas digitales de navegador reutilizadas, estructura de pedido repetida y comportamiento de tarea sincronizado pueden conectar cuentas que parecían separadas sobre el papel.
Las mitigaciones son operacionales, no glamorosas. Divide el tráfico de monitor del tráfico de cuenta y del tráfico de checkout. Escalonea los inicios para que la flota no actúe como un script. Limita la reutilización entre tarjetas, direcciones, navegadores y grupos de IP. Registra resultados post-checkout por retailer para que puedas distinguir la diferencia entre un acierto verdadero y una cancelación retrasada.
La disciplina de causa raíz importa aquí. Si una ejecución falla, identifica si el problema vino de reputación de proxy, salud de cuenta, identidad del navegador o revisión de pago. Reemplazar la capa equivocada desperdicia dinero y no te enseña nada.
Para una referencia práctica sobre controles del lado de la red, esta guía sobre cómo evitar bloqueos de IP cubre patrones de activación comunes y pasos de mitigación en detalle utilizable.
Construyendo una Configuración Optimizada para Rendimiento
Una buena configuración se construye como un sistema de ejecución bajo carga. La ventana de lanzamiento es corta, el objetivo se adapta en tiempo real y los eslabones débiles se muestran rápido. Los operadores que siguen intercambiando bots sin arreglar identidad, política de red y ubicación de cómputo generalmente obtienen resultados inconsistentes porque el cuello de botella está debajo del bot.
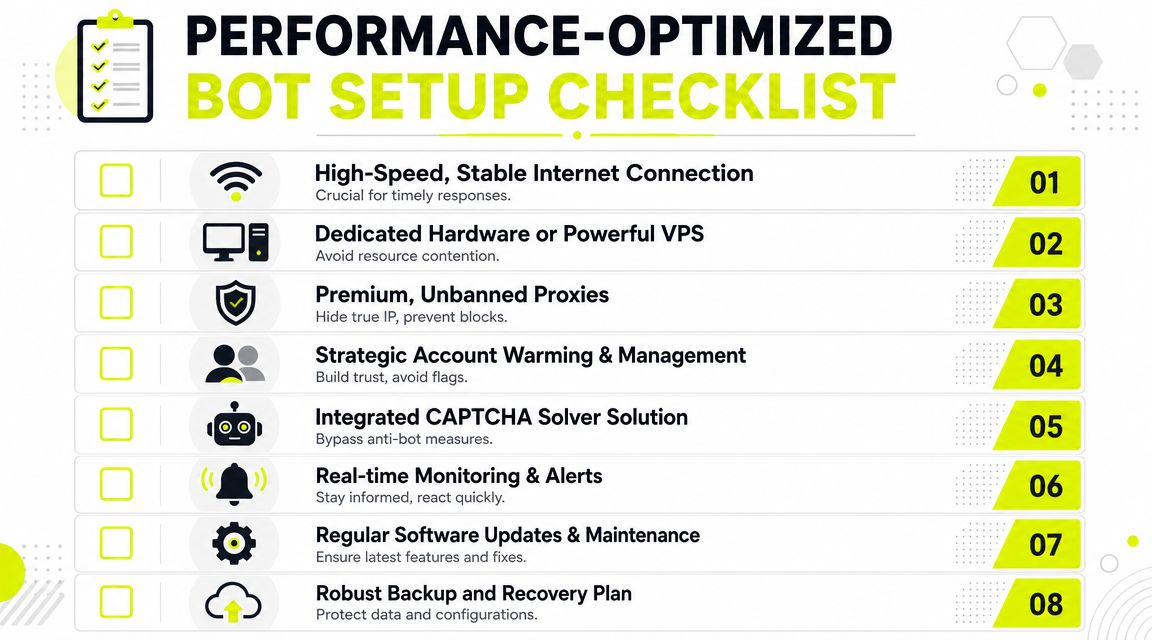
Una configuración práctica para objetivos de comercio rápido
Para objetivos rápidos con verificaciones de cuenta más ligeras, ejecuta un stack de carril dividido.
Pon monitores en proxies de datacenter de bajo costo y trátalos como sensores desechables. Su trabajo es detectar cambios de estado de producto, movimiento de stock, comportamiento de cola y salud de endpoint sin desperdiciar inventario de confianza caro. Reserva el checkout para sesiones ISP o residenciales persistentes vinculadas a perfiles calentados. Esa separación mantiene tu costo por intento bajo control y protege IPs de mayor confianza del tráfico ruidoso.
La ubicación del servidor importa más de lo que muchos operadores admiten. Un VPS de baja latencia cerca del edge del retailer reduce el retraso en aciertos de monitor, solicitudes de carrito y envíos de checkout. La ganancia no es mágica, pero en un lanzamiento decidido por márgenes de tiempo estrechos, reducir la distancia de red ayuda. Usa navegadores antidetección solo en flujos donde el estado y persistencia del navegador mejoran los resultados. En endpoints más simples, la sobrecarga completa del navegador puede ralentizar el stack sin agregar mucha confianza.
Esta configuración se mapea bien a equipos que ya ejecutan infraestructura de rendimiento en otros lugares. El modelo es familiar. Los carriles baratos recopilan señal. Los carriles premium ejecutan.
Una configuración práctica para lanzamientos intensivos en identidad
Para lanzamientos donde la historia de la cuenta tiene más peso que la velocidad bruta, centra la construcción en continuidad de identidad y calidad de sesión.
Usa proxies residenciales o móviles para acciones de cuenta, entradas de rifa y cualquier flujo donde la plataforma evalúe historial de usuario sobre comportamiento de ráfaga. Mantén cada cuenta vinculada a un perfil de navegador persistente en AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc. Calienta la cuenta con el tiempo, mantén la geografía consistente y evita rotar sesiones solo porque el dashboard lo permite. La rotación resuelve un problema y crea otro si el objetivo espera un usuario estable.
Para equipos que quieren un proveedor a través de tráfico residencial, móvil, ISP, datacenter e IPv6, Sota Proxy es una opción. La ventaja práctica es simplicidad operacional. Un dashboard para sesiones persistentes, geo targeting y política de rotación es más fácil de administrar que unir varios proveedores de proxies a través de tareas de zapatillas, scraping, trabajo de cuentas de anuncios y pruebas específicas de mercado.
Usa esta lista de verificación:
- Separa el tráfico de monitor del tráfico de ejecución
- Usa sesiones persistentes donde la continuidad de sesión afecte la confianza
- Calienta cuentas antes de acciones de alto valor
- Mantén las huellas digitales del navegador estables por cuenta
- Coloca el cómputo cerca de la región objetivo
- Gasta inventario premium de proxy solo en pasos evaluados
- Rastrea cancelaciones separadamente de checkouts pasados
- Trata los bots para zapatillas como infraestructura, no solo software
Artículos relacionados
Qué es Sticky Session: Guía Técnica para Usuarios de Proxies
Descubre qué es sticky session, cómo funciona la afinidad de sesión en balanceadores de carga y proxies, y cuándo usarla para multi-accounting, scraping y campañas publicitarias.
Cómo Evitar CAPTCHA en Flujos de Trabajo Automatizados
Aprende cómo evitar CAPTCHA en flujos de trabajo automatizados con tácticas de proxies, navegadores antidetección, control de ritmo de solicitudes y respaldos de resolución diseñados para operadores reales.
Integración de Proxy en AdsPower: La Guía Completa de Configuración
Integración paso a paso de proxy en AdsPower con SotaProxy. Cubre configuración, tipos de proxy, rotación, solución de problemas y mejores prácticas para flujos de trabajo con múltiples cuentas.
7 Mejores Proveedores de Proxies para Arbitraje y Scraping
Compara 7 proveedores de proxies destacados según tipos de IP, segmentación, rotación, uptime, señales de precios y adecuación para scraping, cuentas publicitarias, farming y arbitraje.
Los 10 Mejores Servicios de Proxy para Anuncios, Scraping y Automatización
Compara los mejores servicios de proxy para verificación de anuncios, scraping, operaciones de cuentas y geo-targeting según tipo de IP, precio, tiempo de actividad y controles.
10 Alternativas a Smartproxy para Equipos Técnicos
Compara 10 alternativas a smartproxy según tipo de proxy, calidad de IP, segmentación, rotación, velocidad, precios y caso de uso para equipos técnicos.