Código de respuesta HTTP 503: solucionar errores de servidor y proxy
Comprende el código de respuesta HTTP 503. Guía práctica para equipos de arbitraje de tráfico y automatización: diagnostica y soluciona problemas de carga del servidor y proxies.
Lanzas un lote de anuncios de Facebook o TikTok a través de AdsPower o Dolphin Anty. El flujo de calentamiento se ve limpio. Las cookies se mantienen. Los proxies se autentican. Luego, las solicitudes comienzan a fallar en todos los frentes con 503 Service Unavailable.
Ese es el tipo de problema que mata el impulso del farming de cuentas, las verificaciones de cloaking, las campañas geolocalizadas y los trabajos de scraping al mismo tiempo. Es peor cuando el objetivo aún se carga en un navegador normal, porque ahora te quedas haciéndote la pregunta crítica: ¿está caída la plataforma, tu propio stack de landing está colapsando, o tu capa de proxy acaba de convertirse en el cuello de botella?
La mayoría de las guías se detienen en "el servidor está sobrecargado". Eso no es suficiente para operadores multiusuario que ejecutan GoLogin, Multilogin, Hidemyacc o automatización personalizada contra plataformas de anuncios y flujos de revisión. En la práctica, los 503 a menudo se encuentran en el límite entre la capacidad del origen, el comportamiento del CDN, los controles anti-bot y la mala rotación de proxies. Si no separas esas capas rápidamente, perderás horas escalando lo incorrecto o cambiando infraestructura saludable sin razón.
Tabla de contenidos
- Por qué el error 503 detiene tu automatización en seco
- Qué significa realmente un error 503
- Diagnóstico de la verdadera fuente de errores 503
- Reforzar tu infraestructura contra 503s
- Estrategias del lado del cliente para manejar 503s con elegancia
- Tácticas avanzadas de proxy para evadir disparadores 503
- Construcción de un stack de automatización resiliente
Por qué el error 503 detiene tu automatización en seco
Un 503 generalmente aparece en el peor momento. Tienes cuentas de anuncios de Facebook listas, creativos de TikTok divididos por GEO, perfiles de navegador antidetección mapeados uno a uno con proxies, y un conjunto de reglas de cloaking que pasó verificaciones anteriores. Luego, una sola ola de 503s comienza a propagarse en cascada por toda la operación.
En un equipo de compra de medios, eso significa prelanders fallidos, verificaciones de revisión rotas y lanzamientos de campaña retrasados. En una configuración de farming de cuentas, significa que las acciones del perfil se detienen a mitad de camino y la coherencia se pierde. En trabajos de scraping o verificación de anuncios, significa que tu recolector no puede distinguir si el objetivo es inestable o si tu propio patrón de solicitudes causó el fallo.
El error costoso es tratar cada 503 como el mismo evento.
A veces el objetivo realmente está sobrecargado o en mantenimiento. A veces tu propio host de cloaking o embudo de WordPress no puede absorber una ráfaga. A veces el nivel de proxy está limitando la tasa, cortando conexiones upstream o rotando tan agresivamente que el objetivo interpreta tu tráfico como hostil. Esa última categoría se pasa por alto todo el tiempo, especialmente en stacks que combinan scripts headless, navegadores antidetección y pools rotatorios.
Regla práctica: Si el mismo endpoint funciona desde una sesión de navegador limpia pero falla a través de tu ruta de automatización, no empieces escalando servidores. Primero aísla las diferencias de identidad, proxy y modelado de solicitudes.
Por eso los equipos que ejecutan operaciones masivas necesitan un flujo de trabajo de diagnóstico, no una suposición. La forma más rápida de dejar de quemar presupuesto es probar las capas de objetivo, origen y proxy por separado, luego comparar el comportamiento bajo el patrón de carga de trabajo exacto que estás enviando. Si tu operación incluye tareas de análisis o recolección, un flujo de trabajo de web scraping dedicado también ayuda a exponer si los fallos están relacionados con la concurrencia de solicitudes, la combinación de GEO o la reputación de IP en lugar de bugs puros de la aplicación.
Qué significa realmente un error 503
El código de estado HTTP 503 Service Unavailable existe desde hace mucho tiempo. Se definió formalmente en 1999 con el RFC 2616, que estandarizó HTTP/1.1 y posicionó el 503 como un error de servidor utilizado cuando el servidor no puede manejar temporalmente la solicitud, típicamente debido a sobrecarga o mantenimiento programado, como se documenta en la referencia de estado 503 de MDN.
Rechazo temporal, no fallo permanente
La palabra clave es temporal.
Un 503 significa que el servicio es lo suficientemente accesible para responder, pero no está dispuesto o no puede procesar la solicitud en este momento. Eso es diferente de una ruta de aplicación rota, una cadena upstream muerta o un timeout en una puerta de enlace esperando algo más.
Para los equipos de automatización, esa distinción cambia la respuesta:
- Si es un 503, los reintentos ciegos inmediatos a menudo empeoran la situación.
- Si es un 500, puedes estar encontrando un fallo de aplicación.
- Si es un 502 o 504, el fallo puede estar en un proxy, balanceador de carga o ruta de dependencia upstream.
Por eso es importante leer el estado exacto cuando estás gestionando acciones de cuenta en GoLogin, flujos de farming en Multilogin o simulaciones de revisión para páginas de cloaking. Un 503 a menudo significa "retrocede e inspecciona la presión". Normalmente no significa "envía un parche de código ahora mismo".
Referencia rápida de errores de servidor 5xx
| Código de estado | Nombre | Qué significa para ti |
|---|---|---|
| 500 | Internal Server Error | La aplicación o el servidor se rompió de manera genérica. Verifica errores de app, despliegues recientes y rutas de excepción. |
| 502 | Bad Gateway | Un proxy o gateway obtuvo una mala respuesta desde upstream. Verifica proxies inversos, balanceadores de carga y salud upstream. |
| 503 | Service Unavailable | El servicio rechaza temporalmente el tráfico, a menudo por sobrecarga o mantenimiento. Desacelera, reintenta con cuidado e inspecciona señales de capacidad o limitación. |
| 504 | Gateway Timeout | Un proxy o gateway esperó demasiado tiempo por upstream. Verifica backends lentos, pools de conexión y configuraciones de timeout. |
Un 503 dice que la puerta está ahí, pero el servicio detrás de ella no puede tomar tu solicitud en este momento.
Para los profesionales, eso generalmente significa dos verificaciones inmediatas. Primero, verifica si el mismo fallo aparece en múltiples identidades y rutas de red. Segundo, observa si el fallo está vinculado a ráfagas, eventos de rotación o una etapa específica en el flujo como inicio de sesión, carga de creativos o fetch de landing page.
Si te saltas eso y simplemente reinicias todo, difuminarás la señal que necesitas.
Diagnóstico de la verdadera fuente de errores 503
Un error común ocurre cuando se ve un 503, llevando directamente a la suposición de "origen sobrecargado". En stacks de automatización, esa es solo una posible causa.
Comienza con evidencia de tu propio stack
Comienza con logs y presión de recursos. En stacks Apache, Nginx y PHP, patrones como reached pm.max_children, upstream timed out y no live upstreams son señales prácticas de que has alcanzado el agotamiento de workers o perdido un backend, como se describe en la guía de solución de problemas 503 de ClickMinded.
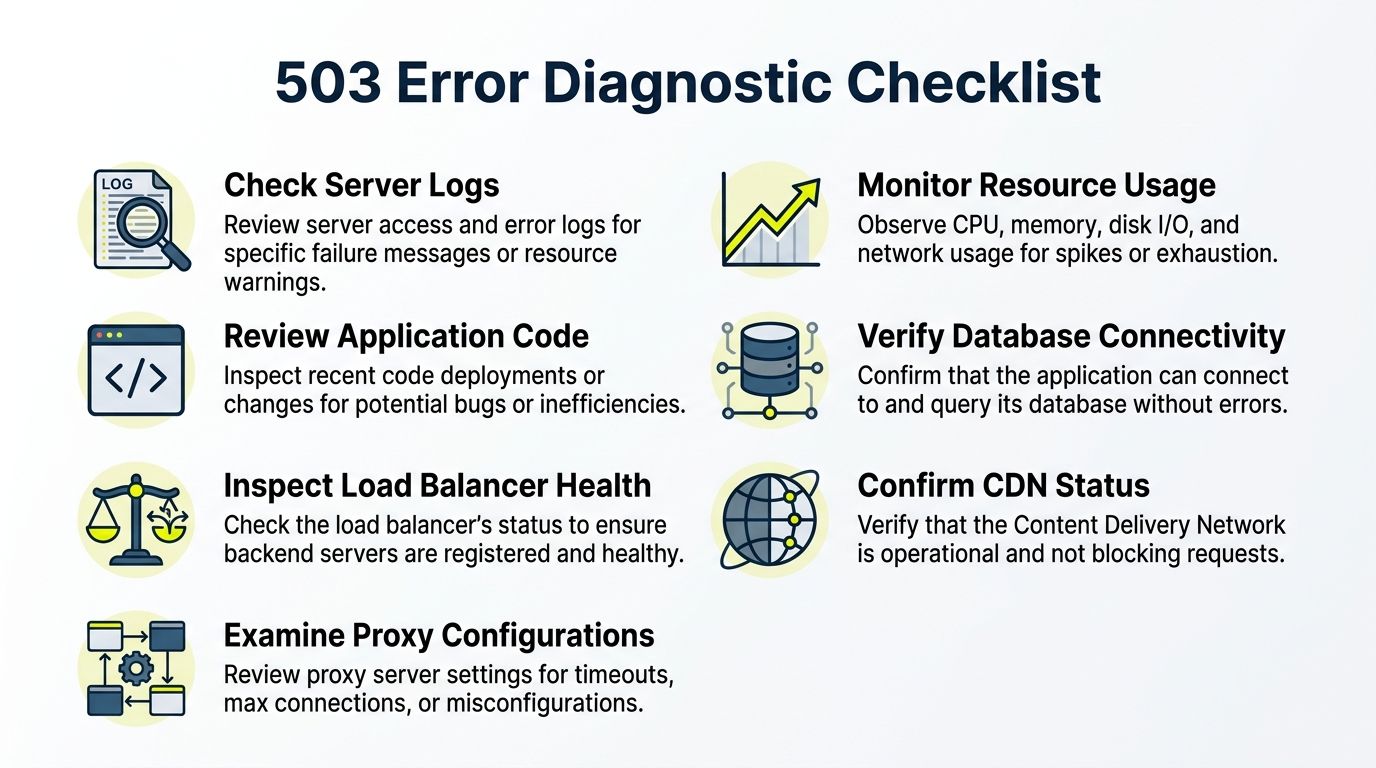
Usa una lista de verificación corta antes de tocar nada:
- Lee los logs de errores primero: No adivines desde la salida del navegador. Revisa logs del servidor web, logs de app y logs de proxy en la misma ventana de tiempo.
- Verifica la saturación de workers: Si los children de PHP-FPM están agotados, las colas de solicitudes se acumulan rápido y los 503s se propagan a rutas que de otro modo serían saludables.
- Busca upstreams muertos:
no live upstreamsgeneralmente significa que el proxy inverso perdió backends saludables, no que toda la aplicación desapareció. - Compara el comportamiento de endpoints: Si los activos estáticos se sirven pero los handlers de login o redirect fallan, el cuello de botella puede estar en workers de app o acceso a base de datos.
- Mapea fallos a deploys o trabajos cron: Ventanas de mantenimiento, importaciones y sincronizaciones de feeds a menudo crean picos predecibles de 503.
Muchos embudos de arbitraje fallan aquí porque los operadores sobrecargan WordPress con plugins, rastreadores, lógica de redirección y verificaciones de cloaking. La página puede renderizar bajo pruebas manuales pero colapsar bajo tráfico simultáneo de bot y revisor.
Luego aísla la capa de proxy
Ahora prueba el mismo objetivo a través de diferentes rutas.
Si los endpoints de negocios de Facebook, los flujos de carga de TikTok o las verificaciones de landing page fallan solo a través de una subred de proxy o una política de rotación, no estás viendo una interrupción universal. Estás viendo un problema de modelado de tráfico. Eso puede significar limitación upstream en tu red de proxy, un rango de IP quemado o concurrencia de solicitudes que parece lo suficientemente sintética para desencadenar comportamiento protector.
Esto importa para usuarios de AdsPower, Dolphin Anty, GoLogin, Multilogin e Hidemyacc porque la huella digital del navegador puede permanecer estable mientras la firma de red cambia por debajo. El perfil se ve normal. El comportamiento de la IP no.
Para equipos que depuran estos problemas de límite, ayuda entender cómo los servidores proxy y firewalls interactúan, especialmente cuando reintentos, reutilización de conexiones y reglas de filtrado se apilan uno encima del otro.
Una ayuda visual rápida es útil cuando el equipo está solucionando problemas bajo presión.
Un árbol de decisión rápido para operadores
Usa esto en operaciones en vivo:
- Prueba desde una ruta limpia sin automatización. Si el objetivo también falla allí, el problema es más amplio.
- Prueba la misma solicitud a través de un segundo grupo de proxies. Si el fallo desaparece, tu primer pool es el sospechoso.
- Ejecuta la solicitud con menor concurrencia. Si los 503s se desvanecen, probablemente estás alcanzando umbrales de capacidad o limitación.
- Verifica si todos los GEOs fallan por igual. Las campañas geolocalizadas a menudo se rompen de manera desigual porque las rutas edge y el filtrado local difieren.
- Inspecciona tu propia cadena upstream. Redirecciones de cloaking, middleware anti-bot, workers de app y bases de datos pueden ser cada uno el punto más estrecho.
No preguntes "¿está caído el sitio?" Pregunta "¿qué capa rechaza esta solicitud bajo esta forma de tráfico?"
Esa pregunta te lleva a la solución mucho más rápido.
Reforzar tu infraestructura contra 503s
Si controlas el origen, deja de tratar los 503s como un evento aleatorio. Generalmente exponen una decisión de ingeniería que aún no has reforzado.
Las causas comunes del lado del servidor incluyen picos de tráfico, mantenimiento programado, plugins defectuosos y configuraciones incorrectas del servidor. Los embudos basados en WordPress son especialmente vulnerables cuando el uso intensivo de plugins drena recursos, como se describe en la descripción general de causas HTTP 503 de Network Solutions.
Primero soluciona los cuellos de botella obvios
Comienza con las partes que probablemente fallen bajo tráfico de ráfaga:
- Workers de aplicación: Si los pools de workers son demasiado pequeños, se forman colas antes de que la CPU siquiera se vea estresada.
- Límites de proxy inverso: Configuraciones incorrectas de keepalive, buffer o upstream pueden hacer que un backend saludable parezca no disponible.
- Embudos con muchos plugins: Lógica de cloaking, rastreadores, constructores de páginas y hooks adicionales agregan latencia y presión de memoria.
- Dependencias de base de datos: Las consultas lentas a menudo se manifiestan como estancamientos de aplicación, luego Nginx o Apache lanza 503s upstream.
Muchos operadores pierden tiempo ajustando el comportamiento del front-end mientras dejan un origen débil sin tocar. Eso no funciona. Si tu stack de landing cloakeado no puede sobrevivir una ráfaga de verificaciones de aprobación de campaña más tráfico en vivo más tus propios bots de monitoreo, no está listo para producción.
Construye para ráfagas, no para carga promedio
Tu infraestructura tiene que absorber tráfico desigual. Eso significa planificar para presión repentina de lanzamientos de campañas, reintentos de bot, pases de QA y tráfico de verificador llegando juntos.
Usa balanceadores de carga cuando una caja está haciendo demasiado. Distribuye el trabajo entre múltiples instancias de app. Agrega reglas de autoescalado si estás en infraestructura cloud. Mantén las ventanas de mantenimiento aisladas de las ventanas de lanzamiento. Si construyes tu propia capa de proxy o relay para enrutamiento interno, esta guía sobre cómo hacer un servidor proxy es útil para entender dónde el manejo de conexiones y la mala configuración pueden introducir nuevos puntos de fallo 503.
Nota de campo: La mayoría de los incidentes de "503 misterioso" en infraestructura propia resultan ser saturación predecible mezclada con observabilidad débil.
También mantén tu stack simple. Si un plugin, hook de middleware o capa de redirección no produce un valor operativo claro, elimínalo. Cada pieza móvil adicional es otro lugar donde desaparecen el tiempo de worker y la memoria.
Estrategias del lado del cliente para manejar 503s con elegancia
Incluso con un servidor limpio y buenos proxies, algunos 503s aún ocurrirán. Tu cliente tiene que comportarse como un adulto cuando lo hagan.
AWS CloudFront señala que un 503 generalmente apunta a sobrecarga del origen, mantenimiento o agotamiento de recursos, pero en casos raros también puede provenir de restricciones de recursos en una ubicación edge, por lo que el comportamiento inteligente de reintento importa en el lado del cliente, como se explica en la documentación 503 de CloudFront.
Lógica de reintento que no empeora las cosas
La peor respuesta a un 503 es martilleo instantáneo.
Si tu script reintenta inmediatamente a concurrencia completa, estás alimentando la condición exacta que causó el rechazo. Esto es común en herramientas de farming de cuentas y scripts de verificación de anuncios que asumen que cada fallo es transitorio y barato de reintentar.
Usa backoff exponencial. Comienza con un retraso corto. Aumenta la espera después de cada 503 repetido. Agrega jitter para que tus workers no reintenten en una ola sincronizada. Limita el conteo de reintentos para que trabajos estancados no hagan loop para siempre.
Un patrón de implementación práctica:
- Primer fallo: Pausa brevemente y marca el objetivo como degradado.
- Fallo repetido: Aumenta el retraso y reduce la concurrencia para esa ruta o identidad.
- Fallo persistente: Detén la tarea y vuelve a encolarla más tarde en lugar de forzarla.
Si construyes crawlers o bots de verificación, la misma lógica pertenece a tus recolectores desde el día uno. Esto es especialmente cierto para equipos que hacen rastreo web en Python contra objetivos que mezclan CDNs, defensa anti-bot y salud upstream inconsistente.
Usa un disyuntor cuando un servicio empiece a fallar
Un disyuntor es una idea simple. Cuando un servicio sigue fallando, tu cliente deja de enviarle tráfico durante un período de enfriamiento.
Eso protege tus recursos y le da al objetivo tiempo para recuperarse. También evita que una dependencia ruidosa se propague en cascada a cada cuenta, cola o proceso worker que posees.
Úsalo cuando:
- Un objetivo comienza a devolver 503s agrupados: No dejes que cada worker descubra el mismo fallo independientemente.
- Una ruta GEO se degrada: Abre el disyuntor solo para esa ruta, no para todo el sistema.
- Un grupo de proxy se vuelve tóxico: Suspende el pool y mueve el trabajo a otro lado.
El backoff maneja fallos aislados. Un disyuntor maneja inestabilidad repetida.
Para operaciones de anuncios, esto importa porque un endpoint roto no debería congelar todos los flujos de trabajo de Facebook o TikTok. Segmenta por plataforma, GEO, tipo de tarea y grupo de proxy para que un dominio de fallo no contamine todo lo demás.
Tácticas avanzadas de proxy para evadir disparadores 503
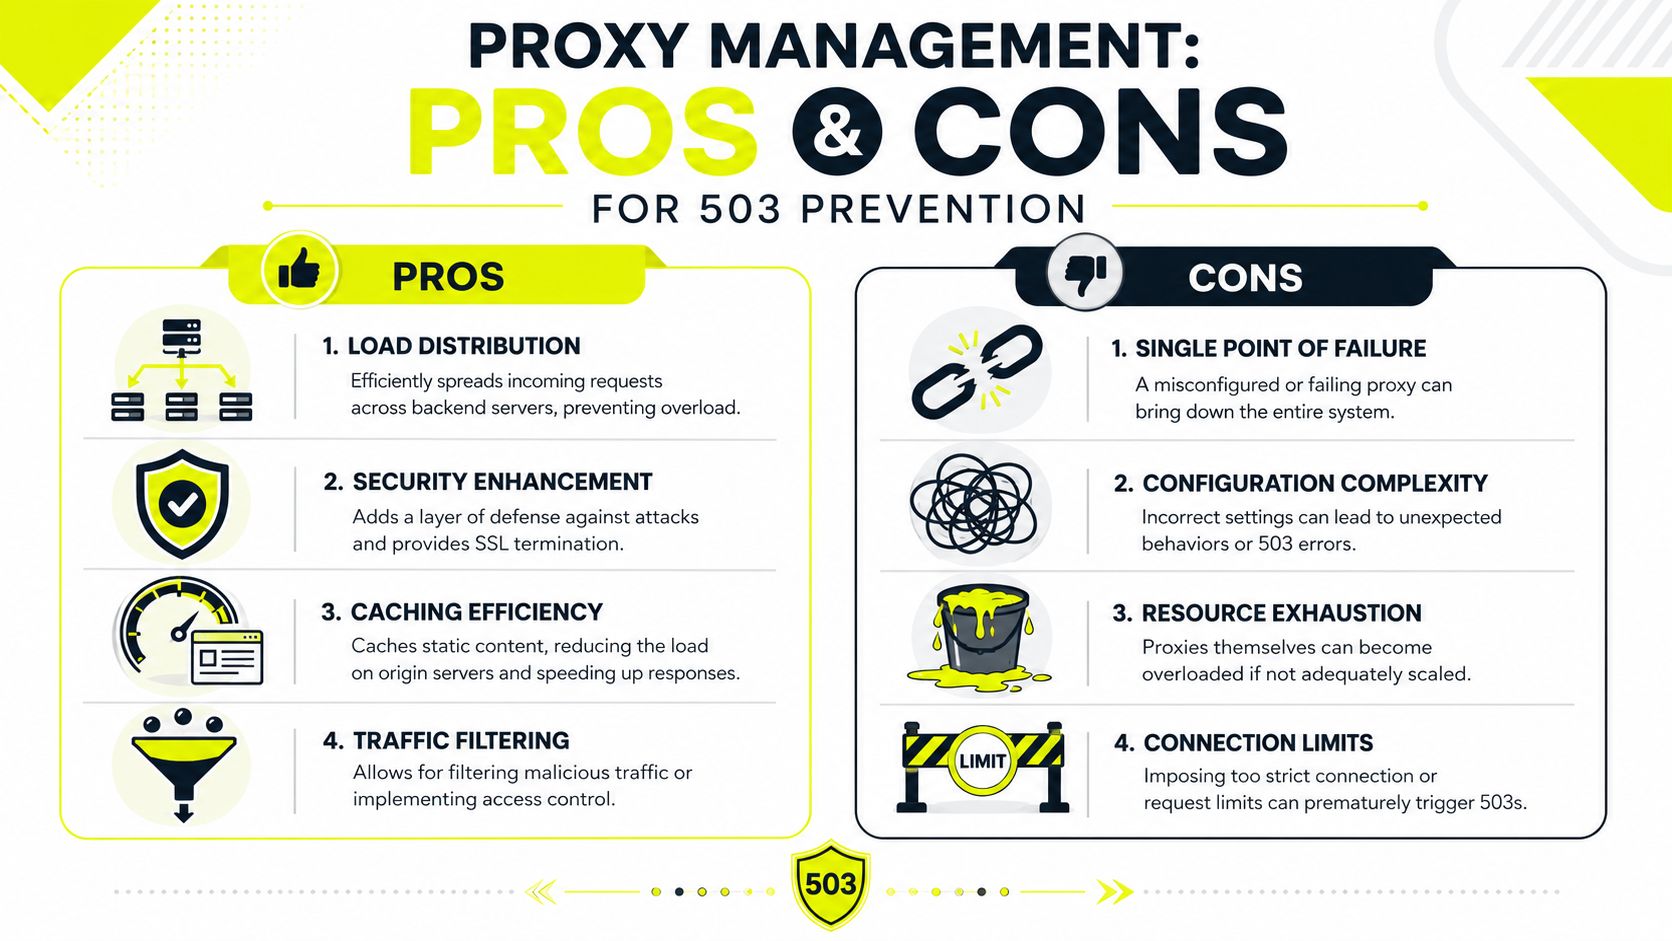
La mayoría de las guías estándar de 503 se quedan cortas. Hablan sobre sobrecarga del origen y se detienen ahí. En automatización real, los proxies pueden crear, amplificar u ocultar el fallo.
La orientación técnica existente a menudo pasa por alto cómo las ráfagas de solicitudes impulsadas por proxy distorsionan los diagnósticos y hacen difícil separar la indisponibilidad real del comportamiento de limitación en cargas de trabajo automatizadas, como señala la discusión de manejo de 503 de HTTP.dev.
No todos los tipos de proxy fallan de la misma manera
La elección de proxy afecta directamente la frecuencia con la que desencadenas patrones de rechazo similares a 503.
Los proxies de datacenter son rápidos y baratos. Son buenos para tareas con mucho rendimiento donde los requisitos de confianza del objetivo son bajos. También se marcan más rápido en plataformas sensibles porque sus patrones de red son más fáciles de clasificar. Para scraping crudo contra objetivos tolerantes, están bien. Para cuentas de anuncios de Facebook, flujos de revisión de TikTok o verificaciones de cloaking, a menudo son los primeros en quemarse.
Los proxies residenciales se parecen más al tráfico de usuario normal porque las solicitudes provienen de redes de consumidores. Generalmente se ajustan mejor a operaciones de cuentas, verificación de anuncios y verificaciones geolocalizadas que los pools compartidos de datacenter. Cuestan más, pero reducen la fricción donde importa la confianza.
Los proxies móviles son la opción más segura para las acciones de cuenta más sensibles. Heredan la confianza de comportamiento de las redes de operador y a menudo sobreviven al escrutinio anti-bot más estricto. También introducen sus propios compromisos, incluyendo rendimiento menos predecible y necesidades de manejo de sesión más cuidadosas.
Los proxies IPv6 pueden ser útiles cuando el objetivo soporta bien IPv6 y necesitas amplia disponibilidad de direcciones. No son una actualización universal. Algunos objetivos aún tratan el tráfico IPv6 de manera diferente, y algunos sistemas de terceros en tu cadena no lo manejan limpiamente. Pruébalos por carga de trabajo, no por suposición.
La estrategia de rotación importa más que el tamaño bruto del pool
Los operadores aman los pools grandes. Los pools grandes no salvan el mal modelado de tráfico.
Si rotas en cada solicitud mientras realizas un inicio de sesión, checkout, edición de cuenta de anuncios o flujo de sesión warm, destruyes la continuidad. Eso puede desencadenar controles de tasa, desajustes de identidad y patrones de tráfico sintético. Por otro lado, si mantienes una IP sticky demasiado tiempo en acciones concurrentes agresivas, puedes sobrecargar esa ruta e invitar su propia respuesta de limitación.
Usa rotación basada en el tipo de tarea:
- Sesiones sticky para trabajo de cuentas: Mejor para sesiones de cuentas de Facebook y TikTok, perfiles de AdsPower y entornos de Multilogin donde importa la continuidad.
- Rotación programada para lotes de scraping: Mejor para trabajos de recolección que necesitan distribución sin cambiar identidad en cada solicitud.
- Particionamiento controlado de pool por GEO: Mantén el tráfico para cada país o ciudad dentro de un segmento de proxy coincidente para que las campañas geolocalizadas no deriven.
Si estás ajustando esta capa, las estrategias de rotación de IP de proxy son una de las primeras cosas a revisar cuando aparecen 503s en ráfagas.
Ajusta el comportamiento del proxy a la carga de trabajo
No ejecutes todos los trabajos a través de una política universal.
El farming de cuentas necesita sesiones estables, bajo ruido y coherencia de red que coincida con el perfil antidetección. Las verificaciones de cloaking necesitan alineación GEO limpia y simulación de revisor repetible. Los scrapers necesitan controles de concurrencia vinculados a la reputación del dominio y la estabilidad de la ruta. La verificación de anuncios necesita precisión de ubicación más que velocidad de solicitud pura.
Eso significa dividir tu lógica de proxy por clase de trabajo, no solo por objetivo.
Un mapeo práctico se ve así:
| Carga de trabajo | Comportamiento de proxy que generalmente funciona | Lo que a menudo causa problemas 503 |
|---|---|---|
| Acciones de cuenta de anuncios de Facebook o TikTok | Sesiones sticky residenciales o móviles | Rotación por solicitud durante flujos autenticados |
| Farming de cuentas en AdsPower, GoLogin, Multilogin, Dolphin Anty, Hidemyacc | Mapeo estable sesión-a-perfil | Reutilizar subredes ruidosas en muchos perfiles |
| Verificaciones de cloaking y GEO | IPs residenciales limpias que coinciden con la intención de ubicación | Desajuste GEO, nodos relay sobrecargados y tormentas de reintentos |
| Lotes grandes de scraping | Rotación controlada con límites de concurrencia | Ráfagas de pool compartido que parecen abuso |
El rendimiento de proxy barato puede ser caro si convierte el tráfico ordinario en una fábrica de 503.
Construcción de un stack de automatización resiliente
Un stack confiable no intenta eliminar cada 503. Asume que algunos ocurrirán y sigue operando de todos modos.
Trata el manejo de 503 como arquitectura
El modelo duradero tiene tres capas.
Primero, la capa de cliente necesita backoff, disyuntores, colas de tareas y controles de concurrencia. Eso evita que un servicio inestable arrastre toda la operación hacia abajo.
Segundo, la capa de red necesita políticas de proxy vinculadas a la carga de trabajo real. Usa sesiones estables para acciones de cuenta en AdsPower, Dolphin Anty, GoLogin, Multilogin e Hidemyacc. Usa rotación controlada para scrapers. Mantén las cuentas de anuncios de Facebook y TikTok alineadas con el GEO correcto y el comportamiento de sesión. No dejes que el farming de cuentas, cloaking y trabajos de recolección compartan el mismo pool ruidoso por defecto.
Tercero, la capa de origen tiene que sobrevivir ráfagas si alojas tus propios prelanders, redirectores o páginas cloakeadas. Elimina plugins débiles, observa los límites de workers y escala las partes que se saturan.
Cuando los equipos hacen esto bien, los 503s dejan de ser un misterio. Se convierten en otra señal en el sistema. Una que te dice si debes desacelerar el cliente, reemplazar un segmento de proxy o arreglar tu propia infraestructura.
Si también recomiendas infraestructura a otros operadores, también hay un ángulo de negocio. Algunos proveedores de proxy ejecutan programas de referidos que pagan comisión recurrente. Sota Proxy, por ejemplo, ofrece un programa de afiliados con hasta 40% de comisión, lo que puede tener sentido para equipos que ya estandarizan herramientas en cuentas de clientes o grupos de compra internos.
Si tu stack depende de geolocalización limpia, sesiones estables y comportamiento de proxy predecible para scraping, verificación de anuncios, gestión de cuentas o cloaking, Sota Proxy está construido para ese tipo de carga de trabajo. Soporta opciones residenciales, móviles, ISP, datacenter e IPv6, más control de rotación y sesión sticky, para que puedas modelar el tráfico alrededor del trabajo en lugar de forzar cada flujo de trabajo a través de una política de proxy frágil.
Artículos relacionados
Qué es un Forward Proxy: Guía completa para 2026
Aprende qué es un forward proxy, cómo funciona para el tráfico saliente y por qué los equipos lo usan con navegadores antidetección para Facebook, TikTok y web scraping.

Clave API de Bing Search: Configuración, Pruebas y Escalado en 2026
Obtén una clave API de Bing Search funcional en 2026, prueba solicitudes, protege la clave y escala scraping de alto volumen sin bloqueos. Guía práctica para equipos técnicos.

10 Formas de Recopilar Datos Cualitativos para Compradores de Medios
Descubre 10 formas de recopilar datos cualitativos de tus usuarios. Aprende métodos como entrevistas y grupos focales para optimizar el uso de proxies y la estrategia de campañas.
Para Qué Se Usa un Proxy: Guía de Arbitraje 2026
Para qué se usa un proxy - Descubre para qué se utiliza un proxy en 2026, desde mejorar la seguridad hasta gestionar operaciones multiaccount para equipos de arbitraje
ERR_TUNNEL_CONNECTION_FAILED: The Error Name Is the Diagnosis
Chrome asked a proxy to open a CONNECT tunnel and it failed. That is the whole error. Where the proxy comes from when you never configured one, the six ways a proxy you did configure produces it, and why clearing your cache fixes nothing.
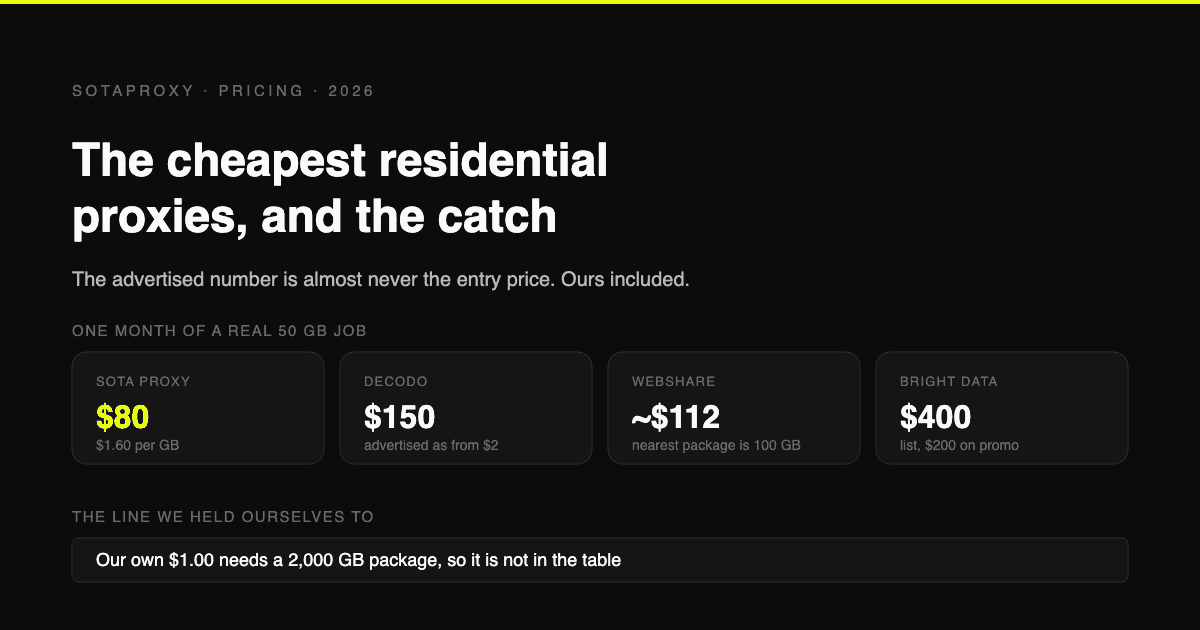
Los proxies residenciales más baratos en 2026 y la trampa que esconde cada uno
Precios verificados por gigabyte directamente de las páginas de cinco proveedores, no de artículos del año pasado. Por qué el precio anunciado casi nunca es el de entrada, qué proveedores te obligan a un mínimo mensual y cómo calcular tu coste real por gigabyte.