¿Qué es el 99.9% de Uptime? Desglose Práctico para Usuarios de Proxies
¿Qué es el 99.9% de uptime? Convierte este porcentaje en tiempo de inactividad diario, mensual y anual, compara niveles de servicio y revisa los SLAs antes de comprar.
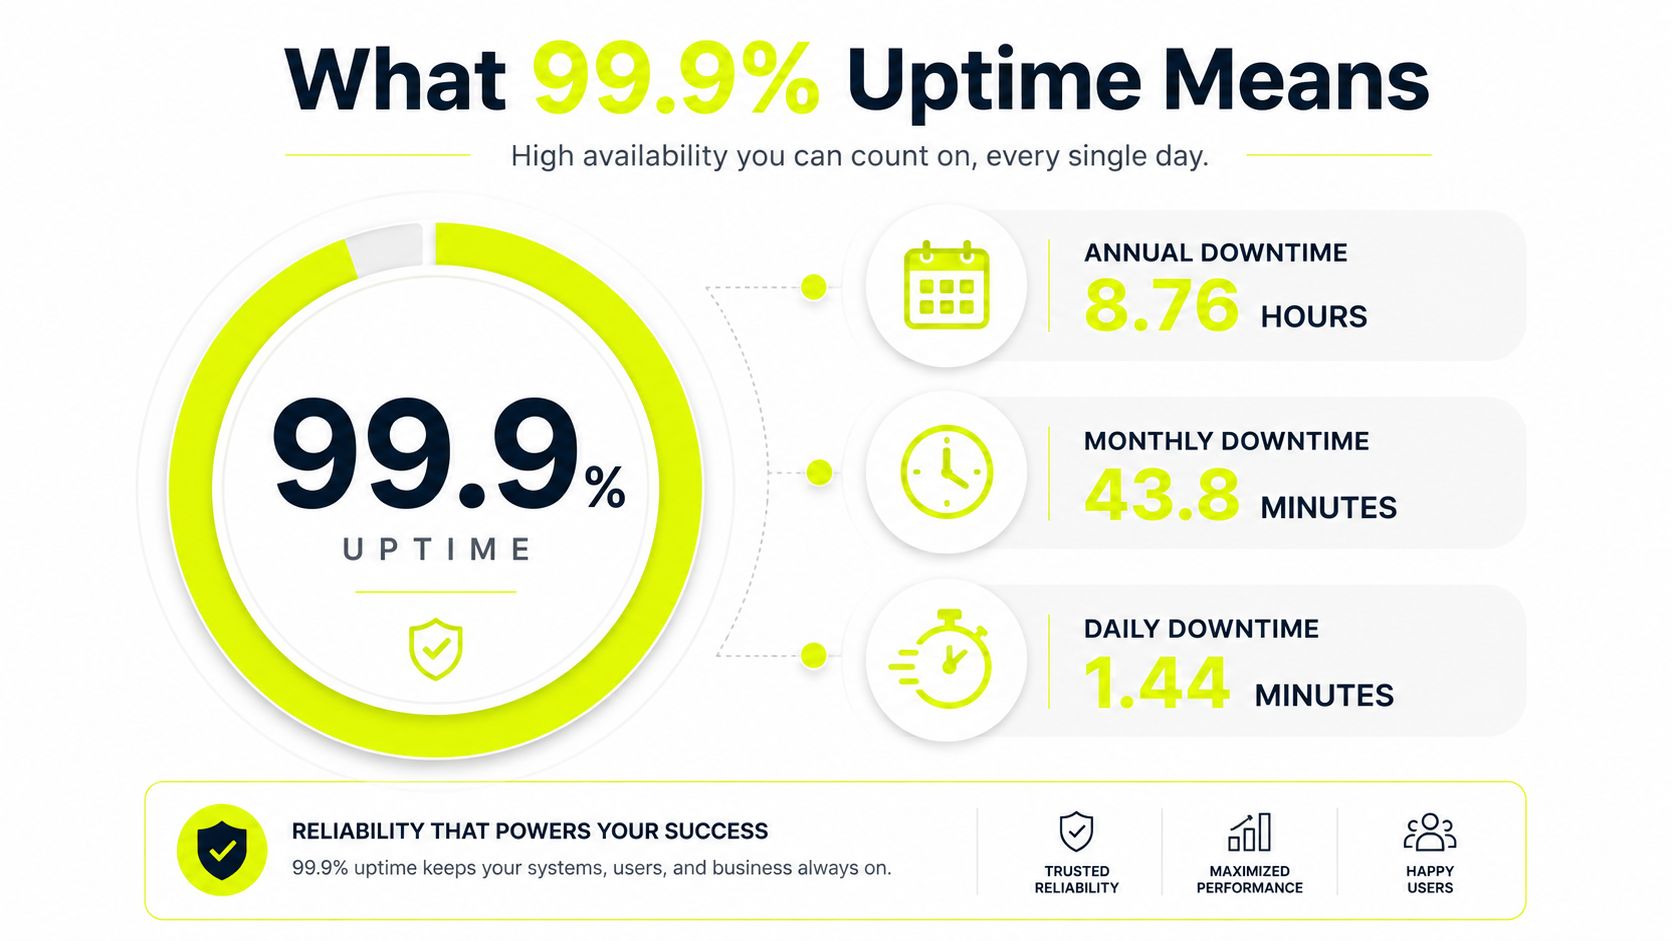
99.9% de tiempo de actividad significa aproximadamente 43 minutos de tiempo de inactividad permitido por mes y aproximadamente 8 horas 45 minutos por año. Eso no es "siempre activo". Es un nivel de servicio con un presupuesto real de interrupciones, y un solo incidente grave puede consumir rápidamente una gran parte de él.
Tabla de Contenidos
- Qué Significa Realmente el 99.9% de Tiempo de Actividad en la Práctica
- Convirtiendo el 99.9% en Cifras Reales de Tiempo de Inactividad
- Comparando los Niveles 99%, 99.9%, 99.99% y 99.999%
- Cómo los SLAs Establecen el 99.9% y Qué Excluyen Silenciosamente
- Qué Significa el 99.9% para las Cargas de Trabajo Proxy en la Práctica
- Verificando la Afirmación de Tiempo de Actividad de un Proveedor Antes de Comprar
- Eligiendo el Nivel Correcto de Tiempo de Actividad y Poniéndolo en Práctica
Qué Significa Realmente el 99.9% de Tiempo de Actividad en la Práctica
Tres nueves suena bien en una página de ventas, pero las matemáticas son contundentes. 99.9% de tiempo de actividad aún permite aproximadamente 43 minutos de tiempo de inactividad por mes y aproximadamente 8 horas 45 minutos por año (referencia de tres nueves de Hyperping). Eso es espacio suficiente para una interrupción real, no solo un parpadeo cosmético.
Para los operadores de proxies, esa asignación es la parte que importa. Si estás ejecutando cuentas de anuncios de Facebook, cuentas de anuncios de TikTok, farming de cuentas, cloaking o campañas geo-localizadas, la pregunta es si una interrupción ocurre dentro de una ventana de gasto, una sesión de farming o una ejecución de scraping que ya tomó horas en cola. Una breve interrupción puede desperdiciar sesiones precalentadas, romper el timing de rotación o forzar a que una ejecución se reinicie desde cero.
Regla práctica: no trates el 99.9% como "siempre activo". Trátalo como un presupuesto limitado de interrupciones, porque una vez que lo gastas en la ventana equivocada, el mes se vuelve más difícil de recuperar.
Por eso el 99.9% aparece tan frecuentemente en el marketing de proxies y SaaS. Es un SLA empresarial básico, no una promesa de que nada te interrumpirá. El servicio aún puede caerse el tiempo suficiente para importar, y un incidente prolongado puede consumir la mayor parte de la asignación del mes. La pregunta correcta es si ese presupuesto de interrupciones coincide con tu carga de trabajo, tu lógica de reintentos y tu tolerancia a la pérdida de sesiones.
La propia política de uso justo de Sota Proxy pertenece a la misma discusión, porque el tiempo de actividad solo importa si la plataforma también mantiene los patrones de tráfico lo suficientemente controlados como para proteger la calidad del pool. Ese es el lado operativo que los proveedores a menudo minimizan. Si estás comparando afirmaciones, lee la política y el SLA juntos.
Como señala CloudOrbis Inc. sobre interrupciones de TI, una mentalidad útil es simple. El 99.9% es una línea base para la continuidad, no inmunidad contra la interrupción. Si tu carga de trabajo puede absorber pausas, el número puede estar bien. Si una interrupción rompe un ciclo de campaña, necesitas probar al proveedor más que el titular del SLA.
Convirtiendo el 99.9% en Cifras Reales de Tiempo de Inactividad
Un año tiene 525,600 minutos, y 0.1% de eso son 525.6 minutos de tiempo de inactividad permitido. Esas son las matemáticas detrás del titular. También es por eso que 99.9% de tiempo de actividad se traduce en aproximadamente 1 minuto 26 segundos por día, aproximadamente 10 minutos por semana y aproximadamente 43 minutos por mes (explicación de SLA de tiempo de actividad de Web-Alert).
La conversión que debes tener en mente
Usa un año como base y convierte desde ahí. Eso mantiene las matemáticas honestas e impide que los proveedores seleccionen una ventana más favorable.
| Nivel de tiempo de actividad | Por día | Por semana | Por mes, 30d | Por año, 365d |
|---|---|---|---|---|
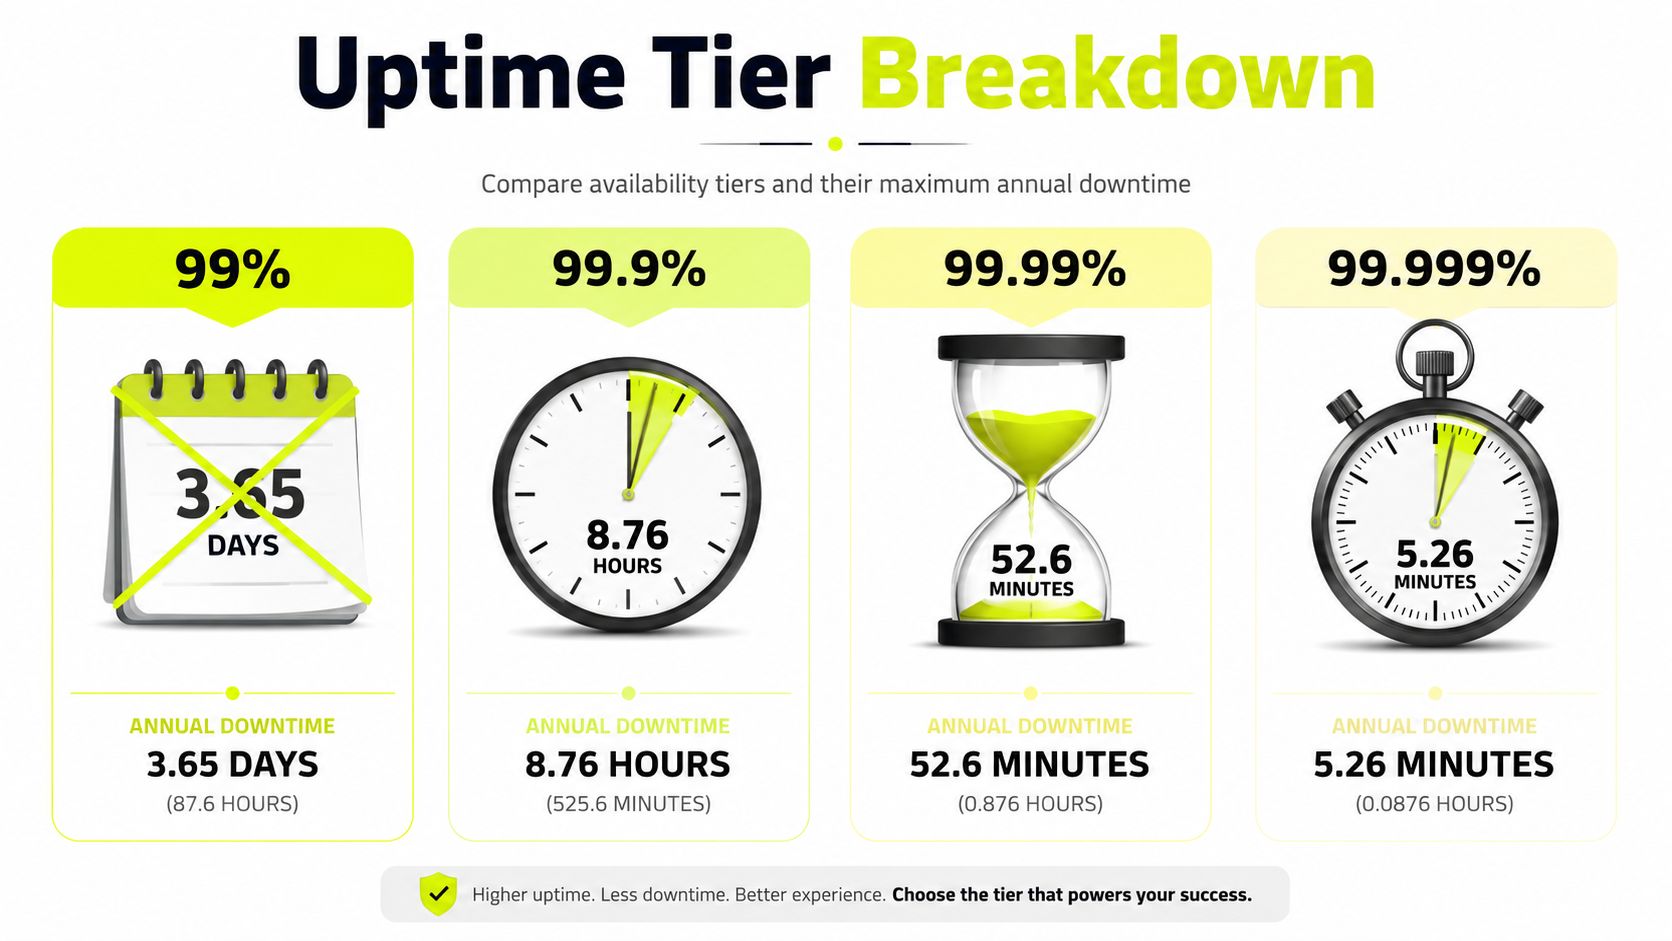
| 99% | aproximadamente 14 minutos 24 segundos | aproximadamente 1 hora 41 minutos | aproximadamente 7 horas 12 minutos | aproximadamente 3.65 días |
| 99.9% | aproximadamente 1 minuto 26 segundos | aproximadamente 10 minutos | aproximadamente 43 minutos 12 segundos | aproximadamente 8 horas 45 minutos 36 segundos |
| 99.99% | aproximadamente 8.6 segundos | aproximadamente 1 minuto | aproximadamente 4 minutos 19 segundos | aproximadamente 52.6 minutos |
| 99.999% | menos de 1 segundo | unos segundos | menos de 30 segundos | aproximadamente 5.3 minutos |
Esa tabla es la que pegaría en un runbook. Hace visible el equilibrio rápidamente. 99.9% no es un presupuesto de interrupciones minúsculo, es una porción medible del mes.
Qué cambia operacionalmente con la conversión
Para operaciones de proxies, la unidad que importa rara vez es "año". Es el ciclo de anuncios, la sesión de farming o el lote de scraping. Un proveedor puede verse excelente en papel y aún fallarte durante la ventana exacta que importa. Si no traduces el tiempo de actividad en un presupuesto por ventana, terminas confiando en un porcentaje en lugar de planificar para interrupciones.
Si no puedes decirme qué significan 43 minutos para tu hora más ocupada, realmente no entiendes el 99.9%.
Mantén las matemáticas en tus propias notas y verifica cualquier calculadora de proveedor contra ellas. Luego ancla el número contra tu cadencia de ejecución real. Esa es la única forma de saber si una promesa es utilizable o solo cosméticamente alta.
Para una lista de verificación más profunda sobre medición del comportamiento del servicio, la nota interna sobre pruebas de confiabilidad es mejor compañera que cualquier página de ventas.
Comparando los Niveles 99%, 99.9%, 99.99% y 99.999%
El salto entre niveles de uptime no es lineal. Cada nueve adicional reduce el tiempo de inactividad permitido aproximadamente por un factor de diez, y la diferencia en la práctica es mayor de lo que la mayoría de los compradores esperan. La referencia de niveles de IBM hace que ese contraste sea fácil de ver, con 99.0% en aproximadamente 3.65 días por año, 99.9% en aproximadamente 8.8 horas, 99.99% en aproximadamente 52.6 minutos, y 99.999% en aproximadamente 5.3 minutos (referencia de 9s de IBM).
Qué te ofrece realmente cada nivel
99% está bien para dashboards de bajo riesgo, herramientas secundarias y cualquier cosa que pueda permanecer inactiva sin costarte dinero cada minuto. No es lo que deseas para operaciones de tráfico activo.
99.9% es el SLA empresarial estándar y la línea base normal para servicios de proxy. Sota Proxy anuncia ese nivel en su plataforma, y es la clase de promesa adecuada para la mayoría de flujos de scraping, gestión de cuentas y pruebas geográficas que pueden tolerar pausas cortas.
99.99% es un nivel diferente de ingeniería. Normalmente significa que el proveedor ha construido para escenarios de fallo completo del centro de datos, no solo problemas a nivel de nodo. Ese es el nivel que empiezas a considerar cuando una interrupción puede detener el gasto, romper un lanzamiento cronometrado o dejar toda una región fuera de línea.
99.999% es la conversación de grado carrier. Es para sistemas donde cada minuto duele y donde la arquitectura necesita redundancia muy agresiva.
La perspectiva de la carga de trabajo de proxy
Para cuentas publicitarias de Facebook y cuentas publicitarias de TikTok, 99.9% suele ser aceptable si tienes pools de respaldo y manejo limpio de sesiones. Para farming de cuentas dentro de AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc, el nivel es suficientemente bueno si la granja está distribuida y puedes cambiar endpoints sin arruinar fingerprints.
Para scraping y verificación de anuncios, la brecha entre 99.9% y 99.99% importa más cuando el trabajo está limitado en tiempo o es sensible a la región. Un fallo breve puede forzar una repetición, eliminar un lote o dejar una región sin probar. El nivel superior te compra menos interrupciones, pero también suele costar más ingeniería y más dinero porque el proveedor tiene que mantener capacidad redundante.
La decisión no se trata de perseguir el número más grande. Se trata de ajustar el nivel al costo del fallo.
Cómo los SLA Declaran 99.9% y Qué Excluyen Silenciosamente
Un SLA impreso es usualmente un cálculo mensual envuelto en lenguaje legal. El proveedor cuenta el tiempo de inactividad dentro de una ventana definida, y luego elimina lo que quiera excluir. Eso significa que el número destacado puede verse más fuerte que la realidad operativa si no lees la letra pequeña en los términos de servicio, como los términos de Sota Proxy.
Las exclusiones habituales
La mayoría de los contratos trazan una línea entre tiempo de inactividad planificado y no planificado. El mantenimiento programado a menudo no cuenta. Tampoco los eventos de fuerza mayor, fallos upstream o incidentes que el proveedor etiqueta como fuera de su control. Algunos contratos también excluyen incidentes cortos por debajo de un umbral, por lo que una interrupción ruidosa pero breve puede nunca llegar al registro del SLA.
El lenguaje de créditos puede ser igual de limitado. Un SLA de 99.9% puede venir aún con un tope de crédito modesto, lo que significa que incluso un fallo real no produce automáticamente compensación significativa. Si el proveedor define la disponibilidad de manera estricta, también puede ignorar estados degradados que se sienten como tiempo de inactividad desde tu lado, como un servicio que responde lo suficientemente lento como para romper tu flujo de trabajo.
Qué deben buscar los compradores de proxies
Lee las cláusulas que mencionan ventanas de mantenimiento, interrupciones de proveedores upstream, rangos beta, nuevos rangos de IP y elegibilidad de créditos. Esos son los lugares donde la promesa se reduce. Los contratos de proxies residenciales, móviles, ISP y de centro de datos pueden ocultar redacciones similares, incluso si la página de inicio se ve limpia.
Si el SLA nunca dice cómo se cuentan las interrupciones, asume que el proveedor quiere la versión más indulgente.
Ese es el truco central. La página de marketing habla de uptime, pero el contrato define lo que el proveedor está dispuesto a pagar si falla. Si estás comprando proxies para tráfico pago, quieres la definición operativa, no el porcentaje más bonito. La brecha entre esos dos es donde vive la mayoría de las decepciones.
Qué Significa 99.9% para Cargas de Trabajo de Proxy en la Práctica
Para operadores de proxy, el número importa menos que el presupuesto de interrupciones detrás de él. 99.9% se ve sólido en una página de ventas, pero bajo carga en vivo aún puede desaparecer en el momento equivocado. Un salto de proxy fallido durante un ciclo de anuncios, una sesión de farming o una ejecución de scraping puede significar un inicio de sesión perdido, una sesión rota o un trabajo parcial que tiene que rehacerse. La pregunta es cuánto trabajo puedes perder antes de que la afirmación de uptime del proveedor deje de ser útil.
Anuncios, farming, cloaking y pruebas geográficas
Cuentas publicitarias de Facebook y cuentas publicitarias de TikTok muestran el modo de fallo rápidamente. Si una campaña está avanzando intensamente durante una ventana pico y la capa de proxy cae, la continuidad se rompe inmediatamente. Los proxies residenciales o móviles usualmente manejan esa presión mejor que una configuración de centro de datos pura porque el patrón de sesión se ajusta más naturalmente al comportamiento de la plataforma, pero el presupuesto de uptime aún importa si tu flujo de trabajo depende de sesiones sticky.
Farming de cuentas dentro de AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc necesita endpoints estables, no lenguaje vago de uptime. Si un perfil pierde su ruta mientras estás iniciando sesión, calentando o repitiendo una rutina, toda la sesión puede desperdiciarse y es posible que tengas que empezar de nuevo. Los pools redundantes y las verificaciones de salud hacen más aquí que un titular de SLA pulido.
Cloaking y campañas geo-dirigidas añaden otro punto de fallo. Una interrupción regional puede hacer que la página objetivo o el verificador sean inconsistentes, y entonces terminas depurando la capa equivocada. Mantén un pool de respaldo por región y prueba la ruta antes de enviar tráfico.
Regla del operador: cuanto más corta la ventana de campaña, menos indulgente se vuelve el 99.9%.
Cargas de scraping y verificación
Para web scraping y monitoreo SEO, 99.9% suele ser suficiente si la cola puede pausarse y reanudarse limpiamente. Las IPs residenciales rotativas absorben pérdidas breves mejor que una configuración de sesión única, pero una parada completa aún fuerza reintentos y puede alterar la planificación de velocidad. La verificación de anuncios sigue el mismo patrón, porque la región y el tiempo importan más que el rendimiento bruto.
Si la ejecución es desechable, 99.9% suele estar bien. Si la ejecución tiene que terminar antes de un evento de mercado, un lanzamiento de producto o un cambio de campaña, el mismo nivel se vuelve doloroso rápidamente.
El tipo de proxy también importa. Los proxies residenciales se ven como acceso de consumidor y usualmente se adaptan mejor a flujos sensibles. Los proxies móviles a menudo se comportan aún más cerca del tráfico de dispositivos móviles y pueden ayudar donde la suspicacia de la plataforma es alta. Los proxies de datacenter ofrecen velocidad y enrutamiento limpio, pero destacan más en entornos estrictos. Los proxies IPv6 pueden ayudar con escala y grandes pools, pero no reemplazan la calidad de sesión o el tiempo de actividad disciplinado.
Para métricas de monitoreo y flujos de trabajo de incidentes, úsalo como modelo para alertas y seguimiento. El punto no es recolectar dashboards para decoración. El punto es detectar una falla antes de que tu campaña o ejecución de scraping lo haga por ti.
El punto no es que un tipo gane en todas partes. El uptime y el tipo de proxy resuelven problemas diferentes, y ambos tienen que alinearse antes de que confíes a un proveedor tráfico pagado.
Verificando la Afirmación de Uptime de un Proveedor Antes de Comprar
Un proveedor puede decir 99.9% y aún ocultar una configuración operativa descuidada. Yo verificaría la afirmación de la misma manera que probaría cualquier ruta de tráfico, revisando evidencia externa, comportamiento sintético, y el proceso de soporte alrededor de incidentes. Un buen proveedor no solo habla de uptime, lo hace visible mediante monitoreo.
Qué revisar primero
Busca una página de estado pública, luego compárala contra rastreadores de uptime de terceros como UptimeRobot y StatusCake. Si un proveedor no expone un historial de estado, trata la afirmación como marketing hasta que se demuestre lo contrario. Luego pide historial de incidentes, no solo una promesa de soporte.
Las pruebas sintéticas también importan. Ejecuta sondeos HTTP desde múltiples regiones contra el tipo exacto de proxy que te importa, ya sean residenciales, móviles, ISP o datacenter. Si un pool se ve bien desde una región y se desmorona desde otra, has aprendido algo útil antes de comprometer gasto.
Para un marco práctico sobre métricas de monitoreo y flujos de trabajo de incidentes, úsalo como plantilla para cómo quieres que funcionen las alertas y el seguimiento. El punto no es recolectar dashboards para decoración. El punto es detectar una falla antes de que tu campaña o ejecución de scraping lo haga por ti.
Lista de verificación del comprador
- Confirma la ventana de reporte. Los SLA mensuales y anuales se comportan diferente, y las matemáticas de penalización cambian con la ventana.
- Pide ejemplos de crédito. Si el proveedor no puede mostrar cómo una falla se convierte en un crédito, el SLA es demasiado abstracto.
- Solicita la geo exacta y tipo de proxy. Una prueba en la ruta de red incorrecta no te dice mucho.
- Verifica el monitoreo en tiempo real. Quieres que el dashboard muestre uso y salud, no solo un balance.
- Prueba los horarios de soporte. Una respuesta humana real 24/7 importa más que un FAQ pulido cuando un pool falla en medio de una ejecución.
Algunas señales de proveedor valen peso extra. Soporte humano 24/7, pagos encriptados en cripto, y facturación transparente de pago por uso usualmente indican que el operador espera uso serio y quiere menos sorpresas de facturación o confianza. Si el proveedor también expone un verificador de proxy, úsalo antes de confiar en un pool. El propio verificador de proxy de Sota Proxy es el tipo de utilidad que deberías esperar que exista antes de gastar tráfico real en una nueva configuración.
Eligiendo el Nivel de Uptime Correcto y Poniéndolo a Trabajar
El nivel correcto depende de cuánto te cuesta una falla. Si una pausa breve solo retrasa una tarea no crítica, 99.9% es usualmente el estándar pragmático. Si una interrupción puede interrumpir gasto, romper un lanzamiento, o dejar fuera de línea una región monitoreada, pagar por 99.99% empieza a tener sentido porque el proveedor tiene que llevar más redundancia, capacidad de failover reservada, y automatización más robusta.
Un filtro de decisión simple
- Usa 99.9% cuando el flujo de trabajo pueda pausar, reintentar, o hacer failover sin daño financiero mayor.
- Considera 99.99% cuando la carga de trabajo esté limitada por tiempo, sea sensible a región, o esté atada a ventanas activas de ingresos.
- Pide prueba cuando el SLA del proveedor suene limpio pero los detalles operacionales falten.
Para la mayoría de configuraciones de farming de cuentas y scraping, 99.9% es suficiente si el monitoreo es sólido y el diseño del pool es sensato. Eso significa sesiones persistentes donde se necesiten, pools redundantes donde sea posible, y el hábito de probar el tipo exacto de proxy antes de un push en vivo. Si el proveedor no puede sobrevivir tus verificaciones básicas, el porcentaje de uptime no importa mucho.
Sota Proxy encaja en el lado práctico de este tema porque está construido alrededor de 99.9% de uptime, pools de IP limpias, clusters redundantes, más de 220 geolocalizaciones, y soporte humano 24/7/365. Esa combinación cubre los tipos de operaciones intensivas en proxies discutidas aquí, desde campañas geo-dirigidas hasta scraping y gestión de cuentas. Si ya confías en la plataforma, el programa de referidos y afiliados de Sota Proxy con hasta 40% de comisión también puede compensar parte de tu estructura de costos sin cambiar tu lógica de tráfico.
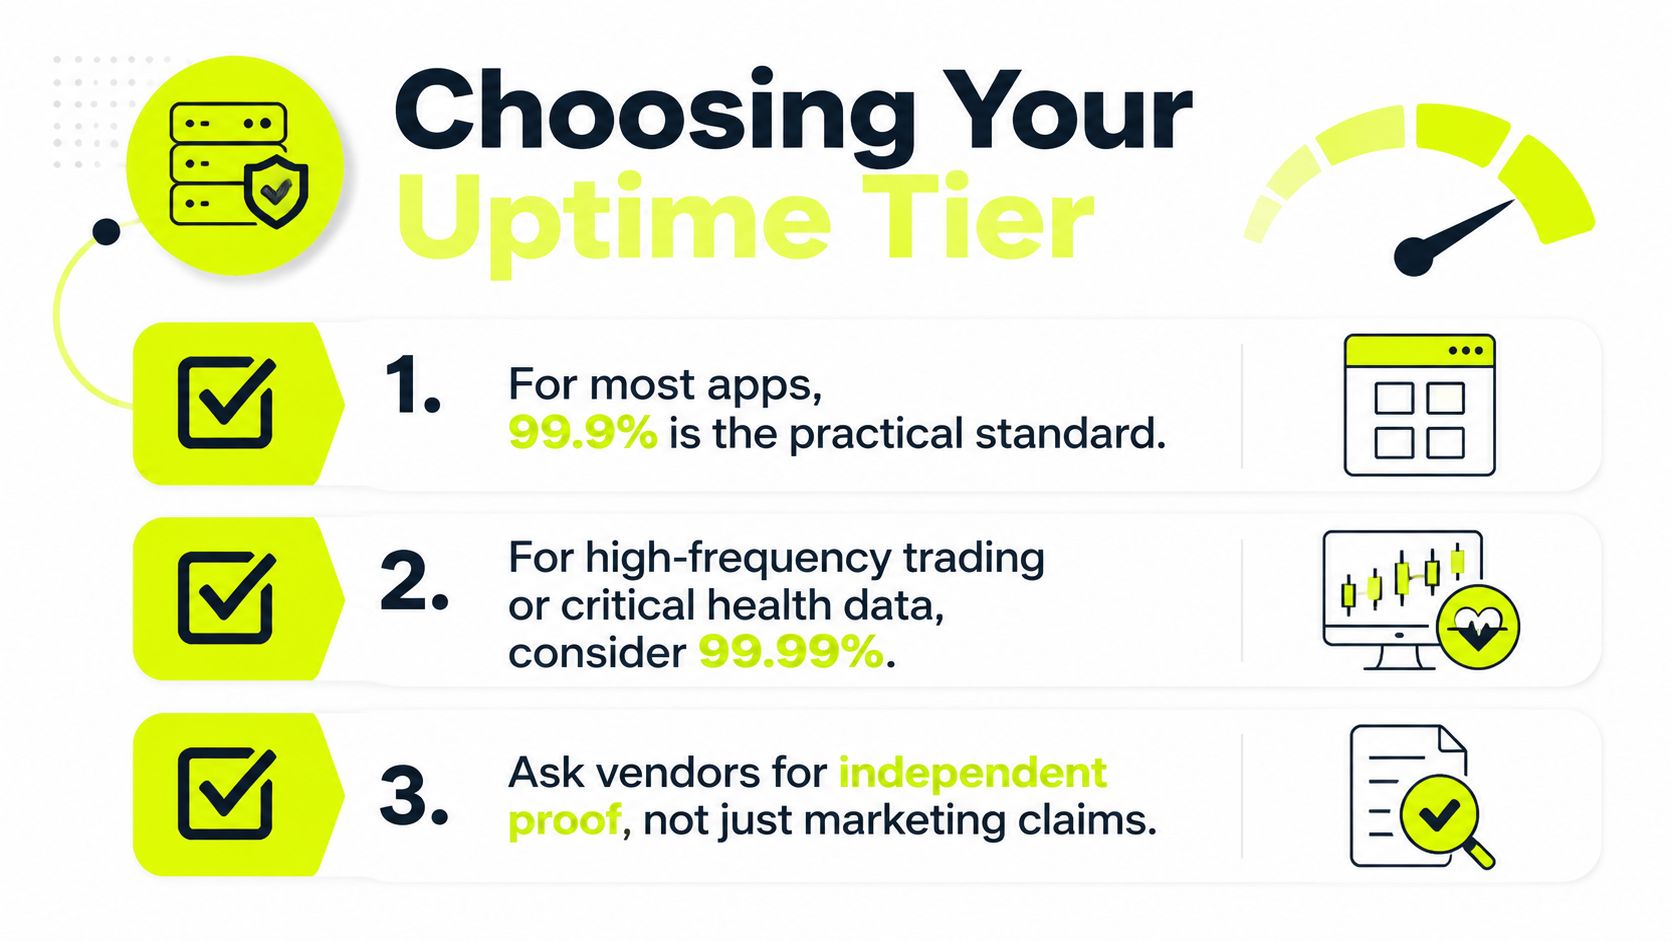
Ejecuta esta lista de verificación antes de comprar: ¿el SLA muestra la ventana de reporte?, ¿el proveedor publica comportamiento de incidentes?, y ¿puedes probar la geo exacta que necesitas bajo condiciones de tráfico real? Si las respuestas son claras, el nivel es probablemente usable. Si no lo son, el porcentaje en la página de inicio no está haciendo mucho por ti.
Si quieres infraestructura de proxy construida para tráfico pagado, gestión de cuentas, scraping, y pruebas específicas de región, visita Sota Proxy y compara el tipo de proxy, ubicación, y modelo de soporte contra la carga de trabajo que ejecutas. Si el ajuste es correcto, puedes usar la misma plataforma para operaciones de proxy y economía de referidos sin cambiar tu flujo de trabajo.
Artículos relacionados
Para Qué Se Usa un Proxy: Guía de Arbitraje 2026
Para qué se usa un proxy - Descubre para qué se utiliza un proxy en 2026, desde mejorar la seguridad hasta gestionar operaciones multiaccount para equipos de arbitraje
Cómo Crear un Scraper de Reseñas de Amazon que Realmente Funcione
Crea un scraper confiable de reseñas de Amazon con tácticas probadas de proxy, anti-bloqueo y análisis. Guía paso a paso para operadores técnicos y agencias.
CSV vs JSON: Una Guía Práctica para Scrapers y Ad Ops
Comparación de CSV vs JSON para equipos técnicos: estructura, velocidad de análisis, datos anidados y elección real para scraping, verificación de anuncios y pipelines de automatización.
Llamada API con Python para Automatización de Anuncios
Domina la llamada API con Python para automatización de anuncios. Aprende patrones asíncronos, rotación de proxies, reintentos y fingerprinting para flujos de trabajo multi-cuenta.
Lista de bloqueados en Instagram: Cómo detectar y solucionar bloqueos
Descubre cómo funciona realmente la lista de bloqueados en Instagram, cómo detectar bloqueos y shadowbans, y los pasos exactos para gestionar tu lista de cuentas bloqueadas.
Política de Uso Justo Explicada para Usuarios de Proxies
Descubre qué significa realmente una política de uso justo para usuarios de proxies. Cubre límites, limitación de velocidad y consejos prácticos de cumplimiento para clientes de SotaProxy.