CSV vs JSON: Una Guía Práctica para Scrapers y Ad Ops
Comparación de CSV vs JSON para equipos técnicos: estructura, velocidad de análisis, datos anidados y elección real para scraping, verificación de anuncios y pipelines de automatización.
Muchos equipos hacen la pregunta equivocada. CSV vs JSON rara vez es una decisión clara por sí sola, porque el formato solo funciona cuando coincide con el trabajo que tienes delante. Si ejecutas pipelines de scraping, trabajos de verificación de anuncios o exportaciones de farming de cuentas, el árbol de decisión clave es tablas planas versus payloads anidados, streaming versus cargas de archivos completos, e inspección humana versus ingesta automatizada.
Por eso el consejo binario se desmorona. CSV sigue dominando las exportaciones tabulares planas porque RFC 4180 estandarizó el modelo de registro común, con cada línea llevando el mismo número de campos, mientras que los objetos JSON pueden variar por registro y llevar estructura anidada. JSON gana cuando el payload tiene jerarquía o campos cambiantes. En el medio, JSONL a menudo supera a ambos para logs y feeds de solo-agregar, y Parquet gana cuando la eficiencia analítica y de almacenamiento importa más que revisar texto sin procesar.
| Formato | Mejor uso | Fortaleza | Punto débil |
|---|---|---|---|
| CSV | Exportaciones planas, hojas de cálculo, importaciones SQL | Compacto, fácil de transmitir, simple para comparar | Débil para anidamiento y tipado mixto |
| JSON | APIs, objetos anidados, archivos de configuración | Autodescriptivo, estructura flexible | Verboso en transmisión, más lento de analizar |
| JSONL | Logs, respuestas de streaming, feeds de solo-agregar | Procesamiento línea por línea, sin carga de archivo completo | Sigue siendo texto, sigue siendo verboso para datos amplios |
| Parquet | Warehouses, data lakes, archivos grandes | Fuerte compresión y eficiencia de consultas | No amigable para humanos en un editor de texto |
Tabla de Contenidos
- Deja de Preguntar CSV vs JSON y Empieza a Preguntar Qué Necesitas Realmente
- Estructura, Esquema y Tipado Lado a Lado
- Tamaño, Velocidad de Análisis y Huella de Memoria
- Bibliotecas de Análisis y Fragmentos de Código de Conversión
- Elegir un Formato por Caso de Uso en Scrape y Ad Ops
- Escapes, Codificación y Trampas de Seguridad
- Cuándo JSONL o Parquet Superan a Ambos
- Recomendaciones por Pipeline y Elección de Proxy
Deja de Preguntar CSV vs JSON y Empieza a Preguntar Qué Necesitas Realmente
El debate se complica porque la gente compara CSV y JSON como si resolvieran el mismo problema. No lo hacen. CSV es un formato de registro plano. JSON es un formato de documento con espacio para objetos anidados, arrays y campos opcionales. Si fuerzas uno a hacer el trabajo del otro, terminas escribiendo código de conversión, vigilando casos extremos y explicando exportaciones malformadas a las 2 a.m.
Empieza con la forma, no con la preferencia
Si tu fuente es una fila por cuenta, fila por palabra clave, o fila por evento de proxy, CSV usualmente encaja. Si cada registro lleva creatividades anidadas, metadata variable, o un grafo de objetos cambiante, JSON es el formato de transmisión más limpio. Si la fuente es un stream de eventos, JSONL puede evitar que cargues un archivo completo solo para leer la línea 17. Si el archivo es para analítica, Parquet es a menudo la mejor opción de almacenamiento a largo plazo, porque los archivos columnares soportan consultas downstream más eficientes que el texto orientado a filas.
Regla práctica: elige el formato según cómo se mueven los datos a través del pipeline, no por lo que es más fácil exportar desde el sistema fuente.
Esto importa en ad ops y scraping porque el mismo equipo a menudo necesita los cuatro formatos en diferentes lugares. Un trabajo de automatización de navegador en AdsPower o Multilogin puede emitir logs estructurados. Una exportación de verificación de anuncios de Facebook o TikTok puede aplanarse limpiamente en filas. Una verificación de cloaking puede producir metadata de solicitud anidada. Un trabajo de warehouse puede necesitar un almacén analítico comprimido, no un archivo de texto que alguien abre en Excel.
El verdadero árbol de decisión
Usa CSV cuando los humanos necesiten una tabla, cuando las importaciones de base de datos sean simples, y cuando quieras exportaciones compactas. Usa JSON cuando el payload sea anidado o variable. Usa JSONL cuando necesites procesamiento de solo-agregar, línea por línea. Usa Parquet cuando la salida esté destinada a analítica, data lakes, o consultas repetidas de escaneo intensivo. Este árbol de decisión es más útil que discutir sobre cuál de los dos formatos de texto es "mejor". También se alinea con la forma en que la orientación moderna de ingeniería de datos divide exportaciones simples, intercambio de streaming y almacenamiento analítico en diferentes categorías, no en un concurso genérico de formato de archivo.
Estructura, Esquema y Tipado Lado a Lado
CSV y JSON difieren primero a nivel de forma, luego a nivel de esquema, luego a nivel de tipado. Esa es la parte que muchos minimizan hasta que un analizador se rompe. CSV te da filas y columnas. JSON te da objetos y arrays. Uno está construido para registros tabulares. El otro está construido para documentos.
campaign_id,geo,spend,is_active
1001,US,12.50,true
1002,DE,8.00,false
[
  {"campaign_id": 1001, "geo": "US", "spend": 12.50, "is_active": true},
  {"campaign_id": 1002, "geo": "DE", "spend": 8.00, "is_active": false}
]
La versión CSV es fácil de escanear, fácil de importar y fácil de unir en SQL. La versión JSON es autodescriptiva, y eso importa cuando tus registros no todos se ven idénticos. En un pipeline de scraping, una tarjeta de producto puede tener historial de precios anidado, mientras que una tarjeta de listado puede no tenerlo. JSON maneja eso sin inventar columnas vacías solo para mantener una matriz feliz. CSV funciona mejor cuando cada fila debe compartir los mismos campos.
| Criterio | CSV | JSON |
|---|---|---|
| Modelo de datos | Filas y columnas | Objetos y documentos |
| Esquema | Implícito, generalmente externo | Incrustado en la estructura |
| Tipos | Débil, generalmente cadenas de texto en disco | Soporte nativo para números, booleanos, arrays, objetos |
| Datos anidados | Incómodo | Natural |
| Legibilidad humana | Alta para tablas simples | Alta para objetos pequeños, baja para arrays grandes |
| Ajuste a hojas de cálculo | Excelente | Pobre |
| Ajuste a APIs | Pobre | Excelente |
CSV se adapta bien a flujos de trabajo de hojas de cálculo y SQL porque el archivo ya parece una tabla. JSON se adapta a APIs REST y cargas útiles de tipo NoSQL porque los registros pueden variar y anidarse. Ese desajuste estructural impulsa todo lo demás en el artículo. Si tu consumidor final es un operador de hojas de cálculo o un cargador SQL, CSV generalmente no estorba. Si tu consumidor final es un cliente de API o un servicio de aplicación, JSON generalmente reduce la fricción.
Para automatización impulsada por proxies, esa distinción aparece de inmediato. Las exportaciones de cuentas publicitarias a menudo comienzan como tablas planas. Los registros de automatización del navegador desde herramientas como AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc a menudo incluyen metadatos anidados que CSV no puede representar sin decisiones de aplanamiento de las que te arrepentirás después. Un formato que se ajuste a la forma de los datos ahorra trabajo de limpieza posterior, y esa es la parte que los equipos sienten en producción.
Para un flujo de trabajo de automatización más amplio en torno a la gestión de cuentas, esta guía de automatización con proxies ocupa el mismo espacio práctico que la elección del formato, porque el manejo de formatos y el manejo de tráfico generalmente fallan juntos.
Tamaño, Velocidad de Análisis y Huella de Memoria
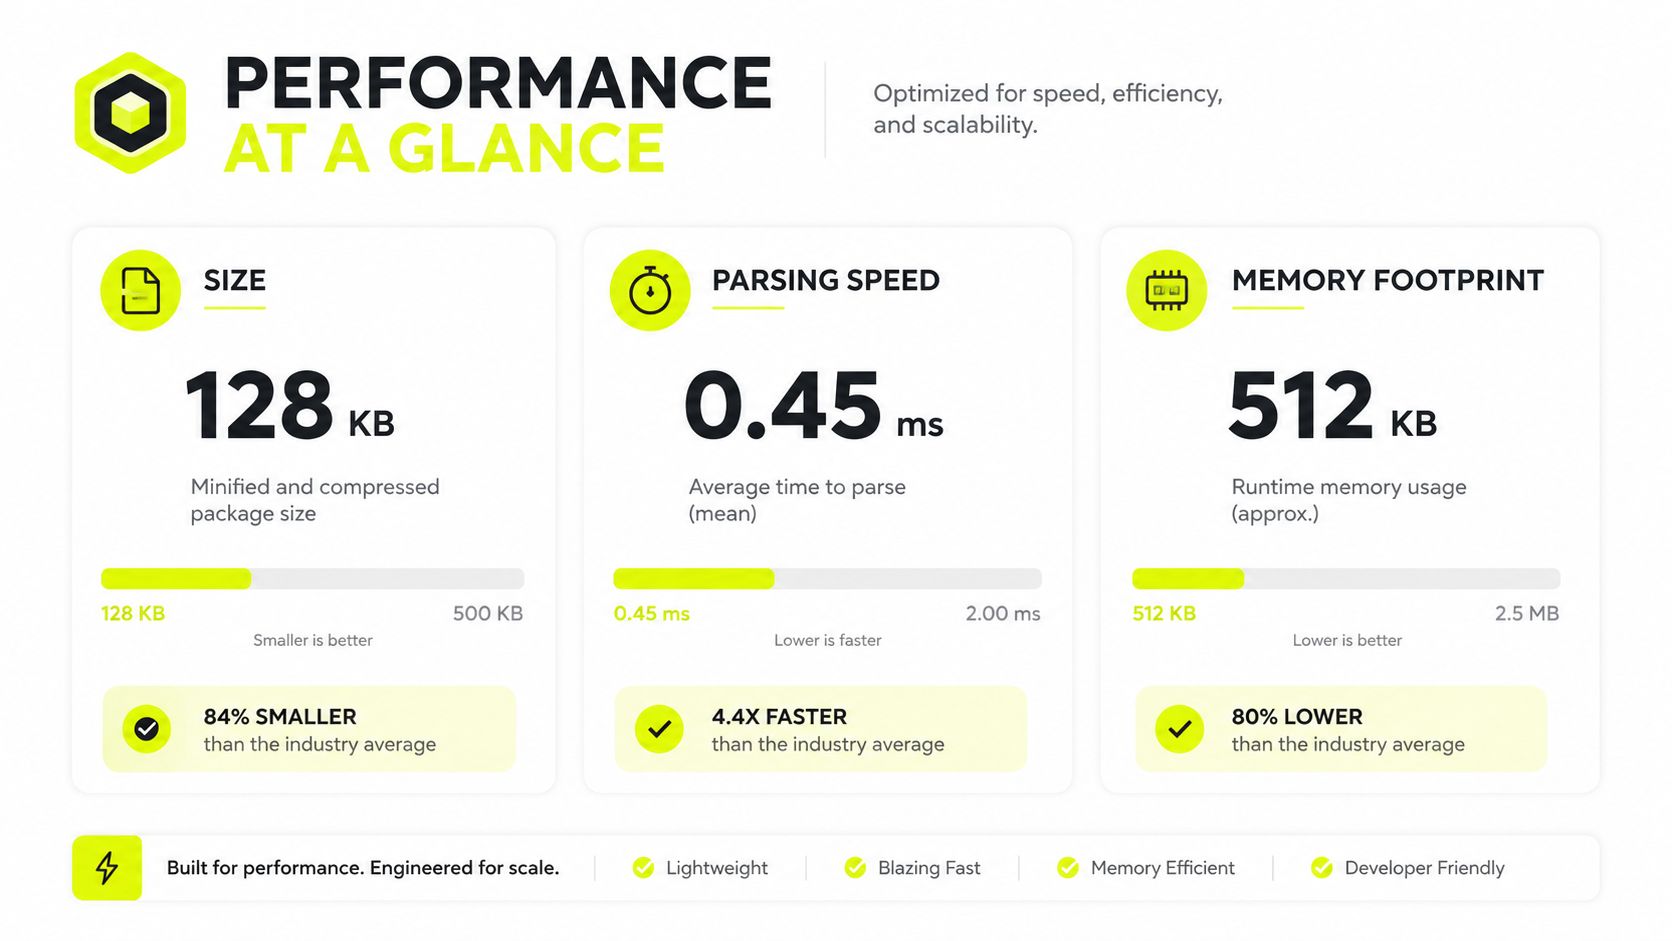
En feeds planos, CSV generalmente gana porque se mantiene más pequeño y es más barato de analizar. Una comparación publicada sobre un conjunto de datos de 1 millón de filas por 10 columnas reportó CSV en 85 MB y 2.3 segundos de tiempo de análisis con 120 MB de memoria, versus JSON en 210 MB, 5.8 segundos y 340 MB de memoria. El mismo benchmark también mostró que CSV analiza más rápido en JavaScript, Python y Java en un conjunto de datos de 100,000 filas, manteniéndose la diferencia en cada lenguaje. Esa brecha aparece rápidamente en workers de scraping, procesadores de logs de proxy y trabajos de feeds de campañas que se ejecutan todo el día.

Por qué CSV generalmente gana en feeds planos
CSV se mantiene ligero porque no repite nombres de campos en cada fila. JSON repite claves y agrega llaves, corchetes y comillas para cada registro. Las comparaciones independientes a menudo sitúan los archivos JSON del mundo real en un tamaño 1.5 a 3 veces mayor que archivos CSV equivalentes para datos planos comparables, y un ejemplo comúnmente citado sitúa un conjunto de datos de 10,000 filas en aproximadamente 1 MB como CSV versus 2.5 MB como JSON. Esa diferencia es sobrecarga de carga útil, no magia en el parser.
Esa sobrecarga importa para feeds de campañas geotargetizadas y exportaciones masivas de cultivo de cuentas. Cada byte extra todavía tiene que moverse a través de capas de almacenamiento, red y análisis. Si estás alimentando una cola, un ejecutor de trabajos o un cargador de almacén de datos, CSV generalmente te da menos fricción. Si estás enviando objetos anidados a través de una API, JSON se gana su lugar en legibilidad y estructura.
Regla práctica: para tablas planas, usa CSV por defecto a menos que el anidamiento o la interoperabilidad descendente te dé una razón para no hacerlo.
La compresión cambia las matemáticas
La compresión reduce la brecha porque las claves JSON repetidas se comprimen bien. Una comparación sitúa la diferencia post-compresión en aproximadamente 10% a 20%. Eso no borra la ventaja de CSV, pero sí cambia la economía para archivos archivados y almacenamiento a largo plazo. Una vez que el archivo está detrás de la compresión tipo gzip, la penalización en bruto en el cable se reduce lo suficiente como para que la claridad del esquema pueda importar más que el recuento de bytes.
Para pipelines de ciencia de datos, el mismo patrón aparece también en el uso de tokens. Un conjunto de datos orientado a LLM con aproximadamente 5,000 celdas usó 56.20% menos tokens en CSV que en JSON, mientras también mejoraba la precisión y latencia en esa prueba. Es un benchmark estrecho, pero aún apunta al mismo resultado operacional: las tablas de texto plano son más baratas de consumir cuando los datos son planos.
Para un desglose más amplio de las compensaciones de rendimiento de rastreo, la guía de crawling en Python es un complemento útil para esta decisión de formato, porque el volumen de rastreo y el formato de archivo generalmente golpean los mismos cuellos de botella.
Bibliotecas de Análisis y Fragmentos de Código de Conversión
La biblioteca estándar de Python es suficiente para trabajo básico de producción. Para CSV, csv.DictReader y csv.DictWriter cubren la mayoría de las exportaciones planas. Para JSON, json.load, json.dump, json.loads y json.dumps manejan los casos estándar. En Node, la gente generalmente recurre a Papa Parse o csv-parse del lado CSV. En Java, OpenCSV es el punto de partida usual cuando necesitas manejo tabular directo.
Lectura y escritura mínima en Python
import csv
import json

# Leer CSV
with open("input.csv", newline="", encoding="utf-8") as f:
    rows = list(csv.DictReader(f))

# Escribir CSV
with open("output.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["campaign_id", "geo", "spend"])
    writer.writeheader()
    writer.writerow({"campaign_id": "1001", "geo": "US", "spend": "12.50"})

# Leer JSON
with open("input.json", encoding="utf-8") as f:
    payload = json.load(f)

# Escribir JSON
with open("output.json", "w", encoding="utf-8") as f:
    json.dump(payload, f, ensure_ascii=False, indent=2)
El problema es que una conversión ingenua de csv.DictReader a json.dump convierte todo en cadenas planas a menos que coacciones explícitamente los tipos. También elimina arrays anidados si ya los has aplanado mal anteriormente. Así es como los equipos terminan con booleanos rotos, cadenas de fecha por todas partes y estructura "misteriosamente" faltante después de un paso de conversión.
Conversión limpia de CSV a JSON con campos anidados
import csv
import json

def parse_tags(value):
    return [x.strip() for x in value.split("|") if x.strip()]```html
records = []
with open("input.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        records.append({
            "campaign_id": int(row["campaign_id"]),
            "geo": row["geo"],
            "spend": float(row["spend"]),
            "flags": {
                "active": row["is_active"].lower() == "true",
                "tags": parse_tags(row.get("tags", "")),
            }
        })

with open("output.json", "w", encoding="utf-8") as f:
    json.dump(records, f, ensure_ascii=False, indent=2)
Ese patrón es mejor porque decides los tipos antes de la serialización. También hace que la conversión sea explícita, lo que ayuda cuando las exportaciones de account-farming o los registros de verificación de anuncios necesitan sobrevivir múltiples etapas del pipeline. Para una ruta práctica de integración en Python, esta referencia de configuración encaja con la misma mentalidad de producción.
Elegir un Formato según el Caso de Uso en Scraping y Operaciones Publicitarias
La respuesta correcta cambia según la carga de trabajo. Un feed de scraping masivo no es lo mismo que un reporte de verificación de anuncios, y ninguno de esos se comporta como una exportación de navegador antidetección o un flujo de registros de proxy. Elegir un formato para todo normalmente crea conversiones innecesarias más adelante.
Feeds de web scraping masivo
Usa CSV cuando el scraping produzca filas con un conjunto de columnas estable. Los feeds de productos, instantáneas de precios, exportaciones de SERP y listas de leads generalmente se ajustan a este patrón. CSV es más fácil de escanear, más fácil de comparar, y menos doloroso de cargar en una base de datos u hoja de cálculo.
Si el scraper emite páginas de payloads mixtos o eventos en streaming, usa JSONL en lugar de un único array JSON. Eso te da análisis línea por línea, que es más adecuado para rastreos de larga duración. El enlace interno sobre casos de uso de web scraping es relevante aquí porque el formato de archivo y la estrategia de proxy usualmente se ajustan juntos.
Reportes de verificación de anuncios en Facebook y TikTok
Usa JSON cuando el reporte incluya metadatos de creativos anidados, datos de ubicación u objetos de campaña variables. Las instantáneas planas de gasto pueden seguir terminando en CSV, especialmente cuando los compradores de medios necesitan filtros rápidos en Excel o Google Sheets. Lo importante es no aplanar datos de creativos anidados solo para satisfacer un hábito de hoja de cálculo.
Exportaciones de account farming para navegadores antidetección
Para AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc, CSV normalmente funciona mejor para exportaciones masivas de perfiles, seguimiento de estado de perfiles y hojas de transferencia. El archivo tiende a estar orientado a filas, y los operadores a menudo quieren ordenar, filtrar y reimportarlo sin herramientas adicionales. Mantén la codificación estricta y la lista de columnas estable. El account farming se rompe rápido cuando un cambio de formato "pequeño" se propaga a través de una hoja compartida.
Ingestión de registros de proxy
Para registros de proxy de alto volumen, JSONL o Parquet normalmente tiene más sentido que JSON plano o CSV. JSONL soporta ingestión de registros de solo agregación. Parquet es más potente cuando el archivo de registros se convierte en un problema de consulta de almacén de datos. Si estás ejecutando proxies residenciales o móviles para trabajos sensibles a la confianza, o datacenter e IPv6 para rendimiento puro, el formato de archivo debe coincidir con el mismo objetivo operativo. Para el lado arquitectónico de esa decisión, esta guía de ETL versus ELT es una buena lectura complementaria.
Trampas de Escape, Codificación y Seguridad
CSV se rompe de formas feas cuando los campos de texto contienen comas, saltos de línea o caracteres de comillas. JSON se rompe cuando las suposiciones de codificación difieren y el parser recibe texto hostil o malformado. Ambos formatos pueden explotar en producción si los tratas como "solo texto" y omites la validación.
Trampas de CSV que siguen apareciendo
Una coma incrustada dentro del nombre de una campaña puede desplazar columnas. Un salto de línea en un campo de notas puede dividir una fila en dos. Convenciones mixtas de comillas pueden hacer que un archivo sea ilegible por un parser y "esté bien" en otro.
- Comas y comillas incrustadas: usa un escritor CSV real, no concatenación de cadenas.
- Saltos de línea dentro de campos: siempre abre archivos con manejo explícito de saltos de línea y entrecomilla los campos correctamente.
- Inyección CSV: prefija fórmulas de hoja de cálculo riesgosas con una estrategia de escape segura antes de que alguien abra el archivo en Excel.
Trampas de JSON que importan en automatización
JSON es más estricto sobre la estructura, pero no es inmune a fallos de producción. Las suposiciones de UTF-8 aún pueden romperse cuando los sistemas upstream emiten bytes incorrectos. Los payloads grandes también pueden desencadenar presión de memoria si los cargas completos en lugar de transmitirlos en streaming.
Analiza datos hostiles como si estuvieran construidos para romper tu parser, porque eventualmente alguien te entregará exactamente ese archivo.
La trampa del streaming importa aquí. Un archivo que parece de tamaño manejable todavía puede matar un worker si lo fuerzas completamente en memoria. Así es como un scrape se convierte en un crash de OOM. Usa parsers de streaming, fragmentación o un formato orientado a líneas cuando la fuente pueda crecer sin aviso.
Para una referencia adyacente útil sobre manejo de streams, elegir entre Yellowstone gRPC y streams parseados de Solana muestra el mismo instinto de ingeniería, es decir, elegir la estrategia de transporte y análisis juntas en lugar de por separado.
```Cuándo JSONL o Parquet Superan a Ambos
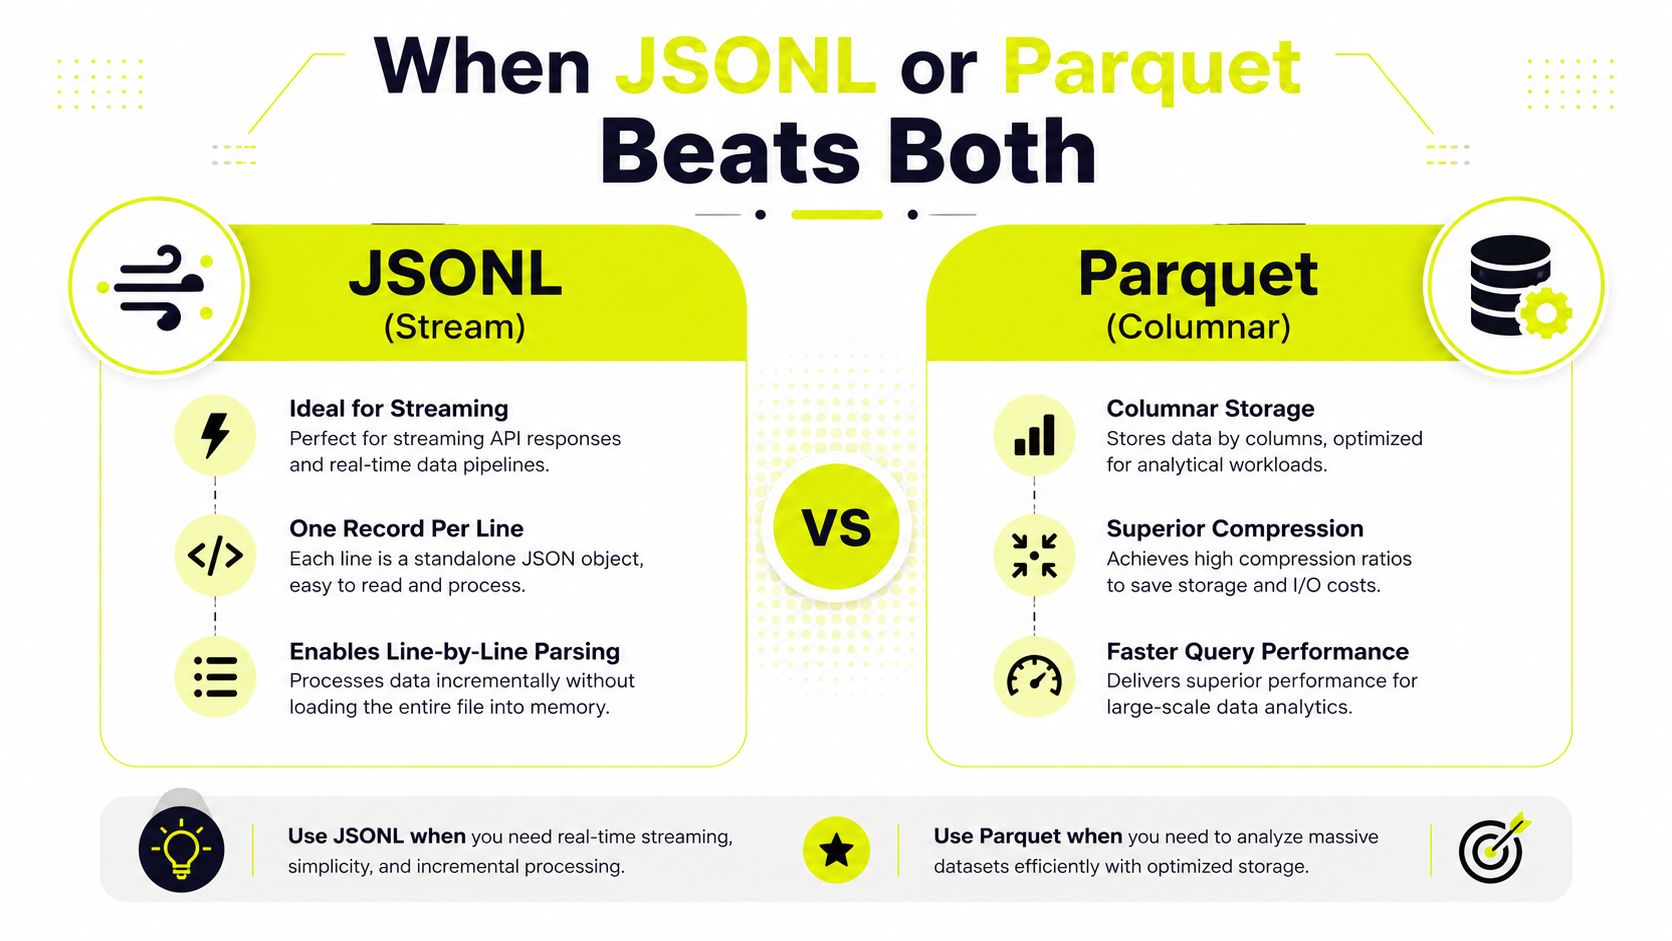
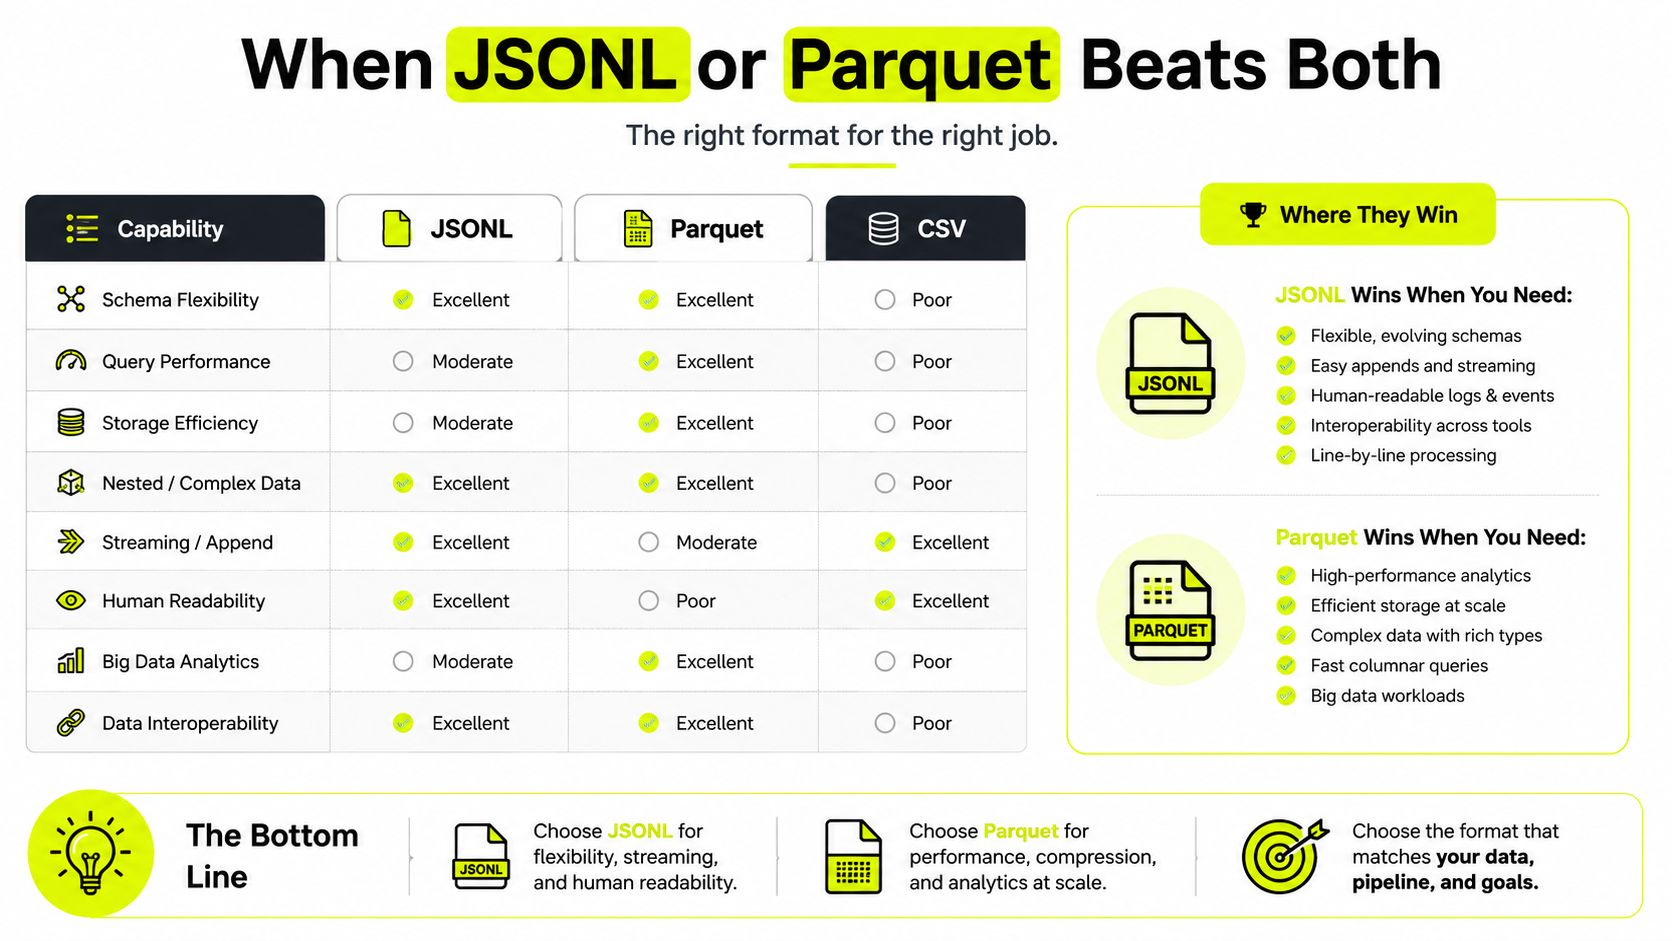
CSV y JSON se usan en exceso porque son familiares, no porque siempre sean correctos. Una vez que los datos se convierten en un flujo o una carga de trabajo de almacén, la mejor respuesta a menudo no es ninguno de los dos. JSONL resuelve el problema de "necesito agregar y leer un registro a la vez". Parquet resuelve el problema de "necesito almacenamiento compacto y escaneos analíticos rápidos".
JSONL para flujos y registros
JSONL almacena un objeto JSON por línea. Esto lo hace ideal para pipelines de logs, respuestas de API en streaming y feeds de solo agregado. No necesitas cargar el archivo completo antes de que comience el procesamiento, y puedes recuperar el progreso parcial después de un fallo sin reproducir un array gigante.
Parquet para análisis
Parquet es un formato columnar. Por eso se adapta mejor a almacenes de análisis, lagos de datos y grandes archivos de scraping que los archivos de texto orientados a filas. El almacenamiento columnar te proporciona mejor compresión y comportamiento de consulta cuando sigues escaneando los mismos campos en grandes conjuntos de datos. La orientación reciente en ingeniería de datos trata a Parquet como el formato de almacenamiento al que recurrir cuando la eficiencia y la escala importan más que la legibilidad humana.
La regla es simple. Exportación de hoja de cálculo o SQL, elige CSV. API REST o configuración anidada, elige JSON. Logs en streaming o feeds de solo agregado, elige JSONL. Almacén de análisis, elige Parquet. Ese mapeo es más útil que pretender que CSV y JSON cubren cada carga de trabajo seria.
Recomendaciones por Pipeline y Elección de Proxy
Los pipelines de scraping deberían comenzar con el formato que coincida con el modo de fallo que ves en producción. Para feeds planos, CSV sigue siendo la opción más fácil porque los operadores pueden abrirlo, filtrarlo y pasarlo sin código de análisis extra. Una vez que el feed se convierte en un flujo, o los registros llegan uno por uno y necesitan ingesta segura ante reinicios, JSONL es el ajuste más limpio. Si la salida se dirige al almacenamiento de almacén en lugar de un informe rápido, Parquet normalmente vale la pena considerarlo antes de comprometerte con un archivo de texto.
Para informes de verificación de anuncios en Facebook y TikTok, usa JSON para creativos anidados, colocación y detalles de auditoría, y mantén CSV para instantáneas planas de gasto o estado. Esa división preserva la estructura donde importa y evita forzar a cada consumidor downstream a recorrer un árbol de documento solo para leer unos pocos campos. También mantiene a los compradores de medios en hojas de cálculo para las partes que revisan cada día.
Para exportaciones de account farming en AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc, CSV con codificación UTF-8 estricta es el predeterminado práctico. Estos trabajos están basados en filas, y las personas que los manejan generalmente quieren algo que puedan ordenar, importar y pasar sin herramientas personalizadas. Si la exportación va de vuelta a la automatización, mantén el esquema estrecho, estable y aburrido. Si también necesitas alinear la capa de transporte, configura la capa de proxy primero, luego mapea el formato de archivo alrededor de ella.
Para logs de proxy, JSONL funciona mejor cuando los logs son de agregado intensivo y necesitan análisis línea por línea. Parquet gana una vez que el archivo se convierte en un problema de análisis y la velocidad de escaneo importa más que la legibilidad humana. Los proxies residenciales o móviles se adaptan a flujos de trabajo que dependen de señales de confianza, especialmente en trabajos de cloaking o intensivos en cuentas. Los proxies de datacenter e IPv6 tienen más sentido cuando el rendimiento y la rotación importan más que parecer una red de consumidores.
Si estás construyendo un flujo de trabajo de socios alrededor de infraestructura de proxy, elige tu arquitectura de pipeline de datos antes de decidir cómo se mueven los archivos a través de ella. Los mismos equipos que ejecutan scraping, verificación de anuncios y flujos de trabajo de múltiples cuentas a menudo necesitan un suministro constante de proxies, y un mal emparejamiento entre formato y transporte se convierte rápidamente en reintentos desordenados. Mantén la capa de proxy y la capa de datos alineadas, ya sea que estés usando opciones residenciales, móviles, de datacenter, ISP o IPv6.
Artículos relacionados

7 Métodos de Recopilación de Datos para Media Buyers y Farmers
Descubre los mejores métodos de recopilación de datos para media buyers. Aprende a aprovechar scraping, APIs y encuestas para cuentas publicitarias, account farming y geo-targeting.

7 Opciones Económicas de Proxies para 2026
Explora opciones económicas de proxies. Una guía técnica sobre planes asequibles de datacenter, residenciales e IPv6 para arbitraje de anuncios, scraping y farming de cuentas.
Segmentación por Código Postal para Campañas Publicitarias: Guía Práctica
Segmentación por código postal explicada para compradores de medios y equipos de arbitraje de tráfico. Cubre configuración de proxies, reglas de plataformas publicitarias, riesgos de detección y mejores prácticas.

Soporte al Cliente 24/7: Lo Que los Operadores Realmente Necesitan
Soporte al cliente 24/7 explicado para operadores de proxies y automatización. KPIs, SLAs, preguntas para proveedores y flujos de escalamiento reales que reducen el tiempo de inactividad.
Qué es un Forward Proxy: Guía completa para 2026
Aprende qué es un forward proxy, cómo funciona para el tráfico saliente y por qué los equipos lo usan con navegadores antidetección para Facebook, TikTok y web scraping.

Clave API de Bing Search: Configuración, Pruebas y Escalado en 2026
Obtén una clave API de Bing Search funcional en 2026, prueba solicitudes, protege la clave y escala scraping de alto volumen sin bloqueos. Guía práctica para equipos técnicos.