Soporte al Cliente 24/7: Lo Que los Operadores Realmente Necesitan
Soporte al cliente 24/7 explicado para operadores de proxies y automatización. KPIs, SLAs, preguntas para proveedores y flujos de escalamiento reales que reducen el tiempo de inactividad.

Estás en medio de una campaña cuando la cuenta se bloquea, la página encubierta empieza a agotar el tiempo de espera y tu pool de proxies se convierte en un vertedero de sesiones muertas. A la plataforma de anuncios no le importa que sean las 3 de la madrugada. A tu proveedor de soporte sí le importa, o no. Esa diferencia decide si recuperas la cuenta y mantienes el gasto activo, o pasas la noche mirando dashboards y actualizando ventanas de chat que solo saben decir "hemos recibido tu solicitud."
Para los operadores que trabajan dentro de AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc, el soporte al cliente 24/7 no es una insignia de confianza. Es parte del stack. Si gestionas cuentas de anuncios de Facebook, cuentas de anuncios de TikTok, farming de cuentas, cloaking o campañas geo-segmentadas, ya sabes que la pregunta no es si un proveedor responde eventualmente. Es si un humano puede diagnosticar el fallo lo suficientemente rápido como para que importe.
Tabla de Contenidos
- La Prueba de las 3am que Expone un Soporte Débil
- Lo que Realmente Significa el Soporte al Cliente 24/7
- Tipos de Proxy y Por Qué la Velocidad de Soporte Importa para Cada Uno
- KPIs, Elementos de SLA y Preguntas para Hacer a los Proveedores
- Flujo de Trabajo de Resolución de Problemas y Escalación que Realmente Funciona
- Escenarios Donde el Soporte 24/7 Salvó la Campaña
- Elegir un Proveedor y Obtener Más de la Relación
- Lista de Verificación del Operador Antes del Próximo Incidente a las 3am
La Prueba de las 3am que Expone un Soporte Débil
Una cuenta de TikTok se marca en pleno vuelo. El creativo todavía se ve bien. El CPM está bien. El interruptor de apagado es la bandeja de entrada del soporte.
A las 3am, no necesitas un reconocimiento amigable. Necesitas un humano que pueda decirte si el problema está del lado de la cuenta, del lado del proxy, del lado de la huella digital o es una retención de la plataforma. Si tu proveedor envía una respuesta enlatada y dice que alguien lo revisará durante el horario laboral, acabas de aprender lo que 24/7 realmente significa en su organización. Significa que el widget de chat permanece encendido. No significa que el resolutor esté despierto.
Por eso la mentalidad del operador importa más que el folleto. Lee el manual de estrategia de soporte al cliente fuera de horario con esa perspectiva, luego prueba cada promesa contra el único evento que importa: un fallo en vivo cuando el dinero está en movimiento. Lo mismo aplica a páginas de soporte como la guía de uptime de Sota Proxy, porque las afirmaciones de uptime no ayudan si nadie puede convertir una interrupción en acción lo suficientemente rápido.
Regla práctica: si la primera respuesta solo confirma recepción, aún no tienes soporte 24/7. Tienes una cola con una etiqueta de turno nocturno.
El operador que sobrevive al golpe de las 3am no empieza preguntando: "¿Dan soporte a clientes las 24 horas?" Pregunta: "¿Quién puede arreglar esto cuando la campaña se está quemando?" Esa pregunta cambia lo que compras, cómo te organizas y qué proveedores merecen una recarga el lunes.
Lo que Realmente Significa el Soporte al Cliente 24/7
El soporte 24/7 solo funciona cuando el proveedor tiene un verdadero compromiso de servicio para aceptar, clasificar y responder a cualquier hora. Eso es diferente a tener una burbuja de chat en un sitio web. El modelo útil tiene tres capas: un helpdesk 24/7 para aceptar y ordenar solicitudes, un NOC 24/7 para vigilar la infraestructura, y operaciones de seguridad 24/7 para manejar abuso, reputación de IP y eventos de amenazas.
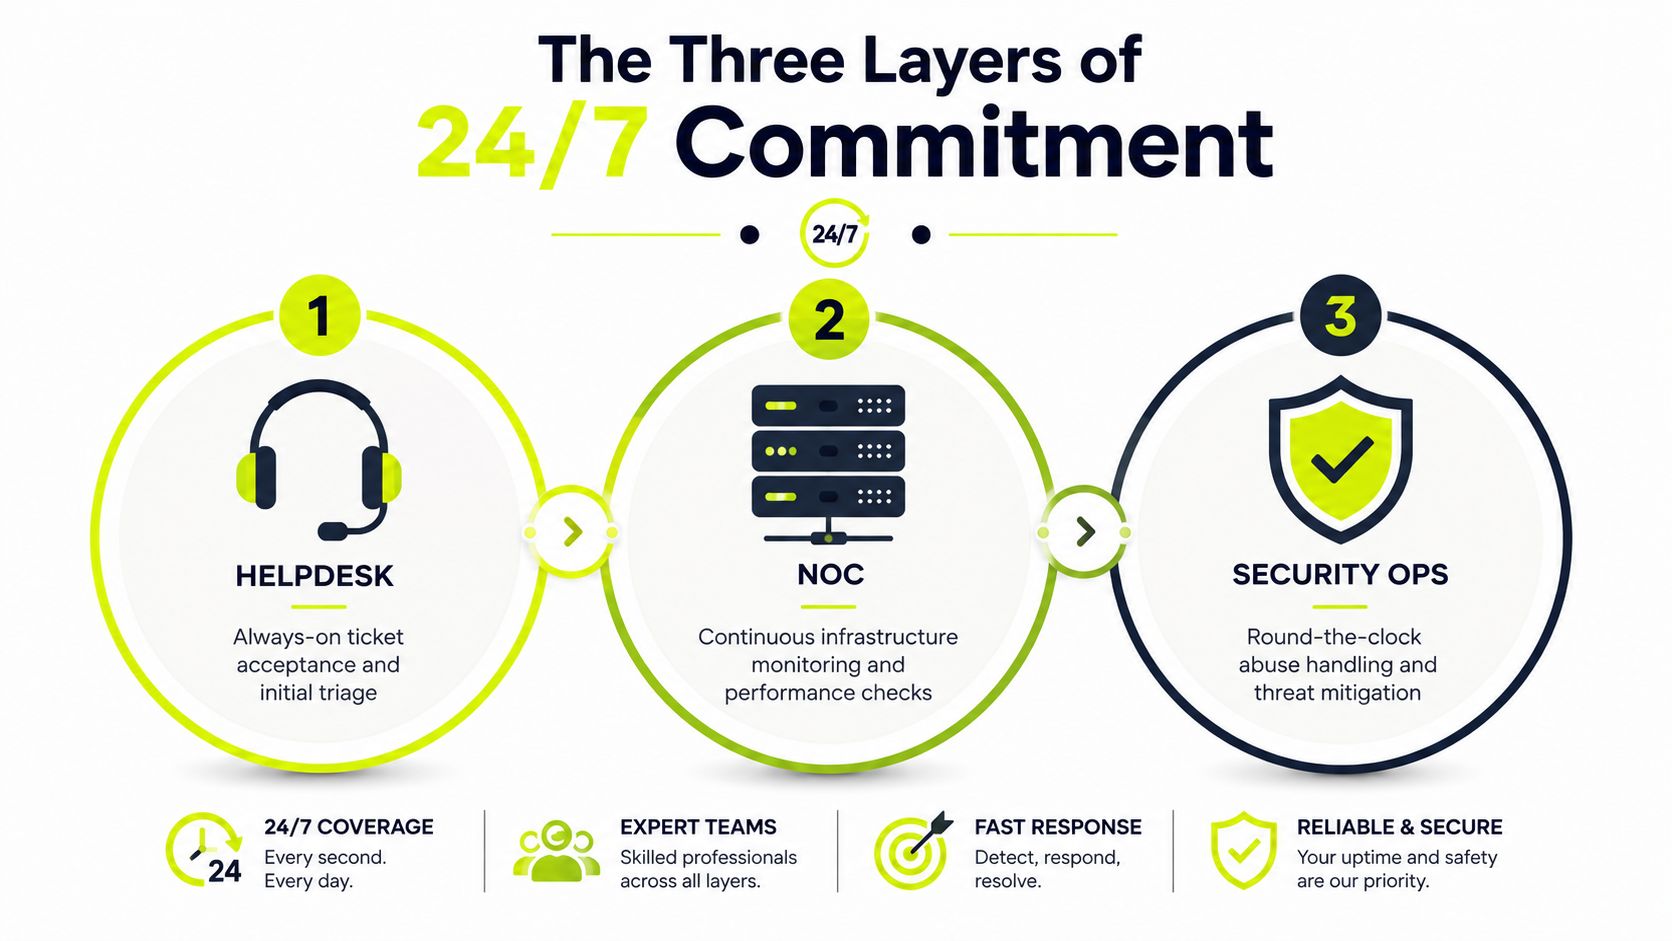
La cobertura no es capacidad
Un agente de chat que responde a las 3am pero no puede contactar a un ingeniero de escalación no desbloqueará una cuenta de anuncios de Facebook prohibida. Solo pueden recopilar síntomas. Esa es la diferencia entre tener personal y tener ingeniería de soporte.
Si tu flujo de trabajo depende de proxies, perfiles de navegador, persistencia de sesión o enrutamiento geo-segmentado, la interrupción podría estar en el pool, el operador, el stack de huellas digitales o la plataforma misma. Una configuración de soporte adecuada conecta esas capas con un resolutor que puede actuar, no solo responder. Por eso la guía de servicios de call center 24/7 es útil como base, pero los equipos con mucha automatización necesitan un estándar más estrecho que "alguien contestó."
El soporte híbrido supera al ruido de tiempo completo
El patrón más fuerte es un modelo de soporte híbrido. Deja que la automatización absorba el trabajo de baja urgencia como restablecimientos de contraseña o cambios de rotación de IP. Deja que los agentes en vivo manejen preguntas de configuración y verificaciones de estado. Reserva humanos para incidentes que pueden matar ingresos, como una prohibición de todo el pool, retención de pago o una ruptura de cloaking en múltiples regiones.
Ese modelo híbrido mantiene las colas limpias. También evita que tu turno nocturno se ahogue en problemas que un artículo de ayuda puede resolver en dos minutos.
Si el proveedor no puede describir los niveles de escalación en lenguaje sencillo, probablemente no los tiene.
Para los operadores, la prueba decisiva es simple. Pregunta si el proveedor puede hacer más que reconocer el problema. Pregunta si el resolutor puede monitorear, enrutar y escalar sin esperar al horario de oficina. La página de soporte de Sota Proxy importa porque muestra dónde quiere un proveedor que empieces cuando algo sale mal.
Tipos de Proxy y Por Qué la Velocidad de Soporte Importa para Cada Uno
El tipo de proxy cambia lo que significa "urgente". Residencial, móvil, datacenter e IPv6 todos se rompen de diferentes maneras, por lo que la carga de soporte no es la misma. Si compras el modelo de respuesta equivocado para la clase de proxy equivocada, terminas pagando por uptime que aún no puedes usar.
| Tipo de proxy | Uso típico en automatización | Modo de fallo que requiere soporte | Por qué importa la velocidad 24/7 |
|---|---|---|---|
| Residencial | Cuentas publicitarias de Facebook y TikTok, farming de cuentas, cloaking | Un sub-pool es marcado o la calidad cae | Decisiones rápidas de reemplazo mantienen las sesiones activas y salvan campañas ya en curso |
| Móvil | Sesiones más difíciles de banear, flujos sociales de alta confianza | Fallos en la rotación del operador o fallos de sesión pegajosa | La investigación humana importa porque el fallo a menudo está fuera de tu stack del navegador |
| Datacenter | Cargas de trabajo rápidas y baratas, pruebas masivas, tareas de ciclo corto | Quema de rangos, baneos o picos de bloqueo | La velocidad de respuesta controla qué tan rápido cambias rangos y dejas de malgastar presupuesto |
| IPv6 | Automatización de gran volumen, paralelismo de bajo coste, pruebas geo | Problemas de enrutamiento o aceptación del lado del proveedor | El soporte de reemplazo rápido importa porque la opción barata deja de serlo cuando falla |
Los residenciales necesitan triaje rápido de sub-pools
Las IPs residenciales suelen tener la mayor confianza, pero la calidad del pool puede variar. Esto significa que puedes hacerlo todo bien en AdsPower o Multilogin y aún así ser penalizado por una porción mala del inventario. Cuando un proveedor puede reemplazar o redirigir rápido, preservas la continuidad de la campaña en lugar de dejar que un segmento podrido contamine toda la ejecución.
Móviles y datacenter fallan de manera diferente
Los proxies móviles son útiles porque son más difíciles de banear, pero el comportamiento del lado del operador puede romper la rotación de formas que no se muestran como un error limpio del navegador. Datacenter e IPv6 son más rápidos y baratos, lo cual es genial hasta que la plataforma quema el rango y el camino de reemplazo se convierte en el producto real. Si el soporte no puede moverse rápido, la opción de bajo coste empieza a costarte tiempo, y el tiempo es lo que mata las cuentas publicitarias.
Para profundizar en cómo los proveedores clasifican estas opciones, la guía de tipos de proxy es un punto de referencia claro. La conclusión práctica es más simple. Paga por soporte más rápido donde la clase de proxy tiene mayor probabilidad de convertirse en un bloqueador de campaña.
No evalúes los proxies solo por precio. Evalúalos por la rapidez con que el soporte puede devolverte a una sesión funcional.
KPIs, elementos de SLA y preguntas para hacer a los proveedores
"Buen soporte" no sirve de nada a menos que puedas medirlo. Para flujos de trabajo de operadores, el cuadro de mando debe incluir tiempo de primera respuesta, tiempo de resolución, abandono de llamadas nocturnas, tasa de transferencia de escalamiento y rutas de escalamiento fallidas. Si un proveedor no puede mostrar esos números, probablemente está optimizando para el cierre de tickets, no para la recuperación.
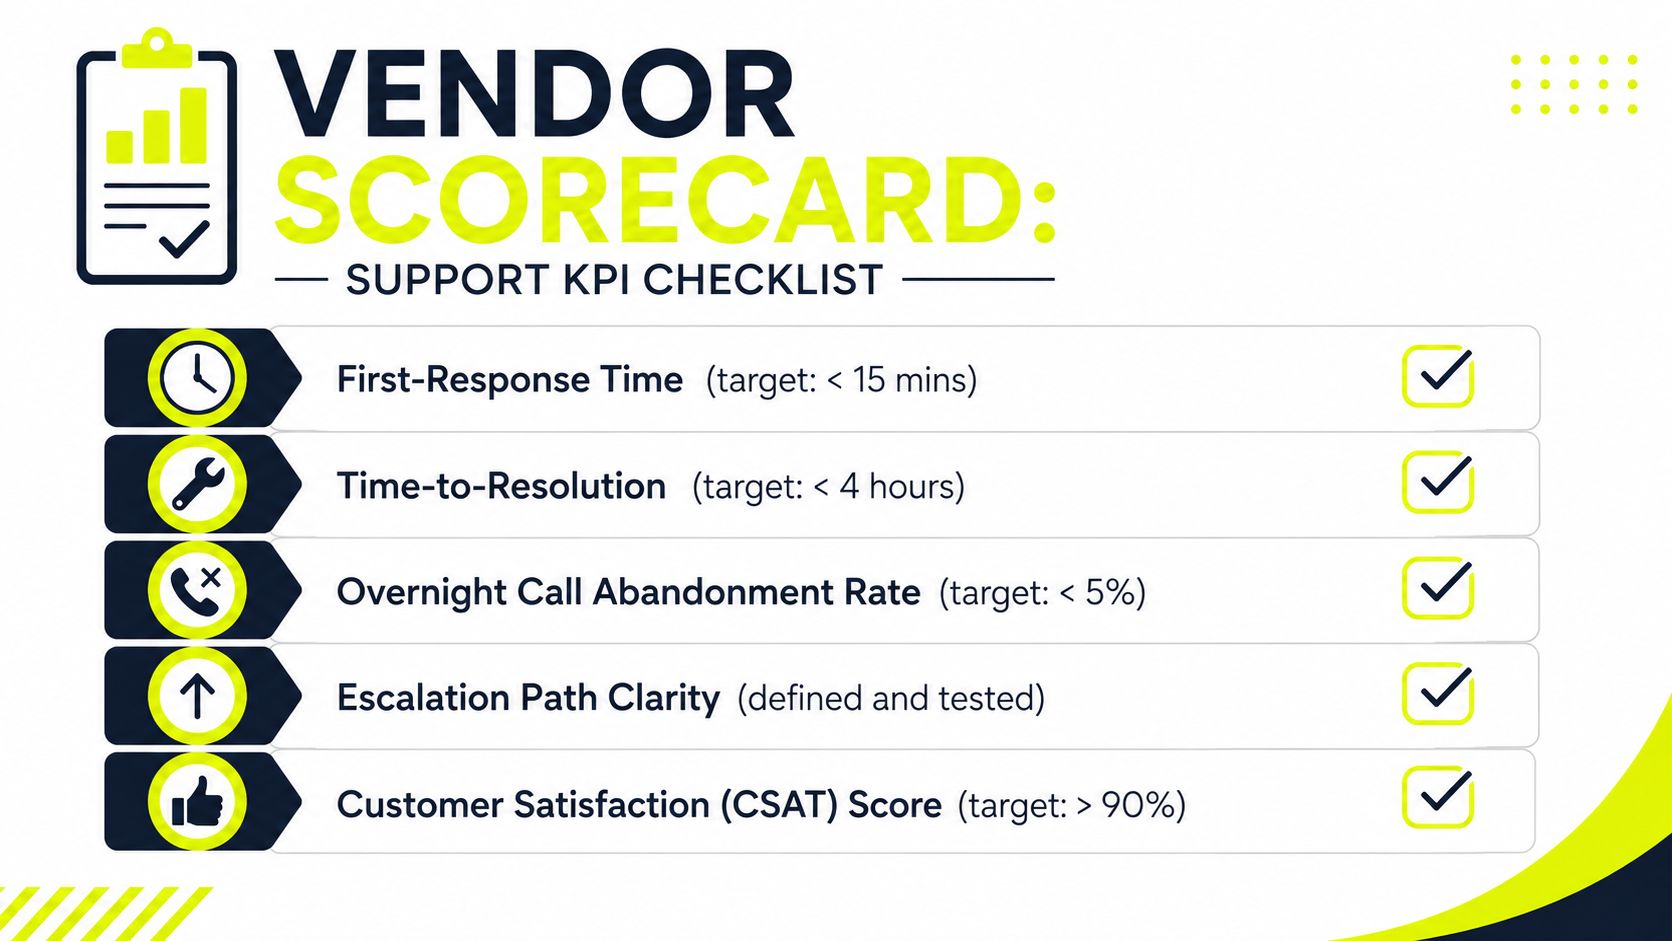
Qué exigir por escrito
Comienza con el SLA, no con la presentación de ventas. Quieres garantías de tiempo de actividad, ventanas de respuesta por nivel de severidad, contactos de escalamiento nominales y cláusulas de reembolso o crédito si el proveedor incumple la promesa. Si un proveedor no lo pone por escrito, te está pidiendo que aceptes su proceso interno por fe.
La política de uso justo también importa porque el soporte se complica cuando las reglas de uso son vagas. Un equipo de soporte no puede ayudarte si los términos comerciales no son claros o si el proveedor puede señalar una laguna en la política después del hecho.
Preguntas que atraviesan el ruido
- ¿Quién responde a las 3am? Pregunta si es un ingeniero, un generalista o un socio del proveedor.
- ¿Tengo un contacto nominal? Las colas anónimas desperdician tiempo cuando un incidente ya está en vivo.
- ¿Se puede probar el escalamiento antes de firmar? Si no, estás confiando en una promesa que nunca has visto funcionar.
- ¿Qué pasa cuando la primera solución falla? Los proveedores débiles repiten la misma respuesta. Los fuertes escalan rápido.
- ¿Cómo manejan los fallos nocturnos? Si no pueden explicar el camino, probablemente no tienen uno.
La conversación de soporte debería sentirse como una adquisición de infraestructura crítica. No una demo de ventas. No una conversación de chat. Una verificación de sistema.
Regla de proveedor: si el camino de escalamiento no se puede describir en un minuto, no resistirá bajo presión.
Para equipos que ejecutan cuentas publicitarias de Facebook, drops de TikTok y cloaking geo-dirigido, la pregunta del KPI es si el proveedor puede mantener el canal vivo cuando el canal ya está fallando. Esa es la única métrica de soporte que importa en medio de la noche.
Flujo de resolución de problemas y escalamiento que realmente funciona
El mejor flujo de incidentes comienza antes de que el soporte vea el ticket. Primero, revisa el panel, los controles de rotación y el estado de sesión pegajosa. Si el problema se resuelve ahí, acabas de ahorrarte una transferencia. Si no, crea un ticket con los detalles que el soporte necesita.
Paso a paso sin adivinar
- Autoservicio primero. Verifica la salud del perfil, cambia la rotación, reinicia las sesiones pegajosas y confirma que el fallo es reproducible.
- Abre un ticket estructurado. Incluye tipo de proxy, geolocalización, IDs de cuenta, códigos de error, marcas de tiempo y qué cambió justo antes de la falla.
- Usa chat en vivo para problemas de urgencia media. Un fallo único de perfil de AdsPower o una cuenta de TikTok actuando raro normalmente necesita un triaje rápido, no un puente de incidentes completo.
- Escala a un ingeniero humano para incidentes críticos. Baneos masivos, páginas de cloaking fallando verificaciones geo en múltiples regiones, o retenciones de pago bloqueando recargas necesitan escalamiento real, no una respuesta de bot repetida.
La guía de problemas de resolución DNS es relevante aquí porque un número sorprendente de "problemas de soporte" comienzan como comportamiento de infraestructura mal interpretado. Si el proveedor no puede distinguir entre una mala configuración local y un problema del lado de la plataforma, tu ticket se estancará.
Cómo se ve un buen escalamiento
Un buen escalamiento significa que un ingeniero nominal toma propiedad, no un chatbot reciclando la misma frase. Un buen escalamiento también significa que el proveedor pide los datos que acortan el diagnóstico, en lugar de hacerte repetir los mismos síntomas tres veces. El recurso mejorar el manejo de reportes de bugs es útil porque impulsa la misma disciplina: entrada estructurada vence queja vaga cada vez.
Un camino de escalamiento limpio ahorra tiempo de formas feas. Para una granja de 50 cuentas, eso puede significar la diferencia entre un incidente recuperable y una eliminación de noche completa. Para una campaña geo-dirigida, puede significar la diferencia entre capturar un problema del operador antes de que la ventana de drop cierre y ver la ventana desaparecer.
Escenarios Donde el Soporte 24/7 Salvó la Campaña
Un buen equipo de soporte no "se siente útil". Detiene pérdidas. Eso se refleja en matemáticas directas de operador.
Cambio de pool residencial que mantuvo vivo el gasto
Una granja de AdsPower con 50 cuentas publicitarias de Facebook queda marcada en un solo barrido. El operador abre un ticket, proporciona los detalles completos del stack y obtiene un cambio limpio de pool residencial en unos 20 minutos. Sin esa respuesta, el gasto del resto del día muere en la cola. Con ella, la campaña de la semana sobrevive lo suficiente para seguir probando.
Corrección del lado del carrier antes de que cierre el lanzamiento de sneakers
Una campaña de TikTok geo-segmentada de sneakers falla porque la rotación de IP móvil se atasca. El navegador se ve bien. El enrutamiento no. Un ingeniero de soporte a medianoche rastrea la falla hasta un problema del lado del carrier antes de que cierre la ventana de lanzamiento, lo cual importa porque las campañas cronometradas no te dan una segunda oportunidad. El soporte lento convierte esa ejecución en inventario muerto.
Respaldo IPv6 cuando un rango de datacenter se quema
Un pipeline de cloaking se rompe en dos regiones después de que un rango de datacenter se quema. El proveedor rota a IPv6 dentro de la ventana del SLA, y el operador mantiene la campaña en movimiento en lugar de reconstruir el stack desde cero. Ese tipo de ruta rápida es exactamente donde un proveedor justifica su valor.
Si quieres las matemáticas aproximadas, el punto es simple. Una campaña que no puede servir es una campaña que no puede aprender, y una campaña que no puede aprender quema dinero mientras está offline. El soporte rápido no crea ingresos por sí solo. Detiene pérdidas prevenibles.
El tiempo de inactividad nunca es solo tiempo de inactividad. Es gasto desperdiciado, aprendizaje perdido y una pila creciente de trabajo de recuperación.
Elegir un Proveedor y Obtener Más de la Relación
Elige el proveedor como elegirías cualquier pieza de infraestructura que no puedas vigilar constantemente. Ejecuta una prueba pre-contrato. Envía un ticket detallado a las 2am hora local. Cronometra la primera respuesta. Dispara una escalación falsa. Evalúa si el contacto nombrado existe y si puede hacer avanzar el problema.
Esa prueba importa más que la llamada de ventas. Un vendedor puede sonar pulido a la luz del día y aún así colapsar cuando la cola se pone fea. Si responden lentamente, si se esconden detrás de respuestas genéricas, o si no pueden explicar el siguiente paso, vete.
Qué estandarizar antes de firmar
- Documenta el stack. Mantén el tipo de proxy, perfil de navegador, IDs de cuenta y notas de escalación en un solo lugar.
- Rota contactos nombrados. No dejes que un ingeniero se convierta en un punto único de falla.
- Mantén plantillas de incidentes listas. Tu primer mensaje ya debería contener los campos que el soporte necesita.
- Ajusta el comportamiento del proveedor a la carga de trabajo. Si necesitas ayuda personalizada cada noche, compra para esa realidad en lugar de esperar que un widget de chat madure.
Para equipos que ya manejan volumen serio, la relación con el proveedor también puede compensar costos. Sota Proxy tiene un programa de referidos que paga hasta 40% de comisión en referidos convertidos, lo cual puede importar si tu grupo se estandariza en un proveedor y dirige a otros operadores allí también. Trátalo como una palanca de control de costos, no como una razón para ignorar la calidad del soporte.
El proveedor debe ajustarse a la forma operativa del trabajo. Si ejecutas farming de cuentas, cloaking o campañas geo-segmentadas en múltiples navegadores, necesitas escalación rápida y diagnósticos limpios. Si no pueden soportar ese patrón, el plan barato se vuelve caro rápidamente.
Checklist del Operador Antes del Próximo Incidente a las 3am
Prueba la respuesta a las 3am antes de firmar. Mantén tu stack, IDs de cuenta y ruta de escalación en un solo lugar. Exige términos de SLA con niveles de severidad y cláusulas de crédito por escrito. Rastrea los tiempos de primera respuesta y resolución en cada incidente. Construye una relación con un ingeniero nombrado, no solo con un widget de chat.
Si estás ejecutando automatización intensiva en proxies y necesitas infraestructura construida para recuperación real, visita Sota Proxy y revisa el flujo de soporte antes de que la próxima campaña se tuerza. Verás cómo sus tipos de proxy, controles de rotación y soporte humano se ajustan al tipo de problemas a las 3am con los que lidian los operadores.
Artículos relacionados
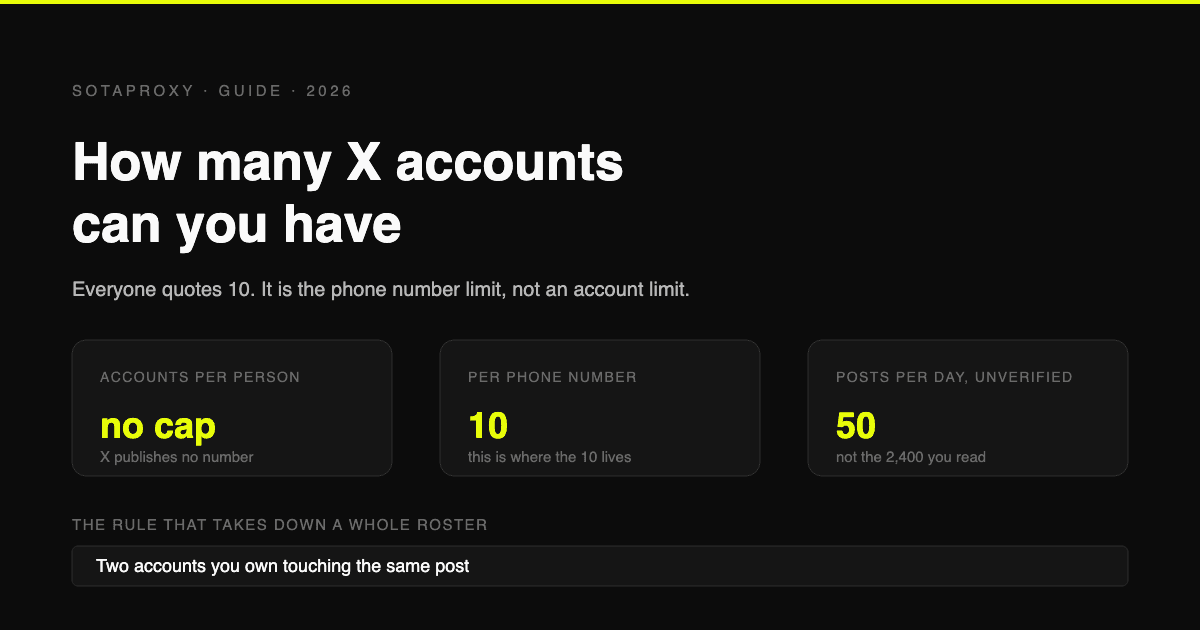
¿Cuántas cuentas de X (Twitter) puedes tener en 2026? (El límite de 10 es por teléfono, no por persona)
X no establece límite oficial de cuentas por usuario. El número 10 que todos mencionan se refiere a cuántas cuentas puedes asociar a un mismo número de teléfono. Las restricciones reales son los 50 posts diarios en cuentas gratuitas, casos de uso duplicados y cuentas que interactúan entre sí.
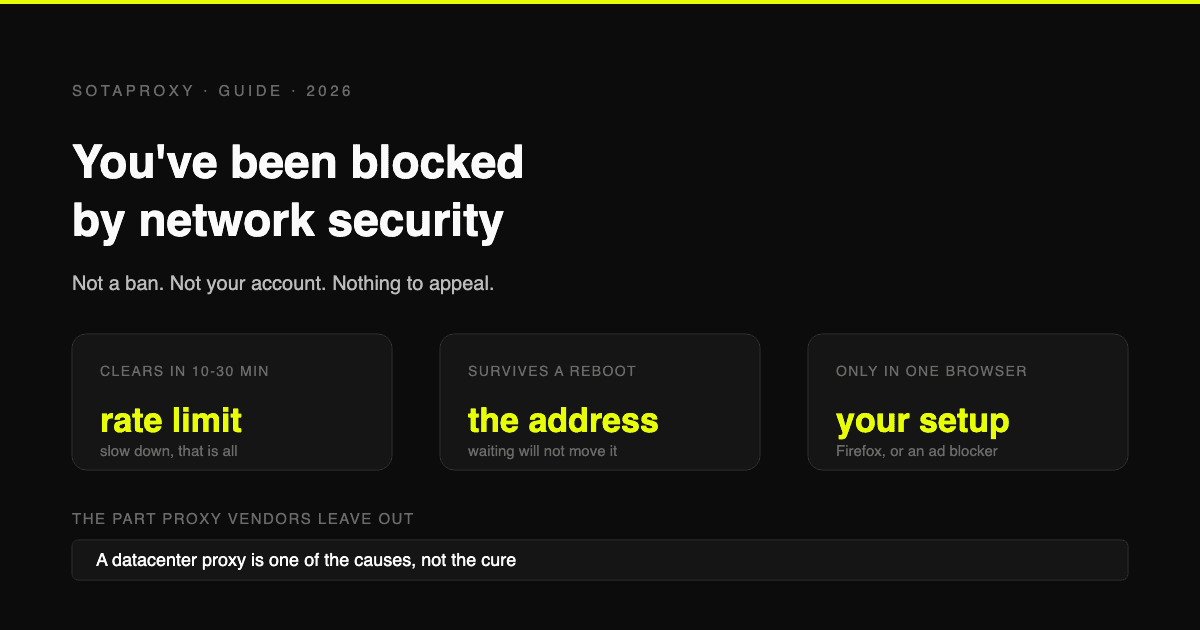
Reddit "You've Been Blocked by Network Security": Todas las causas y la solución para cada una
No es un baneo y no hay nada que apelar. Proviene del edge de Reddit, se aplica a tu conexión y tiene seis causas. Aquí te mostramos cómo identificar cuál tienes y cuánto dura cada una.
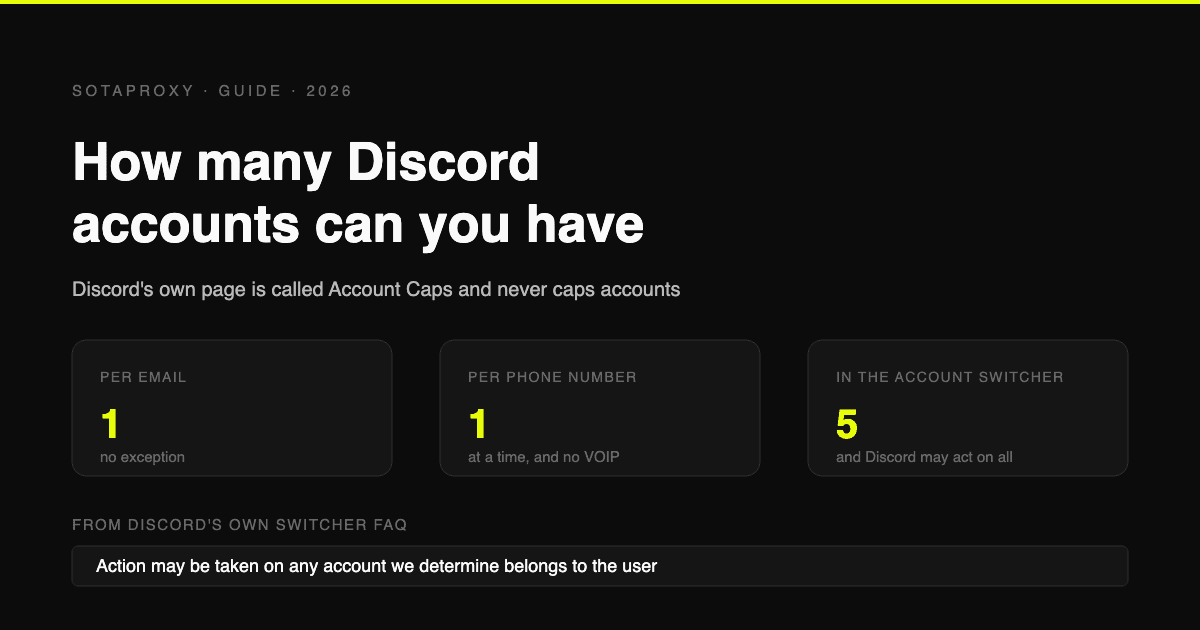
Cuántas Cuentas de Discord Puedes Tener en 2026 (Por Email, Por Teléfono, Por Dispositivo)
Discord no publica ningún límite en las cuentas. Los límites reales son uno por email, un número de teléfono a la vez sin VOIP, y cinco en el Cambio de Cuentas, que Discord indica que puede hacer cumplir de forma general.
Automatización de Telegram con Telegram Expert: qué hacer si la tarea se detuvo a la mitad
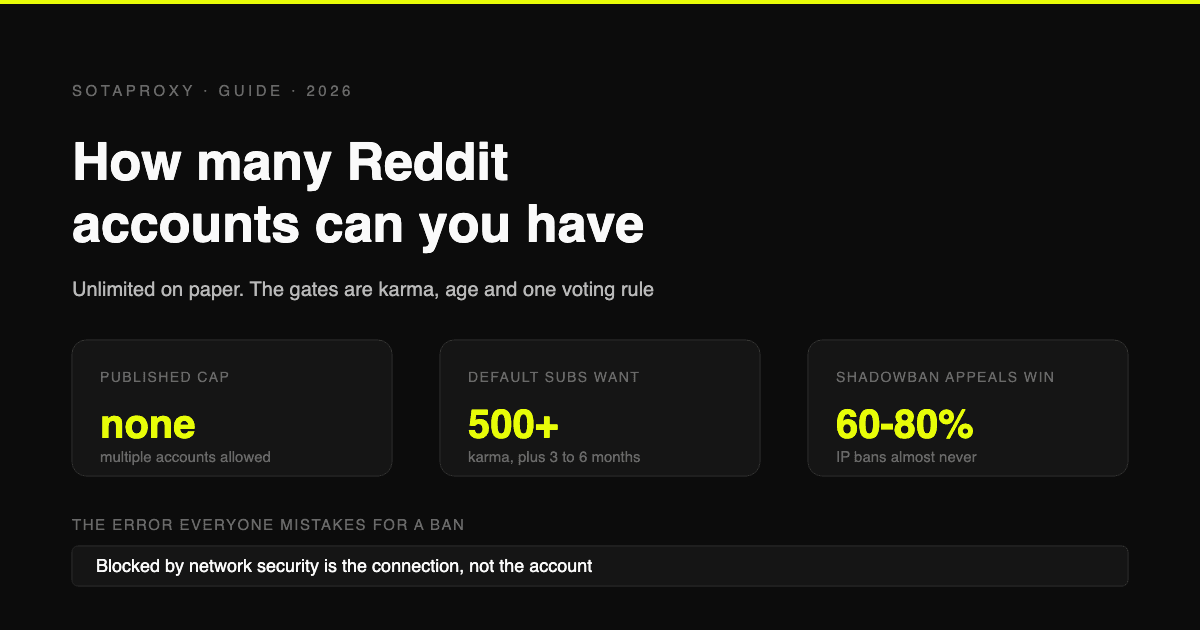
Cuántas Cuentas de Reddit Puedes Tener en 2026 (Barreras de Karma, Baneos, Bloqueos de Seguridad de Red)
Reddit permite múltiples cuentas abiertamente. Lo que te detiene son las barreras de karma, calidad del colaborador, límites de tasa y una regla estricta sobre votación, además de los tres tipos de baneo, cómo se apela cada uno, y por qué "bloqueado por seguridad de red" no es ninguno de ellos.
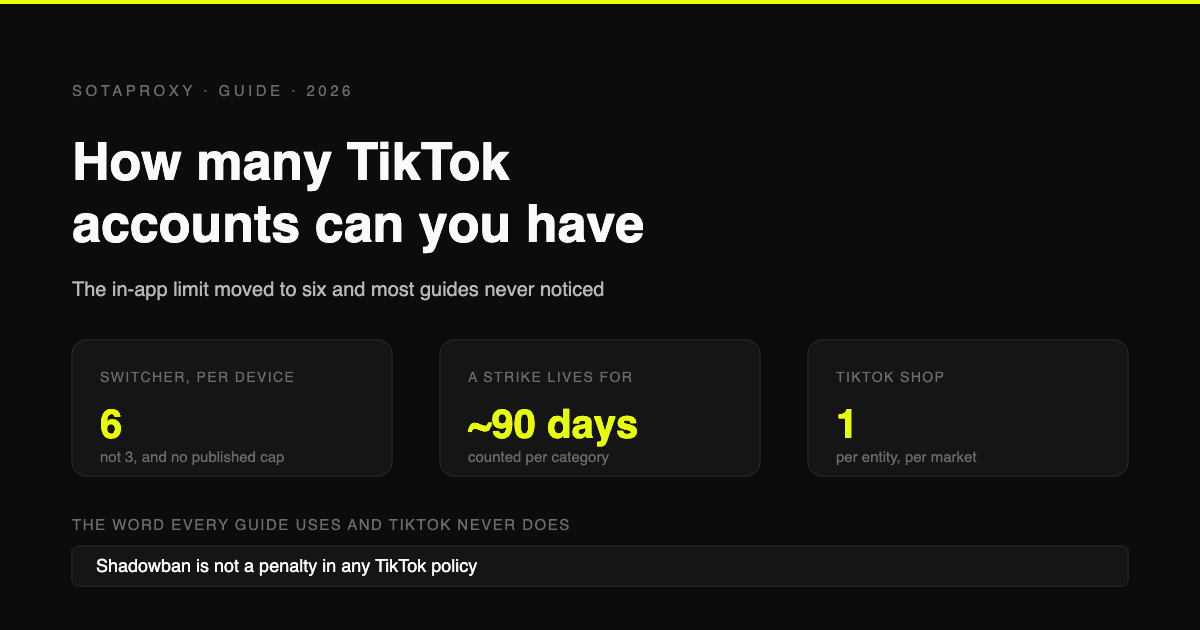
Cuántas Cuentas de TikTok Puedes Tener en 2026 (Límites, Strikes y Reglas de Shop)
Seis cuentas por dispositivo, no tres, y sin límite publicado. Las reglas que realmente deciden la supervivencia: límites de acción según la antigüedad de la cuenta, cómo expiran los strikes, qué es realmente un shadowban y una Shop por entidad comercial por mercado.