Лучшие прокси для веб-скрейпинга в 2026: как выбрать тип под конкретный сайт
Какой тип прокси подходит для парсинга того или иного сайта, во сколько обойдётся миллион страниц на каждом из них и как за 200 запросов понять, что блокирует цель: rate limit или класс адресов.
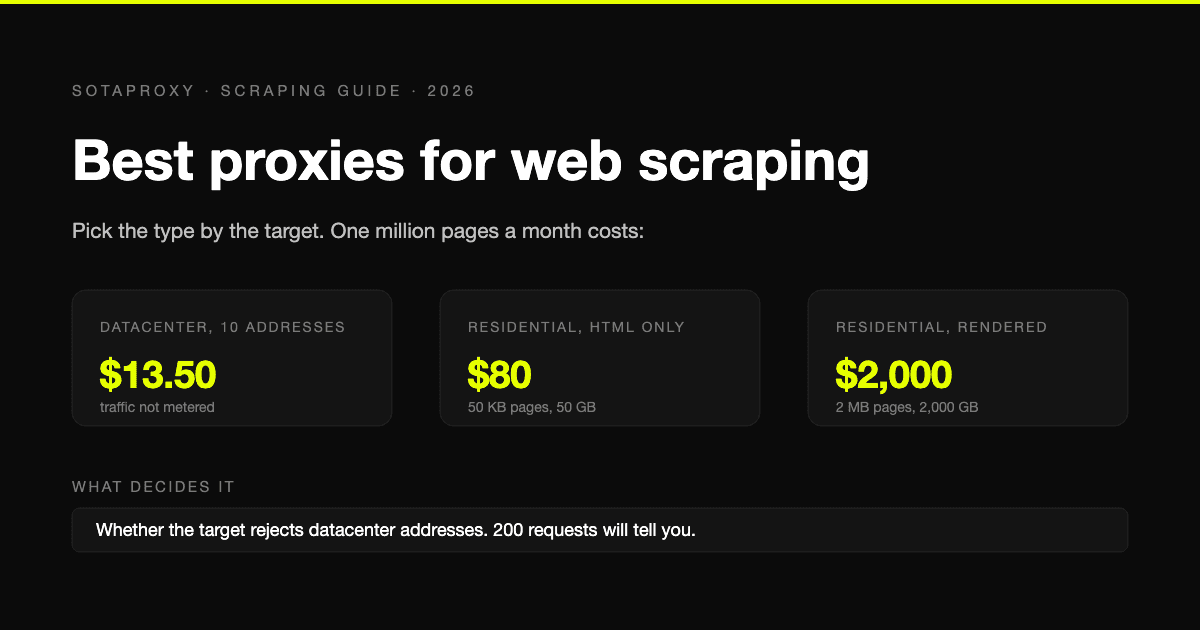
Лучший прокси для веб-скрейпинга - самый дешёвый тип, который принимает ваша цель. Это правило работает лучше любого топа, потому что разрыв в цене между типами огромен: миллион страниц в месяц обходится примерно в $14 на датацентровых адресах и до $2000 на резидентном трафике, если загружать каждую страницу в браузере.
Поэтому вопрос не в том, какого поставщика выбрать. Вопрос в типе прокси, и выяснить его можно двумястами запросами, не потратив серьёзных денег. В этом руководстве мы даём тест, стоимость каждого типа на миллион страниц и настройки, которые важны после выбора. Цены наши, взяты из актуального прайс-листа на 30 сентября 2026 года.
Короткий ответ по типу цели
| Что вы парсите | Тип прокси | Как тарифицируется |
|---|---|---|
| Сайты без защиты от роботов: документация, небольшие магазины, открытые порталы данных | Датацентровые | За адрес в месяц, трафик не учитывается |
| Крупные сайты, которые отвечают по IPv6 и не применяют жёсткую защиту | IPv6 | За адрес в месяц, самый дешёвый тип у нас |
| Защищённые сайты: маркетплейсы, результаты поиска, тревел, билеты | Резидентные с ротацией | За гигабайт |
| Страницы за вашим собственным логином | ISP, один статичный адрес на аккаунт | За адрес в месяц |
| Мобильные приложения и контент только для операторов связи | Мобильные | За модем в день |
Большинство задач по парсингу относятся к первой или третьей строке, и дорогая ошибка - платить за третью, когда достаточно первой.
Узнайте, что требуется вашей цели, за 200 запросов
Возьмите один датацентровый адрес и запросите один и тот же тип страницы двести раз. Не смотрите только на коды статуса: проверьте, что ответ содержит что-то присущее только настоящей странице, например элемент с названием товара.
import collections
import requests

TARGET = "https://example.com/some/listing"
MUST_CONTAIN = "product-title"      # строка, которая есть только на настоящей странице
PROXY = "http://login:password@198.51.100.20:50100"

results = collections.Counter()
for _ in range(200):
    try:
        r = requests.get(TARGET, proxies={"http": PROXY, "https": PROXY}, timeout=20)
    except requests.RequestException:
        results["network error"] += 1
        continue
    if r.status_code == 429:
        results["429 rate limit"] += 1
    elif r.status_code in (403, 503):
        results[f"{r.status_code} block"] += 1
    elif r.status_code == 200 and MUST_CONTAIN not in r.text:
        results["200 without content"] += 1
    elif r.status_code == 200:
        results["ok"] += 1
    else:
        results[str(r.status_code)] += 1

print(results)
Затем прочитайте результат:
- Все двести запросов прошли нормально. Датацентрового прокси достаточно. Остановитесь и не покупайте резидентный трафик.
- Сначала всё нормально, потом 429. Это лимит на адрес, а не оценка его типа. Замедлитесь или добавьте ещё датацентровых адресов. Переход на резидентные обойдётся гораздо дороже и ничего не решит.
- 403 или страница с проверкой с первого же запроса. Цель отвергает класс адресов. Именно для этого и существует резидентный трафик.
- 200 без содержимого, каждый раз. Мягкая блокировка: сайт отвечает вежливо, но выдаёт стену для ботов. В наших тестах страница товара на Amazon возвращалась с HTTP 200 и 3,8 КБ текста «продолжайте покупки». Считайте это блокировкой и повторяйте попытку на адресе другого типа.
Один контрольный момент делает тест надёжным. Запустите тот же скрипт без прокси, с вашего собственного соединения. Если блокировка происходит и там, проблема в вашем клиенте, его заголовках или TLS-отпечатке, и никакой прокси любого типа не поможет.
Сколько стоит миллион страниц для каждого типа
Для типов с тарификацией за гигабайт стоимость определяется весом страницы, поэтому мы используем веса, которые измерили сами: 46 КБ и 106 КБ для чистого HTML статьи Википедии и городской страницы Booking.com, 424 КБ и 2011 КБ для тех же страниц, загруженных в браузере. Измерения приведены в статье как зарабатывать на веб-скрейпинге.
| Конфигурация | Трафик на 1 000 000 страниц | Стоимость у нас |
|---|---|---|
| Датацентровые, десять адресов | Не учитывается | $13,50 в месяц |
| IPv6, сто адресов | Не учитывается | $20 в месяц |
| Резидентные, только HTML, страницы по 50 КБ | около 48 ГБ | $80 за пакет 50 ГБ |
| Резидентные, только HTML, страницы по 106 КБ | около 101 ГБ | около $150 |
| Резидентные, с рендерингом, страницы по 424 КБ | около 405 ГБ | $650 за пакет 500 ГБ |
| Резидентные, с рендерингом, страницы по 2 МБ | около 1920 ГБ | $2000 за пакет 2000 ГБ |
Эти цифры указаны до повторных попыток, а неудачный запрос тарифицируется так же, как успешный.
Из таблицы следуют два вывода. Первое: строки с датацентровыми адресами не растут с объёмом. Миллион страниц в месяц - это один запрос каждые 2,6 секунды для всей задачи, или один каждые 26 секунд на адрес при десяти адресах, что терпит почти любой сайт. Второе: на резидентных главный рычаг стоимости - не поставщик и не тариф за гигабайт. Это вопрос, применяете ли вы рендеринг. Те же миллион страниц стоят $150 как HTML и $2000 через браузер.
Настройки, которые важны после выбора
Ротация происходит по соединению, а не по запросу. На нашем резидентном шлюзе новое соединение получает новый выход. Клиент, который поддерживает соединения живыми (именно это делают объекты сессий в HTTP-библиотеках), сохраняет адрес, с которого начал. Если ваш скрейпер показывает один адрес минутами, причина в этом.
Чистое решение - управлять этим самостоятельно через идентификаторы сессий в логине:
import itertools
import requests

GATEWAY = "proxy.sotaproxy.com:10000"
counter = itertools.count(1)

def proxy_for_new_exit(country="US"):
    n = next(counter)
    url = f"http://login_c_{country}_s_{n}_ttl_30s:password@{GATEWAY}"
    return {"http": url, "https": url}

session = requests.Session()
r = session.get("https://example.com/page/1", proxies=proxy_for_new_exit(), timeout=30)
Каждый новый идентификатор запрашивает новый выход, а повторное использование идентификатора сохраняет тот же выход столько, сколько позволяет его время жизни.
Сохраняйте один адрес для всего, что имеет состояние. Пагинация, которая зависит от куки, корзина, сессия поиска: дайте такой задаче один идентификатор с временем жизни пятнадцать минут или час. Три времени жизни и как выбирать между ними описаны в справке по ротируемым и липким сессиям.
Давайте каждому воркеру свой идентификатор. Два воркера, делящие один идентификатор, делят выход, и цель видит одного посетителя, который делает вдвое больше запросов.
Выбирайте страну выхода под сайт. Британский ритейлер показывает британские цены и наличие британским адресам. Наши датацентровые адреса продаются по странам в 41 стране, в том числе в Великобритании, США и Германии, а резидентный трафик принимает страну как суффикс в логине.
Сократите вес страницы, прежде чем сокращать скорость. В безголовом браузере блокируйте то, что вы не разбираете:
BLOCKED = {"image", "media", "font"}

def drop_heavy(route):
    if route.request.resource_type in BLOCKED:
        route.abort()
    else:
        route.continue_()
page.route("**/*", drop_heavy)Это Python API Playwright. Подход не делает отрисовку дешёвой, потому что скрипты и стили составляют основную часть трафика, но он убирает то, что вам вообще не нужно.
IPv6-прокси для скрейпинга: когда они работают
Адреса IPv6 у нас стоят $0,20 за штуку в месяц. Это самая низкая цена в каталоге. Они работают только в том случае, если целевой сайт публикует AAAA-запись, то есть доступен по IPv6 вообще.
Мы проверили это для крупных сайтов 8 сентября 2026 года. Google, YouTube, Facebook, Instagram, LinkedIn, Reddit, Wikipedia и Amazon отвечают по IPv6. X, TikTok, eBay, AliExpress и Walmart не отвечают. Полный список по странам и скрипт для самостоятельной проверки любого домена находятся на нашей странице поддержки IPv6.
Два момента, прежде чем покупать тысячу адресов:
- Доступность не равна лояльности. Сайт может отвечать по IPv6, но при этом блокировать диапазоны датацентров. Сначала прогоните тест на 200 запросов с IPv6-адреса.
- Сайты считают IPv6 по блокам, а не по адресам. Поскольку один абонент обычно получает целый /64, ограничения по частоте применяются к /64 или шире. Много адресов из одного блока могут вести себя как один адрес.
Мы продаём IPv6 в 17 странах. Подробности на странице IPv6-прокси.
Когда прокси не решение
Прокси меняют адрес, с которого идёт запрос. Они не меняют то, как выглядит клиент.
- Страница остаётся пустой оболочкой, пока не выполнятся скрипты. Наш сырой запрос к листингу Reddit вернул 8 КБ с заголовком «Reddit». Тут нужен браузер, какой бы прокси ни был.
- Вас блокируют и без прокси. Это фингерпринтинг клиента, и исправление в клиенте.
- Вы не хотите это всё поддерживать. Тогда покупайте результат, а не трафик. Bright Data, Oxylabs и Zyte продают разблокировщики и API для скрейпинга, которые обрабатывают рендеринг, повторы и проверки как управляемый сервис. Мы такого не продаём. Сравнение двух крупнейших в статье Bright Data vs Oxylabs.
Где купить
По резидентскому трафику цены пяти вендоров на 10, 100 и 1000 ГБ приведены в статье лучшие резидентские прокси. На момент написания мы самые дешёвые из пяти по гигабайту, но у нас нет опубликованных независимых бенчмарков, поэтому тестируйте, прежде чем покупать объём.
По адресам датацентров, ISP и IPv6 наши цены $1,80, $3,00 и $0,20 за один адрес в месяц, они падают до $1,35 и $2,10 при десяти адресах для первых двух типов. Подписки нет, оплата только криптовалютой. Полные тарифные сетки на странице цен.
Если хотите прогнать тест на 200 запросов до оплаты кому-либо, Webshare даёт десять общих датацентровых прокси бесплатно. Общие адреса отказывают чаще выделенных, поэтому успех там хорошая новость, а провал не окончательный вердикт.
FAQ
Какой прокси лучше для веб-скрейпинга?
Самый дешёвый тип, который принимает цель. Датацентры для сайтов без защиты от ботов, резидентские для сайтов, отвергающих диапазоны датацентров, статический ISP-адрес для всего, что за логином. Выясняйте, что подходит, тестом на 200 запросов с одного адреса датацентра.
Нужны ли резидентские прокси для скрейпинга?
Только если цель блокирует адреса датацентров по классу, что проявляется как 403 или стена бота с самого первого запроса. Код 429 после серии успешных запросов это ограничение частоты, и больше адресов датацентров решают его за долю стоимости.
Сколько прокси мне нужно?
Разделите количество страниц, которые нужны в день, на то, что может забрать один адрес в рамках лимита цели. Если сайт терпит один запрос каждые две секунды с адреса, один адрес забирает около 43 000 страниц в день. Для миллиона страниц в месяц это один адрес на бумаге и десять на практике для запаса. На ротируемых резидентских вопрос не стоит: вы покупаете гигабайты, а пул подставляет адреса.
Достаточно ли бесплатных прокси или парсеров прокси?
Парсер прокси собирает публичные списки прокси, и эти адреса общие для всех, кто спарсил тот же список. Ожидайте, что большинство мертвы или уже заблокированы на любом сайте, который стоит скрейпить. Они годятся для изучения, как работают прокси, а не для работы, от которой вы зависите.
HTTP или SOCKS5 для скрейпинга?
HTTP, если только ваш инструмент не требует чего-то, что HTTP не передаёт. Каждый наш продукт говорит на обоих. Если используете SOCKS5, пишите socks5h://, чтобы имена хостов резолвились на стороне прокси, а не на вашей машине. Подробности в разделе протоколы и порты.
Законен ли веб-скрейпинг?
Зависит от страны, от того, что это за данные и как вы их используете. К публичным неличным данным относятся совершенно иначе, чем к личным данным или контенту за логином, а условия сайта тоже могут иметь значение. Это не юридическая консультация. Если данные личные или проект коммерческий, спросите юриста, прежде чем масштабировать.
Похожие статьи
Авторизация прокси: логин и пароль или белый список IP
Прокси узнаёт вас одним из двух способов: по логину и паролю в каждом подключении или по списку адресов, которых пускают без них. Разбираем, что каждый способ передаёт по сети (с замерами на тестовом прокси), какие инструменты умеют только один из них и почему ноутбук из белого списка через неделю перестаёт работать.
Забанили с чистым прокси? Ошибки в настройке, из-за которых это происходит
Прокси был чистым, адрес резидентным, а аккаунт всё равно умер. В большинстве случаев, которые мы разбирали, адрес был ни при чём. Семь ошибок настройки, каждую можно проверить за минуту, в том порядке, в котором они обычно и оказываются причиной.
Decodo или IPRoyal в 2026: реальные входные цены, сгорающий трафик и кто проверяет документы
Оба вендора работают в среднем сегменте, принимают карты и крипту и продают трафик гигабайтами. Цены с их страниц на 6 октября 2026 года, почему ни одна из заголовочных ставок не является входной, у кого сгорает трафик, кто проверяет личность перед покупкой и кто возвращает деньги.
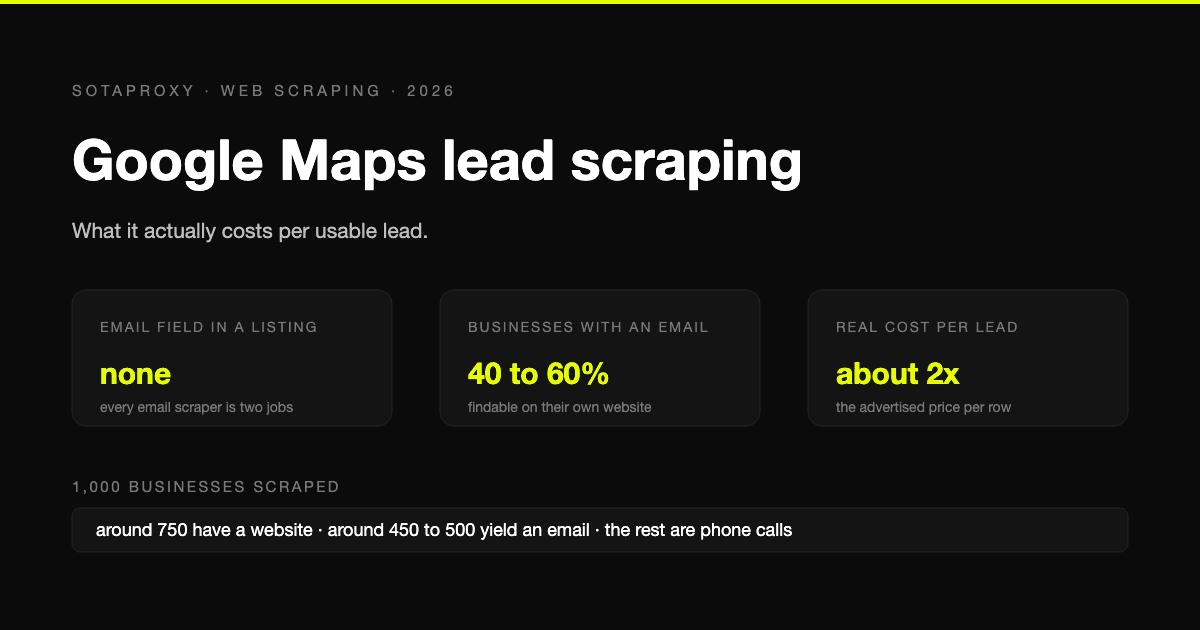
Парсинг лидов из Google Карт: реальная цена одного готового контакта
В Google Картах нет поля с email, поэтому любой парсер email работает в два этапа, и только примерно половина компаний даёт адрес. Сколько на самом деле стоит получить тысячу записей в пересчёте на годный лид, что делать с бизнесами без сайтов и какова правовая ситуация после решения по делу SerpApi.
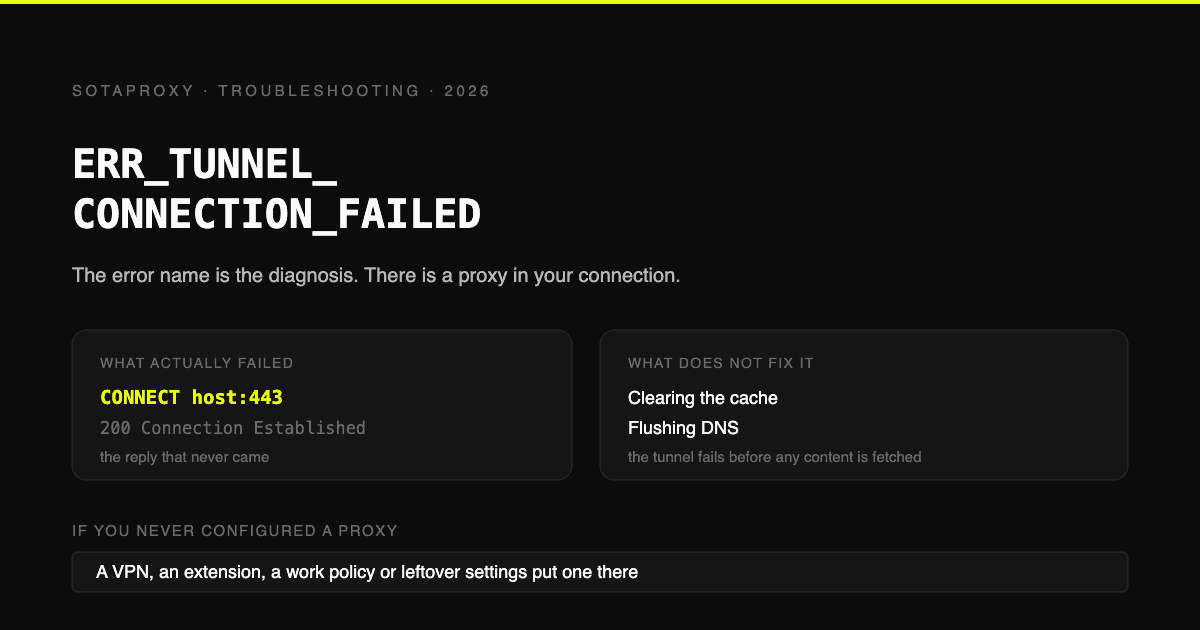
ERR_TUNNEL_CONNECTION_FAILED: диагноз содержится в самой ошибке
Chrome попросил прокси открыть CONNECT-туннель, но получил отказ. Это и есть суть ошибки. Откуда берётся прокси, который вы никогда не настраивали, шесть причин, по которым настроенный прокси выдаёт эту ошибку, и почему очистка кеша ничего не решает.
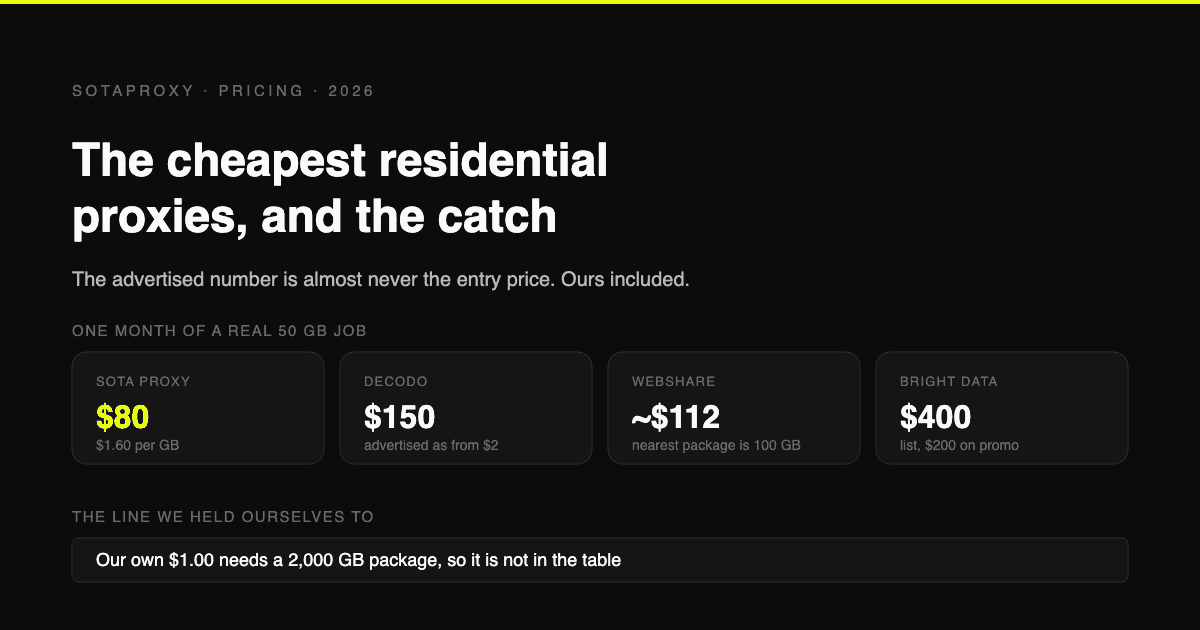
Самые дешёвые резидентные прокси в 2026 году и скрытые подводные камни каждого
Проверенные цены за гигабайт с сайтов пяти провайдеров, а не из прошлогодних обзоров. Почему рекламная стоимость почти никогда не совпадает с реальной ценой входа, какие провайдеры устанавливают минимальный месячный порог оплаты и как рассчитать свою реальную стоимость гигабайта.