CSV vs JSON: Практическое руководство для скрейперов и Ad Ops
Сравнение CSV и JSON для технических команд: структура, скорость парсинга, вложенные данные и реальный выбор для скрейпинга, верификации рекламы и конвейеров автоматизации.
Многие команды задают неправильный вопрос. CSV против JSON редко является однозначным решением само по себе, потому что формат работает только тогда, когда он соответствует стоящей перед вами задаче. Если вы запускаете пайплайны парсинга, задачи верификации рекламы или экспорты для фарминга аккаунтов, ключевое дерево выбора - это плоские таблицы против вложенных данных, потоковая обработка против загрузки полного файла, и человеческий просмотр против машинной обработки.
Вот почему бинарные советы не работают. CSV всё ещё лидирует в плоских табличных экспортах, потому что RFC 4180 стандартизировал общую модель записей, где каждая строка несёт одинаковое количество полей, в то время как JSON-объекты могут различаться по записям и содержать вложенную структуру. JSON выигрывает, когда данные имеют иерархию или изменяющиеся поля. Посередине JSONL часто превосходит оба формата для логов и потоков только на добавление, а Parquet выигрывает, когда аналитика и эффективность хранения важнее, чем просмотр сырого текста.
| Формат | Лучшее применение | Сильная сторона | Слабое место |
|---|---|---|---|
| CSV | Плоские экспорты, таблицы, импорт в SQL | Компактный, легко стримить, простой для сравнения | Слаб для вложенности и смешанных типов |
| JSON | API, вложенные объекты, конфиг-файлы | Самоописываемый, гибкая структура | Многословный в передаче, медленнее парсится |
| JSONL | Логи, потоковые ответы, потоки только на добавление | Построчная обработка, без загрузки полного файла | Всё ещё текст, всё ещё многословный для широких данных |
| Parquet | Хранилища, дата-лейки, большие архивы | Сильное сжатие и эффективность запросов | Не дружелюбен для человека в текстовом редакторе |
Содержание
- Перестаньте спрашивать CSV против JSON и начните спрашивать, что вам действительно нужно
- Структура, схема и типизация в сравнении
- Размер, скорость парсинга и потребление памяти
- Библиотеки парсинга и примеры кода для конвертации
- Выбор формата по случаю использования в парсинге и рекламных операциях
- Экранирование, кодирование и проблемы безопасности
- Когда JSONL или Parquet превосходят оба формата
- Рекомендации по пайплайну и выбору прокси
Перестаньте спрашивать CSV против JSON и начните спрашивать, что вам действительно нужно
Дебаты запутываются, потому что люди сравнивают CSV и JSON, как будто они решают одну и ту же проблему. Это не так. CSV - это формат плоских записей. JSON - это формат документов с возможностью вложенных объектов, массивов и опциональных полей. Если вы пытаетесь применить один формат для задачи другого, вы в итоге пишете связующий код для конвертации, возитесь с граничными случаями и объясняете неправильно сформированные экспорты в 2 часа ночи.
Начните с формы данных, а не с предпочтений
Если ваш источник - это строка на аккаунт, строка на ключевое слово или строка на событие прокси, CSV обычно подходит. Если каждая запись содержит вложенные креативы, переменные метаданные или изменяющийся граф объектов, JSON - более чистый формат для передачи. Если источник - это поток событий, JSONL может избавить вас от необходимости загружать весь файл только для чтения строки 17. Если архив предназначен для аналитики, Parquet часто является лучшим долгосрочным выбором для хранения, потому что колоночные файлы поддерживают более эффективные запросы на стороне потребителя, чем строчно-ориентированный текст.
Практическое правило: выбирайте формат по тому, как данные движутся через пайплайн, а не по тому, что проще экспортировать из исходной системы.
Это важно в рекламных операциях и парсинге, потому что одна и та же команда часто нуждается во всех четырёх форматах в разных местах. Задача автоматизации браузера в AdsPower или Multilogin может выдавать структурированные логи. Экспорт верификации рекламы Facebook или TikTok может чисто укладываться в строки. Проверка клоакинга может создавать вложенные метаданные запросов. Задача для хранилища может требовать сжатого аналитического хранилища, а не текстового файла, который кто-то откроет в Excel.
Настоящее дерево решений
Используйте CSV, когда людям нужна таблица, когда импорт в базу данных прост, и когда вы хотите компактные экспорты. Используйте JSON, когда данные вложенные или переменные. Используйте JSONL, когда вам нужна построчная обработка только на добавление. Используйте Parquet, когда вывод предназначен для аналитики, дата-лейков или повторяющихся запросов с большим сканированием. Это дерево выбора более полезно, чем спор о том, какой из двух текстовых форматов «лучше». Оно также совпадает с тем, как современные руководства по инженерии данных разделяют простые экспорты, потоковый обмен и аналитическое хранение на разные категории, а не один общий конкурс файловых форматов.
Структура, схема и типизация в сравнении
CSV и JSON различаются сначала на уровне формы, затем на уровне схемы, затем на уровне типизации. Это та часть, которую многие игнорируют, пока не сломается парсер. CSV даёт вам строки и столбцы. JSON даёт вам объекты и массивы. Один создан для табличных записей. Другой создан для документов.
campaign_id,geo,spend,is_active
1001,US,12.50,true
1002,DE,8.00,false
[
  {"campaign_id": 1001, "geo": "US", "spend": 12.50, "is_active": true},
  {"campaign_id": 1002, "geo": "DE", "spend": 8.00, "is_active": false}
]
CSV-версия легко читается, легко импортируется и легко соединяется в SQL. JSON-версия самоописываема, и это важно, когда ваши записи не все выглядят одинаково. В пайплайне парсинга карточка товара может иметь вложенную историю цен, в то время как карточка листинга может её не иметь. JSON справляется с этим без изобретения пустых столбцов только для поддержания матрицы. CSV лучше работает, когда каждая строка должна иметь одинаковые поля.
| Критерий | CSV | JSON |
|---|---|---|
| Модель данных | Строки и столбцы | Объекты и документы |
| Схема | Неявная, обычно внешняя | Встроена в структуру |
| Типы | Слабые, обычно строки на диске | Встроенная поддержка чисел, булевых значений, массивов, объектов |
| Вложенные данные | Неудобно | Естественно |
| Читаемость для человека | Высокая для простых таблиц | Высокая для небольших объектов, низкая для больших массивов |
| Совместимость с таблицами | Отличная | Плохая |
| Совместимость с API | Плохая | Отличная |
CSV легко отображается на рабочие процессы с таблицами и SQL, потому что файл уже выглядит как таблица. JSON подходит для REST API и NoSQL-подобных данных, потому что записи могут различаться и быть вложенными. Это структурное несоответствие определяет всё остальное в статье. Если ваш конечный потребитель - это оператор таблиц или загрузчик SQL, CSV обычно не создаёт проблем. Если ваш конечный потребитель - это API-клиент или прикладной сервис, JSON обычно снижает трение.
В автоматизации через прокси это различие проявляется сразу. Экспорт рекламных аккаунтов часто начинается с плоских таблиц. Логи автоматизации браузера из таких инструментов, как AdsPower, Dolphin Anty, GoLogin, Multilogin или Hidemyacc, часто включают вложенные метаданные, которые CSV не может представить без решений по уплощению, о которых вы потом пожалеете. Формат, который соответствует структуре данных, экономит работу по очистке позже, и именно эту часть команды ощущают на практике.
Для более широкого рабочего процесса автоматизации управления аккаунтами это руководство по автоматизации с прокси находится в том же практическом пространстве, что и выбор формата, потому что обработка форматов и обработка трафика обычно ломаются вместе.
Размер, скорость парсинга и объём памяти
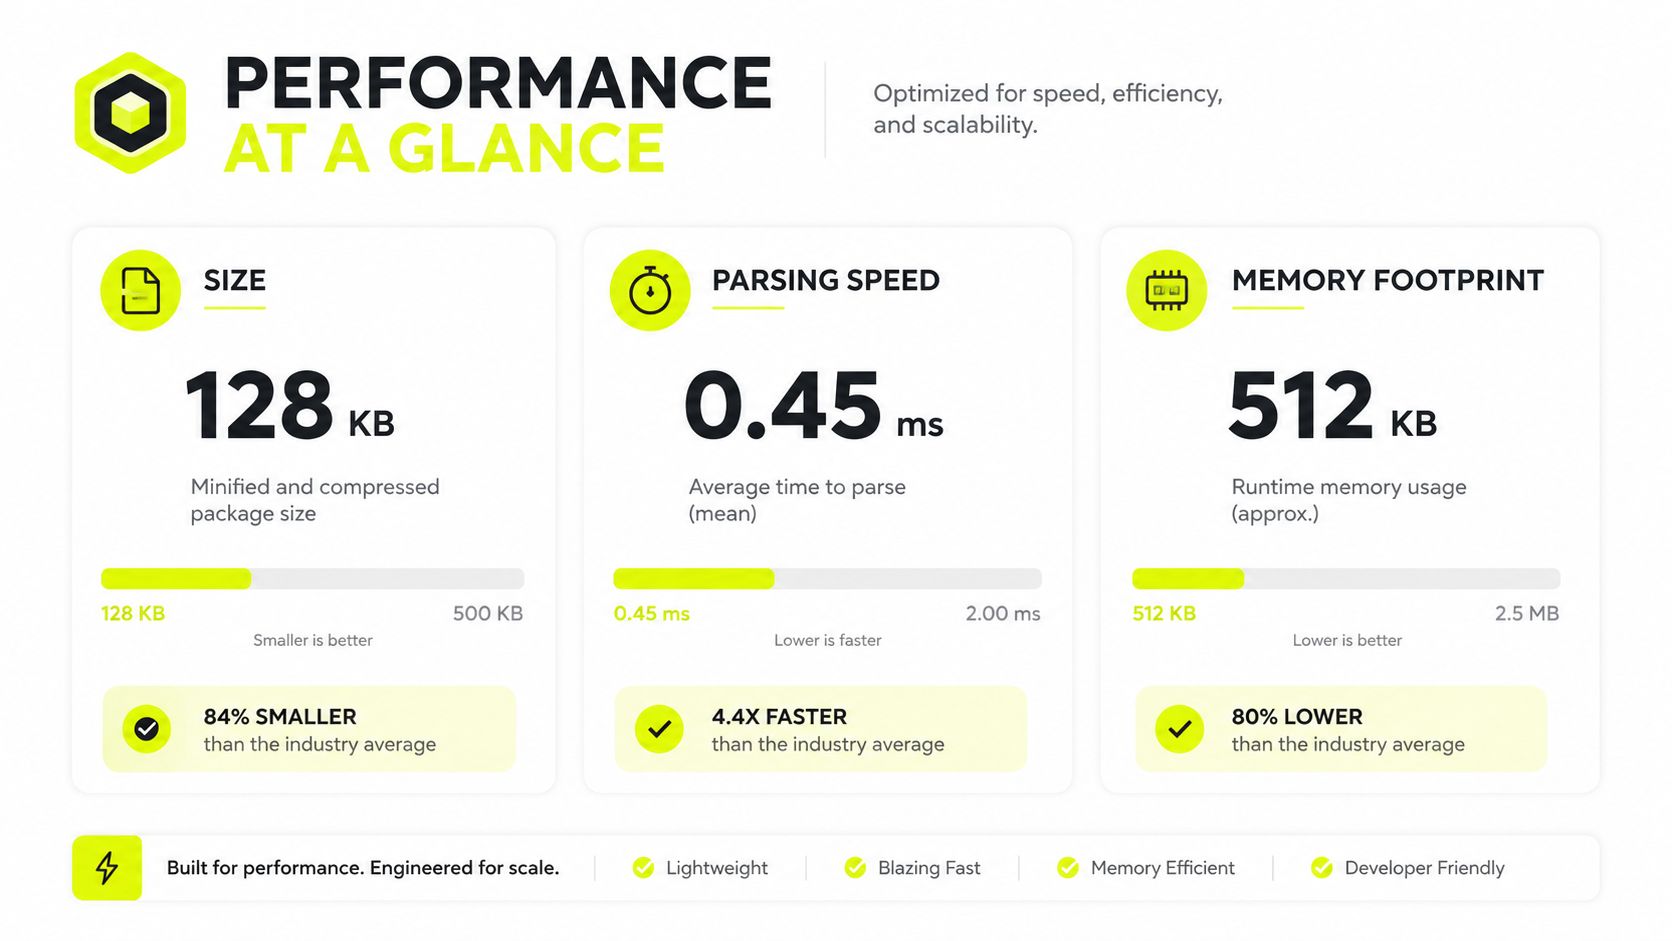
На плоских потоках данных CSV обычно выигрывает, потому что остаётся меньше по размеру и дешевле в парсинге. Одно опубликованное сравнение на наборе данных из 1 миллиона строк и 10 столбцов показало CSV размером 85 МБ и временем парсинга 2,3 секунды с использованием 120 МБ памяти, против JSON размером 210 МБ, 5,8 секунды и 340 МБ памяти. Тот же бенчмарк также показал более быстрый парсинг CSV в JavaScript, Python и Java на наборе из 100 000 строк, причём разрыв сохранялся на каждом языке. Этот разрыв быстро проявляется в воркерах скрейпинга, обработчиках логов прокси и задачах по обработке фидов кампаний, которые работают весь день.

Почему CSV обычно выигрывает на плоских потоках
CSV остаётся компактным, потому что не повторяет имена полей в каждой строке. JSON повторяет ключи и добавляет фигурные скобки, квадратные скобки и кавычки для каждой записи. Независимые сравнения часто показывают, что реальные JSON-файлы в 1,5–3 раза больше, чем эквивалентные CSV-файлы для сравнимых плоских данных, и один часто цитируемый пример показывает набор из 10 000 строк размером около 1 МБ в CSV против 2,5 МБ в JSON. Эта разница - накладные расходы на формат, а не магия в парсере.
Эти накладные расходы важны для геотаргетированных фидов кампаний и массового экспорта фарминга аккаунтов. Каждый лишний байт всё равно должен пройти через слои хранения, сети и парсинга. Если вы подаёте данные в очередь, воркер задач или загрузчик хранилища, CSV обычно создаёт меньше трения. Если вы отправляете вложенные объекты через API, JSON оправдывает себя читаемостью и структурой.
Практическое правило: для плоских таблиц используйте CSV по умолчанию, если только вложенность или совместимость с последующими системами не дают вам причину поступить иначе.
Сжатие меняет математику
Сжатие сокращает разрыв, потому что повторяющиеся ключи JSON хорошо сжимаются. Одно сравнение показывает разницу после сжатия примерно в 10–20%. Это не устраняет преимущество CSV, но меняет экономику для архивных файлов и долгосрочного хранения. Как только файл находится под gzip-подобным сжатием, реальные накладные расходы на передачу уменьшаются настолько, что ясность схемы может иметь большее значение, чем количество байтов.
Для пайплайнов обработки данных та же закономерность проявляется и в использовании токенов. Тестовый набор данных для LLM с примерно 5000 ячеек использовал на 56,20% меньше токенов в CSV, чем в JSON, при этом также улучшая точность и задержку в этом тесте. Это узкий бенчмарк, но он всё равно указывает на тот же операционный результат: плоские текстовые таблицы дешевле в обработке, когда данные плоские.
Для более широкого разбора компромиссов пропускной способности краулинга руководство по краулингу на Python является полезным дополнением к этому решению о формате, потому что объём краулинга и формат файла обычно сталкиваются с одними и теми же узкими местами.
Библиотеки для парсинга и фрагменты кода для конвертации
Стандартной библиотеки Python достаточно для базовой производственной работы. Для CSV csv.DictReader и csv.DictWriter покрывают большинство плоских экспортов. Для JSON json.load, json.dump, json.loads и json.dumps обрабатывают стандартные случаи. В Node обычно используют Papa Parse или csv-parse для работы с CSV. В Java OpenCSV - это обычная отправная точка, когда вам нужна простая обработка табличных данных.
Минимальное чтение и запись в Python
import csv
import json

# Чтение CSV
with open("input.csv", newline="", encoding="utf-8") as f:
    rows = list(csv.DictReader(f))

# Запись CSV
with open("output.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["campaign_id", "geo", "spend"])
    writer.writeheader()
    writer.writerow({"campaign_id": "1001", "geo": "US", "spend": "12.50"})

# Чтение JSON
with open("input.json", encoding="utf-8") as f:
    payload = json.load(f)

# Запись JSON
with open("output.json", "w", encoding="utf-8") as f:
    json.dump(payload, f, ensure_ascii=False, indent=2)
Подвох в том, что наивная конвертация из csv.DictReader в json.dump превращает всё в плоские строки, если вы явно не приводите типы. Она также теряет вложенные массивы, если вы уже плохо уплощили их раньше. Вот так команды получают сломанные булевы значения, строки дат повсюду и «таинственно» пропавшую структуру после шага конвертации.
Чистая конвертация CSV в JSON с вложенными полями
import csv
import json

def parse_tags(value):
    return [x.strip() for x in value.split("|") if x.strip()]records = []
with open("input.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        records.append({
            "campaign_id": int(row["campaign_id"]),
            "geo": row["geo"],
            "spend": float(row["spend"]),
            "flags": {
                "active": row["is_active"].lower() == "true",
                "tags": parse_tags(row.get("tags", "")),
            }
        })

with open("output.json", "w", encoding="utf-8") as f:
    json.dump(records, f, ensure_ascii=False, indent=2)
Этот паттерн лучше, потому что вы определяете типы данных до сериализации. Он также делает преобразование явным, что помогает, когда экспорты из фарминга аккаунтов или логи верификации рекламы должны пройти через несколько стадий пайплайна. Для практического пути интеграции с Python этот справочник по настройке соответствует тому же production-подходу.
Выбор формата под конкретную задачу в скрейпинге и ad ops
Правильный ответ меняется в зависимости от рабочей нагрузки. Массовая лента скрейпинга - это не то же самое, что отчёт о верификации рекламы, и оба эти случая отличаются от экспорта антидетект-браузера или потока прокси-логов. Выбор одного формата для всего обычно создаёт ненужные преобразования в дальнейшем.
Массовые ленты веб-скрейпинга
Используйте CSV, когда скрейпинг выдаёт строки со стабильным набором колонок. Продуктовые фиды, снимки цен, экспорты выдачи поисковиков и списки лидов обычно подходят под этот паттерн. CSV проще просматривать, проще сравнивать и менее болезненно загружать в базу данных или электронную таблицу.
Если скрейпер выдаёт страницы смешанных полезных нагрузок или потоковые события, используйте JSONL вместо единого JSON-массива. Это даёт построчный парсинг, который лучше подходит для длительных краулов. Внутренняя ссылка сценарии использования веб-скрейпинга здесь релевантна, потому что формат файла и стратегия работы с прокси обычно настраиваются вместе.
Отчёты о верификации рекламы для Facebook и TikTok
Используйте JSON, когда отчёт включает вложенные метаданные креативов, данные о размещениях или переменные объекты кампаний. Плоские снимки расходов всё равно могут попадать в CSV, особенно когда медиабайерам нужны быстрые фильтры в Excel или Google Sheets. Главное - не уплощать вложенные данные креативов только ради привычки к электронным таблицам.
Экспорты из фарминга аккаунтов для антидетект-браузеров
Для AdsPower, Dolphin Anty, GoLogin, Multilogin и Hidemyacc CSV обычно работает лучше всего для массовых экспортов профилей, отслеживания статуса профилей и таблиц передачи данных. Файл, как правило, ориентирован на строки, и операторам часто нужно сортировать, фильтровать и реимпортировать его без дополнительных инструментов. Держите кодировку строгой, а список колонок стабильным. Фарминг аккаунтов быстро ломается, когда «небольшое» изменение формата распространяется через общую таблицу.
Приём прокси-логов
Для высоконагруженных прокси-логов обычно больше смысла в JSONL или Parquet, чем в обычном JSON или CSV. JSONL поддерживает приём логов только на добавление. Parquet сильнее, когда архив логов превращается в проблему запросов к хранилищу. Если вы используете резидентные или мобильные прокси для задач, чувствительных к доверию, или дата-центровые и IPv6 для чистой пропускной способности, формат файла должен соответствовать той же операционной цели. Для архитектурной стороны этого решения это руководство по ETL против ELT - хорошее дополнение.
Экранирование, кодирование и ловушки безопасности
CSV ломается уродливыми способами, когда текстовые поля содержат запятые, переносы строк или кавычки. JSON ломается, когда предположения о кодировке расходятся, и парсер получает враждебный или некорректный текст. Оба формата могут взорваться в production, если вы обращаетесь с ними как с «просто текстом» и пропускаете валидацию.
Ловушки CSV, которые продолжают всплывать
Встроенная запятая внутри названия кампании может сдвинуть колонки. Перенос строки в поле заметок может разбить одну строку на две. Смешанные соглашения о кавычках могут сделать файл нечитаемым для одного парсера и «нормальным» для другого.
- Встроенные запятые и кавычки: используйте настоящий CSV-writer, а не конкатенацию строк.
- Переносы строк внутри полей: всегда открывайте файлы с явной обработкой переносов строк и корректно заключайте поля в кавычки.
- CSV-инъекция: добавляйте префикс к рискованным формулам электронных таблиц с безопасной стратегией экранирования, прежде чем кто-то откроет файл в Excel.
Ловушки JSON, важные в автоматизации
JSON строже в отношении структуры, но не застрахован от production-сбоев. Предположения о UTF-8 всё ещё могут сломаться, когда вышестоящие системы выдают битые байты. Большие полезные нагрузки также могут вызвать нагрузку на память, если вы загружаете их целиком, вместо потоковой обработки.
Парсите враждебные данные так, будто они созданы, чтобы сломать ваш парсер, потому что в конечном итоге кто-то передаст вам именно такой файл.
Здесь важна ловушка потоковой обработки. Файл, который выглядит управляемым по размеру, всё равно может убить воркер, если вы принудительно загрузите его полностью в память. Вот как скрейпинг превращается в OOM-крэш. Используйте потоковые парсеры, разделение на части или формат, ориентированный на строки, когда источник может расти без предупреждения.
Для полезной смежной ссылки по обработке потоков выбор между Yellowstone gRPC и парсенными потоками Solana показывает тот же инженерный инстинкт, а именно выбор транспорта и стратегии парсинга вместе, а не по отдельности.
Когда JSONL или Parquet лучше обоих
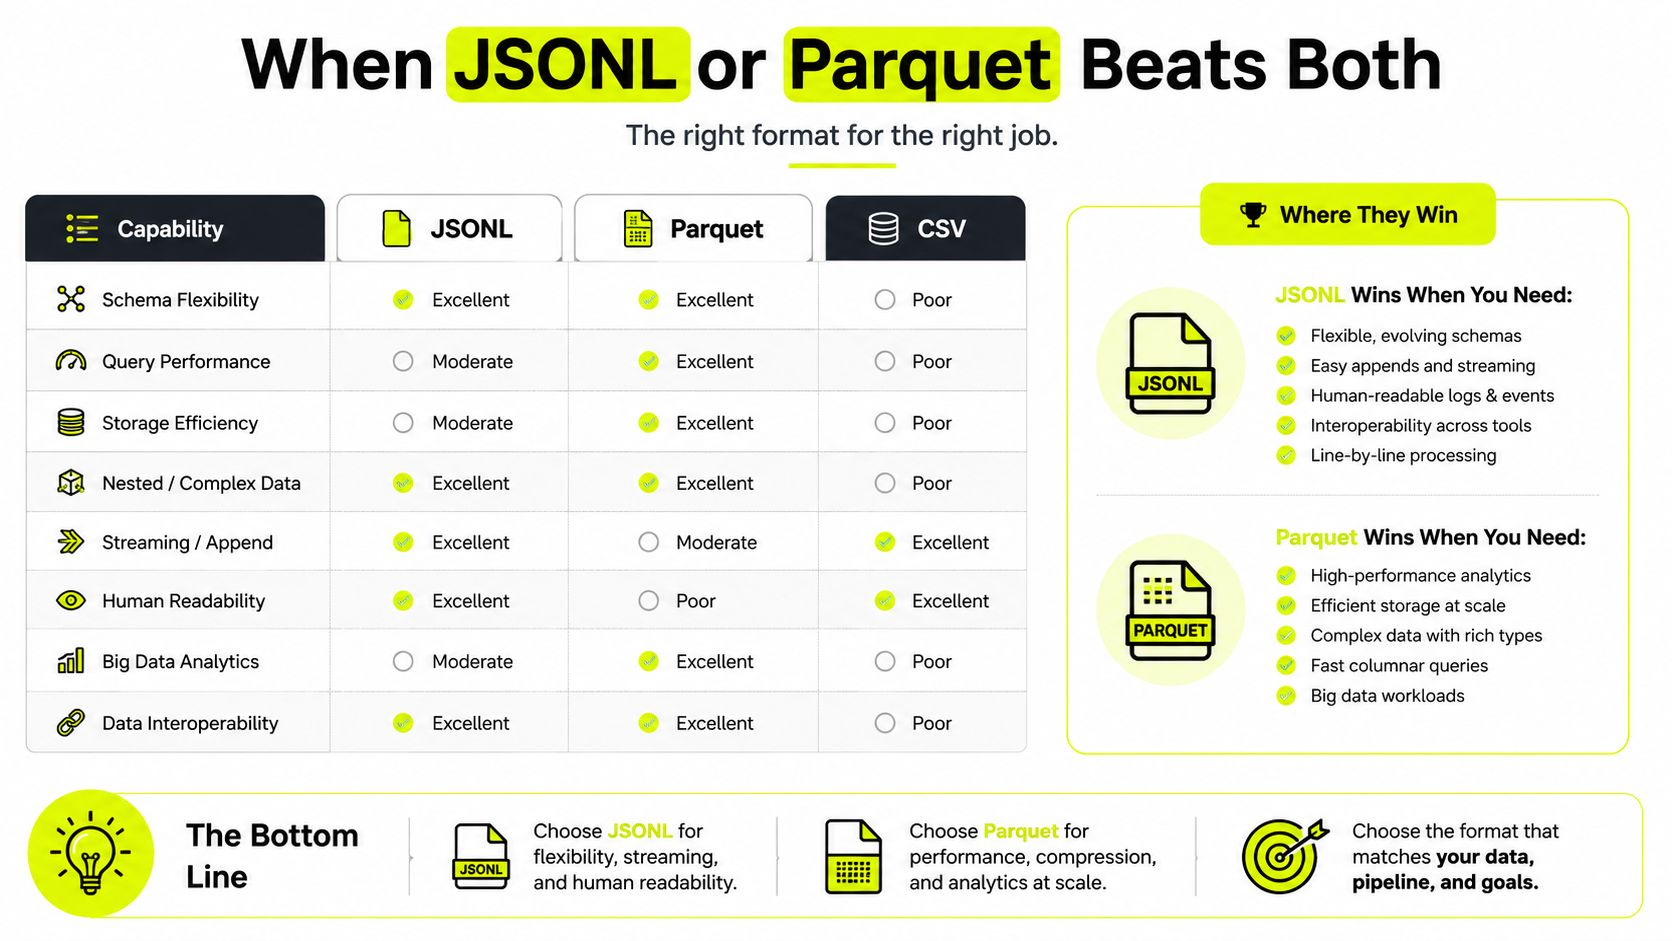
CSV и JSON используются слишком часто потому, что они знакомы, а не потому, что они всегда правильный выбор. Когда данные превращаются в поток или рабочую нагрузку хранилища, лучшим ответом часто оказывается ни тот, ни другой. JSONL решает проблему «мне нужно добавлять и читать по одной записи за раз». Parquet решает проблему «мне нужно компактное хранилище и быстрое аналитическое сканирование».
JSONL для потоков и логов
JSONL хранит один JSON-объект на строку. Это делает его идеальным для конвейеров логов, потоковых ответов API и лент только для добавления. Вам не нужно загружать весь файл перед началом обработки, и вы можете восстановить частичный прогресс после сбоя без повторного воспроизведения гигантского массива.
Parquet для аналитики
Parquet - это колоночный формат. Поэтому он лучше подходит для аналитических хранилищ, озёр данных и больших архивов скрейпинга, чем текстовые файлы с построчной организацией. Колоночное хранение обеспечивает лучшее сжатие и поведение запросов, когда вы постоянно сканируете одни и те же поля в больших наборах данных. Современные рекомендации по инженерии данных рассматривают Parquet как формат хранения, к которому следует обращаться, когда эффективность и масштаб важнее человеческой читаемости.
Практическое правило простое. Экспорт из электронной таблицы или SQL - выбирайте CSV. REST API или вложенная конфигурация - выбирайте JSON. Потоковые логи или ленты только для добавления - выбирайте JSONL. Аналитическое хранилище - выбирайте Parquet. Это соответствие полезнее, чем притворяться, что CSV и JSON покрывают любую серьёзную рабочую нагрузку.
Рекомендации в зависимости от конвейера и выбора прокси
Конвейеры скрейпинга должны начинаться с формата, который соответствует режиму отказа, который вы видите в продакшене. Для плоских лент CSV остаётся самым простым выбором, потому что операторы могут открыть его, отфильтровать и передать дальше без дополнительного кода парсинга. Как только лента превращается в поток, или записи поступают по одной и требуют безопасного для перезапуска приёма, JSONL подходит лучше. Если вывод направляется в хранилище, а не в быстрый отчёт, Parquet обычно стоит рассмотреть, прежде чем фиксировать текстовый архив.
Для отчётов о верификации рекламы в Facebook и TikTok используйте JSON для вложенных креативов, размещений и деталей аудита, и сохраняйте CSV для плоских снимков расходов или статусов. Это разделение сохраняет структуру там, где это важно, и избегает принуждения каждого последующего потребителя проходить по дереву документа только для чтения нескольких полей. Это также оставляет медиа-байеров в электронных таблицах для частей, которые они проверяют каждый день.
Для экспортов фарминга аккаунтов в AdsPower, Dolphin Anty, GoLogin, Multilogin и Hidemyacc CSV со строгой кодировкой UTF-8 является практическим стандартом. Эти задачи основаны на строках, и люди, работающие с ними, обычно хотят что-то, что они могут сортировать, импортировать и передавать без специальных инструментов. Если экспорт возвращается в автоматизацию, держите схему узкой, стабильной и скучной. Если вам также нужно выстроить транспортный уровень, сначала настройте прокси-слой, затем подстройте формат файла под него.
Для логов прокси JSONL работает лучше, когда логи интенсивно пополняются и требуют построчного парсинга. Parquet выигрывает, как только архив становится аналитической задачей, и скорость сканирования важнее человеческой читаемости. Резидентные или мобильные прокси подходят для рабочих процессов, которые зависят от сигналов доверия, особенно при клоакинге или работе с множеством аккаунтов. Дата-центровые и IPv6 прокси имеют больше смысла, когда пропускная способность и ротация важнее, чем выглядеть как потребительская сеть.
Если вы строите партнёрский рабочий процесс вокруг прокси-инфраструктуры, выберите архитектуру конвейера данных, прежде чем решать, как файлы будут перемещаться по нему. Те же команды, которые запускают скрейпинг, верификацию рекламы и мультиаккаунтные рабочие процессы, часто нуждаются в стабильной поставке прокси, и плохое сочетание формата и транспорта быстро превращается в беспорядочные повторы. Держите прокси-слой и слой данных согласованными, независимо от того, используете ли вы резидентные, мобильные, дата-центровые, ISP или IPv6 опции.
Похожие статьи

7 методов сбора данных для медиабайеров и фармеров
Изучите лучшие методы сбора данных для медиабайеров. Узнайте, как использовать скрейпинг, API и опросы для рекламных аккаунтов, фарминга аккаунтов и геотаргетинга.

7 бюджетных вариантов прокси в 2026 году
Изучите бюджетные варианты прокси. Техническое руководство по недорогим дата-центровым, резидентным и IPv6 тарифам для арбитража трафика, парсинга и фарминга аккаунтов.
Таргетинг по почтовым индексам для рекламных кампаний: практическое руководство
Таргетинг по почтовым индексам для медиабайеров и команд арбитража трафика. Рассматриваются настройка прокси, правила рекламных платформ, риски обнаружения и лучшие практики.

Круглосуточная поддержка клиентов: что действительно нужно операторам
Круглосуточная поддержка клиентов для операторов прокси и автоматизации. KPI, SLA, вопросы к вендорам и реальные процессы эскалации, которые сокращают простои.
Что такое прямой прокси (Forward Proxy): Полное руководство на 2026 год
Узнайте, что такое прямой прокси (forward proxy), как он работает для исходящего трафика и почему команды используют его вместе с антидетект-браузерами для Facebook, TikTok и парсинга.

Bing Search API ключ: настройка, тестирование и масштабирование в 2026 году
Получите рабочий Bing Search API ключ в 2026 году, протестируйте запросы, защитите ключ и масштабируйте высоконагруженный скрейпинг без блокировок. Практическое руководство для технических команд.