API для соціальних мереж: посібник для операторів і розробників
Технічний посібник з API для соціальних мереж. Дізнайтеся, як використовувати офіційні, неофіційні та скрейпінгові API для управління акаунтами, автоматизації та рекламних кампаній.
Ви вже знаєте сценарій провалу. Один байєр запускає рекламу у Facebook через AdsPower. Інший розгортає кампанії в TikTok з Dolphin Anty. Хтось прогріває резервні акаунти в GoLogin. Команда ферми ротує куки, креативи, проксі та лендінги через десятки профілів. Все працює, поки не з'являється обсяг.
У цей момент ручна робота перестає бути просто дратівливою і стає вузьким місцям. Люди пропускають коментарі, дублюють завантаження, спалюють рекламні акаунти, входячи з неправильного середовища, і втрачають контроль над тим, який геотаргетований креатив де вийшов у світ. Проблема не в зусиллях. Проблема в контролі.
Ось де API для соціальних мереж перестає бути абстракцією для розробників і стає операційною інфраструктурою. API соціальних мереж стали центральними для сторонньої автоматизації, коли платформи стандартизували доступ розробників до постів, профілів, коментарів, лайків і метрик залученості, завдяки чому сучасні системи управління можуть об'єднувати планування, звітність і маршрутизацію повідомлень між мережами з одного інтерфейсу, як описано в огляді API соціальних мереж від Data365.
Зміст
- Масштабування операцій у соціальних мережах за межами ручних кліків
- Офіційні vs неофіційні vs скрейпінгові стратегії API
- Навігація в автентифікації та платформних обмеженнях швидкості
- Основні ендпоінти API для автоматизації та управління
- Найкращі практики для побудови надійної автоматизації
- Роль проксі та антиблокувальних рішень
- Юридичні обмеження та умови використання платформ
Масштабування операцій у соціальних мережах за межами ручних кліків
П'ять рекламних акаунтів - це керовано. П'ятдесят - ні.
Команда трафік-арбітражу може силою прорватися на ранньому етапі зростання, призначивши людей на браузерні профілі, рекламні акаунти та сторінки в соцмережах. Один оператор керує сторінками Facebook в Multilogin. Інший ротує акаунти для постингу в TikTok через Hidemyacc. Третій перевіряє, чи правильно відображаються клоаковані сторінки для кожної цільової країни. Така схема працює тиждень. Потім помилки накопичуються.
Перша поломка зазвичай не технічна. Вона процедурна. Команди публікують не той креатив з неправильної сесії, повторно використовують прогрітий браузерний профіль для холодного акаунта або пропускають події у вхідних, які мали викликати реакцію чи паузу. Коли ви жонглюєте фармінгом акаунтів, верифікацією реклами, геотаргетованими кампаніями та дистрибуцією контенту, ручні кліки не масштабуються чисто.
Чому ручні операції не витримують
Кілька паттернів з'являються щоразу:
- Плутанина з сесіями: оператор відкриває неправильний профіль AdsPower або GoLogin і виконує чутливу дію на неправильному акаунті Facebook або TikTok.
- Відсутність центрального стану: ніхто не має достовірного погляду на те, що було опубліковано, відредаговано, оскаржено, призупинено чи на що відповіли.
- Лінійне кадрове забезпечення: кожна партія нових акаунтів потребує більше людей. Це не система. Це проблема чисельності.
Практичне правило: якщо завдання треба повторювати на багатьох акаунтах, багатьох гео або багатьох варіантах креативів - йому місце в коді.
API для соціальних мереж дає вам програмний контроль над повторюваним шаром. Ви можете стандартизувати публікацію, збирати сигнали залученості, маршрутизувати повідомлення, помічати збої та запускати сповіщення, не покладаючись на людей, які мають пам'ятати кожен крок. Це не прибирає антидетект-браузери зі стеку. Воно звужує їхню роль до дій, які все ще потребують повної браузерної сесії.
Де API вписуються в реальний стек оператора
Для більшості медіа-команд робоча розбивка виглядає так:
- Використовуйте браузерну автоматизацію для крихких дій: створення акаунтів, прогрів, апеляційні потоки, налаштування платежів і все, що залежить від живого рендерингу або JS-важкої поведінки.
- Використовуйте API для повторюваних дій: публікація, витягування метрик, синхронізація статусів і обробка вхідних або модераційних робочих процесів.
- Використовуйте скрейпінг обережно: переважно для зовнішньої верифікації, моніторингу конкурентів або покриття там, де офіційні поверхні відсутні. Якщо ваша команда займається цим, цей посібник про веб-краулінг на Python для масштабованого збору даних буде корисним супутником.
Суть не в тому, щоб все замінити на API. Суть у тому, щоб перестати витрачати хороших операторів на роботу, яку повинне володіти програмне забезпечення.
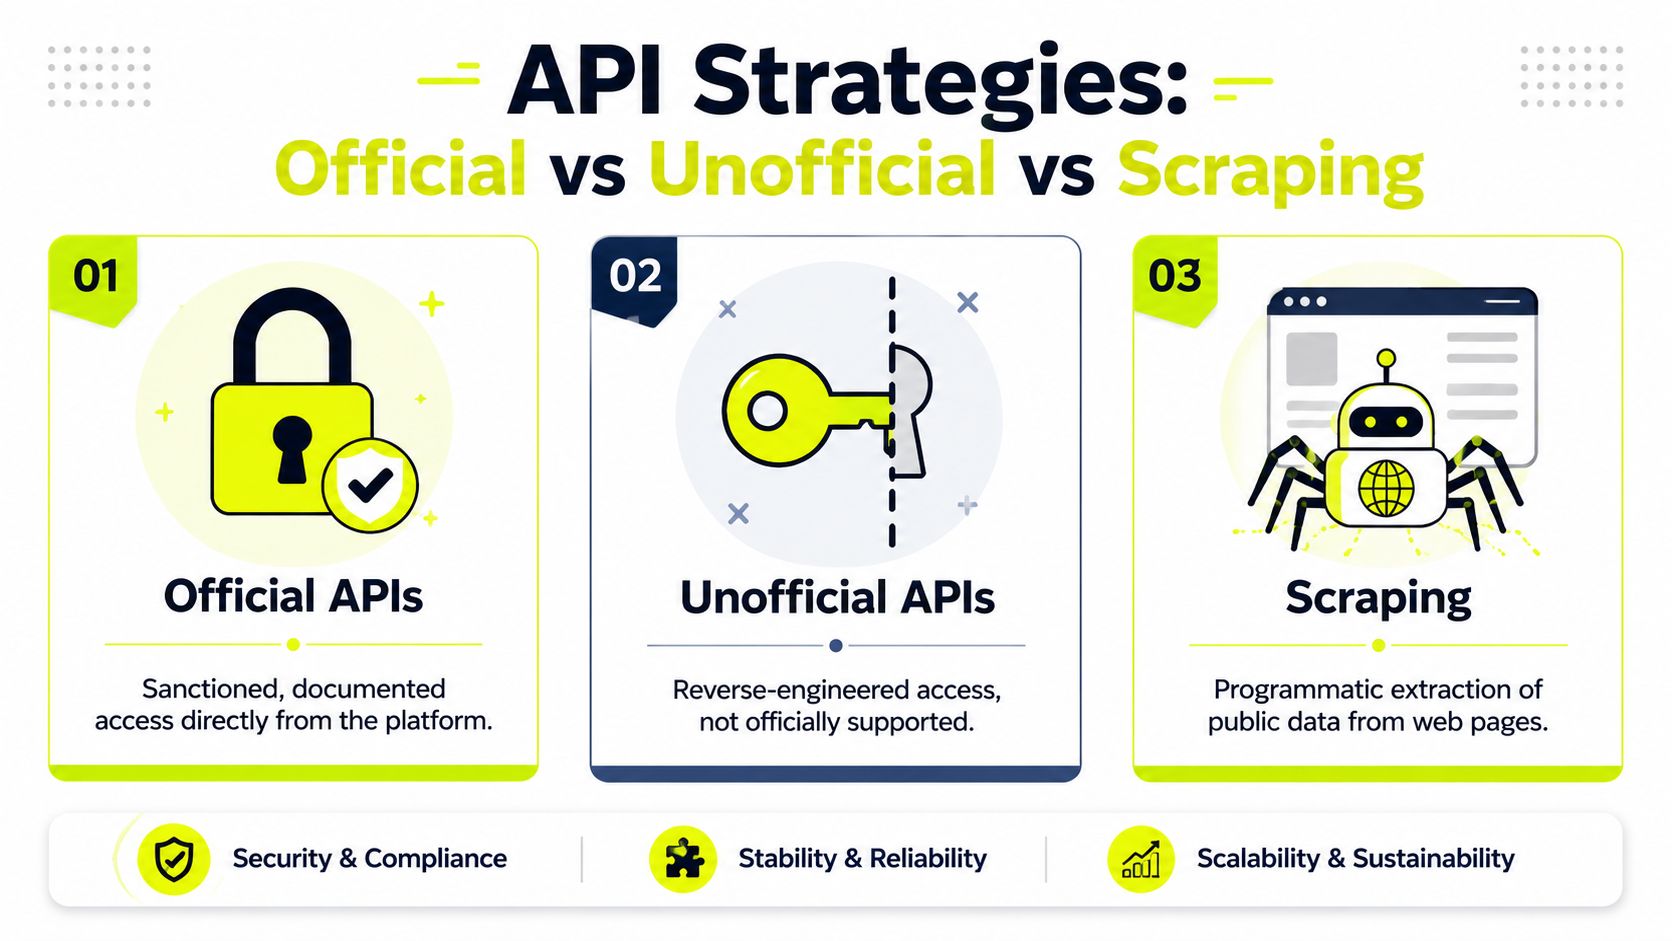
Офіційні vs неофіційні vs скрейпінгові стратегії API
Команди зазвичай не обирають один метод доступу назавжди. Вони обирають первинний метод, а потім додають винятки, коли прогалини в покритті або тиск масштабування змушують до цього.
Офіційні API для живучості
Офіційні API - найменш цікава опція і зазвичай найкращий фундамент. Вони існують не просто так. Платформи хочуть надати контрольований доступ до постів, медіа, аналітики, коментарів і вибраних поверхонь акаунтів, не даючи вам необмеженого охоплення їхніх систем.
Перевага - стабільність. Документація існує. Потоки аутентифікації задокументовані. Режими відмови передбачувані. Якщо ви керуєте брендованими сторінками Facebook, публікуєте контент TikTok, завантажуєте на YouTube або витягуєте дані про продуктивність у внутрішні дашборди, офіційні API - найчистіший шлях.
Недолік - контроль доступу та тиск квот. Ви не отримуєте все. Часто ви не отримаєте повну історичну глибину, яку хочете. Затвердження може бути повільним, і деякі ендпоінти заблоковані за перевірками, верифікацією бізнесу або обмеженнями продукту.
Уніфіковані API для швидкості
Постачальники уніфікованих API розташовуються між вашим додатком і кожною платформою. Цей проміжний шар може заощадити багато інженерного болю. Уніфіковані API соціальних мереж зменшують складність інтеграції, надаючи один REST-ендпоінт, який нормалізує платформо-специфічні формати та обробляє аутентифікацію для кожної платформи. Додаток надсилає один запит, тоді як уніфікований шар відображає його на власні правила кожної платформи, що дуже ефективно для кросплатформенної публікації, як пояснено в посібнику Zernio про API соціальних мереж.
Ця модель допомагає, коли вашій команді потрібен один планувальник, один менеджер кампаній або один бекенд звітності для кількох мереж. Вона також допомагає, якщо ви швидко будуєте внутрішній інструментарій і не хочете окремих інтеграцій для Instagram, LinkedIn, X, Pinterest і YouTube.
Використовуйте відео нижче, якщо хочете швидкий візуальний огляд перед оцінкою деталей реалізації.
Що не працює добре - це припускати, що уніфікований шар дає вам повну функціональну паритетність. Не дасть. Абстракція найсильніша для стандартної публікації та поширених читань. Вона слабшає, коли вам потрібні платформо-специфічні рекламні функції, незвичайні медіа-робочі процеси або граничні випадки модераційної логіки.
Неофіційні API та скрейпінг для граничного доступу
Неофіційні API та прямий скрейпінг існують, тому що оператори хочуть доступ, якого не надає офіційний шар. Це правда за більшістю великомасштабних налаштувань фармінгу акаунтів, верифікації реклами та моніторингу конкурентів.
Ось компроміс у простих термінах:
| Метод | Найкращий для | Що працює | Що ламається |
|---|---|---|---|
| Офіційний API | Довгострокова безпека акаунтів | Стабільна аутентифікація, задокументовані ендпоінти, відповідність платформі | Обмежене покриття, тертя при затвердженні |
| Уніфікований API | Швидша багатоплатформенна розробка | Одна схема, менше обслуговування, кросплатформенна публікація | Залежність від вендора, неповні граничні функції |
| Неофіційний або скрейпінг | Прогалини в даних і приховані поверхні | Ширша видимість, користувацьке вилучення, гнучкіші робочі процеси | Блокування, хибні дані, тиск фінгерпринтів, ризик порушення умов |
Якщо ви скрейпите публічні поверхні або зворотно проектуєте приватні виклики, ваш антиблокувальний шар має таке ж значення, як і ваш парсер. Браузерні фінгерпринти, тайминг запитів, геоконсистентність, стан кукі та довіра до IP - все це впливає на результати. Для команд, які тестують конвеєри вилучення, ця стаття про веб-скрейпінг на PHP в реальних умовах блокування актуальна.
Чим цінніші приховані дані, тим агресивніше платформи захищають шлях до них.
Для рекламних операцій звичайний паттерн простий. Будуйте свій хребет на офіційному доступі. Додавайте уніфіковані абстракції там, де вони економлять час інженерів. Торкайтеся неофіційних методів, лише коли можете дозволити собі операційний і політичний ризик.
Навігація в автентифікації та платформних обмеженнях швидкості
Команди рідко втрачають доступ до API, бо не можуть написати запит. Вони втрачають його через неохайну обробку токенів і немодельовані бюджети запитів.
Аутентифікація ламається нудними способами
Більшість продакшн-проблем навколо аутентифікації - самонанесені. Токени закінчуються. Потоки оновлення незаміченими відмовляють. Один сервіс правильно зберігає облікові дані, поки інший записує їх не в те середовище. Воркер повторює спроби зі старим bearer-токеном, поки акаунт не буде позначений.
Ви побачите ті самі будівельні блоки знову й знову:
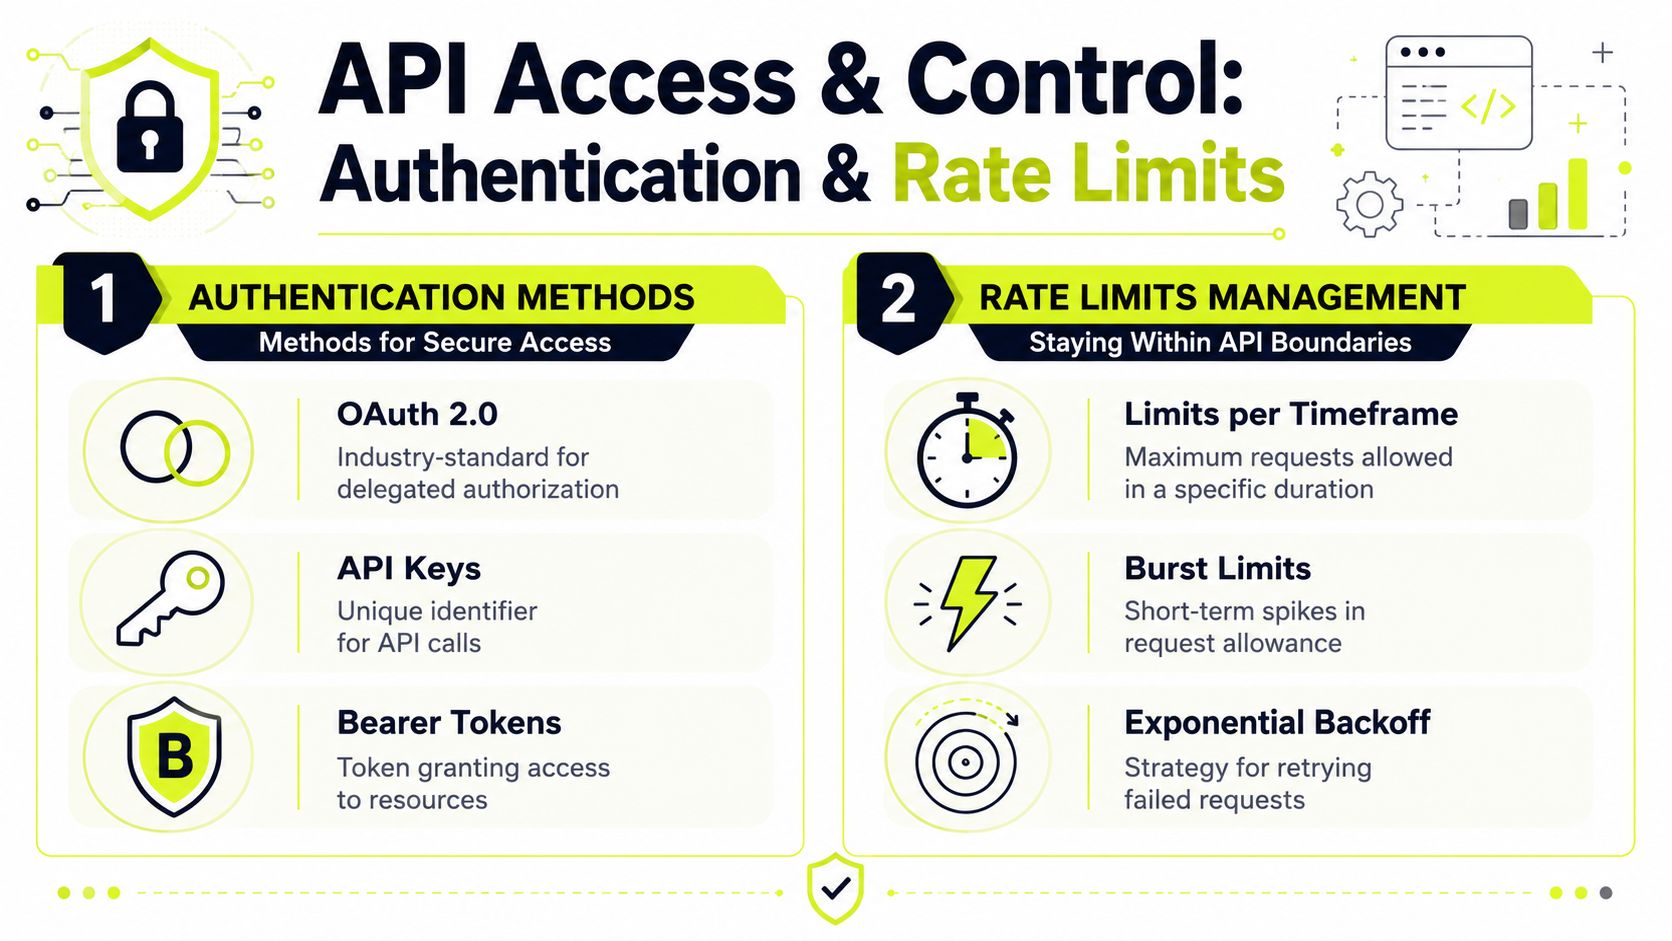
- OAuth 2.0: поширений, коли користувачі підключають акаунти та надають делегований доступ.
- API-ключі: корисні для ідентифікації на рівні додатка, але зазвичай недостатні для захищених дій користувача.
- Bearer-токени: стандарт для автентифікованих запитів після рукостискання.
Для команд арбітражу практичне занепокоєння - зіставлення токенів з правильною сутністю акаунта. Якщо ваша внутрішня система чітко не розділяє користувача, робочий простір, рекламний акаунт, сторінку, браузерний профіль і геопризначення, ви врешті-решт опублікуєте з неправильного активу або витягнете дані в неправильний клієнтський бакет.
Друга проблема з'являється, коли команди недбало змішують браузерні сесії та API-аутентифікацію. Оператор входить в актив TikTok або Facebook в Dolphin Anty, тоді як фонова задача використовує відключений стан токена для того самого активу. Ця невідповідність створює заплутане налагодження і може виглядати підозріло, коли дії не збігаються.
Обмеження швидкості визначають пропускну здатність
API соціальних мереж регулюються суворими обмеженнями. Graph API від Meta використовує динамічну модель, із прикладами як-от приблизно 200 × кількість користувачів та 4800 × кількість показів для деяких ендпоінтів Instagram. X зазвичай застосовує обмеження на основі ендпоінтів за 15-хвилинними вікнами, з багатьма ендпоінтами читання близько 300–900 запитів за вікно. Data API YouTube використовує стандартну квоту 10 000 одиниць на день. Pinterest задокументував 1000 запитів на день для пробного доступу та до 100 запитів на секунду на додаток користувача для стандартного доступу, згідно з розбивкою обмежень API соціальних мереж від GetStream.
Це означає, що скрипт, який працює на одній сторінці, може розвалитися, коли ви запускаєте його одночасно на багатьох акаунтах, багатьох креативах і багатьох завданнях звітності.
Операційна порада: ставтеся до обмежень швидкості як до розподілу бюджету, а не як до випадкових помилок.
Робочий контрольний цикл включає:
- Читайте заголовки обмежень, коли доступно. Зберігайте залишковий бюджет і час скидання централізовано.
- Чергу за сімействами ендпоінтів. Публікація, аналітика, коментарі та завантаження медіа не повинні конкурувати в одній смузі.
- Відступайте перед жорстким збоєм. Якщо залишок дзвінків низький, сповільніть воркерів замість того, щоб дозволити їм молотити в 429.
- Розділяйте термінові та масові завдання. Модерація коментарів і паузи кампаній потребують пріоритету над історичними синхронізаційними завданнями.
Команди, що будують моніторинг або парсери поряд із соціальними API, часто виграють від тієї самої дисципліни, що використовується в структурованих конвеєрах вилучення. Цей посібник про робочі процеси XML і Python для контрольованих завдань парсингу корисний, якщо ви проектуєте бюджетно-свідомих воркерів.
Що зазвичай працює
Стабільний паттерн нудний і надійний. Використовуйте короткочасний доступ там, де платформа цього очікує. Оновлюйте рано. Логуйте кожну невдачу аутентифікації з контекстом акаунта. Будуйте тротлери для кожної платформи, а не один глобальний перемикач повтору.
Що не працює - це робити вигляд, що обмеження не мають значення, бо у вас більше серверів. Платформні обмеження не хвилюються, скільки воркерів ви запускаєте.
Основні ендпоінти API для автоматизації та управління
Коли аутентифікація та квоти опрацьовані, наступне питання простіше. Які ендпоінти мають значення для операторів?
Ендпоінти публікації
Ендпоінти публікації - це очевидна відправна точка. Це маршрути, що створюють пости, завантажують медіа, планують контент, а іноді оновлюють або видаляють раніше опубліковані елементи.
Для трафікових команд публікація - це не просто соціальне планування. Це підтримуюча інфраструктура для:
- Геотаргетованого розповсюдження кампаній: просування локалізованих креативів на регіоноспецифічні сторінки чи профілі.
- Підтримки рекламних сторінок: утримання сторінок Facebook активними, щоб рекламні акаунти не вказували на мертві активи.
- Органічного посіву TikTok: надання контенту в теплі акаунти, прив'язані до платних воронок.
На практиці ви зазвичай надсилатимете JSON-пейлоади з текстом, посиланнями на медіа, ідентифікаторами цільових акаунтів і інструкціями планування. Важлива частина не сам пейлоад. Це побудова мапера, щоб кожен акаунт отримував правильну мову, варіант лендінгу та комплаєнс-безпечний креатив.
Ендпоінти читання та аналітики
Ендпоінти читання витягують дані профілю, стан постів, коментарі, поверхні підписників і вибрані метрики. Ендпоінти аналітики додають дані про залученість, стан доставки та пов'язані з кампанією сигнали там, де платформа їх відкриває.
Цей шар корисний для кількох реальних завдань:
- Верифікація постів: підтвердження, що актив опубліковано і не провалився в обробці.
- Маршрутизація модерації: приймання коментарів або повідомлень і пересилання їх до внутрішніх черг.
- Тріаж креативів: порівняння паттернів відгуку на рівні постів перед повторним використанням контенту на нових акаунтах.
Не очікуйте повної універсальності. Кожна платформа відкриває інший зріз реальності. Деякі повертають багаті об'єкти. Інші повертають лише мінімум, потрібний для простих дашбордів.
Вебхуки перемагають постійне опитування
Опитування працює на малому масштабі. Потім стає марнотратним.
Якщо платформа підтримує вебхуки, використовуйте їх для подій як-от нові коментарі, вхідні повідомлення та оновлення статусу постів. Дизайн на основі вебхуків зменшує шум, скорочує марнотратні запити та дає вашій команді швидші вікна реакції.
Опитуйте, коли потрібно. Підписуйтесь, коли можна.
Це має значення, коли одна модераційна черга підтримує багато сторінок Facebook, профілів TikTok і допоміжних брендових активів. Якщо ваша система чекає на цикли опитування, щоб виявити проблеми, оператори реагують пізно, а акаунти поглинають непотрібний ризик.
Найкращі практики для побудови надійної автоматизації
Більшість зламаної автоматизації не була амбіційною. Вона була недорозвиненою.
Багато команд пишуть щасливий шлях, тестують його на одному акаунті, а потім спрямовують на флот. Ось тоді вони виявляють прогалини пагінації, шторми повторів, дубльовані пости та конкурентність, яка перетворює незначне тротлінг на широке порушення акаунтів.
Спочатку пагінація
Якщо ендпоінт повертає списки, припускайте, що перша відповідь неповна. Коментарі, історії постів, рядки аналітики, треди вхідних і інвентарі акаунтів майже завжди пагінуються.
Будуйте обробку пагінації перш ніж вас хвилює швидкість.
- Потоки на основі курсора: точно слідуйте наступному токену, як повернуто.
- Потоки offset-limit: захищайтеся від пропущених або дубльованих рядків, якщо записи змінюються між запитами.
- Чекпоінтинг: зберігайте прогрес, щоб довготривалі синхронізації могли відновлюватися замість перезапуску.
Це має значення для команд арбітражу, які одночасно аудитують багато сторінок підтримки або багато активів воронок. Частковий набір даних може призвести до неправильних рішень, таких як думка, що модераційна черга порожня або пакетна публікація провалилася, коли пізніші сторінки просто не були витягнуті.
Логіка повтору, яка не завдає більшої шкоди
Повтори потребують судження. Тимчасовий тайм-аут мережі і жорстка помилка дозволу - це не одне й те саме.
Використовуйте просту класифікаційну модель:
| Тип помилки | Правильна відповідь |
|---|---|
| Тимчасова проблема мережі | Повторити із затримкою |
| Відповідь про обмеження швидкості | Відступити та перечергувати |
| Недійсна аутентифікація | Оновити токен або вимагати повторної аутентифікації |
| Відмова в дозволі | Зупинити та ескалювати |
| Збій валідації | Виправити пейлоад, не повторювати наосліп |
Експоненційний відступ досі найбезпечніше загальне правило. Додайте джиттер, щоб великі пули воркерів не повторювали синхронно. Обмежте кількість повторів для дій запису. Дубльоване аналітичне читання дратує. Дубльована публікація може створити видимий безлад на живих активах.
Для команд, що борються з блокуваннями на суміжних завданнях краулінгу та верифікації, мислення перетинається зі стандартною практикою анти-бану. Ця стаття про як уникнути IP-банів під час автоматизованої активності добре поєднується з дизайном повтору API, бо обидва залежать від темпу та чистої обробки збоїв.
Конкурентність зі стриманістю
Конкурентність корисна, поки не перестає виглядати як нормальна поведінка.
Кілька практичних обмежень допомагають:
- Шардуйте за акаунтом або робочим простором: не дозволяйте одному галасливому клієнту морити всіх інших голодом.
- Розділяйте читання від записів: читання метрик і публікація медіа створюють різні профілі ризику.
- Використовуйте ключі ідемпотентності де можливо: особливо для викликів публікації та оновлення.
- Тротліть чутливі дії жорсткіше: надсилання повідомлень, дії з коментарями та повторні правки викликають увагу швидше за звичайні читання.
Що працює - це вимірювана пропускна здатність. Що ламається - це спроба змусити соціальні платформи поводитися як внутрішні мікросервіси. Вони не побудовані для вашої зручності. Вони побудовані, щоб захищати платформу насамперед.
Роль проксі та антиблокувальних рішень
Якщо ви працюєте з багатьма акаунтами, шар API - лише частина картини. Інша частина - чи вірять платформи, що навколишня активність послідовна.
Ось чому серйозні команди відокремлюють автоматизацію API від управління ідентичністю. API обробляють повторювану машинну роботу. Антидетект-браузери обробляють дії, які все ще потребують повного браузерного контексту. Проксі склеюють шар ідентичності так, щоб сторінки Facebook, рекламні акаунти TikTok, теплі профілі та підтримуючі активи не обвалювались в один видимий мережевий паттерн.
Для чого насправді підходить кожен тип проксі
Різні типи проксі вирішують різні проблеми. Ставлення до них як до взаємозамінних - один з найшвидших способів спалити акаунти.
| Тип проксі | Первинний варіант використання | Оцінка довіри | Вартість | Ключова слабкість |
|---|---|---|---|---|
| Резидентні | Створення акаунтів, управління акаунтами, консистентність входу, доступ до рекламних акаунтів | Висока | Вища | Дорожчі для важких масових завдань |
| Мобільні | Чутливі дії в Instagram, TikTok і високофрикційні потоки прогріву | Дуже висока | Найвища | Вартість і нижчий контроль пропускної здатності |
| Датацентр | Швидкий скрейпінг, нечутливі перевірки, внутрішній інструментарій, масове витягування | Нижча | Низька | Платформам легше класифікувати |
| IPv6 | Дешевий масовий збір на цілях, що його підтримують | Нижче-середнє | Низька | Багато платформ і сервісів все ще ставляться до нього непослідовно |
Резидентні проксі - стандарт для серйозної роботи з акаунтами, тому що IP виглядають як справжній користувацький трафік. Якщо ви керуєте рекламними акаунтами Facebook, старієте ідентичності TikTok або входите в активи через AdsPower або Multilogin, резидентні зазвичай безпечніша базова лінія.
Мобільні проксі сильніші для крихких дій. Платформи часто трактують трафік мобільних операторів як нормальну споживчу поведінку. Тому команди використовують їх для прогріву, відновлення або дій, що постійно провалюються на слабших класах IP.
Датацентрові проксі все ще корисні. Вони швидкі, дешеві та легко масштабуються для нечутливих завдань як-от перевірки публічних сторінок, QA або збору даних, не прив'язаних до акаунта. Вони неправильний інструмент для більшості фармінгу акаунтів або високоцінного управління акаунтами.
IPv6 має місце в масовій роботі, де ціль його добре підтримує. Він може бути економічно вигідним для скрейпінгу та завдань широкого охоплення. Він рідко перший вибір для чутливих операцій із соціальними акаунтами.
Хороший проксі - не той, що з найкращим маркетингом. Це той, що відповідає вимогам довіри дії.
Фінгерпринтинг та ізоляція сесій
Сам проксі не врятує погане налаштування. Якщо браузерний фінгерпринт, часовий пояс, мова, поведінка WebRTC, історія кукі та IP-географія всі суперечать один одному, акаунт все одно виглядає неправильно.
Тому оператори поєднують проксі з антидетект-браузерами як-от AdsPower, Dolphin Anty, GoLogin, Multilogin і Hidemyacc. Кожен акаунт отримує свій власний браузерний профіль, локальне сховище, куки, поведінку canvas і апаратний фінгерпринт. Зроблено правильно, це створює ізольовані середовища для:
- Рекламних акаунтів Facebook, прив'язаних до конкретних бізнес-менеджерів
- Рекламних акаунтів TikTok, приєднаних до окремих креативних конвеєрів
- Фармлених сторінок підтримки, що використовуються в клоакуванні або шляхах затвердження
- Геотаргетованих кампаній, що потребують точного за країною рендерингу та перегляду
Ключ - послідовність. Тримайте IP-географію вирівняною з історією акаунта. Не стрибайте прогрітим акаунтом по неспорідненим країнам. Не відкривайте той самий актив із робочих процесів на основі API, що імплікують один регіон, і браузерних сесій, що імплікують інший. Не змішуйте чисте управління сторінками підтримки з агресивним скрейпінгом з того самого пулу ідентичності.
Стратегія ротації також має значення. Липкі сесії допомагають, коли важлива безперервність акаунта. Часта ротація допомагає, коли ви збираєте публічні дані в масштабі. Якщо ваша команда налаштовує ці компроміси, цей посібник про ротацію IP проксі для автоматизаційних навантажень варто прочитати.
Деякі оператори також компенсують витрати на проксі, рекомендуючи інші команди, коли вони визначаються зі стеком провайдерів. Якщо це має значення у вашій бізнес-моделі, програми, що пропонують до 40% комісії, можуть перетворити рефералів інфраструктури на побічну лінію доходу. Це не виправить погані операції, але може зменшити тиск витрат на інструментарій.
Юридичні обмеження та умови використання платформ
Багато операторів думають, що єдине справжнє питання - чи працює метод. Такий підхід коштує дорого.
Краще питання - чи працює метод достатньо довго, під правильним ризиковим конвертом, не збиваючи акаунти, клієнтів або інфраструктуру, приєднану до нього. Фармінг акаунтів, клоакування, багатоакаунтне управління та агресивне вилучення даних - усе це знаходиться в спектрі платформної толерантності. Деякі тактики просто крихкі. Інші - прямі порушення умов.
Найшвидший метод масштабування може бути найкоротшим
Найважчий компроміс у роботі з API для соціальних мереж не технічний. Це доступ проти відповідності.
Недавні рекомендації попереджають, що отримання даних поза офіційними каналами API може входити в юридичні сірі зони і може порушувати умови платформи, і що команди все частіше стикаються з вибором між відповідними, але обмеженими офіційними API та ширшим охопленням, що супроводжується обмеженнями політики та надійності, згідно з приміткою Університету Бата про обмеження API та дослідницький доступ.
Це має значення далеко за межами наукових досліджень. Воно безпосередньо торкається комерційних операторів, коли вони скрейпять публічні стрічки, зворотно проектують приватні ендпоінти або будують автоматизацію, що імітує стандартну користувацьку поведінку для обходу опублікованих обмежень.
Що призводить до блокування команд
Більшість довгострокової шкоди виникає від наслідування паттернів. Одна агресивна тактика може вижити сама по собі. Кілька разом створюють чіткий сигнал.
Поширені тригери включають:
- Фармінг акаунтів без ізоляції: багато акаунтів створено або керовано з перетинаючими сигналами пристрою та мережі.
- Клоакування з непослідовними шляхами перегляду: рецензенти бачать один досвід, тоді як користувачі з платного трафіку бачать інший.
- Незатверджена автоматизація обмежених дій: особливо обмін повідомленнями, роздування залученості або повторні правки в масштабі.
- Комерційний скрейпінг, що ігнорує межі платформи: навіть коли фронт-енд дані виглядають публічними.
Якщо ви проводите геотаргетовані кампанії, будьте особливо обережні з місцевими правилами конфіденційності та обробкою згоди. Соціальна автоматизація часто торкається користувацьких даних, коментарів, повідомлень і метаданих профілю. Ваш код не стає відповідним лише тому, що ендпоінт повертає пейлоад.
Якщо втрата активу завдасть шкоди доходу, не тестуйте юридичні межі на цьому активі.
Розумні команди ізолюють ризик за призначенням. Вони тримають основні рекламні операції чистішими за експериментальний збір даних. Вони відокремлюють управління сторінками підтримки від інфраструктури скрейпінгу. Вони уникають прив'язування своїх найцінніших рекламних акаунтів Facebook і TikTok до тих самих середовищ, що використовуються для збору в сірій зоні або клоакованих потоків перегляду.
Команди, що тривають - не ті, що автоматизують найбільше. Вони ті, що знають, де автоматизація перестає бути ефективною і починає ставати доказом.
Якщо ваш стек залежить від стабільних IP, чистого геотаргетування та ізольованих сесій у антидетект-браузерах, Sota Proxy побудований для такого роду навантажень. Він підтримує управління акаунтами, верифікацію реклами, скрейпінг і багатоакаунтні операції з резидентними, мобільними, ISP, датацентровими та IPv6 опціями. Якщо ви вже працюєте з іншими байєрами або командами ферм, Sota Proxy також має партнерську програму з до 40% комісією за рефералів.
Схожі статті

Bing Search API ключ: налаштування, тестування та масштабування у 2026 році
Отримайте робочий Bing Search API ключ у 2026 році, тестуйте запити, захистіть ключ та масштабуйте високонавантажений скрейпінг без блокувань. Практичний посібник для технічних команд.

10 способів збору якісних даних для медіабаєрів
Відкрийте для себе 10 способів збору якісних даних від ваших користувачів. Вивчіть методи, такі як інтерв'ю та фокус-групи, для оптимізації використання проксі та стратегії кампаній.
Для чого використовується проксі: Гід з арбітражу 2026
Для чого використовується проксі - Дізнайтеся, для чого використовується проксі у 2026 році, від підвищення безпеки до управління мультиакаунтними операціями для арбітражних команд
ERR_TUNNEL_CONNECTION_FAILED: назва помилки вже є діагнозом
Chrome попросив проксі-сервер відкрити CONNECT-тунель, і це не вдалося. Ось і вся помилка. Звідки береться проксі, коли ви його не налаштовували, шість причин, чому налаштований проксі викликає цю помилку, і чому очищення кешу нічого не виправляє.
Найдешевші резидентські проксі 2026 року: які підводні камені ховає кожен провайдер
Перевірені ціни за гігабайт з офіційних сторінок п'яти постачальників, а не з торішніх оглядів. Чому заявлена ціна майже ніколи не є вхідною, які провайдери встановлюють мінімальний місячний поріг оплати і як розрахувати реальну вартість гігабайта.
Скільки акаунтів Telegram можна мати у 2026 році (і що насправді означає «обмежений»)
Telegram не публікує ліміту на кількість акаунтів, один номер на акаунт, а власні FAQ про спам стверджують, що обмежений акаунт може писати всім, хто зберіг ваш номер. Що саме провокує обмеження, чому VOIP-номери блокуються ще до першого повідомлення і чому дострокового зняття обмежень не існує.