Comprender la investigación de mercado: Manual del comprador de medios
Domina la comprensión de la investigación de mercado para compradores de medios y arbitraje. Aprende recopilación de datos con proxies, análisis de campañas y errores a evitar en 2026.
Lanzas una campaña geo-dirigida en Facebook hacia un mercado que parecía económico sobre el papel. Los CPM se disparan, la calidad de aprobación cae, y las cuentas empiezan a envejecer mal. O cultivas un lote limpio de perfiles de TikTok en AdsPower, solo para ver cómo la confianza colapsa después de que la plataforma cambia las reglas de detección. Este resultado frecuentemente se ve como mala suerte.
Generalmente no lo es.
Para los operadores, comprender la investigación de mercado no tiene nada que ver con reportes académicos o presentaciones pulidas. Es la disciplina de aprender qué hará un mercado, plataforma o audiencia antes de quemar presupuesto, perder cuentas o escalar hacia un ángulo muerto. En el arbitraje de tráfico, la investigación de mercado está dentro de las operaciones diarias. Afecta qué geo pruebas, en qué pool de proxies confías, cómo validas flujos de cloaking, y si tus datos extraídos reflejan usuarios reales o simplemente el sesgo de tu propia infraestructura.
Tabla de contenidos
- Por qué la investigación de mercado importa para el arbitraje y las operaciones de cuentas
- Redefiniendo objetivos de investigación para equipos técnicos
- Metodologías centrales para la adquisición de datos digitales
- Automatizando la recopilación de datos con proxies y scrapers
- Analizando datos para insights accionables de campaña
- Navegando obstáculos técnicos y sesgos de datos
- Líneas legales y éticas en operaciones basadas en datos
Por qué la investigación de mercado importa para el arbitraje y las operaciones de cuentas
Muchas campañas fallidas se culpan a los creativos, el seguimiento o la disciplina de compra de medios. A veces es cierto. Pero muchas pérdidas comienzan antes, en la capa de investigación.
Si tu equipo no sabe cómo se ve un funnel en una geo objetivo, qué están promoviendo los competidores locales, cómo se comportan las aprobaciones de anuncios según el tipo de cuenta, o cómo ven los usuarios la página desde una conexión residencial, estás comprando a ciegas. Lo mismo aplica al cultivo de cuentas. Cuando los activos cultivados mueren rápidamente, los operadores a menudo ajustan rutinas de calentamiento o huellas de navegador en Dolphin Anty, GoLogin, Multilogin o Hidemyacc. También deberían preguntarse si las suposiciones iniciales del mercado estaban equivocadas.
La investigación es una función operacional
La investigación de mercado importa porque protege el margen y la calidad de activos. Te dice dónde está aumentando la saturación, qué ángulos están ya sobreutilizados, dónde se rompen las rutas de cloaking, y si tus campañas geo-dirigidas se ven normales desde el lado de la audiencia.
Aproximadamente el 80% de las empresas a nivel mundial realizan investigación de mercado para recopilar información sobre rendimiento, clientes, tendencias y competidores, lo que muestra cuán estándar se ha vuelto esta práctica en las operaciones digitales, no solo en equipos empresariales tradicionales (Salesforce sobre cómo realizar investigación de mercado). En arbitraje, ese mismo hábito se aplica a la validación de ofertas, verificación de anuncios, verificaciones de precios, extracción de SERP y monitoreo de competidores locales.
Si estás mapeando flujos de trabajo en torno a casos de uso de proxies para investigación de mercado, el punto no es recopilar más datos. El punto es recopilar datos que cambien la siguiente decisión.
Regla práctica: Si un paso de investigación no reduce el desperdicio de gasto, mejora la supervivencia de cuentas o afina la segmentación geo, probablemente es ruido.
Cómo se ve una mala investigación en la práctica
La mala investigación de mercado dentro de un equipo de compra generalmente se muestra así:
- Se escala la geo incorrecta: Viste baja competencia desde un conjunto de extracción limitado, pero la presión publicitaria local ya era fuerte.
- La verificación de anuncios te miente: Revisaste la página a través del tipo incorrecto de IP, por lo que la ruta del usuario se veía limpia cuando la audiencia real vio algo diferente.
- Las operaciones de cuenta se malinterpretan: Un problema de TikTok o Facebook se culpa a la configuración del navegador, mientras que el problema real es un comportamiento inconsistente del lado del mercado en diferentes regiones.
- El cloaking se prueba en el vacío: El cloaker funciona contra una ruta de inspección, luego falla bajo diferentes condiciones regionales.
Los buenos operadores no separan la investigación de la ejecución. La tratan como la primera parte de la ejecución.
Redefiniendo objetivos de investigación para equipos técnicos
La mayoría de los consejos sobre investigación de mercado hablan de conciencia, sentimiento y buyer personas. Eso es demasiado suave para equipos que gestionan cuentas de anuncios de Facebook, gasto en TikTok, flotas de scrapers y cultivo de cuentas.
Los equipos técnicos necesitan objetivos de investigación que puedan impulsar una acción directa. No preguntas amplias. Específicas.
Comienza con una pregunta operacional
Un objetivo de investigación útil comienza con un problema de producción. Si una campaña se estanca en Alemania, el objetivo no es "entender mejor el mercado". Es más como esto:
- ¿Cuáles tres hooks de VSL aparecen con más frecuencia en funnels de competidores activos para esta categoría de oferta?
- ¿Qué elementos de la landing page cambian entre una visita residencial limpia y una visita desde datacenter?
- ¿Cambia el comportamiento de aprobación de TikTok cuando el perfil del navegador en AdsPower no coincide con el entorno del proxy?
- ¿Qué geo tiene la menor saturación para este ángulo mientras sigue apoyando la salud estable de cuentas?
- ¿Se mantiene el cloaking bajo verificación repetida desde rutas residenciales y móviles mixtas?
Esas preguntas son suficientemente estrechas para responder. También producen algo sobre lo que tu equipo puede actuar hoy.
Traduce el lenguaje empresarial a KPIs de operador
El lenguaje de objetivos tradicional todavía tiene valor, pero los operadores deben reescribirlo en tareas medibles.
| Objetivo genérico | Versión de operador |
|---|---|
| Entender competidores | Extraer landers activos, identificar reclamos repetidos, comparar estructura de CTA localizado |
| Mejorar segmentación | Validar la entrega de campaña geo-dirigida por ciudad y tipo de IP |
| Reducir riesgo de cumplimiento | Verificar comportamiento de cloaking contra múltiples perfiles de dispositivo y ubicación |
| Mejorar rendimiento de cuentas | Rastrear salud de cuentas por configuración de navegador, duración de sesión y consistencia de IP |
El punto es vincular cada brief de investigación a uno de tres resultados: lanzar, bloquear o cambiar.
Construye preguntas alrededor de restricciones
Los equipos fuertes no definen objetivos en abstracto. Los definen alrededor de lo que pueden recopilar.
Por ejemplo, si estás ejecutando verificación de anuncios en Facebook y TikTok, es posible que ya tengas contenedores de navegador en Dolphin Anty o GoLogin, una política de rotación, registros de scraper, notas de aprobación y capturas de pantalla locales. Eso es suficiente para hacer mejores preguntas que muchos otros equipos.
Usa un filtro simple:
- ¿Podemos recopilarlo limpiamente?
- ¿Podemos compararlo entre geos o grupos de cuentas?
- ¿Cambiará la respuesta la asignación de presupuesto, el manejo de cuentas o la configuración del funnel?
Si la respuesta a la tercera pregunta es no, descártalo.
La investigación se vuelve costosa cuando los equipos recopilan porque pueden, no porque el resultado cambie la compra u operaciones.
Buenos objetivos para casos de uso reales de operador
Para equipos técnicos, estos son los tipos de objetivos que vale la pena mantener:
- Análisis de funnel de competidores: Comparar ángulos de anuncios visibles, estructuras de prelander y encuadre de oferta por país.
- Mapeo de detección de plataforma: Rastrear dónde Facebook y TikTok empiezan a señalar inconsistencia en la configuración de cuenta, navegador e IP.
- Validación de cloaking: Probar qué ven los revisores, usuarios y rutas de automatización bajo diferentes condiciones.
- Control de calidad de cultivo de cuentas: Observar cómo se comportan los activos bajo diferentes configuraciones de timing de sesión e identidad.
- Verificación de campaña geo-dirigida: Confirmar que los usuarios locales reciben el anuncio, la página y la experiencia localizada que crees que estás sirviendo.
Los objetivos de investigación débiles crean dashboards bonitos. Los fuertes te detienen de escalar basura.
Metodologías centrales para la adquisición de datos digitales
Un comprador verifica un funnel de competidor desde Berlín en una configuración, luego verifica el mismo funnel desde Madrid en otra. La versión de la página cambia, el bloque de precios se mueve, y los comentarios del anuncio se ven más limpios de lo que se veían una hora antes. Si la mezcla de proxies, la identidad del navegador y el método de recopilación son inconsistentes, el equipo no está investigando el mercado. Está investigando sus propios errores de configuración.
Esa es la diferencia de la que los equipos técnicos necesitan preocuparse. Para el arbitraje y el cultivo de cuentas, el problema no es solo la precisión de los datos. Es la representatividad de los datos. Si tu ruta de recopilación no coincide con el usuario, revisor o estado de plataforma que quieres observar, tu muestra de investigación ya está distorsionada antes de que comience el análisis.
Métodos primarios en flujos de trabajo de operador
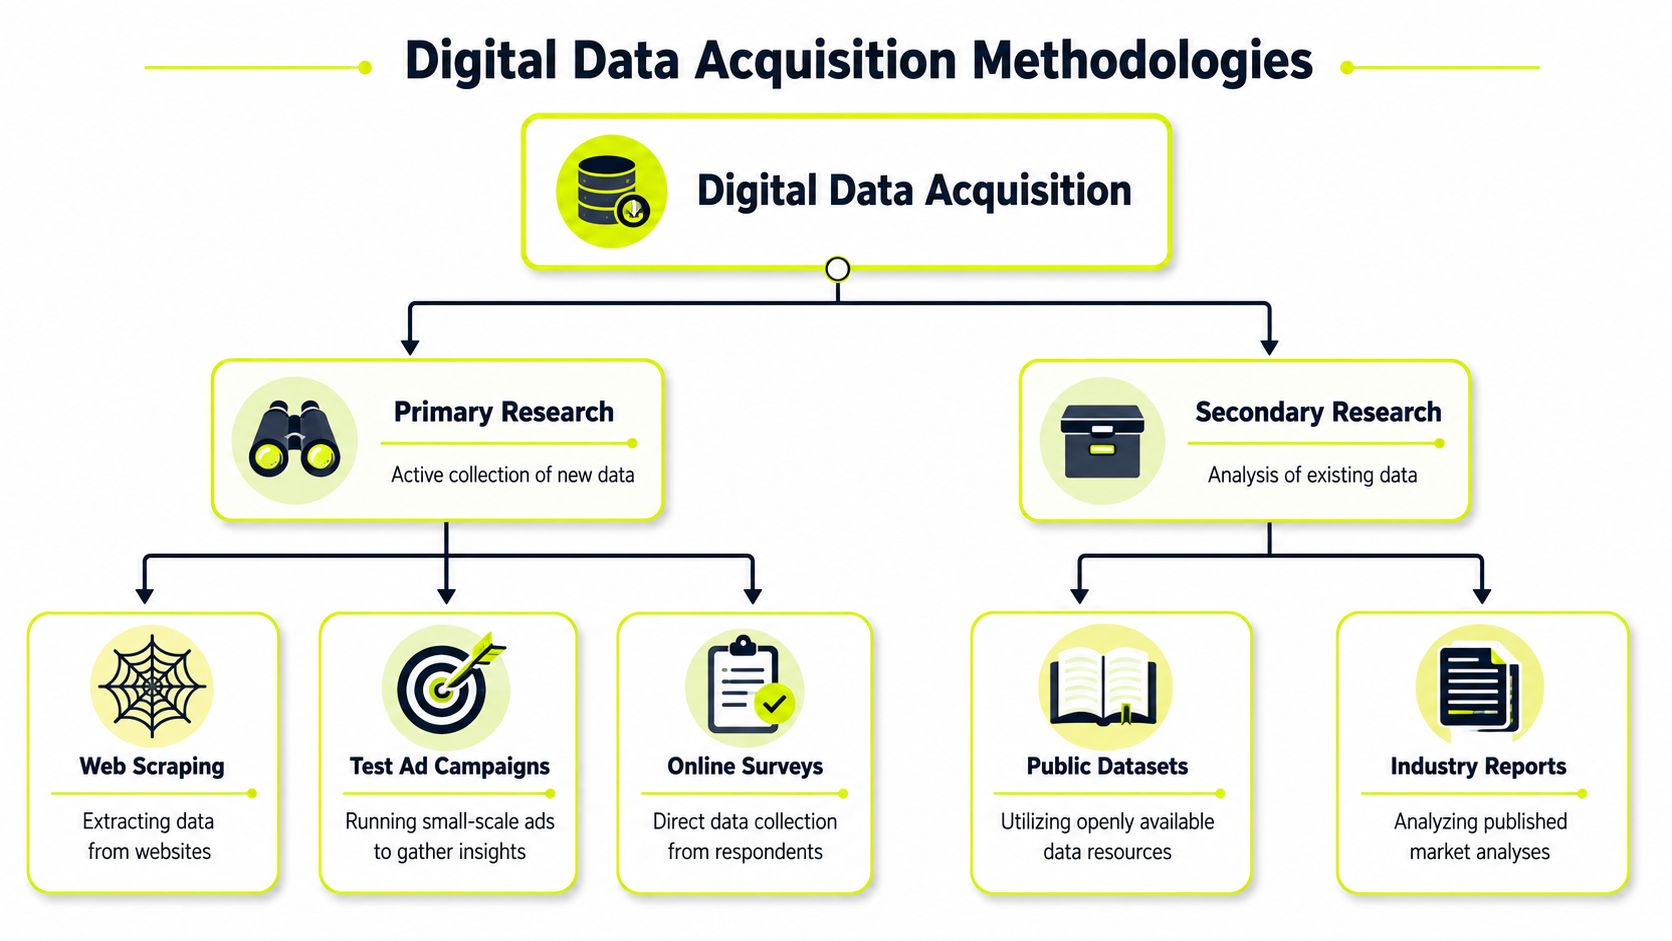
La investigación primaria significa crear observaciones frescas bajo condiciones controladas. En la práctica, eso generalmente significa ejecutar verificaciones a través de los mismos entornos de los que dependen tus campañas. Los equipos usan vistas previas de anuncios en vivo, campañas de sondeo de bajo presupuesto, visitas de página controladas por geo, capturas repetidas de competidores y pruebas de ruta de revisor.
Este trabajo cuesta tiempo y dinero. También ofrece la señal más limpia cuando el comportamiento de la plataforma cambia rápidamente.
Un equipo de compra de medios podría lanzar una prueba limitada para comparar tasas de aprobación entre grupos de cuentas. Un equipo de operaciones de cuentas podría abrir el mismo destino a través de diferentes salidas residenciales para confirmar si los usuarios locales obtienen el mismo lander, capa de traducción y flujo de checkout. Un equipo de cloaking podría probar timing, clase de dispositivo y ruta de referencia para mapear qué versión aparece bajo cada condición.
Los métodos primarios comunes incluyen:
- Web scraping: Extrayendo landers, páginas de precios, páginas de reseñas, ubicaciones SERP o registros de biblioteca de anuncios según un cronograma.
- Campañas de anuncios de prueba: Ejecutando sondeos de presupuesto pequeño para observar patrones de aprobación, comportamiento de entrega, calidad de comentarios y renderizado local.
- Bucles de retroalimentación directa: Recopilando retroalimentación post-clic, registros de soporte o respuestas de audiencia propia cuando controlas la fuente de tráfico.
Los equipos que construyen alrededor de APIs a menudo toman mejores decisiones de recopilación porque definen entidades, campos y lógica de actualización antes de comenzar a extraer. Una referencia práctica es esta guía de un flujo de trabajo de API de redes sociales para recopilación de datos estructurados.
Métodos secundarios que ahorran tiempo
La investigación secundaria comienza con material que ya tienes o puedes acceder sin generar nuevo tráfico. Eso incluye registros de campaña, notas de rechazo, historial de sesión del navegador, capturas de pantalla archivadas, bibliotecas de anuncios públicas, páginas de competidores capturadas anteriormente, notas de redes de afiliados, y cualquier registro interno vinculado al gasto o calidad de cuenta.
Aquí, los equipos disciplinados reducen el desperdicio.
El buen trabajo secundario estrecha las preguntas antes de que alguien gaste dinero en pruebas nuevas. Si seis meses de registros muestran caídas de aprobación solo en un lote de cuentas, no hay razón para comenzar con un estudio de mercado amplio. Verifica primero la procedencia de la cuenta, la consistencia del perfil del navegador, la asignación de proxy y la secuencia de calentamiento. Si las capturas de competidores archivadas muestran la misma cadencia de precios en tres geos, el siguiente paso es verificar si las diferencias visibles provienen de la estrategia de inventario local o de tu ruta de recopilación.
La misma regla aplica a las afirmaciones estadísticas. Los grandes conjuntos de datos históricos y estudios agrupados pueden fortalecer la toma de decisiones, pero solo cuando la fuente está documentada y la muestra coincide con el entorno en el que operas. Sin atribución, los números específicos sobre tamaño de muestra, reducción de error, fuerza de correlación o impulso predictivo no deberían impulsar decisiones de campaña.
Cómo elegir entre ellos
Usa recopilación primaria cuando la respuesta dependa de la entrega en vivo, aplicación de plataforma, renderizado localizado o comportamiento específico de sesión. Usa análisis secundario cuando necesites estrechar el campo, confirmar que un patrón se repite o decidir si vale la pena el riesgo de cuenta para una prueba nueva.
Una división práctica se ve así:
- Comienza con primaria para verificaciones de entrega de anuncios, validación de ruta de revisor, pruebas de cloaking y renderizado de página local.
- Comienza con secundaria para problemas de aprobación recurrentes, saturación de categoría, mapeo de tendencias creativas y comparación de funnel a lo largo del tiempo.
- Usa ambos juntos para cualquier cosa que cambie la asignación de presupuesto, rotación de cuentas o política de infraestructura.
El método importa, pero el entorno importa igual. Una extracción desde la clase incorrecta de IP, una verificación desde un perfil de navegador sobreutilizado, o una campaña de sondeo desde un cultivo débil pueden convertir una metodología limpia en mala investigación. Los operadores fuertes eligen el método y el contexto de recopilación juntos.
Automatizando la recopilación de datos con proxies y scrapers
Una verificación manual dice que un competidor está promoviendo un advertorial suave en Alemania. La extracción desde tu servidor dice que la página está limpia. El equipo de cuentas inicia sesión desde una IP de datacenter reutilizada y obtiene una tercera versión con un enlace muerto. Mismo funnel, tres observaciones diferentes. El problema no es el volumen. El problema es el contexto de recopilación.
Por eso la automatización para la investigación de arbitraje comienza con representatividad, no velocidad. Si la capa de proxy, la identidad del navegador y el patrón de solicitud no coinciden con la audiencia o estado de cuenta que estás tratando de medir, el scraper recopilará muchos datos y aún responderá la pregunta incorrecta.
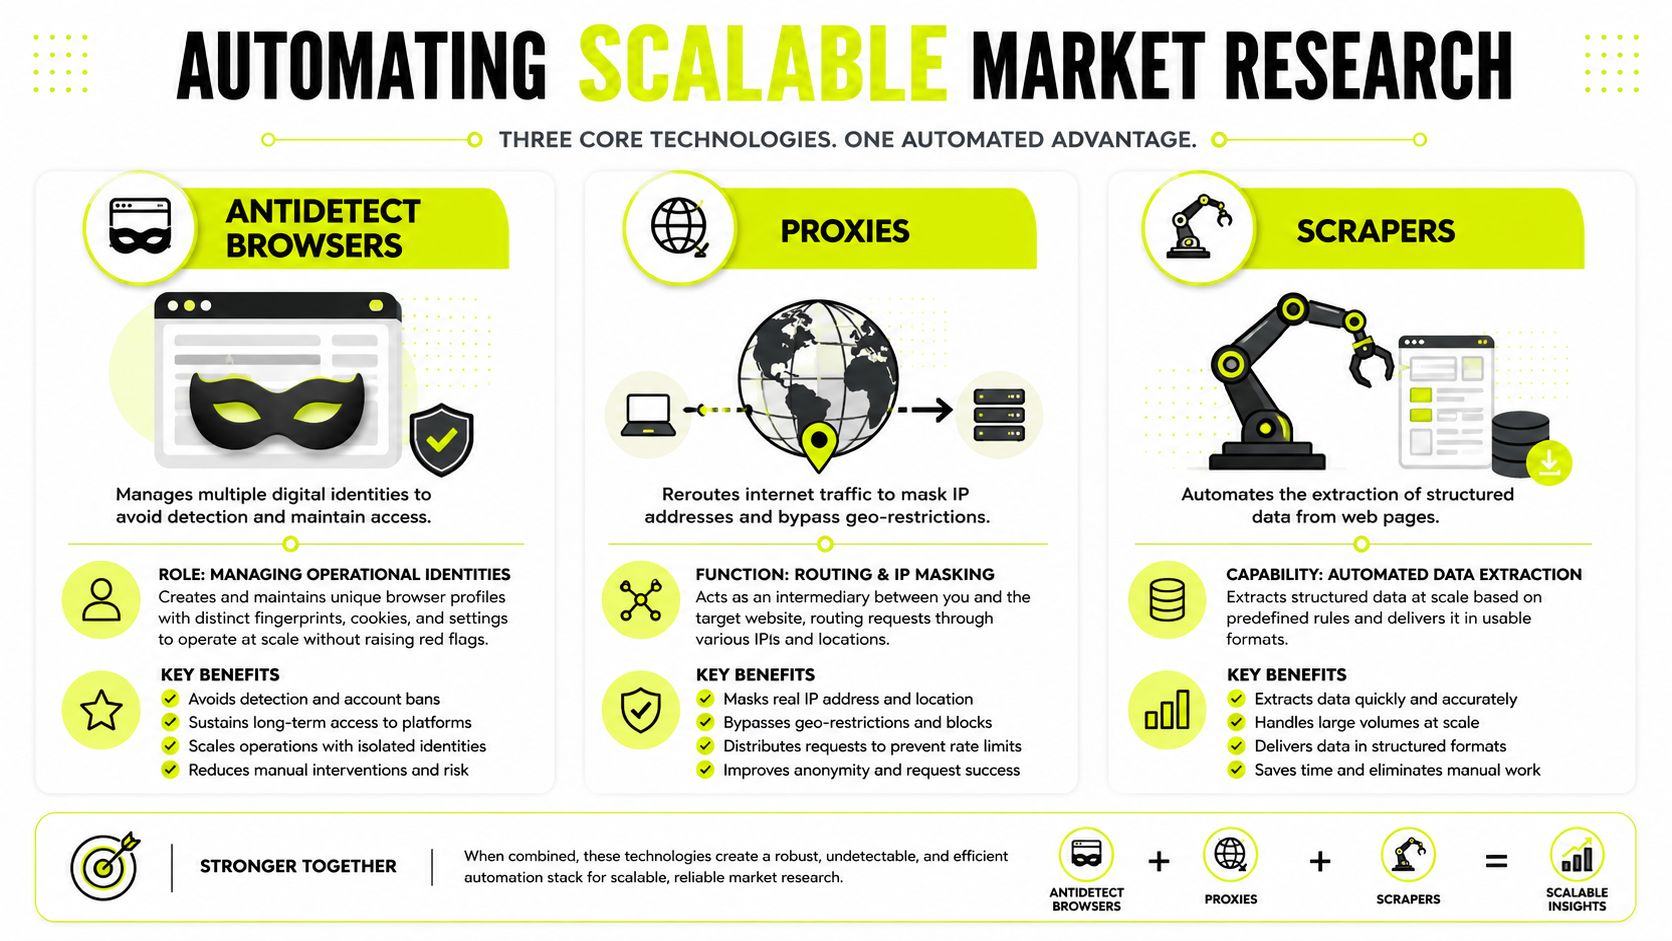
La pila de trabajo generalmente tiene tres capas. Los navegadores antidetect mantienen identidades estables. Los proxies definen la ruta de red y geografía. Los scrapers manejan extracciones repetidas, parsing, reintentos y registros.
Qué hace realmente cada capa
Herramientas como AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc hacen un trabajo bien. Preservan las huellas de navegador, cookies, almacenamiento local y continuidad de sesión para que cada cuenta o ruta de investigación permanezca aislada.
Los proxies responden una pregunta diferente. Determinan cómo la plataforma objetivo clasifica la visita. El tráfico residencial, móvil, datacenter e IPv6 no se trata igual, y esa diferencia cambia lo que tu muestra de investigación representa. Un proxy no es solo una herramienta de acceso. Es parte de la metodología.
Los scrapers se sitúan sobre esa base. Extraen páginas según cronograma, capturan HTML o capturas de pantalla, extraen campos y reintentan solicitudes fallidas. Para operaciones de web scraping más grandes, la configuración útil es la que vincula cada extracción a su entorno: clase de proxy, geo, perfil de navegador, timestamp y calidad de respuesta.
Después de que la pila está en su lugar, este tutorial es una referencia visual útil para el lado del flujo de trabajo de la automatización:
Eligiendo el tipo correcto de proxy para el trabajo
La selección de proxy cambia el conjunto de resultados, especialmente en el trabajo de arbitraje donde las plataformas personalizan por región, dispositivo, historial de sesión y señales de confianza.
| Tipo de proxy | Mejor uso | Fortaleza | Limitación |
|---|---|---|---|
| Residencial | Verificación de anuncios, verificaciones de ruta de usuario local, trabajo de cuentas | Más cercano al tráfico de consumidor normal | Mayor costo y rendimiento más lento en trabajos de extracción grandes |
| Móvil | Verificaciones de aplicaciones mobile-first, validación de plataformas sociales, rutas de app-store | Útil donde el contexto del operador afecta la entrega o confianza | Costoso e ineficiente para extracción amplia |
| Datacenter | Scraping masivo, parsing rápido, monitoreo de bajo costo | Alta velocidad y bajo costo unitario | Más probable que se clasifique como tráfico de automatización |
| IPv6 | Tareas regionales seleccionadas y escala de menor costo en entornos compatibles | Grandes pools de direcciones | Los resultados varían según la plataforma objetivo y la calidad de configuración |
Una regla práctica ayuda aquí. Usa datacenter para tareas de monitoreo donde te importa la cobertura y velocidad. Usa residencial o móvil cuando necesites saber cómo se ve la entrega para un usuario real o cómo se comporta una cuenta bajo condiciones realistas. IPv6 puede funcionar bien en configuraciones estrechas, pero solo después de validar que la plataforma trata ese tráfico de la manera en que se trataría a tu audiencia objetivo.
Diseño de sesión para cultivo de cuentas y verificación
La política de sesión importa tanto como el tipo de IP. Los cultivos de cuentas fallan cuando la identidad del navegador dice un usuario y el comportamiento de red dice diez operadores y un script.
En el trabajo diario de cuentas, las sesiones estables generalmente superan la rotación agresiva. Un perfil de Facebook cultivado que inicia sesión a través de la misma ciudad, mismo perfil de dispositivo y misma IP sticky tiene un historial coherente sobre el cual construir. Si ese mismo perfil salta redes con demasiada frecuencia, la confianza cae, los checkpoints aumentan, y la fricción de revisión aparece más rápido. La tolerancia exacta varía según la plataforma, edad de cuenta y patrón de acción, por lo que las reglas numéricas duras son arriesgadas a menos que la fuente esté documentada y coincida con tu entorno.
Ese es el problema con los benchmarks prestados. Un explicador amplio de investigación de mercado como Hanover Research sobre investigación de mercado es útil para enmarcar metodología, pero no es una fuente para umbrales operacionales de proxy en cultivo de cuentas. En la práctica, los equipos deben validar la duración de sesión, reglas de rotación y tasas de falla dentro de sus propios cultivos y registrar el resultado por plataforma, geo y cohorte de cuenta.
La división que uso es directa:
- Cultivo de cuentas: sesiones sticky, un perfil de navegador por cuenta, ritmo lento de login, sin cambios innecesarios de IP
- Verificación de anuncios: sesiones controladas con la geo correcta, contexto de dispositivo y suficiente persistencia para reproducir la entrega
- Scraping de página pública: rotación basada en sensibilidad del objetivo, límites de solicitud y patrones de falla del parser
- Verificaciones de cloaking: múltiples tipos de sesión desde múltiples clases de IP, porque una ruta limpia prueba muy poco
A escala, la ventaja viene de hacer coincidir el entorno de recopilación con la decisión que necesitas tomar. Si el objetivo es estimar qué experimentan los usuarios en una geo objetivo, el tráfico representativo importa más que el recuento bruto de extracción. Si el objetivo es monitoreo amplio de competidores, el tráfico de menor costo puede ser suficiente siempre que el equipo etiquete ese conjunto de datos correctamente y no lo trate como evidencia representativa de usuario.
Analizando datos para insights accionables de campaña
Un equipo ejecuta verificaciones de aprobación en cinco geos, ve un pico en estados verdes y escala el gasto al mediodía. Para la tarde, la calidad de conversión ha bajado, dos lotes de cuentas están inestables, y el creativo ganador solo funcionó en la configuración exacta de recopilación utilizada para la investigación. El error no fue falta de datos. El error fue análisis débil vinculado a un entorno no representativo.
Cómo estructurar las entradas sin procesar
El análisis accionable comienza con un formato de registro que coincide con las decisiones que toma tu equipo. Si el objetivo es elegir un creativo, cortar una pila de navegador mala, o verificar si un funnel es estable por geo, cada registro necesita suficiente contexto para explicar el resultado más tarde.
Usa una hoja de cálculo, base de Airtable o una tabla SQL ligera. La herramienta importa menos que el esquema.
Cada fila debe responder cinco preguntas:
- Qué observaste
- Dónde lo observaste
- Cuándo sucedió
- Qué entorno de recopilación lo produjo
- Qué acción tomó el equipo
Para operaciones de campaña y cuentas, los campos útiles generalmente son geo, tipo de dispositivo, perfil de navegador, clase de proxy, persistencia de sesión, bucket de edad de cuenta, ángulo de anuncio, variante de lander, resultado de aprobación, CTA visible, y notas sobre redirecciones o comportamiento de cloaking. Para salida de scraper, agrega estado de respuesta, éxito de parser, reintentos, cambios de DOM, y si la extracción provino de una ruta representativa de usuario o una ruta de monitoreo de menor costo.
Esa distinción importa en la práctica. Los equipos que ejecutan campañas de afiliados a menudo obtienen mejores decisiones cuando mapean creativos, prelanders y comportamiento de conversión contra geo y condiciones de tráfico de la misma manera que mapean entradas operacionales en un flujo de trabajo de campaña de marketing de afiliados. Los números agregados ocultan demasiado.
Cómo encontrar señales que sobreviven a escala
Una vez que los registros están limpios, analízalos de la manera en que un operador revisa el riesgo de campaña en vivo. Mira a través de segmentos, a lo largo del tiempo y a través de grupos de patrones repetidos.
- Segmento: Desglosa resultados por geo, dispositivo, tipo de proxy, cohorte de cuenta y configuración de navegador.
- Tiempo: Verifica qué cambió después de una actualización de plataforma, impulso de presupuesto, cambio de regla de rotación o nuevo lote de cultivo.
- Cluster: Agrupa creativos y landers por tipo de reclamo, estructura visual, lenguaje de CTA o riesgo de cumplimiento.
Los métodos formales de investigación todavía ayudan aquí, como se explica en la guía de Forbes Advisor sobre investigación de mercado, que incluye un ejemplo de regresión multivariada en 50,000 respuestas de consumidores. En ese ejemplo citado, el análisis aisló la percepción de marca como un impulsor de la intención de compra, con un coeficiente de 0.42 y p < 0.005, y una mejora del 10% en la percepción de marca correspondió a un aumento del 4.2% en la intención de compra. La lección práctica para equipos de arbitraje es simple. No trates una victoria superficial como prueba. Verifica si el resultado todavía se mantiene después de controlar por geo, calidad de inventario, condición de cuenta y entorno de recopilación.
Un creativo puede parecer fuerte porque las cuentas eran frescas, las aprobaciones fueron más fáciles en una región, o el tráfico de investigación fue más limpio que el tráfico que tu campaña enfrentará.
Un ciclo de revisión práctico
El proceso de revisión debe terminar en una decisión operativa, no en otra pestaña de dashboard.
Uso un ciclo de cinco pasos:
- Normaliza etiquetas para que geos, dispositivos, clases de proxy y estados de aprobación se nombren de la misma manera en todas las fuentes.
- Etiqueta patrones repetibles en copy, visuales, reclamos, pasos de funnel y resultados de moderación.
- Compara datos representativos versus datos de conveniencia para ver si el hallazgo provino de condiciones reales tipo usuario o solo de la ruta de recopilación más fácil.
- Señala anomalías rápido como desajustes de renderizado, caídas súbitas de aprobación, fallas de parser o cambios de oferta locales.
- Asigna una acción concreta con un propietario y fecha límite.
Ese último paso es donde la investigación se vuelve útil. Lanza el ángulo en una geo primero. Pausa la pila de navegador que solo funciona bajo tráfico de datacenter. Vuelve a ejecutar verificaciones de cloaking a través de una sesión residencial. Divide lotes de cuentas antes de impulsar presupuesto.
El análisis es lo que convierte la recopilación en ventaja. En arbitraje y cultivo de cuentas, la ventaja generalmente proviene de identificar qué resultados son portables y cuáles solo existen dentro de la configuración que los produjo.
Navegando obstáculos técnicos y sesgos de datos
Un equipo extrae anuncios de competidores, landers y precios en cinco geos durante la noche. Por la mañana, el dashboard está limpio, las etiquetas están normalizadas, y la tendencia parece obvia. Luego la campaña se lanza en tráfico real y falla. El problema no fueron datos desordenados. El problema fue que la pila de investigación muestreó la versión incorrecta del mercado.
La precisión no es representatividad
Los equipos técnicos generalmente se enfocan primero en la precisión de recopilación. Eso tiene sentido. Los parsers necesitan HTML estable, los timestamps necesitan alinearse, y los registros duplicados necesitan eliminarse antes de que alguien pueda confiar en la salida.
Pero en arbitraje y operaciones de cuentas, el mayor riesgo es la representatividad. Un scraper puede capturar una página perfectamente y aún capturar la experiencia incorrecta.
Eso sucede todo el tiempo con la selección de proxy. Las IPs de datacenter son más baratas, más rápidas y más fáciles de escalar. También son más propensas a encontrar versiones alternativas de página, flujos de desafío, activos eliminados, o tráfico que se puntúa como sospechoso antes de que el contenido se cargue completamente. Las sesiones residenciales cuestan más y son más difíciles de gestionar limpiamente, pero a menudo producen una versión del mercado que está más cerca de lo que ven los usuarios reales, revisores o sistemas de plataforma.
Trato la clase de proxy como una decisión de muestreo, no solo una decisión de infraestructura.
Dónde falla la investigación basada en proxies
Las fallas comunes son operacionales, no académicas.
- Páginas de desafío registradas como extracciones exitosas: El scraper almacena una respuesta 200, pero al navegador se le sirvió una verificación de bot, muro de consentimiento o renderizado parcial.
- Desajuste de huella digital y red: La IP geolocaliza a Madrid, el locale del navegador es polaco, la zona horaria es UTC, y la plataforma responde con una experiencia de respaldo.
- Patrones de tasa que ningún usuario produciría: Las solicitudes llegan cada pocos segundos desde la misma subred, por lo que cambia la lógica de precios, inventario o entrega de anuncios.
- Sangrado geo entre sesiones: Un pool de rotación dice un país, pero el DNS, la selección de edge de CDN o el historial de cuenta apuntan a otro lugar.
- Sesgo de clase de proxy: La investigación recopilada solo a través de una fuente de tráfico refleja cómo las plataformas tratan esa fuente, no cómo se comporta el mercado en general.
Para equipos que enfrentan presión de bloqueo, los controles prácticos de evitar baneos de IP durante la automatización pueden mejorar la estabilidad. La estabilidad por sí sola no es suficiente. Una configuración de recopilación estable aún puede producir investigación sesgada si el perfil de tráfico no coincide con la audiencia, revisor o ruta de moderación que necesitas entender.
Qué verifican los buenos equipos antes de confiar en el resultado
Busco deriva de entorno antes de mirar el gráfico. Si la misma landing page convierte, renderiza o se revisa de manera diferente entre clases de proxy, asumo que la configuración de investigación es parte del resultado hasta que se demuestre lo contrario.
Un pase de validación utilizable generalmente incluye tres verificaciones. Primero, compara páginas clave en al menos dos entornos de tráfico. Segundo, carga los mismos objetivos a través de la pila de navegador utilizada en operaciones en vivo, no solo solicitudes crudas. Tercero, revisa una muestra manualmente para orden de carga de activos, precios locales, prompts de moderación, redirecciones y comportamiento de consentimiento.
Esto importa más en el cultivo de cuentas y verificación de anuncios. Las tasas de aprobación, la visibilidad de anuncios e incluso qué copy se muestra pueden cambiar según la huella de red detrás de la sesión. Las guías estándar de investigación de mercado enmarcan esto como un problema de precisión de datos. En la práctica, es un problema de representatividad. Si tu entorno de recopilación no se parece al entorno donde suceden los presupuestos, aprobaciones y clics de usuarios, el análisis derivará.
El trade-off es simple. La recopilación rápida y barata aumenta el volumen. La recopilación representativa protege las decisiones. A escala, la segunda ahorra más dinero.
Líneas legales y éticas en operaciones basadas en datos
Un equipo extrae anuncios de competidores a través de un pool de proxies, verifica la entrega a través de otro, luego inicia sesión en cuentas calentadas desde un tercer entorno. Los reportes se ven limpios. Las cuentas no. Esa brecha es donde la exposición legal, las violaciones de políticas y las malas decisiones de investigación comienzan a superponerse.
Para arbitraje y operaciones de cuentas, la pregunta real no es si la recopilación de datos está permitida en abstracto. La pregunta es si el flujo de trabajo coincide con el caso de uso, las reglas de la plataforma y las señales de identidad adjuntas a la sesión. La recopilación de página pública, scraping con login, verificación de anuncios, calentamiento de cuentas y cloaking no conllevan el mismo riesgo. Tratarlos como un solo bucket es cómo los equipos terminan con controles débiles e investigación engañosa.
Reglas de plataforma que no puedes ignorar
Meta y TikTok aplican reglas sobre automatización, consistencia de identidad, comportamiento engañoso e integridad de cuenta. Esas verificaciones afectan la pila exacta que los operadores usan todos los días en AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc. La calidad del perfil del navegador importa. La clase de IP importa. El historial de sesión importa. También importa si la acción solo observa una página o cambia activamente el estado de la cuenta.
Un límite es claro. Meta prohíbe el cloaking y otros métodos que muestran a los revisores contenido diferente del que ven los usuarios, como se establece en los estándares y materiales de políticas publicitarias de Meta. Eso importa operacionalmente porque los entornos de investigación a menudo se filtran en los hábitos de producción. Una configuración construida para inspeccionar anuncios en geos puede derivar hacia un comportamiento que las plataformas leen como tergiversación si la capa de identidad, el comportamiento de destino y el enrutamiento de sesión dejan de alinearse.
La conclusión práctica es simple. Las elecciones de infraestructura son parte del cumplimiento. También moldean la validez de la investigación. Si la capa de proxy cambia cómo las plataformas clasifican la sesión, entonces tus hallazgos pueden describir el entorno de laboratorio, no el mercado en el que planeas comprar tráfico.
Gestión de riesgo en flujos de trabajo reales
Uso una revisión básica antes de aprobar cualquier flujo de trabajo de recopilación o cuenta:
- ¿Es el objetivo público, o requiere login o membresía?
- ¿Estamos observando contenido, recopilando datos a escala o cambiando el estado de la cuenta?
- ¿Altera la configuración las señales de identidad de una manera que una plataforma podría tratar como engañosa?
- ¿Pueden los datos incluir información personal, comentarios, nombres de usuario u otros identificadores?
- Si los registros de la plataforma o el asesor legal revisaran este flujo de trabajo, ¿se mantendrían la intención y los controles?
Ese filtro cambia las decisiones rápido.
| Flujo de trabajo | Riesgo principal |
|---|---|
| Scraping de páginas públicas de competidores | Aplicación de términos, límites de tasa, problemas legales específicos de jurisdicción |
| Scraping detrás de acceso autenticado | Mayor exposición contractual y riesgo legal más fuerte |
| Verificación de anuncios en geos | Menor riesgo de contenido, pero la consistencia de sesión y reputación del proxy aún importan |
| Cultivo de cuentas | Exposición directa de integridad de cuenta y aplicación |
| Cloaking | Violación explícita de política y alto riesgo de suspensión |
El error operacional es asumir que el riesgo legal y el riesgo de plataforma son lo mismo. Están relacionados, pero se rompen en lugares diferentes. Un flujo de trabajo puede ser legal en un sentido estrecho y aún hacer que las cuentas sean restringidas porque la plataforma lee el patrón de identidad como abusivo. Un flujo de trabajo también puede permanecer dentro de las reglas de la plataforma y aún crear problemas de privacidad si el pipeline de recopilación almacena datos personales sin una base clara o política de retención.
Los buenos equipos documentan la intención, aíslan la investigación de la producción, registran quién ejecutó qué y mantienen reglas de retención estrictas. GDPR y CCPA se vuelven relevantes rápidamente cuando el contenido extraído incluye nombres de usuario, comentarios, correos electrónicos, pistas de ubicación o cualquier cosa que pueda vincular la actividad a una persona.
Los operadores que permanecen en este campo durante años no tratan la ética como lenguaje de relaciones públicas. La tratan como diseño de sistema. Si el método depende del cambio oculto de identidad, destinos inconsistentes o recopilación de datos que no puedes justificar almacenar, el flujo de trabajo es débil antes de que la campaña se lance.
Si tu equipo ejecuta scraping a gran escala, verificación de anuncios geo-dirigidos, operaciones de cuentas de Facebook y TikTok, o investigación de mercado que depende de cobertura realista de IP, Sota Proxy está construido para esa carga de trabajo. Ofrece a los equipos técnicos opciones de proxy residencial, móvil, ISP y datacenter en más de 220 geolocalizaciones, con control de sesión sticky y rotativo que se ajusta tanto a flujos de trabajo de investigación como de cuentas. Para operadores que necesitan infraestructura estable en lugar de networking de prueba y error, es una pila práctica para evaluar.
Artículos relacionados
Alternativas a Decodo en 2026: a qué proveedor migrar y cuáles evitar
Decodo lidera en precio en proxies residenciales rotativos, pero resulta de los más caros en ISP dedicados. Precios verificados de ambos, las razones reales por las que la gente se va y qué alternativa encaja con cada caso.
Alternativas a Webshare en 2026: cuando los proxies más baratos dejan de serlo
Webshare regala 10 proxies y vende IPs residenciales estáticas a $0,30 la unidad, una décima parte de lo que cobra la competencia. Precios verificados, las cuatro razones por las que la gente aún migra y el único motivo para quedarse.
Dolphin Anty para gestión de múltiples cuentas: funciones, automatización e integración de proxies
Cómo usar Dolphin Anty para gestionar múltiples cuentas: perfiles de navegador, Cookie Robot, escenarios, Synchronizer, automatización por API y tres formas de conectar proxies de SotaProxy. Código promocional SOTA20 con 20% de descuento.
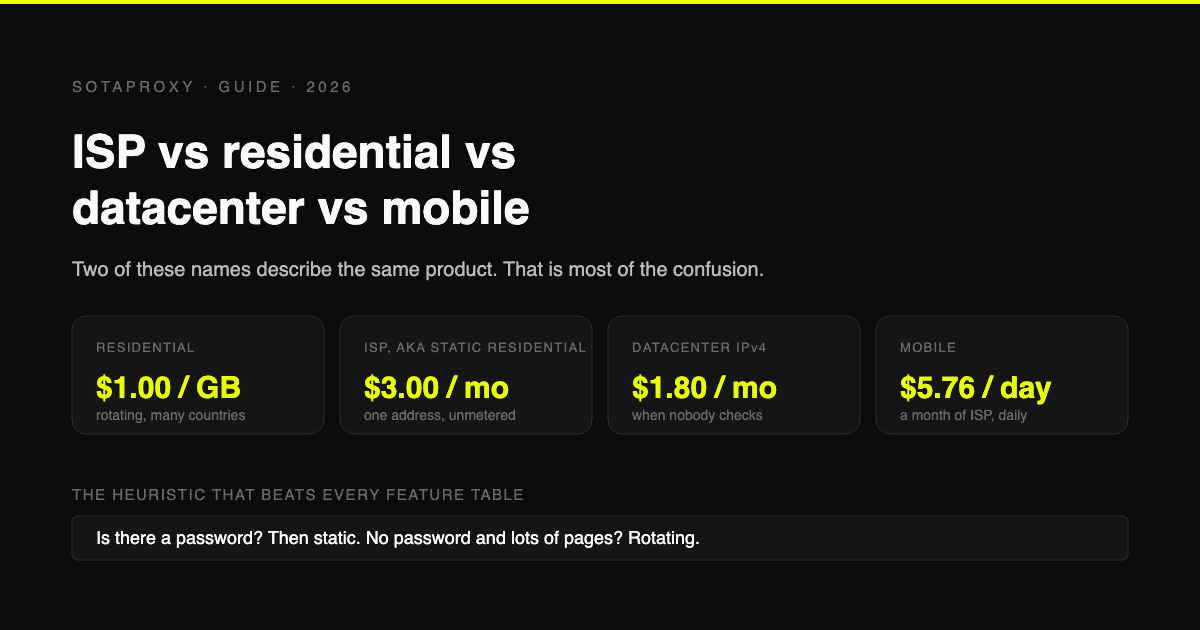
Proxies ISP, residenciales, de datacenter y móviles: cuál necesitas realmente
Los proxies residenciales estáticos y los ISP son el mismo producto con dos nombres distintos, por eso la mitad de las comparaciones terminan confrontando una cosa consigo misma. Qué es cada tipo, cuánto cuesta por unidad y para qué tarea específica funciona mejor cada uno.
Por qué un proxy que funciona no es suficiente: checklist de ToDetect antes del lanzamiento
Un proxy que funciona no garantiza un entorno de navegador coherente. Descubre cómo ToDetect verifica la IP, el DNS, WebRTC y las señales de huella digital del navegador antes del lanzamiento.
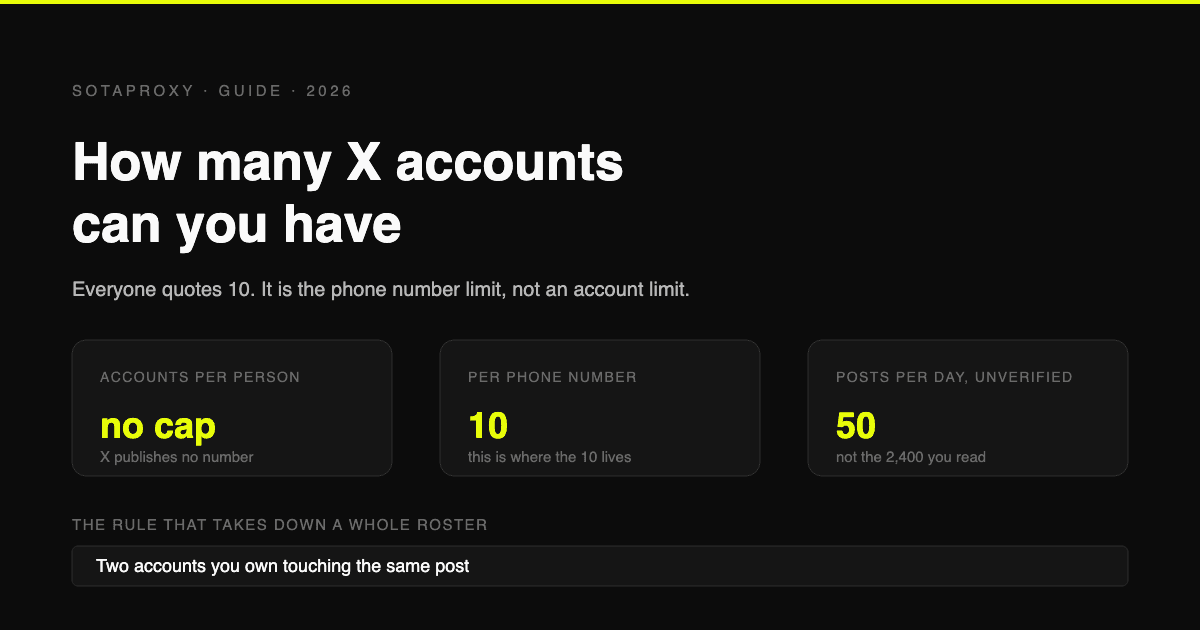
¿Cuántas cuentas de X (Twitter) puedes tener en 2026? (El límite de 10 es por teléfono, no por persona)
X no establece límite oficial de cuentas por usuario. El número 10 que todos mencionan se refiere a cuántas cuentas puedes asociar a un mismo número de teléfono. Las restricciones reales son los 50 posts diarios en cuentas gratuitas, casos de uso duplicados y cuentas que interactúan entre sí.