Dominando el Análisis del Comportamiento del Consumidor para Arbitraje
Domina el análisis del comportamiento del consumidor para arbitraje de tráfico y farming de cuentas. Aprende recolección de datos, flujos de trabajo con proxies y análisis para Facebook y TikTok.
La mayoría de los consejos sobre análisis del comportamiento del consumidor parten de una suposición equivocada. Asumen que el flujo de eventos es limpio, que el recorrido del usuario es rastreable y que la ubicación geográfica adjunta a cada visita es confiable. Eso puede funcionar para un dashboard básico de comercio electrónico. Se desmorona rápidamente cuando ejecutas cuentas publicitarias de Facebook y TikTok a través de AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc, pruebas flujos encubiertos y lanzas campañas geosegmentadas a través de múltiples clusters de cuentas.
En arbitraje, los datos incorrectos no solo difuminan los reportes. Provocan que las cuentas sean marcadas, que los creativos se dirijan mal y que el gasto se oriente a la audiencia equivocada. Si estás cultivando cuentas, validando ofertas, scrapeando SERPs locales o verificando la entrega de anuncios específicos por región, la primera pregunta no es "¿qué hizo el usuario?" Es "¿este evento provino del lugar y contexto de dispositivo que afirma provenir?" La mayoría de las guías omiten eso. Van directo a segmentación y dashboards.
Tabla de Contenidos
- Por qué falla la mayoría del análisis del comportamiento del consumidor
- Marcos fundamentales y métricas accionables
- Recolección de datos para operaciones de alto riesgo
- Técnicas de análisis esenciales para arbitraje
- Casos de uso y obstáculos en gestión de anuncios
- Construyendo tu stack tecnológico
- Implementando un sistema de análisis rentable
Por qué falla la mayoría del análisis del comportamiento del consumidor
La mayoría del análisis del comportamiento del consumidor falla porque los equipos confían más en la etiqueta de los datos que en el origen de los datos.
Si estás comprando tráfico, cultivando cuentas o validando el rendimiento de campañas entre regiones, eso es un error. No puedes construir segmentos confiables a partir de registros contaminados por bots, ubicaciones falsificadas, reseñas sintéticas y contexto de dispositivo desajustado. La Brecha de Procedencia de Datos es la parte que la mayoría del contenido analítico convencional ignora.
Una descripción citada de esa brecha establece que el 68% de los conjuntos de datos de comportamiento del consumidor utilizados en 2024–2025 contenían entradas inconsistentes con la ubicación o generadas por bots, y el 22% de los datos de interacción de comercio electrónico a nivel mundial provenían de reseñas generadas por IA y tráfico sintético según la discusión referenciada sobre la Brecha de Procedencia de Datos. Si tu modelo de audiencia incluye ese ruido, tus "insights" son a menudo solo artefactos de una mala recolección.
El primer punto de fallo es la confianza geográfica
Los equipos de arbitraje de tráfico suelen notar esto después de que el dinero ya se ha ido. Una página de aterrizaje convierte en una ciudad, fracasa en otra, y el dashboard dice que la audiencia se comportó diferente. A veces lo hicieron. A veces los datos de ubicación estaban mal desde el principio.
Eso importa más allá del reporte. Afecta los resultados de revisión de anuncios, los patrones de calentamiento de cuentas, las ofertas localizadas y la lógica de encubrimiento. Una mala suposición geográfica puede envenenar todo un lote de cuentas.
Regla práctica: Verifica la geografía antes de interpretar el comportamiento. Si omites ese paso, cada modelo posterior hereda el error.
Muchos equipos tratan la higiene de proxies como un problema de operaciones y la analítica como un problema de reportes. En la práctica son el mismo sistema. Si la capa de recolección no está limpia, tu análisis de comportamiento no es análisis. Es conjetura con gráficos.
La mayoría de los dashboards explican los resultados demasiado tarde
Los dashboards estándar están construidos alrededor de indicadores rezagados. Gasto, CTR, conteo de conversiones, quizás algunos clips de repetición. Eso no es suficiente para operaciones de alto riesgo. Necesitas saber si la sesión del usuario fue auténtica, si la ruta fue regionalmente válida y si el contexto de la cuenta coincidía con las expectativas de la plataforma.
Para operadores que también realizan scraping o validación de mercado local, esto se vuelve obvio rápidamente. La investigación limpia comienza con un método de recolección verificable, no con un dashboard pulido. Una buena introducción a esa distinción se encuentra en este artículo sobre cómo la investigación de mercado depende de la calidad de los datos.
Marcos fundamentales y métricas accionables
Los marcos como RFM y AIDA todavía funcionan. Solo necesitan traducirse a lenguaje de operadores. Si los dejas como teoría de presentación, no te ayudarán a gestionar cuentas publicitarias de Facebook, debuggear un embudo de TikTok o decidir si un prelander encubierto está filtrando a los usuarios equivocados.
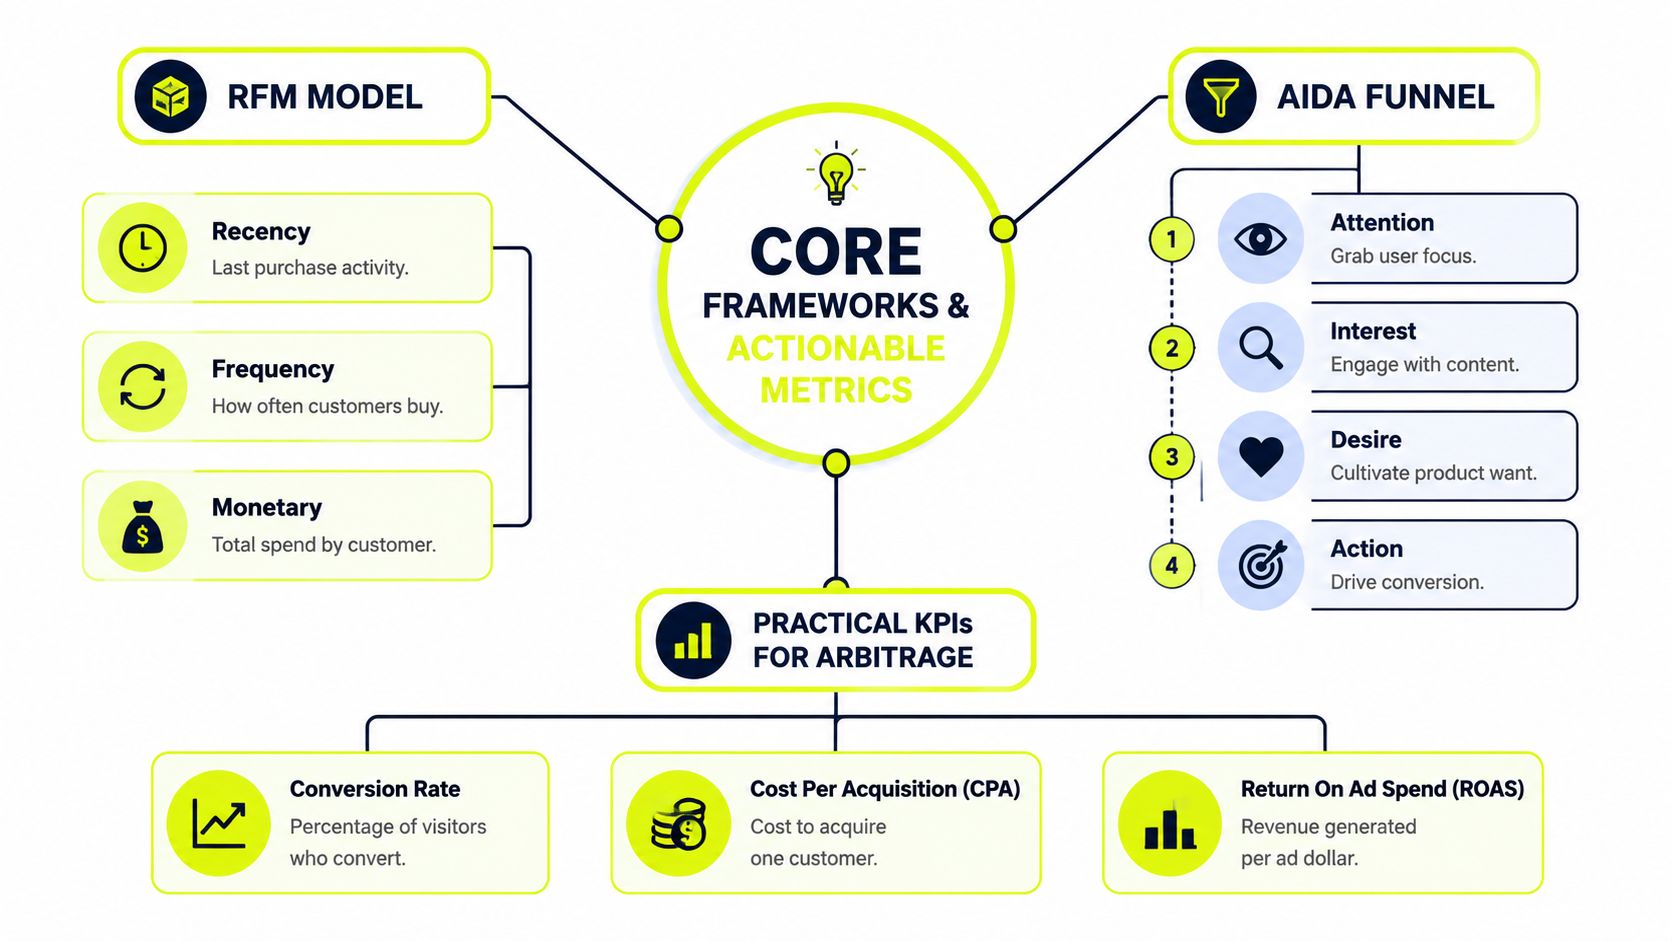
Convierte modelos clásicos en métricas operativas
RFM es útil cuando estás clasificando la calidad del tráfico después del clic.
- Recencia te dice qué tan recientemente actuó un usuario. En términos de arbitraje, esto ayuda a separar respondedores frescos de tráfico reciclado.
- Frecuencia muestra interacción repetida. Eso es útil cuando los bucles de retargeting, la exposición publicitaria repetida o los patrones de revisita de cuentas comienzan a afectar el comportamiento de aprobación y conversión.
- Monetario sigue siendo la capa comercial. En la práctica, los equipos a menudo lo mapean al valor del pedido, calidad del pago o calidad del comprador downstream.
AIDA es mejor cuando estás diagnosticando desajustes de creativos y embudo.
- Atención. ¿El anuncio detuvo el scroll?
- Interés. ¿El usuario interactuó con la página de aterrizaje en lugar de rebotar en un bucle de clic hacia atrás?
- Deseo. ¿La sesión mostró intención de producto, comparación de ofertas o exploración fuerte de CTA?
- Acción. ¿El usuario completó el evento objetivo sin fricción?
El valor no está en nombrar las etapas. El valor está en vincular cada etapa a un comportamiento observable dentro de un stack de tráfico real.
Usa señales de dificultad como sistema de alerta temprana
Una de las pocas métricas que ayuda día a día es el Puntaje de Dificultad. Una guía referenciada describe métricas de dificultad a nivel de sesión como reversiones rápidas del cursor y ventanas emergentes de error repetidas, y establece que este puntaje se correlaciona con una probabilidad 34% mayor de abandono de transacciones. La misma fuente dice que los equipos que rastrean y corrigen esos puntos de fricción pueden recuperar aproximadamente el 22% de los ingresos que de otro modo se perderían según la guía de Glassbox sobre análisis del comportamiento del cliente.
Eso importa porque la dificultad aparece antes de que tu reporte de conversión de alto nivel se vea feo.
Observa patrones de vacilación, no solo salidas. Un usuario que da vueltas, se detiene, reintenta campos o revierte dirección te está diciendo dónde el embudo está a punto de tener una fuga.
Para equipos de arbitraje, el dashboard práctico suele incluir:
- Indicadores de fricción de sesión vinculados a campos de checkout, puntos de redirección o elementos de página bloqueados por geo.
- Continuidad creativo-lander para que puedas detectar cuándo la promesa del anuncio y la realidad de la página no coinciden.
- Puntos de quiebre específicos de plataforma porque un clic de TikTok a menudo se comporta diferente del tráfico de Facebook en el mismo destino.
- Señales de riesgo de aprobación cuando el comportamiento de la cuenta comienza a desviarse del patrón esperado de geo o dispositivo.
Una tasa de rebote no te dirá que una superposición de envío se rompió para una región, o que una regla de encubrimiento sirvió la variante de página incorrecta a una sesión limpia. Una vista orientada a la dificultad a menudo sí lo hará.
Recolección de datos para operaciones de alto riesgo
La recolección cambia cuando la operación es de alto riesgo. No solo estás reuniendo eventos analíticos. Estás tratando de reunirlos sin bloqueos, etiquetas geo falsas, sesiones envenenadas o disparadores de revisión de cuentas. Por eso la elección de proxy debe seguir la tarea.
Elige el tipo de proxy según la tarea, no por costumbre
Los operadores a menudo recurren por defecto a un tipo de proxy para todo. Eso es perezoso y costoso. Residencial, móvil, datacenter e IPv6 cada uno resuelve problemas diferentes.
Para el trabajo de cuentas sociales, el tráfico móvil tiene una ventaja específica. Una fuente citada dice que los proxies móviles proporcionan una tasa de éxito 35% mayor para el farming de cuentas en TikTok e Instagram comparado con proxies residenciales porque esas plataformas confían en el encabezado IP del operador móvil, o ASN. La misma fuente establece que los proxies de datacenter tienen una tasa de fallo del 95% para estas tareas porque no llevan esa señal de confianza, como se nota en esta descripción general de análisis de comportamiento y patrones de confianza de plataforma.
Eso se alinea con lo que los operadores ven en el campo. Si estás registrando cuentas de TikTok o Instagram dentro de AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc, móvil es a menudo el carril más seguro para la reputación de inicio de sesión y farming de cuentas. Residencial todavía importa para muchas simulaciones de consumidor basadas en navegador, verificaciones locales y trabajo de sesión larga. Datacenter es útil donde la velocidad importa más que la confianza. IPv6 suele ser rentable para amplia cobertura geo y validación de gran volumen, pero no es un reemplazo universal para sesiones móviles confiables o residenciales coincidentes con la ciudad.
Comparación de tipos de proxy para recolección de datos del consumidor
| Tipo de Proxy | Caso de Uso Principal | Puntaje de Confianza | Costo | Mejor Para |
|---|---|---|---|---|
| Residencial | Sesiones de navegador geoconsistentes | Alto | Más alto | Gestión de cuentas de Facebook, verificaciones de ofertas locales, validación de encubrimiento |
| Móvil | Actividad social respaldada por operador | Muy alto en plataformas reenviadas por móvil | Más alto | Farming de cuentas de TikTok e Instagram, verificación de anuncios en flujos pesados de móvil |
| Datacenter | Solicitudes masivas rápidas | Bajo para trabajo sensible de cuentas | Más bajo | Scraping no sensible, pruebas internas, trabajos de recuperación de alta velocidad |
| IPv6 | Distribución geo a gran escala y control de costos | Varía según el objetivo y calidad de infraestructura | Costo relativo más bajo a escala | Campañas geosegmentadas, verificación amplia de anuncios, pools de enrutamiento grandes |
Los casos de uso importan más que las etiquetas.
- Residencial encaja cuando la consistencia de ciudad importa. Eso es común con cuentas publicitarias de Facebook, ofertas bloqueadas por región y recolección de SERP local.
- Móvil encaja cuando la plataforma califica la confianza a través del contexto del operador. Ahí es donde los flujos de trabajo de TikTok e Instagram se vuelven menos indulgentes.
- Datacenter encaja en recolección donde la velocidad es primero. No lo uses para calentamiento sensible de cuentas y luego te sorprendas cuando la plataforma trate la sesión como sintética.
- IPv6 encaja en cobertura y control de costos. Es práctico para campañas geosegmentadas y trabajos de validación cuando el objetivo acepta el perfil de red.
Si estás construyendo crawlers alrededor de inteligencia publicitaria, precios locales o instantáneas de mercado, el método de recolección tiene que preservar la integridad de la sesión. Esta guía sobre flujos de trabajo de web crawling con Python es útil para pensar sobre el diseño de parsers y flujo de solicitudes sin reducir el problema a solo "enviar más solicitudes."
Técnicas de análisis esenciales para arbitraje
Una vez que la capa de recolección es estable, el siguiente trabajo es la interpretación. En arbitraje, cuatro técnicas hacen la mayor parte del trabajo útil. Segmentación conductual, análisis de cohortes, análisis de embudo y lógica de atribución. Suenan estándar. No son estándar cuando el tráfico cruza landers encubiertos, apps de mensajería, checkouts de terceros y múltiples entornos de cuentas.
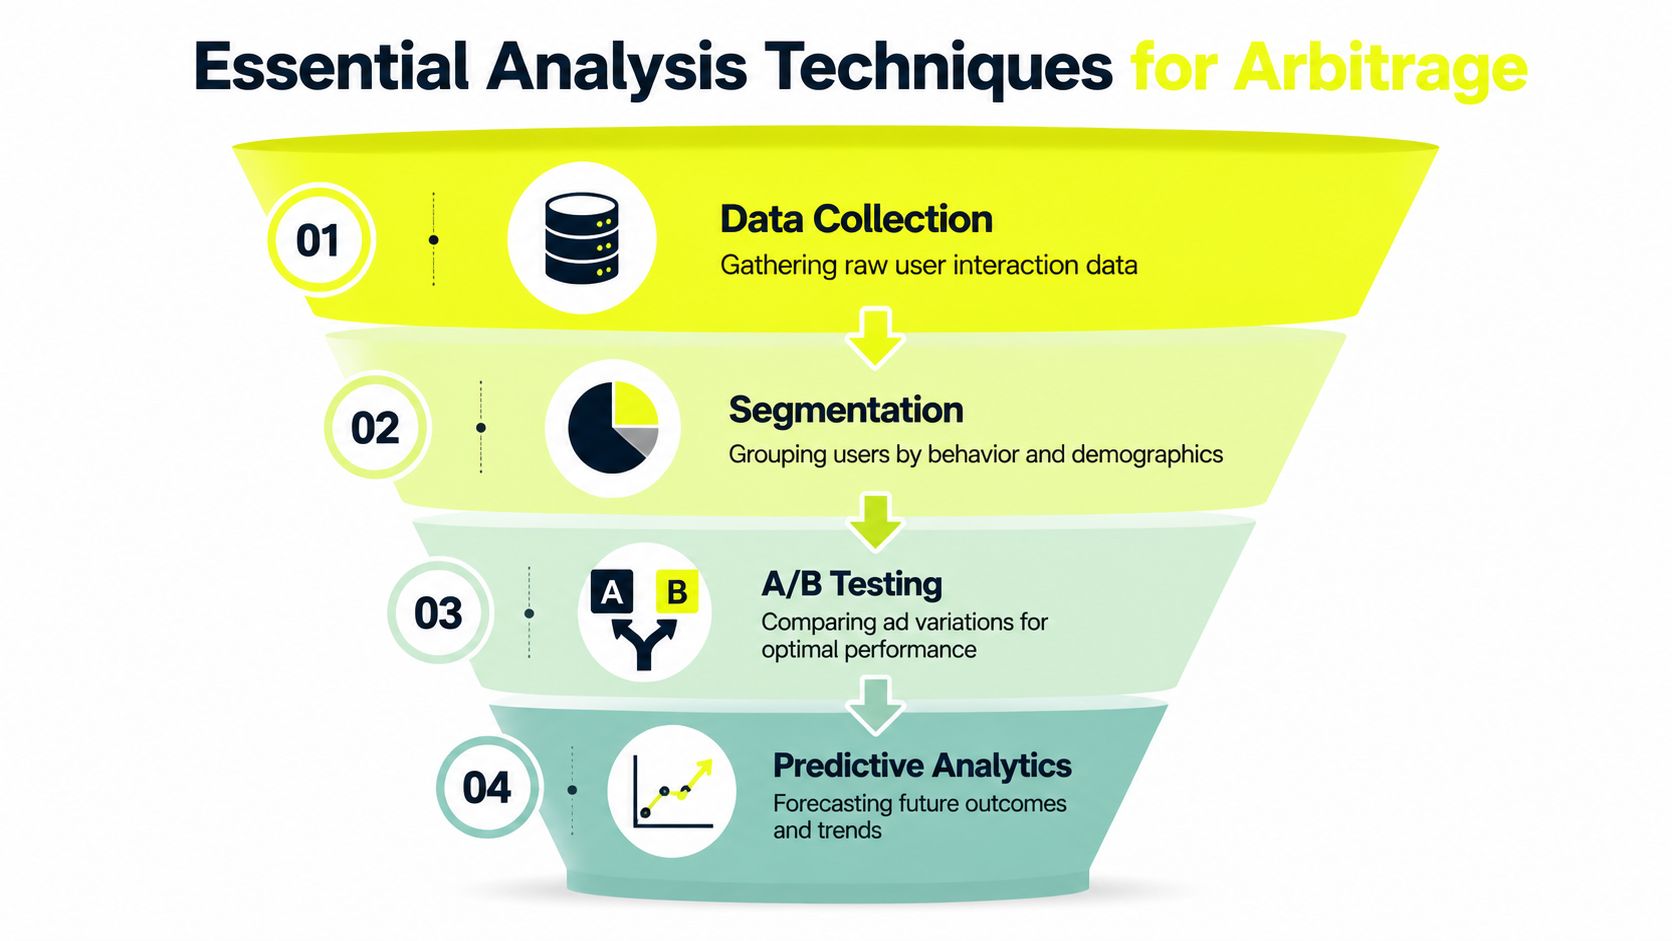
La segmentación conductual supera a los grupos amplios de audiencia
Los segmentos demográficos rara vez ayudan mucho a nivel de compra de medios. El comportamiento sí lo hace.
Un modelo operativo útil es dividir usuarios por estilo de decisión observable:
- Clickers decisivos se mueven limpiamente del anuncio a la oferta con baja vacilación.
- Compradores vacilantes comparan, retroceden, pausan y necesitan una garantía más clara.
- Escépticos de ofertas interactúan pero evitan el paso de compromiso final.
- Tráfico mal dirigido aterriza, escanea y muestra comportamiento de desajuste inmediato.
Esos segmentos son prácticos porque cada uno señala una corrección diferente. Los clickers decisivos usualmente pueden manejar una ruta más corta. Los compradores vacilantes a menudo necesitan menos campos de formulario, precios más claros o marcadores de confianza más fuertes. El tráfico mal dirigido usualmente significa que el creativo, la colocación o la lógica geo está mal.
El mejor segmento es el que le dice al comprador qué cambiar a continuación.
Para equipos que procesan grandes exportaciones de eventos o scrapean estructura de competidores en sus propios modelos, ayuda normalizar esquemas de eventos antes del análisis. Este tutorial sobre trabajo con XML y flujos de datos Python es relevante si tus datos de tráfico o feeds de marketplace llegan en formatos desordenados.
Embudos, cohortes y atribución en recorridos fragmentados
El análisis de cohortes funciona cuando agrupas usuarios por momento u origen de adquisición. Una cohorte de un lote de creativos de TikTok a menudo se comporta muy diferente de una cohorte de retargeting de Facebook, incluso cuando ambas llegan a la misma oferta. El punto no es solo la retención. Es la estabilidad del patrón. Si una cohorte comienza a mostrar más retraso, más bucles de página o acciones downstream más débiles, la calidad de la fuente probablemente cambió.
El análisis de embudo importa aún más en configuraciones pesadas de encubrimiento y prelander. Necesitas mapear los puntos exactos de caída. ¿Los usuarios fallaron antes de la página puente, después de la revelación de la oferta o dentro del flujo de checkout? Los operadores a menudo culpan al anuncio demasiado pronto cuando el problema subyacente radica en el tiempo de redirección, desajuste de página o un elemento específico de región que rompe la confianza.
La atribución es la más desordenada. En rutas de arbitraje reales, los usuarios pueden llegar a TikTok, moverse a WhatsApp, reabrir vía navegador y comprar dentro de una app o carrito externo. La atribución estándar de plataforma única pierde esa cadena. La dependencia de cookies no se sostiene bien en entornos fragmentados, por lo que los equipos usualmente recurren a una mezcla práctica de identificadores de clic, consistencia geo, tiempo de sesión y reconciliación a nivel de oferta.
Las pruebas A/B también pertenecen aquí, pero solo después de que hayas estabilizado la lógica de enrutamiento y seguimiento. Probar creativos sobre un encadenamiento roto solo produce ruido de aspecto más limpio.
Casos de uso y obstáculos en gestión de anuncios
Los errores más grandes en operaciones de cuentas publicitarias no provienen de creativos malos. Provienen de mal control del entorno. Ahí es donde el análisis del comportamiento del consumidor se vuelve operativo, no académico.
Una configuración común se ve así. Un equipo gestiona cuentas publicitarias de Facebook y TikTok a través de AdsPower o Dolphin Anty. Otro equipo maneja landers, lógica de encubrimiento y rotación de gasto. Un tercer equipo vigila aprobación, baneos y salud de cuentas. Si esos grupos no comparten la misma vista de datos de comportamiento, comienzan a resolver el problema equivocado.
Una fuente citada establece que más del 90% de las suspensiones de cuentas publicitarias de Facebook en 2024 fueron disparadas por sistemas automatizados que detectaron actividad sospechosa, principalmente datos de geolocalización inconsistentes, y que emparejar navegadores antidetección con proxies residenciales que coincidan con la ciudad registrada de una cuenta es esencial para evitar la marca de desajuste de ubicación, según este artículo de análisis de comportamiento enfocado en Facebook.
Dónde suelen fallar las granjas de cuentas
La primera ruptura es desajuste IP-a-cuenta. Una cuenta se registra en una ciudad, luego inicia sesión desde otro contexto que no encaja con el comportamiento previo. Eso solo puede disparar presión de revisión.
La segunda ruptura es contaminación cruzada. Los operadores reutilizan huellas de navegador, rutas de sesión o pools de proxies entre cuentas que deberían permanecer aisladas. Luego se preguntan por qué las cuentas saludables comienzan a fallar en clusters.
La tercera ruptura es diagnóstico falso. El comprador ve caer el rendimiento y cambia creativos, presupuestos o reglas de encubrimiento cuando el problema es degradación de confianza de sesión.
Para equipos que trabajan intensamente en Meta, esta guía sobre elegir un proxy para flujos de trabajo de cuentas de Facebook es útil porque la plataforma castiga el manejo descuidado de geo más rápido de lo que a menudo se reconoce.
Si varias cuentas se degradan a la vez, no asumas que la oferta murió. Verifica primero la consistencia de ubicación, aislamiento de navegador y calidad de sesión.
Qué monitorean los buenos operadores entre cohortes de cuentas
Los buenos equipos no solo monitorean conversión. Monitorean deriva de comportamiento entre grupos de cuentas.
- Comportamiento de inicio de sesión de cuenta que repentinamente cambia por región o perfil de navegador.
- Patrones de respuesta creativa que divergen entre tráfico de Facebook y TikTok.
- Vacilación de página de aterrizaje que aparece solo en una rama de campaña geosegmentada.
- Tiempo de revisión y aprobación que comienza a ralentizarse en una cohorte de cuentas cultivadas.
Ese tipo de monitoreo te ayuda a captar actualizaciones de plataforma indirectamente. Ves los síntomas primero. Una cohorte de cuentas comienza a actuar "limpio" en papel pero recibe resultados de revisión más severos. O usuarios de una región comienzan a estancarse en un formulario que antes era estable.
Aquí hay un tutorial útil sobre el entorno más amplio en el que operan estos equipos:
El encubrimiento añade otra capa. Si tu lógica de filtrado envía la variante de página incorrecta a usuarios reales, los datos de comportamiento se vuelven engañosos rápido. Un pico en vacilación podría no significar que la oferta es débil. Podría significar que la ruta limpia y la ruta monetizada ya no se alinean.
Construyendo tu stack tecnológico
Un stack funcional para análisis del comportamiento del consumidor en arbitraje tiene cuatro capas. Recolección, control de identidad, almacenamiento e interpretación. Si una capa es débil, el resto se convierte en limpieza.
Lo que el stack necesita hacer cada día
Primero, necesitas entradas de recolección. Eso usualmente significa exportaciones de plataformas publicitarias, registros de clics, eventos de sitio, herramientas de repetición, datos de mercado scrapeados y señales de moderación de tu equipo de operaciones de cuentas.
Segundo, necesitas aislamiento de identidad. Para esto, navegadores antidetección como AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc importan. No son herramientas analíticas, pero preservan la separación requerida para confiar en el comportamiento adjunto a un perfil o cluster de cuentas.
Tercero, necesitas ejecución respaldada por proxy. Diferentes tareas necesitan diferente enrutamiento. Farming de cuentas, verificaciones de encubrimiento, verificación de anuncios locales, scraping y revisión de campañas geosegmentadas no deberían todas ejecutarse por la misma ruta.
Cuarto, necesitas procesamiento y automatización. Los scripts normalizan registros, etiquetan anomalías de sesión y reconcilian resultados entre plataformas. La automatización de navegador también importa aquí. Si estás instrumentando verificaciones o construyendo trabajos de validación repetibles, esta guía sobre usar Playwright en flujos de trabajo basados en proxy es una referencia práctica.
Un stack esbelto suele ser mejor que uno abarrotado. Si una herramienta no te ayuda a validar geo, aislar identidad, detectar fricción o mejorar asignación de presupuesto, probablemente solo está agregando ruido.
Implementando un sistema de análisis rentable
Comienza con una campaña, un embudo y un grupo de cuentas. No intentes mapear toda la operación el primer día. Limpia la capa de recolección, verifica consistencia geo, etiqueta patrones de vacilación y compara esas señales contra resultados reales de conversión y aprobación.
Luego escala solo lo que permanece confiable. Aplica la misma lógica a tu lote de cuentas de TikTok, tu grupo de retargeting de Facebook o tu set de campañas geo encubiertas. Mantén el aislamiento de cuentas estricto. Mantén la selección de proxy específica de tarea. Mantén el reporte vinculado a acciones que el equipo de compras pueda tomar.
También hay un ángulo de costo práctico aquí. Una fuente citada establece que el programa de referidos de Sota Proxy ofrece hasta 40% de comisión recurrente, lo que puede ayudar a compensar el gasto de infraestructura mientras los equipos expanden el uso de proxies a través de 220+ geolocalizaciones y gestionan 100+ cuentas publicitarias simultáneas para farming de cuentas, según esta referencia a infraestructura de investigación de comportamiento del consumidor.
Un sistema de análisis de comportamiento del consumidor rentable no es el que tiene el dashboard más bonito. Es el que ayuda al equipo a tomar menos malas decisiones, perder menos cuentas y mover presupuesto más rápido hacia tráfico que resiste el escrutinio.
Si estás ejecutando granjas de cuentas, campañas geosegmentadas, pipelines de scraping o verificación de anuncios a escala, Sota Proxy te da la capa de infraestructura que mantiene los datos lo suficientemente limpios para confiar. Soporta enrutamiento residencial, móvil, ISP, datacenter e IPv6 a través de 220+ geolocalizaciones, lo que encaja con flujos de trabajo reales detrás de AdsPower, Dolphin Anty, GoLogin, Multilogin y otras configuraciones de múltiples cuentas. Para operadores que necesitan enrutamiento estable, segmentación a nivel de ciudad y espacio para escalar sin reconstruir el stack cada mes, es un lugar práctico para comenzar.
Artículos relacionados
Integración de Proxy en AdsPower: La Guía Completa de Configuración
Integración paso a paso de proxy en AdsPower con SotaProxy. Cubre configuración, tipos de proxy, rotación, solución de problemas y mejores prácticas para flujos de trabajo con múltiples cuentas.
7 Mejores Proveedores de Proxies para Arbitraje y Scraping
Compara 7 proveedores de proxies destacados según tipos de IP, segmentación, rotación, uptime, señales de precios y adecuación para scraping, cuentas publicitarias, farming y arbitraje.
Los 10 Mejores Servicios de Proxy para Anuncios, Scraping y Automatización
Compara los mejores servicios de proxy para verificación de anuncios, scraping, operaciones de cuentas y geo-targeting según tipo de IP, precio, tiempo de actividad y controles.
10 Alternativas a Smartproxy para Equipos Técnicos
Compara 10 alternativas a smartproxy según tipo de proxy, calidad de IP, segmentación, rotación, velocidad, precios y caso de uso para equipos técnicos.
10 Alternativas a IPRoyal para Cargas de Trabajo Proxy Serias
Compara 10 alternativas a IPRoyal para scraping, verificación de anuncios, gestión de cuentas, navegadores antidetección, campañas geo, precios, rotación y soporte.
10 Alternativas a Oxylabs para Scraping y Operaciones Publicitarias
Compara 10 alternativas a Oxylabs por tipo de proxy, cobertura geográfica, tiempo de actividad, rotación, precios y caso de uso para scraping, verificación de anuncios y gestión de cuentas.