Problemas de Resolución DNS: Solución Avanzada 2026
Soluciona problemas de resolución DNS para scrapers y campañas publicitarias. Guía que cubre herramientas CLI, limpiezas de caché y correcciones específicas de proxies.
Tus proxies están activos. Los anuncios están gastando. Los perfiles de AdsPower o GoLogin se ven limpios. Las cuentas de Facebook y TikTok inician sesión. Luego, la página de destino no abre en la región objetivo, el cloak devuelve la página incorrecta, o tu scraper empieza a lanzar errores de host aleatorios. Ahí es donde la gente suele culpar primero al pool de proxies.
La mayoría de las veces, el proxy no es el problema raíz. Es el DNS.
Para equipos de arbitraje de tráfico, compradores de medios y configuraciones de farming de cuentas, los problemas de resolución DNS no se comportan como un problema ordenado de red de oficina. Aparecen como redirecciones muertas, páginas geo desajustadas, verificaciones inestables, flujos de calentamiento rotos en navegadores antidetección como AdsPower, Dolphin Anty, GoLogin, Multilogin y Hidemyacc, y acciones de cuenta que parecen sospechosas porque el navegador, la salida del proxy y la ruta del resolver no coinciden. Si ejecutas cloaking, campañas geo-segmentadas, scraping u operaciones multi-cuenta, el DNS no es fontanería de fondo. Decide si la solicitud incluso llega al lugar correcto.
Tabla de Contenidos
- Por Qué las Fallas de DNS Arruinan tus Operaciones
- Lista de Verificación de Diagnóstico en 5 Minutos
- Solución Sistemática Desde el Cliente hasta el ISP
- Diagnósticos Avanzados con Dig y Nslookup
- Resolviendo Desafíos DNS Específicos de Proxies
- Estrategia DNS Preventiva para Operaciones de Alto Riesgo
Por Qué las Fallas de DNS Arruinan tus Operaciones
Un patrón de falla común se ve así. Una campaña geo-segmentada se pone en marcha, el gasto comienza y las conversiones se mantienen planas. La cuenta de anuncios de Facebook está bien. La cuenta de anuncios de TikTok está bien. El gateway del proxy responde. Pero los usuarios en el país objetivo nunca llegan a la página de destino prevista porque la resolución falla o resuelve a infraestructura obsoleta.
Por eso los problemas de resolución DNS golpean más fuerte en ad-tech y trabajo multi-cuenta que en una configuración de oficina normal. No solo estás cargando un sitio desde un ISP. Estás rotando identidades, cambiando geos, verificando vistas previas de anuncios, validando cadenas de redirección y sincronizando lo que la plataforma objetivo ve entre huella digital del navegador, IP y ubicación. Si el DNS falla en una región, tus números pueden colapsar mientras el resto del stack aún se ve saludable.
El punto único de falla oculto
Internet aún tiene riesgo de concentración en la capa de resolver. Google y Cloudflare responden casi el 50% de todas las consultas DNS globales, según las mediciones del mercado de resolvers de RIPE. Si uno de esos proveedores se ralentiza, una gran parte de las búsquedas se ralentizan con él. Eso puede romper ejecuciones de scraping, verificación de anuncios y flujos de trabajo de cuentas incluso cuando tus proxies están en línea y responden.
Regla práctica: Si las solicitudes fallan antes de que TLS siquiera comience, deja de culpar primero al sitio objetivo. Verifica la resolución de nombres.
Para el farming de cuentas, esto importa porque la resolución inconsistente crea desviación de comportamiento. El perfil abre a través de una IP de salida, pero la respuesta DNS llega desde una ruta diferente o expira, por lo que se activan reintentos, los activos se cargan a medias y los sistemas de riesgo de la plataforma ven sesiones inestables. Para el cloaking, el daño es más directo. Los bots de revisión, los usuarios y tu propio equipo de QA pueden resolver respuestas diferentes en momentos diferentes.
Por qué las configuraciones pesadas en proxies lo sienten primero
Los usuarios de proxies amplifican el estrés del DNS porque crean más piezas móviles:
- Los navegadores antidetección mantienen las huellas digitales del navegador aisladas, pero no arreglan mágicamente el desajuste del resolver.
- Las rotaciones residenciales y móviles cambian el contexto de red rápidamente, lo que puede exponer rutas de resolver débiles.
- Los proxies de datacenter e IPv6 pueden parecer estables hasta que el objetivo depende de registros que no fueron probados.
- Las verificaciones geo y de anuncios fallan temprano porque el DNS es la primera puerta.
Cuando la gente dice "el proxy es malo", a menudo se refieren a una de tres cosas: el resolver adjunto a esa ruta es lento, la respuesta autoritativa es inconsistente por región, o la solicitud DNS se filtró fuera del túnel previsto. Esos son problemas de DNS vestidos con ropa de proxy.
Lista de Verificación de Diagnóstico en 5 Minutos
Cuando una página de destino no resuelve o un scraper empieza a lanzar errores de host, necesitas triage, no teoría. El objetivo en los primeros cinco minutos es simple: decidir si la falla está en tu máquina, tu red local, tu resolver configurado o la ruta del proxy.
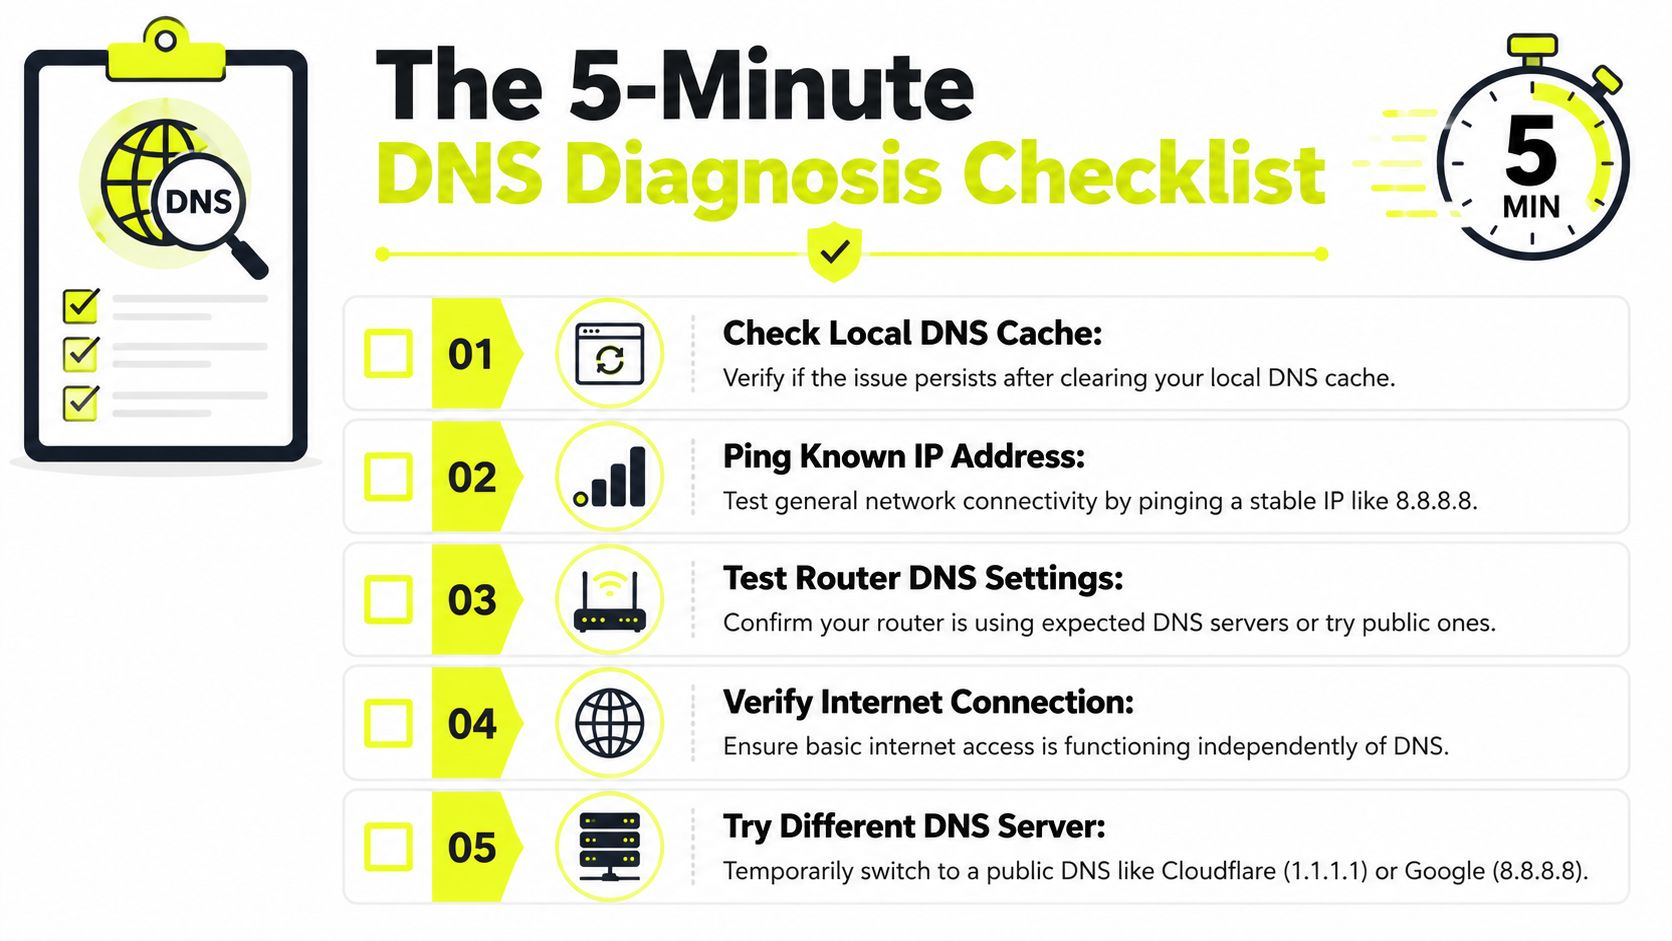
Un punto de referencia útil: una respuesta DNS en caché normal se completa en menos de 1ms, mientras que una resolución sin caché puede tomar 50–200ms. Si las búsquedas siguen pasando de 200ms, has encontrado un cuello de botella real, como se describe en el artículo de solución de problemas DNS de OneUptime.
Ejecuta estas verificaciones en orden
Prueba primero la conectividad básica
Si la red está muerta, las pruebas de DNS pierden tiempo.
ping 8.8.8.8Patrón saludable: las respuestas regresan.
Patrón problemático: tiempos de espera o errores inalcanzables. Eso apunta a conectividad más amplia, no solo DNS.
Prueba la resolución con tu resolver actual
Usa:
nslookup example.comPatrón saludable: obtienes una respuesta rápidamente y el resolver mostrado es el que esperas.
Patrón problemático: tiempo de espera, SERVFAIL, o un resolver que no pretendías usar.
Mira el estado de la caché local en Windows
Usa:
ipconfig /displaydnsPatrón saludable: existen entradas para nombres visitados recientemente y no se ven obsoletas.
Patrón problemático: sin entradas útiles, o las entradas siguen repoblándose con respuestas incorrectas después de limpiezas.
Compara con un resolver público
Cambia temporalmente el sistema o router a un resolver público y prueba de nuevo. Esto aísla rápidamente problemas del resolver del lado del ISP.
Verifica si el proxy cambia el resultado
Resuelve el mismo host con y sin la ruta del proxy. Si el directo funciona y el proxy falla, estás lidiando con comportamiento DNS del proxy, no solo DNS local.
Si la navegación directa funciona pero el mismo dominio falla en AdsPower, Dolphin Anty, Multilogin o Hidemyacc, trata el perfil del navegador y la ruta del proxy como capas separadas. No los agrupes.
Tabla de interpretación rápida
| Verificación | Señal saludable | Señal mala | Lo que usualmente significa |
|---|---|---|---|
| Ping IP estable | Respuestas | Sin respuestas | Problema general de red |
| Nslookup por defecto | Respuesta rápida | Tiempo de espera o SERVFAIL | Problema de resolver |
| Vista de caché local | Entradas esperadas | Entradas incorrectas u obsoletas | Contaminación de caché local |
| Reprueba resolver público | Misma respuesta o más rápida | Funciona solo en resolver público | Problema de resolver del ISP |
| Proxy vs directo | Mismo resultado | La ruta del proxy falla | Desajuste DNS del proxy o fuga |
Si necesitas una lista de verificación del lado del proveedor para el comportamiento de conexión, Sota Proxy mantiene una página de FAQ de proxies práctica que es útil cuando estás separando síntomas DNS de problemas de autenticación o enrutamiento.
No diagnostiques en exceso demasiado pronto
La gente pierde tiempo aquí saltando directamente a la captura de paquetes. Empieza más pequeño. Si un dominio resuelve bien directamente pero falla solo dentro de un flujo de campaña geo-segmentada, la primera sospecha debería ser desajuste de ruta del resolver. Eso es común en verificaciones de anuncios de Facebook y TikTok donde la página misma carga en una ruta pero activos de terceros, endpoints de seguimiento o hosts de redirección dependen de otra.
Solución Sistemática Desde el Cliente hasta el ISP
Una vez que el triage rápido apunta al DNS, trabaja hacia arriba en el stack en un orden fijo. Los cambios aleatorios hacen que los problemas de resolución DNS sean más difíciles de aislar porque las cachés y las funciones del navegador ocultan la fuente real.
La orientación de la industria pone el DNS sin caché bajo 100ms para una buena experiencia de usuario, y los retrasos por encima de 200 a 300ms se vuelven notables, especialmente en resolvers de ISP débiles en algunas regiones, como se describe en la inmersión profunda de monitoreo DNS de LogicMonitor. Para verificación de anuncios, scraping y flujos de redirección de múltiples pasos, esos retrasos se acumulan rápido.
Limpia primero el estado del lado del cliente
Limpia la caché del sistema operativo antes de tocar resolvers.
Windows
ipconfig /flushdns
macOS
sudo dscacheutil -flushcache; sudo killall -HUP mDNSResponder
Linux con systemd-resolved
resolvectl flush-caches
Luego reinicia el perfil del navegador que está fallando. En navegadores antidetección, usa el perfil que está fallando. No pruebes en tu ventana normal de Chrome y asumas que el resultado aplica a AdsPower o GoLogin.
Las correcciones de DNS que solo funcionan en un navegador estándar pero no en el perfil antidetección usualmente apuntan a configuraciones de DNS-over-HTTPS a nivel de perfil, estado de host en caché o manejo específico del proxy.
Verifica el comportamiento DNS del navegador
Los navegadores modernos pueden eludir tu resolver del sistema operativo con DNS-over-HTTPS. Eso es útil para privacidad. Es terrible para depuración si olvidaste que está habilitado.
Busca estos patrones de falla:
- El navegador funciona, CLI falla: el navegador puede estar usando DoH mientras el sistema usa un resolver roto.
- CLI funciona, el navegador falla: el navegador puede tener caché de host obsoleta, problemas con DoH o problemas de integración del proxy.
- Un perfil falla, otro funciona: el problema es específico del perfil, no del sistema completo.
En herramientas basadas en Chrome, inspecciona la configuración de DNS seguro y prueba con ella activada y desactivada. Luego reinicia el perfil. No cambies tres cosas a la vez.
Pasa a la configuración del resolver y router
Si la limpieza del lado del cliente no lo arregla, inspecciona el resolver configurado por DHCP, router o VPN. Muchos equipos dejan esto en el predeterminado del ISP hasta que una campaña empieza a fallar.
Usa estos comandos en Linux:
cat /etc/resolv.conf
resolvectl status
En Windows, inspecciona la configuración DNS del adaptador con PowerShell o la GUI. En macOS, revisa los servidores DNS del servicio de red.
Una secuencia de eliminación práctica:
- Usa el resolver actual y prueba.
- Cambia a un resolver público conocido y prueba.
- Prueba a través de la ruta del proxy y compara.
- Revierte un cambio a la vez para que sepas qué lo resolvió.
Si tu entorno también lidia con interferencia de firewall, este breve artículo sobre servidores proxy y firewalls es relevante porque el tráfico UDP filtrado o interceptado a menudo se malinterpreta como falla pura de DNS.
Detecta interferencia del ISP
Algunos ISPs secuestran o filtran el comportamiento del DNS. Lo reconocerás cuando el resolver configurado no coincida con el servidor que responde, o cuando las consultas directas a resolvers esperados se comporten extrañamente mientras la navegación web aún "medio funciona".
Usa:
traceroute example.com
y verificaciones básicas de latencia contra el resolver mismo.
Estás buscando patrones, no fallas únicas:
- alta latencia al resolver
- respuestas inconsistentes en consultas repetidas
- navegación directa que solo funciona porque el navegador almacenó en caché respuestas anteriores
- fallas de región objetivo que desaparecen cuando cambias resolvers
Reconoce cuándo el problema no es local
Si múltiples máquinas, múltiples perfiles antidetección y múltiples salidas de proxy muestran la misma falla al mismo tiempo, deja de ajustar la configuración del navegador. Eso apunta upstream. Puede ser el resolver del ISP, el resolver público del que dependes o la cadena de nameserver autoritativo para el dominio.
En ese punto, la limpieza del cliente está hecha. Consulta la cadena directamente.
Diagnósticos Avanzados con Dig y Nslookup
Las verificaciones básicas te dicen que algo está mal. dig y nslookup te dicen dónde.
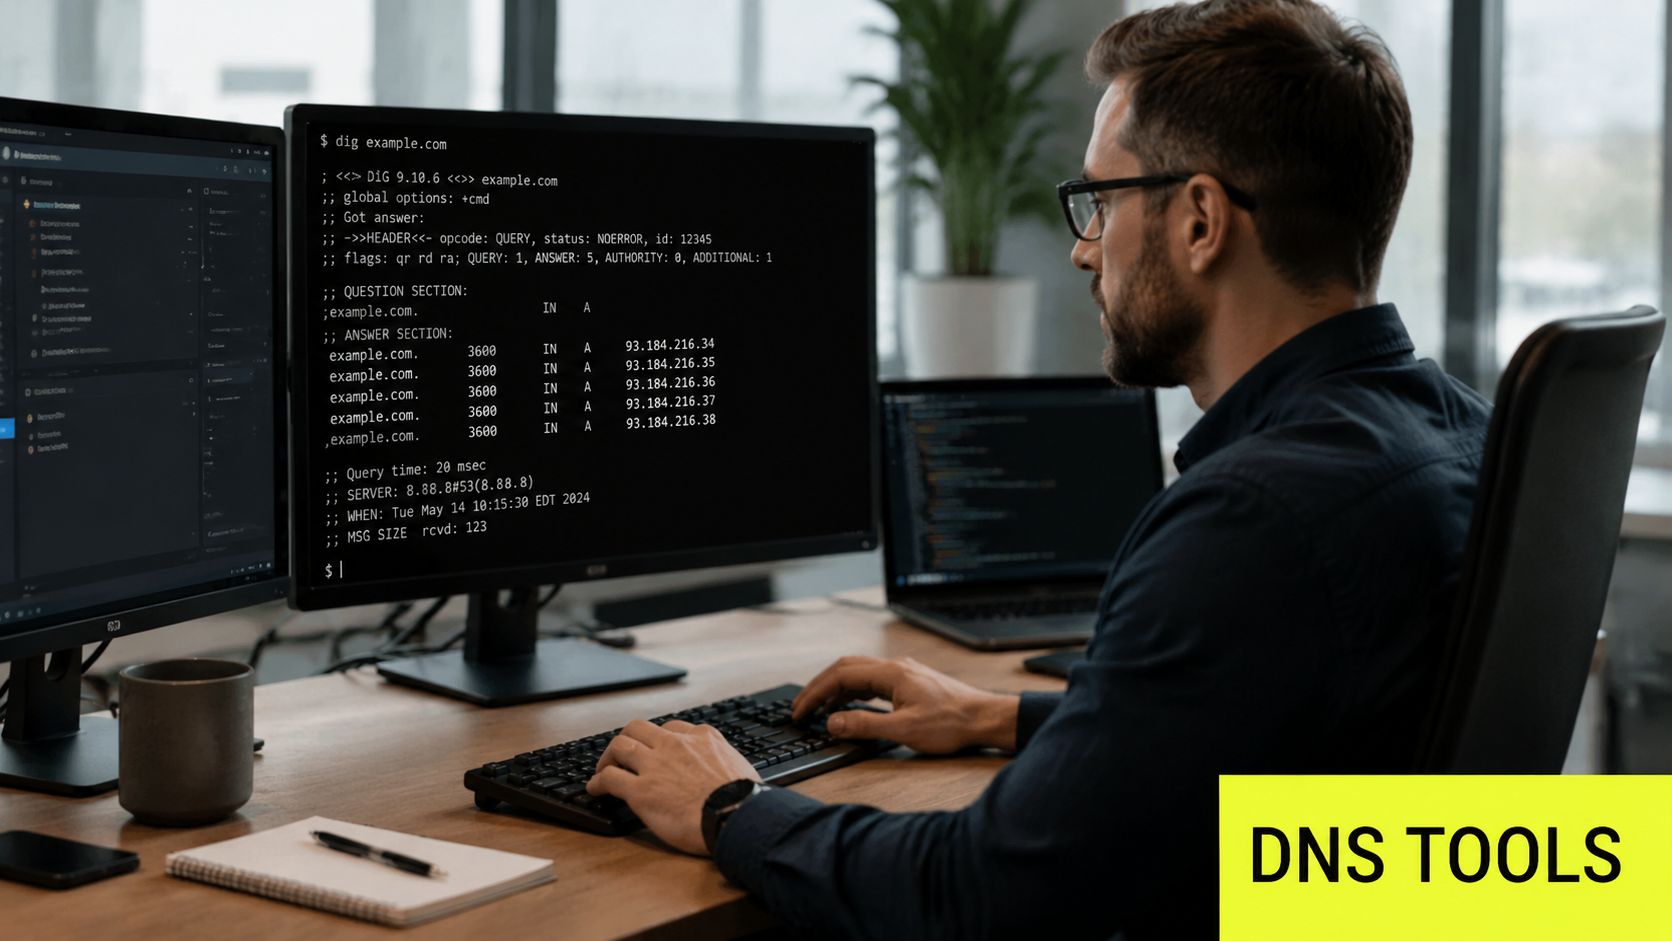
Cuando ejecutas infraestructura de scraping, verificación geo o enrutamiento encubierto, necesitas saber qué respuesta devuelve un resolver específico, si la delegación está intacta y si IPv4 e IPv6 se comportan de manera diferente. Ese último punto importa mucho. La falla de consulta AAAA está en 64.2% globalmente, versus 12.5% para consultas A de IPv4, basado en la medición de APNIC de fallas DNS en el mundo real. Si usas proxies IPv6, el manejo AAAA roto puede parecer inestabilidad aleatoria del proxy cuando en realidad es DNS.
Consulta el resolver que realmente usas
Comienza con el resolver por defecto:
dig example.com
Luego compáralo con un resolver específico:
dig @1.1.1.1 example.com
dig @8.8.8.8 example.com
Verifica:
- ANSWER SECTION. ¿Obtuviste el registro que esperas?
- Query time. ¿Es consistentemente lento?
- SERVER. ¿Qué resolver respondió?
- Status.
NOERROR,SERVFAILyNXDOMAINsignifican cosas muy diferentes.
nslookup es menos detallado, pero sigue siendo útil para una verificación rápida de cordura:
nslookup example.com
Si la respuesta cambia entre resolvers, deja de asumir que el problema es local. Estás viendo diferencias de propagación, comportamiento del resolver o ruptura upstream.
Para equipos que comparan familias de direcciones en stacks de automatización, esta página de glosario IPv4 vs IPv6 es una referencia útil cuando una ruta de proxy se ve saludable en registros A pero se desmorona en AAAA.
Prueba tipos de registro que rompen flujos de trabajo reales
Muchos usuarios solo consultan registros A. Eso se pierde mucho.
Para trabajo de ad-tech y cuentas, también prueba:
dig example.com Adig example.com AAAAdig example.com CNAME
Usa eso cuando:
- un dominio encubierto resuelve para tráfico de escritorio pero no para sesiones de proxy móvil
- una ruta de revisión de Facebook alcanza un objetivo diferente al de tu ruta de usuario
- un proxy IPv6 sale limpiamente pero el host carece de manejo AAAA válido
- los activos de terceros fallan mientras el lander principal carga
El manejo AAAA roto desperdicia horas porque el síntoma parece una subred de proxy mala. Prueba el registro directamente antes de rotar todo el pool.
Un recorrido visual rápido ayuda si necesitas explicar esto a un compañero de equipo o VA que gestiona infraestructura de cuentas:
Rastrea la delegación cuando las respuestas se ven inconsistentes
Si un resolver dice que el nombre existe y otro dice que no, rastrea la cadena:
dig +trace example.com
Esto evita mucha conjetura. Puedes ver si el problema comienza en la delegación, respuesta del nameserver autoritativo o en algún lugar de la resolución recursiva.
Usa +trace cuando:
- un dominio fresco para cloaking se comporta diferente por región
- un registro recientemente cambiado aún sirve destinos obsoletos
- un perfil de navegador antidetección resuelve y otro no
- los bots de vista previa de TikTok y tu propia estación de trabajo de QA no alcanzan el mismo host
El hábito más fuerte aquí es simple. Consulta el resolver por defecto, consulta un resolver externo conocido, luego rastrea la cadena. Esa secuencia convierte problemas de resolución DNS vagos en evidencia.
Resolviendo Desafíos DNS Específicos de Proxies
Los proxies cambian quién hace la solicitud. El DNS decide quién encuentra el destino. Si esos dos no se alinean, tu configuración tiene fugas.
Eso importa más en farming de cuentas, cloaking, verificación de anuncios y pruebas regionales. Un navegador en Multilogin o Dolphin Anty podría presentar una IP al sitio objetivo mientras la resolución DNS ocurre fuera de la ruta del proxy. El resultado es un desajuste entre la identidad de red visible y la geografía del resolver. Las plataformas no necesitan conocer tu IP real para que eso se convierta en un problema de confianza.
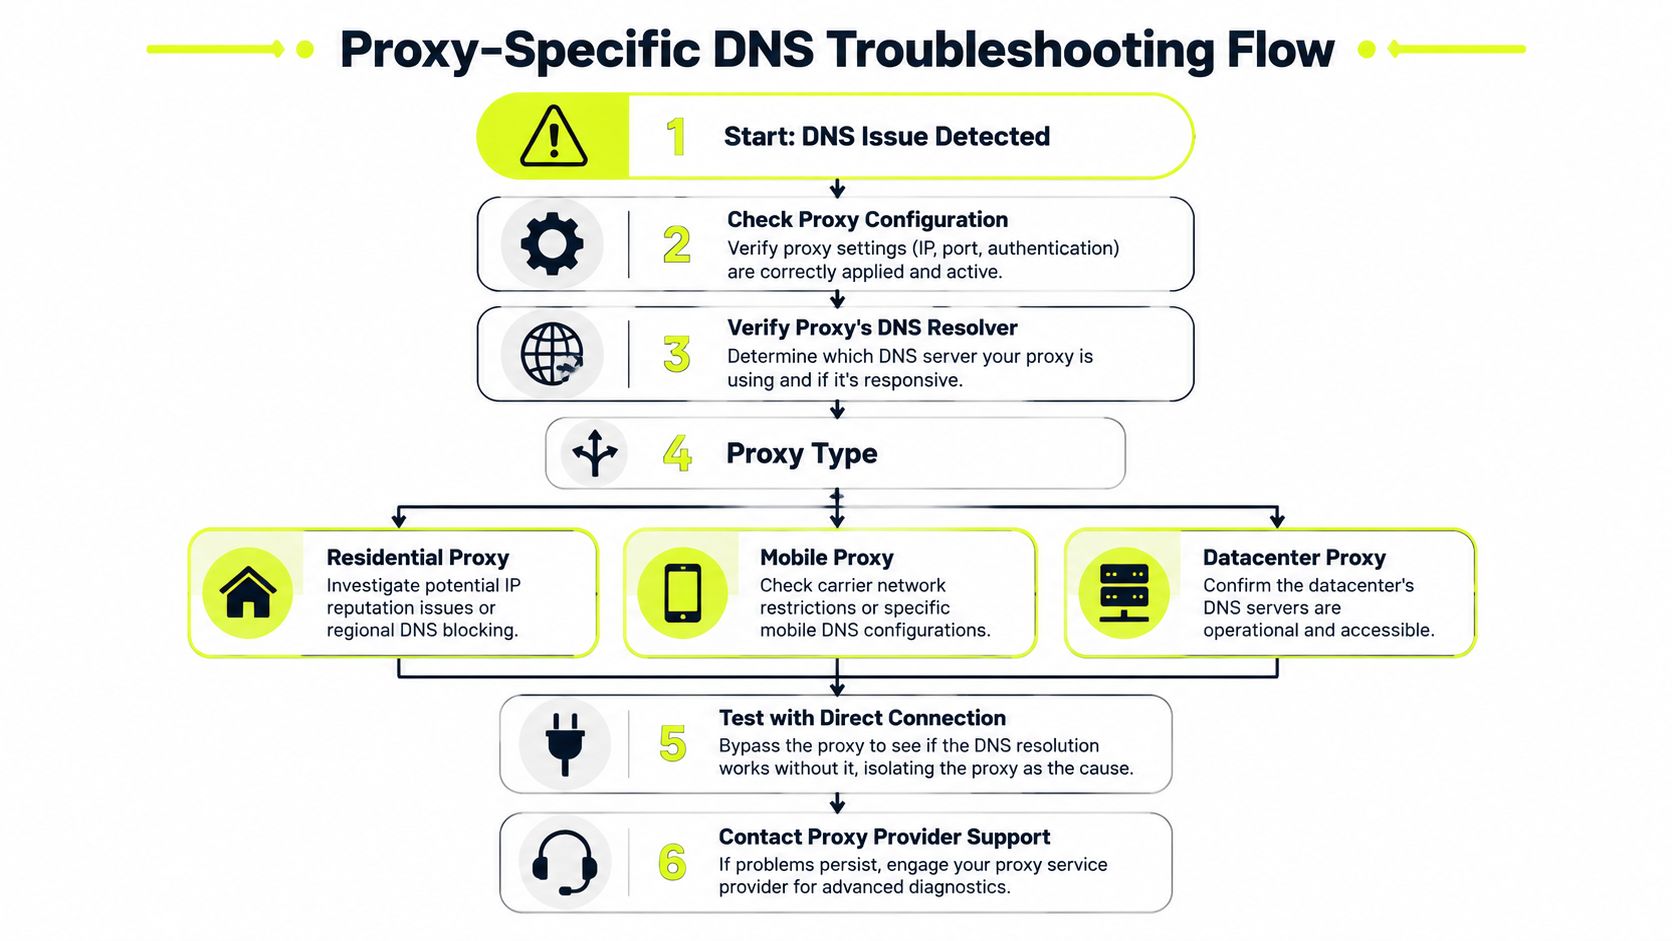
Qué cambia según el tipo de proxy
Cada tipo de proxy crea diferentes modos de falla de DNS.
- Los proxies residenciales se ven más cercanos al tráfico normal de usuario, pero pueden sufrir de inconsistencia del resolver ligada al diseño de enrutamiento del proveedor. Lo difícil es que las fallas pueden aparecer solo en ciertas geos o solo después de la rotación.
- Los proxies móviles heredan el comportamiento del operador. Eso puede ser útil para confianza en cuentas de anuncios de Facebook y TikTok, pero las rutas DNS del operador pueden cambiar con las condiciones de red y la rotación.
- Los proxies de datacenter son más fáciles de comparar y usualmente más estables operacionalmente. También son más fáciles de clasificar para los objetivos, por lo que la consistencia del DNS sola no los hará parecer residenciales.
- Los proxies IPv6 pueden ser rápidos y abundantes, pero son menos indulgentes cuando los registros DNS están incompletos o rotos. Si la ruta IPv6 del host es débil, el proxy es culpado.
Cómo probar fugas que importan
El hecho clave con las configuraciones residenciales es contundente: las fugas de DNS a menudo provienen de las propias fallas de enrutamiento del servicio de proxy, no solo de error del usuario, y la única verificación confiable es probar la resolución desde la ruta del servidor proxy mismo, como se describe en esta nota sobre fugas DNS de proxy residencial.
Eso significa que debes comparar tres cosas:
- Resolución directa desde tu máquina local
- Resolución cuando el navegador usa el proxy
- Lo que el destino ve desde esa sesión
Si los resultados directos y con proxy difieren, no te detengas en "ahora funciona". Averigua si el navegador usó DNS local, DoH del navegador o el resolver propio del proxy.
Un flujo de trabajo práctico para AdsPower, GoLogin, Multilogin y Hidemyacc:
- Deshabilita temporalmente el DNS seguro a nivel del navegador mientras pruebas. Necesitas una vista limpia primero.
- Ejecuta la misma búsqueda de host en un shell sin proxy y un flujo de aplicación con proxy.
- Compara el comportamiento de la página de destino específico de la región, no solo si la página de inicio abre.
- Verifica hosts de terceros usados para rastreadores, scripts y redireccionadores. Esos a menudo fallan antes que el dominio principal.
Si necesitas un desglose dedicado de cómo se comporta el DNS del proxy, este artículo sobre qué es el DNS del proxy cubre las partes móviles claramente.
Una sesión no es limpia solo porque el dominio principal cargó. Si un host de rastreador, host de redirección o endpoint de cloaking resuelve fuera de la ruta prevista, el perfil de sesión es inconsistente.
Un punto operacional más. En granjas de cuentas, los equipos a menudo rotan proxies más rápido de lo que verifican el comportamiento del DNS. Eso está al revés. Las sesiones pegajosas con DNS validado son usualmente más seguras que la rotación rápida con rutas de resolver no verificadas. La misma lógica aplica a campañas geo-segmentadas. Una ruta residencial o móvil estable con DNS coherente supera a un pool más grande que resuelve impredeciblemente.
Estrategia DNS Preventiva para Operaciones de Alto Riesgo
La solución de problemas reactiva evita que el gasto se queme más tiempo del necesario. La política DNS preventiva evita que el problema aparezca durante las ventanas de lanzamiento.
Para operadores que ejecutan cloaking, rotan creatividades de anuncios, granjas de cuentas, flotas de scrapers y verificaciones geo-segmentadas, la parte preventiva se reduce a elección de resolver, política de navegador, disciplina de TTL y selección de proxy que no introduce desajuste de DNS.
Establece la política de resolver con propósito
No dejes la elección del resolver a lo que DHCP entrega. Elige una política y aplícala en máquinas, navegadores y nodos de automatización.
Usa una lista de verificación corta:
- Estandariza la ruta del resolver en tus estaciones de trabajo y cajas de campaña.
- Decide dónde se permite DoH y dónde debe permanecer desactivado para consistencia.
- Valida por geografía antes del lanzamiento, no después de que el gasto comience.
- Mantén un resolver de respaldo limpio para comparación de emergencia.
Cuando trabajas con rutas IPv6, úsalas deliberadamente. No las habilites en todas partes solo porque el pool está disponible. Si tu operación depende de esas salidas, revisa los detalles del servicio de proxy IPv6 del proveedor y prueba tu stack objetivo contra el comportamiento real del registro antes de cambiar el tráfico de producción.
Usa el TTL como un control operacional
El TTL del registro DNS no debe exceder 86400 segundos, y para operaciones dinámicas como cloaking o rotación de creatividades de anuncios, un TTL de 6 horas o menos es esencial, basado en la guía de Cloudflare sobre problemas comunes de DNS.
Eso importa porque el DNS obsoleto rompe operaciones de movimiento rápido de formas silenciosas:
- el objetivo de redirección antiguo permanece activo más tiempo del previsto
- el tráfico de revisión llega a infraestructura desactualizada
- una región ve la nueva ruta mientras otra aún ve la antigua
- el QA de la campaña reporta "funciona para mí" mientras los usuarios obtienen una respuesta diferente
Un TTL más corto no siempre es mejor para todo. Los cambios extremadamente agresivos pueden aumentar la rotación de consultas y exponer comportamiento de caché débil. Pero para flujos de trabajo de ad-tech que cambian endpoints a menudo, los TTLs largos crean más dolor del que ahorran.
Trata el TTL como política de despliegue, no como una casilla que llenas una vez y olvidas.
Si recomiendas infraestructura a otros operadores, hay otro ángulo práctico. La infraestructura de proxy confiable es algo de lo que los equipos hablan en chats privados, grupos de compra y redes de socios. Sota Proxy también tiene un programa de referidos con hasta 40% de comisión, lo cual tiene sentido para afiliados y creadores de herramientas que ya envían personas hacia configuraciones de proxy estables y quieren un incentivo recurrente adjunto a esas recomendaciones.
Si tu operación depende de geo-segmentación limpia, sesiones de cuenta estables y comportamiento DNS predecible a través de IPs residenciales, móviles, ISP o datacenter, Sota Proxy vale la pena considerar. La plataforma está construida para equipos que ejecutan scraping, verificación de anuncios y cargas de trabajo multi-cuenta a escala, y está respaldada por soporte humano cuando una ruta de resolver, perfil de navegador o ruta de proxy necesita solución real de problemas en lugar de respuestas enlatadas.
Artículos relacionados
Monitoreo en Tiempo Real
Monitoreo en tiempo real. Supervisión en tiempo real para redes de proxies, cuentas publicitarias y stacks de scraping. Métricas, alertas, SLAs y tácticas prácticas
Redundancia de Red para Plataformas de Proxy y Automatización
Descubre cómo la redundancia de red mantiene en línea las plataformas de proxy y automatización. Cubre configuraciones activo/pasivo, clústeres multirregión, ajuste de conmutación por error y disponibilidad del 99.9%
Distribución Geográfica para Infraestructura de Proxy
Domina la distribución geográfica para infraestructura de proxy. Aprende a elegir ubicaciones, tipos de proxy y estrategias de enrutamiento para verificación de anuncios y scraping
Qué es Sticky Session: Guía Técnica para Usuarios de Proxies
Descubre qué es sticky session, cómo funciona la afinidad de sesión en balanceadores de carga y proxies, y cuándo usarla para multi-accounting, scraping y campañas publicitarias.
Cómo Evitar CAPTCHA en Flujos de Trabajo Automatizados
Aprende cómo evitar CAPTCHA en flujos de trabajo automatizados con tácticas de proxies, navegadores antidetección, control de ritmo de solicitudes y respaldos de resolución diseñados para operadores reales.
Integración de Proxy en AdsPower: La Guía Completa de Configuración
Integración paso a paso de proxy en AdsPower con SotaProxy. Cubre configuración, tipos de proxy, rotación, solución de problemas y mejores prácticas para flujos de trabajo con múltiples cuentas.