Amazon Scrape API: Создание масштабируемого конвейера данных
Создайте надёжный Amazon Scrape API. Это руководство охватывает архитектуру прокси, конструирование запросов, обработку CAPTCHA и парсинг данных для технических специалистов.
Ваш парсер Amazon, скорее всего, отлично работал на десяти URL в локальном тесте. Затем вы запустили его в production, направили на реальные объёмы, и Amazon ответил ошибками 503, страницами с CAPTCHA, сломанными сессиями и мёртвыми IP. Такой сценарий отказа - норма.
Особенно больно он бьёт, когда парсинг связан с денежным потоком. Команды трафик-арбитража нуждаются в свежих данных о товарах и ценах для геотаргетированных кампаний. Медиабайерам нужно проверять локализованные офферы перед тем, как лить бюджет на рекламные аккаунты Facebook и TikTok. Операторы мультиаккаунтов, работающие в AdsPower, Dolphin Anty, GoLogin, Multilogin или Hidemyacc, нуждаются в стабильном сборе данных, который не отравит тот же слой прокси, используемый для фарма аккаунтов, клоакинга и верификации.
Рабочая настройка Amazon scrape API - это не скрипт. Это инфраструктура. Команды, которые масштабируются, относятся к прокси, проектированию запросов, парсингу и доставке данных как к единой production-системе. Если вы по-прежнему воспринимаете выбор прокси как галочку в конце чек-листа, вы будете продолжать перестраивать один и тот же сломанный стек.
Оглавление
- Дальше простого скрипта
- Проектирование отказоустойчивой архитектуры парсинга
- Реализация стратегического плана по прокси
- Создание необнаружимых запросов
- Нейтрализация CAPTCHA и детекта ботов
- Парсинг данных и гарантия доставки
- Операционный мониторинг и соответствие требованиям
Дальше простого скрипта
Первое ложное предположение - думать, что Amazon блокирует только агрессивных парсеров. Это не так. Amazon блокирует непоследовательное поведение. Скрипт, который запрашивает несколько страниц товаров с одним набором заголовков, одной банкой cookies и одним прокси, может отлично выглядеть на staging и всё равно упадёт в момент, когда вы добавите конкурентность.
Я видел одну и ту же картину в системах верификации рекламы и фермах аккаунтов. Одна команда парсит локализованные цены Amazon, чтобы выровнять клоакнутые лендинги с регионом, показанным в рекламном аккаунте Facebook. Другая команда проверяет офферы продавцов перед запуском кампании в TikTok, привязанной к узкой зоне доставки. Обе начинают с простого Python-воркера. Обе в итоге узнают, что скрипт - это не продукт. Система вокруг него - вот что важно.
Практическое правило: Если ваш парсер Amazon зависит от одного процесса, который последовательно выполняет запросы, парсинг, повторы и хранение, он будет падать шумно и часто.
Парсинг Amazon становится сложнее, когда он привязан к другим операционным системам. Если те же операторы также управляют профилями в AdsPower или GoLogin, или запускают потоки фарма аккаунтов в Dolphin Anty и Multilogin, плохая гигиена прокси распространяется на все рабочие процессы. Сожгите подсеть в парсинге, потом используйте её повторно для логинов - и вы создадите себе проблему с доверием.
Вот почему серьёзная сборка Amazon scrape API начинается с разделения зон ответственности. Парсинг работает на собственной политике запросов, пуле прокси, политике cookies и data pipeline. Управление аккаунтами - на другой.
Если вы всё ещё находитесь на стадии скрипта, это точка, где нужно перестать накладывать заплатки и начать перестраивать систему с более чёткими границами. Хорошая основа по фундаментальным принципам краулера - это руководство по веб-краулингу на Python, но ключевой сдвиг - операционный. Перестаньте думать как автор скрипта. Начните думать как человек, которому нужно поддерживать этот pipeline живым во время запуска кампании.
Проектирование отказоустойчивой архитектуры парсинга
Стабильный стек Amazon scrape API - модульный. Не потому, что так красивее выглядит на диаграмме. А потому, что Amazon сломает одну часть вашей системы раньше, чем все остальные, и вам нужно изолировать ущерб.
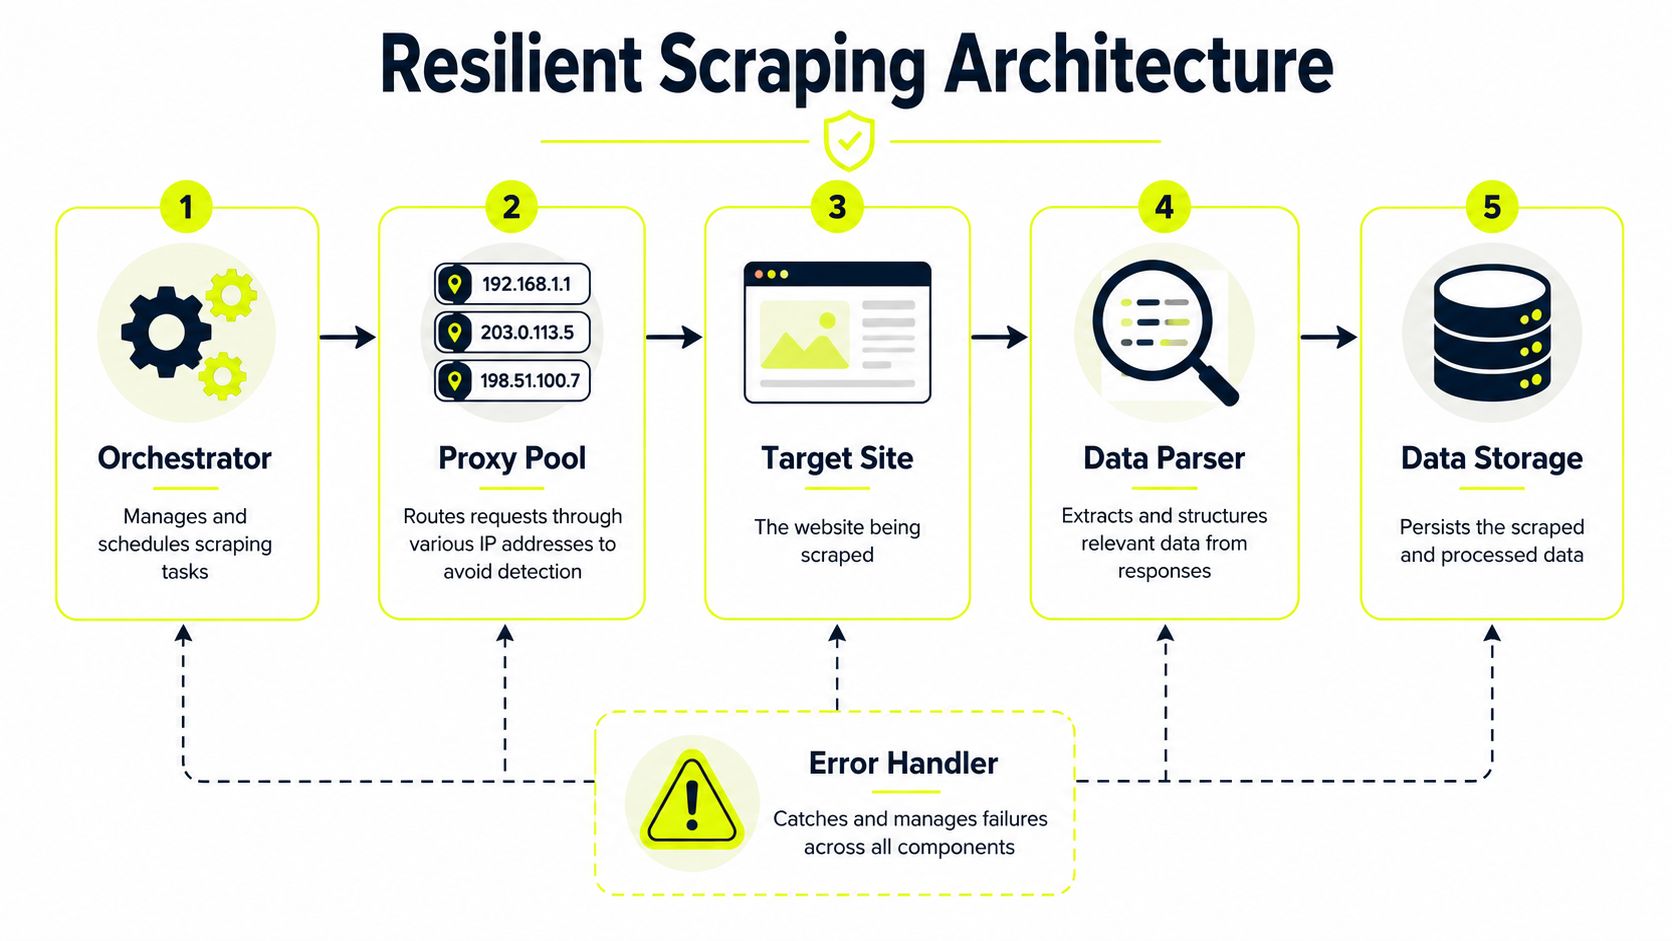
Как должен выглядеть production-поток
Думайте о пяти движущихся частях плюс общий путь ошибок.
Оркестратор
Это ваша плоскость управления. Она создаёт задачи, назначает приоритеты, выбирает маркетплейс и регион, и решает, должен ли запрос идти через прямой захват HTML или через управляемый endpoint парсера.Планировщик запросов
Этот слой должен управлять очередями, распределением, таймингом повторов и ограничениями конкурентности. Не позволяйте воркерам принимать решения о повторах изолированно. Они будут долбить один и тот же целевой паттерн и приведут к блокировке быстрее.Слой управления прокси
Большинство слабых сборок рушатся именно здесь. Слой должен выбирать тип прокси по задаче, применять политику ротации, сохранять залипающие сессии при необходимости и предоставлять геолокацию как реальный параметр запроса.Парсер и валидатор
Парсите только после того, как ответ пройдёт базовые проверки. Обнаруживайте пустые шаблоны, страницы с CAPTCHA, частичный контент и несовпадение региона до того, как что-либо запишете downstream.Хранение и доставка
Храните метаданные сырого ответа, распарсенную полезную нагрузку и статус задачи отдельно. Это разделение делает возможным replay, когда парсер ломается.
Центральный обработчик ошибок должен следить за каждым этапом. Если запрос падает из-за неправильного региона прокси, планировщику нужен этот сигнал. Если парсер начинает возвращать null для рейтингов или блоков офферов, оркестратор должен понизить этот маршрут или переключить режим сбора.
Большинство простоев парсера вызваны не одним заблокированным запросом. Они происходят из-за очереди, которая продолжает подавать сломанную конфигурацию.
Таргетинг по почтовым индексам должен быть нативным
Это тот момент, который пропускают большинство туториалов, и это серьёзный промах для арбитража и рекламных операций.
Если вы проверяете локализованные цены, доступность доставки или наличие товара для геотаргетированных кампаний, геолокации на уровне страны недостаточно. Вам нужно программное выполнение на уровне почтового индекса. Это означает, что ваша модель задачи должна объединять маркетплейс, целевой почтовый индекс, политику сессии и политику прокси вместе, а не как разрозненные параметры, распределённые по воркерам.
Только 2 из топ-9 API для парсинга Amazon явно поддерживают таргетинг на уровне почтовых индексов с резидентными прокси, и это стало ещё важнее после того, как обновления анти-бот системы Amazon в 2025 году ввели более строгую валидацию местоположения на основе IP, как отмечено в этом обсуждении парсинга Amazon на основе местоположения. Если ваша система не может переключать геолокацию в коде без ручного сброса сессий, вы будете собирать несогласованные данные о местоположении и не будете знать, какие ответы неверны.
Практичный поток архитектуры выглядит так:
- Приём задачи: ключевое слово, ASIN, URL продавца или URL категории поступает в очередь.
- Привязка местоположения: оркестратор прикрепляет целевой почтовый индекс и маркетплейс.
- Разрешение прокси: прокси-слой выбирает резидентную конечную точку на уровне города, соответствующую задаче.
- Получение и проверка: воркер подтверждает, что возвращённая страница отражает ожидаемый контекст доставки.
- Парсинг и публикация: только валидированные записи достигают вашего вебхука, объектного хранилища или базы данных.
Если вы создаёте собственные элементы инфраструктуры, полезной справкой по базовой механике является это пошаговое руководство по реализации прокси-сервера. Даже если вы не создаёте прокси-слой самостоятельно, полезно понимать, где должна находиться логика сессий.
Выполнение стратегического плана по прокси
Политика прокси - это место, где программы парсинга Amazon обычно ломаются.
У воркера может быть чистая логика парсинга, повторные попытки и приличные заголовки, но он всё равно может провалиться, потому что прокси-слой рассматривался как товарный пул. На Amazon выбор прокси контролирует три вещи, важные для операторов: будут ли запросы обработаны, заслуживают ли доверия данные, зависящие от местоположения, и останется ли стоимость на одну пригодную страницу предсказуемой по всем аккаунтам и кампаниям.
Матрица выбора типа прокси для парсинга Amazon
| Тип прокси | Основной сценарий использования | Уровень скрытности | Относительная стоимость | Соответствие Amazon |
|---|---|---|---|---|
| Резидентные | Страницы товаров, результаты поиска, страницы продавцов, локализованные цены, предложения с учётом доставки | Высокий | Средняя или высокая | Основной пул для продакшн-парсинга |
| Мобильные | Чувствительные действия с аккаунтом, потоки верификации, прогрев аккаунта, проверки доверия с высоким трением | Очень высокий | Высокая | Лучше резервировать для операций с аккаунтами, а не массового сбора каталога |
| Датацентр | Запросы с низкой ценностью, внутреннее QA, вспомогательные задачи, где сбои допустимы | Низкий | Низкая | Полезны только для изолированных рабочих нагрузок |
| ISP | Смешанные рабочие нагрузки, требующие меньшей задержки с лучшим доверием, чем у стандартных датацентр-диапазонов | Высокий | Средняя | Хороший вторичный пул для целевых задач |
| IPv6 | Дополнительное расширение пула там, где цель чисто его принимает | Переменный | Обычно низкая | Тестируйте изолированно перед масштабным использованием |
Для парсинга Amazon резидентные прокси несут основную нагрузку. Они - единственный практичный вариант по умолчанию, если вам нужен стабильный доступ к поиску, предложениям, страницам продавцов и представлениям доставки с привязкой к почтовому индексу. У датацентр-прокси всё ещё есть место, но только там, где блокировка не повредит downstream-системе. Это означает предварительные проверки, задачи обнаружения с низким приоритетом, внутренний мониторинг или пути повторных попыток, которые вы можете позволить себе потерять.
Решение по инфраструктуре - это не просто «какой прокси лучше». Это вопрос о том, как сегментировать трафик, чтобы плохая репутация IP в одной полосе не загрязняла другую. Трафик парсинга, входы в аккаунты, операции рекламных аккаунтов и верификация, связанная с оформлением заказа, не должны использовать один пул, одну длину сессии или одни правила ротации.
Разделяйте прокси-нагрузки по риску, а не по удобству
Работоспособная продакшн-модель выглядит так:
- Резидентный пул для сбора Amazon: используйте его для страниц поиска, детальных страниц товаров, витрин продавцов, отзывов и любого рабочего процесса, который зависит от контекста доставки.
- Мобильный пул для действий, чувствительных к аккаунту: сохраните его для потоков с интенсивными входами, этапов аккаунта, закрытых проверками доверия, и комбинаций платформ, где антифрод-системы агрессивно коррелируют репутацию IP между сессиями.
- ISP-пул для вторичных задач, чувствительных к задержке: полезен для выборочных конечных точек, где важно время отклика и вам всё ещё нужна более чистая репутация, чем у стандартного датацентр-диапазона.
- Датацентр-пул для одноразового вспомогательного трафика: используйте его для проверок работоспособности, валидации конечных точек и экспериментов, которые никогда не должны касаться вашего основного бюджета на сбор.
Это разделение имеет ещё большее значение для управления несколькими аккаунтами и арбитража трафика. Если одно бизнес-подразделение проверяет цены Amazon по почтовым индексам, а другое прогревает профили браузера для рекламных аккаунтов, общий пул прокси создаёт перекрёстное загрязнение. История сессий, паттерны ASN и всплески частоты смешиваются. Держите каждую полосу изолированной на прокси-шлюзе и обеспечивайте это разделение в коде, а не в записях руководства.
Политика ротации должна соответствовать форме задачи
Стратегия ротации - это место, где команды тратят много хорошего резидентного инвентаря. Amazon не нужна одна и та же модель сессии для каждого запроса.
Используйте короткие sticky-сессии для постраничных потоков поиска, более длинные сессии для путей предложений и продавцов, которые выигрывают от непрерывности cookie, и агрессивную ротацию для широкого обнаружения ключевых слов, где каждый запрос фактически независим. Если ваши воркеры ротируют слишком быстро, вы теряете непрерывность и провоцируете дополнительные страницы проверки. Если они удерживают сессии слишком долго, частота блокировок возрастает, и одна отравленная идентичность сжигает целую партию. Практическая справка по установке политик ротации IP прокси полезна, если вы формализуете эту логику на уровне шлюза.
Ключ в том, чтобы сделать ротацию детерминированной. Привяжите её к типу задачи, маркетплейсу, почтовому индексу и границе аккаунта. Не позволяйте воркерам импровизировать.
Геолокационный таргетинг требует собственной политики прокси
Таргетинг по почтовому индексу - это не функция-галочка. Это требование к инфраструктуре.
Если задача указывает 10001, прокси-слой должен вернуть конечную точку, способную удерживать согласованный контекст доставки Нью-Йорка достаточно долго, чтобы воркер загрузил страницу, сохранил cookie, проверил состояние местоположения и собрал HTML. То же справедливо для 94105, 60601 или любой другой зоны доставки, которая меняет доступность, поведение buy box, обещания доставки или видимость спонсируемых размещений. Общая маршрутизация «US резидентный» часто слишком груба для этого.
На практике селектор прокси должен разрешаться как минимум по следующим полям:
- маркетплейс
- страна
- штат или город, если поддерживается
- целевой почтовый индекс
- продолжительность сессии
- ID аккаунта или клиента
- класс задачи, например поиск, PDP, продавец, отзывы или предложения
Это даёт вам то, что можно проверить позже. Если на странице появляется неправильная оценка времени доставки, вы можете отследить, была ли проблема вызвана неверной географией прокси, устаревшей сессией или тем, что Amazon сбросил местоположение во время процесса.
IPv6 и дешёвая мощность
IPv6 может расширить пул для низкорисковых задач, но он должен оставаться за пределами основного пути сбора данных с Amazon, пока не докажет свою стабильность в ваших собственных тестах. Приёмка варьируется в зависимости от качества маршрута и конкретных страниц, которые вы запрашиваете. Рассматривайте его как дополнительную полосу. Не смешивайте его в высокоценный сбор данных, где вам нужна предсказуемая валидация контекста доставки.
Дешёвые прокси также несут операционные издержки. Они увеличивают количество повторных попыток, создают больше частичных ответов и повышают число записей, которые требуют валидации, прежде чем им можно доверять. Эти затраты проявляются позже в виде исключений парсера, ложных изменений инвентаря и неверных решений по кампаниям.
Расходы на прокси легко измерить. Неверные данные о местоположении - нет. Вот почему план использования прокси нужно разработать до масштабирования краулинга.
Разработка необнаруживаемых запросов
Чистого маршрута прокси недостаточно. Amazon оценивает всю цепочку запроса: поведение TLS, заголовки, куки, порядок навигации и тайминги. Если эти элементы не сочетаются друг с другом, запрос блокируется задолго до того, как ваш парсер увидит страницу продукта.
Создание отпечатков запросов, похожих на браузерные
Трафик на Amazon проваливается, когда команды смешивают заявление одного браузера с поведением другого браузера. User agent от Chrome в паре с неполными client hints, сессионными куками без состояния и шаблоном генерической HTTP-библиотеки легко классифицировать. Решение - это согласованность во всей сессии, а не рандомизация.
Сохраняйте каждый профиль браузера внутренне согласованным:
- Семейство User-Agent: соответствуйте браузеру и версии, которые вы намерены симулировать.
- Accept-Language: соответствуйте маркетплейсу, локали аккаунта и контексту доставки.
- Accept-Encoding: отправляйте значения, которые ваш клиент может обработать.
- Client hints: включайте заголовки вроде
Sec-CH-UAтолько если остальная часть отпечатка их поддерживает. - Непрерывность куков: сохраняйте куки через связанные шаги, такие как поиск, PDP, предложения и пагинация. Сбрасывайте их между несвязанными задачами или клиентами.
Если вы формируете запросы на уровне клиента, это руководство по заголовкам запросов в Python полезно для создания наборов заголовков, которые остаются согласованными под нагрузкой.
Инфраструктурный аспект здесь имеет значение. Команды, которые занимаются скрапингом множества аккаунтов и арбитражем трафика, часто отравляют собственное окружение, повторно используя одни и те же правила профиля браузера для очень разных задач. Краулинг предложений продавцов, проверка рекламы и запрос на получение buy box для конкретного местоположения не должны наследовать одну и ту же банку куков или шаблон заголовков. Изолируйте профили по классу задачи и группе аккаунтов, затем логируйте точный отпечаток, назначенный каждому запросу. Так вы сможете отладить падение успешности без догадок.
Задавайте темп запросов как планировщик, а не как скрипт
Тайминг - часть отпечатка. Фиксированные интервалы, идентичные промежутки между повторами и циклы повтора на уровне воркера создают паттерн, который Amazon может классифицировать, даже если заголовки выглядят нормально.
Используйте правила темпа на уровне планировщика:
- Добавляйте jitter к каждому окну отправки.
- Резервируйте липкие сессии для потоков, требующих непрерывности, таких как корзина, подтверждение местоположения или пагинация предложений.
- Откатывайтесь при ответах 429, 503 и мягких блокировках с увеличивающимися задержками.
- Ограничивайте повторы на маршрут и возвращайте неудавшуюся работу в центральную очередь.
- Помещайте слабые маршруты в карантин вместо того, чтобы позволять воркерам их молотить.
Это одно из самых чётких различий между скриптом и операцией, которая масштабируется. Скрипт повторяет попытку, потому что хочет получить страницу. Разработанный планировщик защищает IP, сессию и остальную часть пакета.
Я использую простое правило в продакшене. Если один и тот же воркер видит повторяющиеся мягкие блокировки от одного маршрута, он теряет право продолжать. Планировщик решает, нужно ли сменить отпечаток, остудить сессию, переключить географию или отправить задачу в полосу с более низким приоритетом. Это предотвращает штормы повторов, которые дороги и легко обнаруживаются.
Для визуального пошагового разбора обработки запросов с защитой от блокировок это видео полезно:
Переход носит операционный характер. Высокие показатели успеха достигаются за счет соответствия идентичности запроса, состояния сессии и темпа точно выполняемой задаче, особенно когда вы ротируете аккаунты и потоки сбора данных с таргетингом по почтовым индексам в масштабе.
Нейтрализация CAPTCHA и обнаружения ботов
CAPTCHA - это запаздывающий индикатор. Если вы продолжаете их видеть, проблема обычно началась раньше с доверия к прокси, отпечатков запросов или темпа.
Избегание лучше решения
Наиболее надежная стратегия работы с CAPTCHA - это снижение частоты их появления на Amazon в первую очередь.
Специализированные API для скрейпинга Amazon, использующие массивные пулы прокси с более чем 110 миллионами IP, стабильно достигают показателей успеха выше 98%, согласно бенчмарку Amazon scraping API от Nimbleway. Это важно, потому что чистая IP-инфраструктура - это основная защита как от CAPTCHA, так и от прямых блокировок.
Вот почему дешевые пулы прокси отравляют серьезные операции. Перегруженные IP чаще подвергаются проверкам. Проверенные сессии создают больше повторных попыток. Больше повторных попыток делают ваш трафик хуже. Затем операторы тратят время на интеграцию решателей CAPTCHA в стек, который нужно было исправить на более раннем этапе.
Частые CAPTCHA обычно означают, что ваш стек раскрывает намерения задолго до появления страницы с проверкой.
Для команд, занимающихся как скрейпингом, так и рекламными операциями, держите экспозицию CAPTCHA изолированной. Не позволяйте одному и тому же профилю браузера или группе прокси взаимозаменяемо обрабатывать скрейпинг Amazon и действия аккаунта Facebook. Если пул прокси начинает привлекать повторяющийся проверочный трафик от Amazon, изолируйте его от рабочих процессов антидетект-браузера.
Когда вы все же натыкаетесь на стену CAPTCHA
Вам все равно нужен реактивный путь.
Есть два практических варианта:
- Полностью автоматизированное решение: интегрируйте сторонний сервис решения CAPTCHA через API. Ваш воркер обнаруживает проверку, отправляет её, ждет токен, затем повторяет сессию с правильным состоянием.
- Полуручное разрешение: для рабочих процессов в Dolphin Anty, AdsPower, GoLogin, Multilogin или Hidemyacc передайте сессию оператору, когда скрейпинг связан с более широкой задачей верификации.
Автоматизированное решение подходит для постоянно работающих пайплайнов данных. Ручное решение подходит для крайних случаев, когда человек уже проверяет поток с геотаргетингом, вариант закрытой страницы или путь от рекламы к лендингу.
Ловушка заключается в чрезмерных инвестициях в решение при игнорировании первопричины. Если ваш стек Amazon scrape API проходит через проверки каждый час, не радуйтесь тому, что ваша интеграция решателя работает. Исправьте выбор маршрута, обработку куки и гигиену прокси.
Если вы работаете со стеками, насыщенными JavaScript, этот справочник по Node-скрейпингу будет полезным дополнением для проектирования более чистого обнаружения и обработки повторных попыток в рабочих процессах, управляемых браузером.
Парсинг данных и гарантия доставки
Скрейпинг не завершен, когда вы получаете ответ. Он завершен, когда структурированные, проверенные данные попадают туда, где остальная часть вашей системы может их использовать.
Сырой HTML ломается первым
Многие пайплайны скрейпинга Amazon все еще зависят от хрупких CSS-селекторов и цепочек XPath. Они работают до тех пор, пока Amazon не изменит макет страницы, не переместит элемент за новую обертку или не изменит путь рендеринга для локализованного блока предложений. Тогда ваш скрейпер продолжает возвращать вывод, но вывод неверный.
Этот скрытый сбой хуже жесткой блокировки.
Управляемые API скрейперов решают часть этой проблемы, возвращая структурированный вывод вместо сырого HTML. API скрейперов корпоративного уровня могут возвращать выводы в формате JSON с полями типа ASIN, цены и рейтинги и могут доставлять результаты асинхронно через вебхуки или внешнее хранилище типа S3 для высоконагруженных задач, как описано в этом сравнении Amazon scraper API.
Это не значит, что сырой HTML бесполезен. Это значит, что вы должны решить, где находится риск парсинга.
Используйте сырой HTML, когда:
- Вам нужен полный контроль: пользовательская логика извлечения, аудиты или экспериментальные поля.
- Вы можете активно поддерживать парсеры: ваша команда ожидает дрейф макета и имеет тесты для селекторов.
- Вам нужна возможность повтора: сохранение сырых снимков помогает, когда парсеры ломаются.
Используйте структурированный JSON, когда:
- Вам нужна стабильная доставка: нижестоящие системы заботятся о данных, а не о разметке.
- Вы работаете с большими объемами: поддержка парсера становится операционным тормозом.
- Вам важна скорость выполнения: рабочие процессы рекламных операций и арбитража обычно нуждаются в полях сейчас, а не в работе с парсером позже.
Пути доставки, которые не теряют данные
Не позволяйте вашим воркерам выводить записи в stdout и называть это пайплайном.
Используйте модель доставки, которая соответствует рабочему процессу:
| Путь доставки | Лучше всего подходит для | Почему это работает |
|---|---|---|
| Webhook | Логика кампаний в режиме реального времени | Отправляет проверенные результаты напрямую в системы верификации или ставок |
| Объектное хранилище | Пакетная аналитика и повтор | Сохраняет большие наборы результатов и сырые полезные нагрузки доступными для повторной обработки |
| Вставка в базу данных | Операционные данные с возможностью поиска | Хорошо для дашбордов, объединений и последующих оповещений |
| Передача через очередь | Многоэтапная обработка | Разделяет получение, парсинг, обогащение и публикацию |
Мое правило простое. Храните три вещи отдельно: метаданные запроса, распарсенные поля и причину сбоя. Это разделение спасает вас, когда Amazon меняет структуру страницы или когда маршрут прокси начинает возвращать неполные локализованные страницы.
Если вы не можете повторно запустить вчерашние неудавшиеся задачи с сегодняшним парсером, ваш пайплайн хрупок по дизайну.
Для арбитражных команд это также защищает качество кампаний. Если геотаргетированная кампания зависит от локального паритета цен, а ваш парсер случайно пропускает блок локализованного предложения, вы будете принимать решения о расходах на основе плохих данных.
Операционный мониторинг и соответствие требованиям
Как только ваш стек Amazon scrape API запущен, относитесь к нему как к любому другому производственному сервису. Следите за показателем успеха, задержкой, состоянием парсера, задержкой доставки и дрейфом затрат. Точные пороговые значения зависят от вашего стека, но принцип остается неизменным. Оповещайте об изменениях, а не только о простоях.
Самая большая операционная ошибка - ждать, пока бизнес-пользователи сообщат о плохих данных. Ваш планировщик должен уже знать, когда один регион начинает чаще давать сбои, чем другие. Ваш парсер должен уже знать, когда исчезают ожидаемые поля. Ваш слой доставки должен уже знать, когда вебхуки начинают накапливаться.
Облегченная система мониторинга работает, если она срабатывает. Более тяжелый стек с дашбордами работает, если кто-то за него отвечает. Важно ловить изменения макета, плохие партии прокси и несоответствие регионов до того, как они распространятся на решения по кампаниям, действия аккаунта или отчетность.
Соблюдение требований тоже имеет значение. Игнорируйте это - и вы создадите ненужный риск. Избегайте сбора персональных данных. Изучите robots.txt и условия использования, чтобы понимать, какие пути являются чувствительными, даже если ваша логика сбора данных не полагается на них для управления разрешениями. Поддерживайте дисциплинированное поведение запросов. Операционная сдержанность снижает ваш профиль риска и обычно повышает стабильность скрейпера.
Команды, которые остаются в этой сфере надолго, не относятся к скрейпингу как к разовому хаку. Они управляют им как инфраструктурой.
Если ваша операция зависит от стабильных прокси для скрейпинга Amazon, геотаргетированной верификации, рекламных аккаунтов Facebook и TikTok, фарминга аккаунтов или работы с антидетект-браузерами, Sota Proxy создан для такого рода нагрузок. Он предоставляет операторам резидентные, мобильные, ISP, дата-центровые и IPv6 опции с таргетингом на уровне города, контролем ротации и инфраструктурой, которая подходит для реальных производственных процессов, а не демо-скриптов.
Похожие статьи
Сетевая избыточность для прокси и платформ автоматизации
Узнайте, как сетевая избыточность обеспечивает бесперебойную работу прокси и платформ автоматизации. Рассматриваются активная/пассивная конфигурация, мультирегиональные кластеры, настройка отказоустойчивости и обеспечение uptime 99,9%
Географическое распределение прокси-инфраструктуры
Освойте географическое распределение прокси-инфраструктуры. Узнайте, как выбирать локации, типы прокси и стратегии маршрутизации для верификации рекламы и парсинга
Что такое Sticky Session: техническое руководство для пользователей прокси
Узнайте, что такое sticky session, как работает привязка сессий в балансировщиках нагрузки и прокси, и когда её использовать для мультиаккаунтинга, скрейпинга и рекламных кампаний.
Как избежать CAPTCHA в автоматизированных рабочих процессах
Узнайте, как избежать CAPTCHA в автоматизированных рабочих процессах с помощью прокси-тактик, антидетект-браузеров, управления темпом запросов и резервных решателей, созданных для реальных специалистов.
Интеграция прокси в AdsPower: Полное руководство по настройке
Пошаговая интеграция прокси AdsPower с SotaProxy. Охватывает настройку, типы прокси, ротацию, устранение неполадок и лучшие практики для работы с множественными аккаунтами.
7 лучших провайдеров прокси для арбитража и скрейпинга
Сравните 7 ведущих провайдеров прокси по типам IP, таргетингу, ротации, uptime, ценовым показателям и применимости для скрейпинга, рекламных аккаунтов, фарминга и арбитража.