Amazon Scrape API: Побудова масштабованого конвеєра даних
Побудуйте надійний Amazon Scrape API. Цей посібник охоплює архітектуру проксі, інженерію запитів, обробку CAPTCHA та парсинг даних для технічних спеціалістів.
Ваш Amazon-скрейпер, напевно, спрацював на десяти URL-адресах під час локального тестування. Потім ви запустили його в продакшн, націлили на реальні об'єми, і Amazon відповів помилками 503, сторінками CAPTCHA, зламаними сесіями та мертвими IP. Такий патерн відмови - це нормально.
Найбільше це б'є тоді, коли скрейпінг живить грошовий потік. Командам арбітражу трафіку потрібні свіжі дані про продукти та ціни для геотаргетованих кампаній. Медіабаєрам потрібно перевіряти локалізовані пропозиції перед тим, як направляти бюджет на рекламні акаунти Facebook і TikTok. Мультиакаунтникам, які працюють з AdsPower, Dolphin Anty, GoLogin, Multilogin або Hidemyacc, потрібен стабільний збір даних без отруєння того самого проксі-шару, який вони використовують для фармінгу акаунтів, клоакінгу та верифікації.
Робочий Amazon scrape API - це не скрипт. Це інфраструктура. Команди, які масштабуються, ставляться до проксі, інженерії запитів, парсингу та доставки як до однієї продакшн-системи. Якщо ви досі сприймаєте вибір проксі як галочку наприкінці, ви продовжите перебудовувати той самий зламаний стек.
Зміст
- Більше, ніж простий скрипт
- Проєктування стійкої архітектури скрейпінгу
- Виконання стратегічного плану проксі
- Інженерія невиявлюваних запитів
- Нейтралізація CAPTCHA та виявлення ботів
- Парсинг даних і гарантування доставки
- Операційний моніторинг і комплаєнс
Більше, ніж простий скрипт
Перше хибне припущення - думати, що Amazon блокує лише агресивних скрейперів. Це не так. Він блокує непослідовну поведінку. Скрипт, який завантажує кілька сторінок продуктів з одним набором заголовків, одним сховищем cookies і одним проксі, може виглядати нормально на стейджингу і все одно провалитися в момент, коли ви додасте конкурентність.
Я бачив той самий патерн у стеках верифікації реклами та акаунт-фармах. Одна команда скрейпить локалізовані ціни Amazon, щоб узгодити клоаковані лендінги з регіоном, показаним у рекламному акаунті Facebook. Інша команда перевіряє пропозиції продавців перед запуском TikTok-кампанії, прив'язаної до вузької зони доставки. Обидві починають з простого Python-воркера. Обидві врешті розуміють, що скрипт - це не продукт. Система навколо нього - ось що.
Практичне правило: якщо ваш Amazon-скрейпер залежить від одного процесу, який послідовно виконує завантаження, парсинг, повторні спроби та зберігання, він провалиться гучно і він провалиться часто.
Скрейпінг Amazon стає складнішим, коли він прив'язаний до інших операційних систем. Якщо ті самі оператори також керують профілями в AdsPower або GoLogin, або запускають потоки фармінгу акаунтів у Dolphin Anty та Multilogin, погана гігієна проксі розповсюджується на всі робочі процеси. Спаліть підмережу в скрейпінгу, потім використайте її повторно для логінів, і ви створите власну проблему довіри.
Ось чому серйозна побудова Amazon scrape API починається з розділення відповідальності. Скрейпінг працює на власній політиці запитів, пулі проксі, політиці cookies та конвеєрі даних. Управління акаунтами працює на іншій.
Якщо ви досі на етапі скрипта, це той момент, коли ви припиняєте додавати латки і починаєте перебудовувати з чистішими межами. Гарний посібник з основ краулера - це цей гайд по веб-краулінгу на Python, але ключовий зсув є операційним. Припиніть думати як автор скрипта. Почніть думати як людина, яка має підтримувати цей конвеєр живим під час запуску кампанії.
Проєктування стійкої архітектури скрейпінгу
Стабільний Amazon scrape API стек є модульним. Не тому, що це виглядає чистіше на діаграмі. Тому що Amazon зламає одну частину вашої системи раніше, ніж зламає всю її, і вам потрібно ізолювати шкоду.
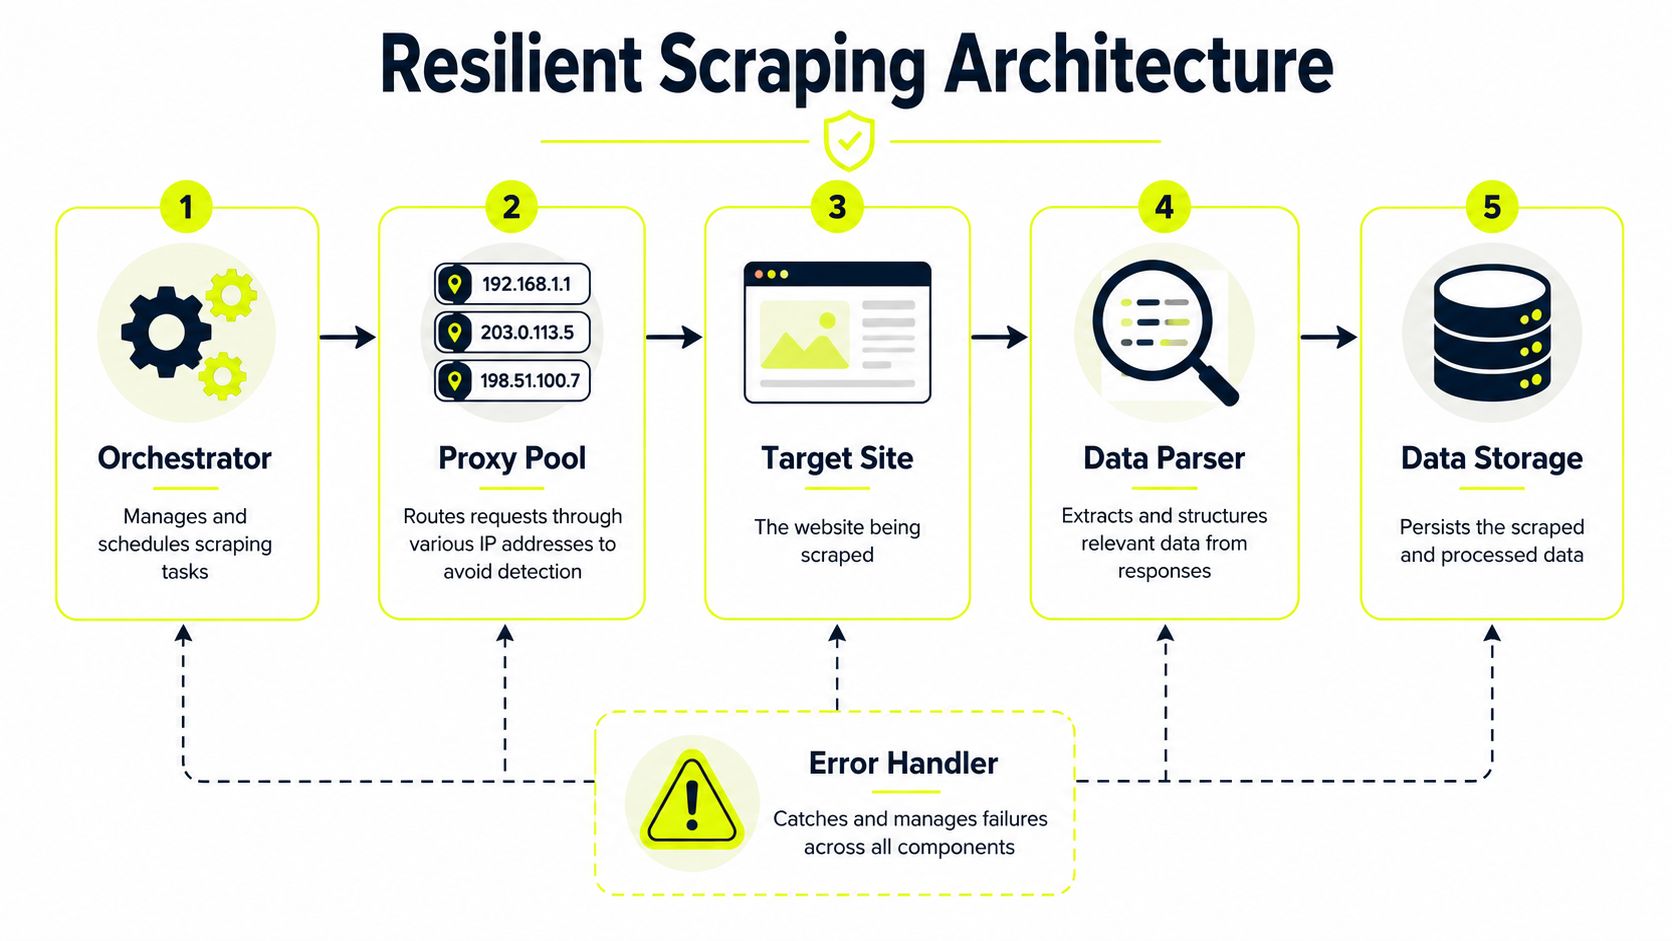
Як повинен виглядати продакшн-потік
Думайте про п'ять рухомих частин плюс спільний шлях помилок.
Оркестратор
Це ваша площина управління. Він створює завдання, призначає пріоритет, вибирає маркетплейс і регіон і вирішує, чи має запит проходити через пряме захоплення HTML, чи через керований скрейпер-ендпоінт.Планувальник запитів
Цей шар має володіти черговістю, темпуванням, таймінгом повторних спроб і обмеженнями конкурентності. Не дозволяйте воркерам приймати рішення про повторні спроби ізольовано. Вони будуть бити по тому самому цільовому патерну і швидше заблокують вас.Шар управління проксі
Більшість слабких збірок руйнуються саме в цій точці. Шар має вибирати тип проксі за завданням, застосовувати політику ротації, зберігати sticky-сесії коли потрібно, і виставляти геолокацію як фактичний параметр запиту.Парсер і валідатор
Парсьте лише після того, як відповідь пройде базові перевірки. Виявляйте порожні шаблони, сторінки CAPTCHA, частковий контент і невідповідність регіону до того, як щось записати нижче за потоком.Зберігання та доставка
Зберігайте метадані сирої відповіді, розпарсений пейлоад і статус завдання окремо. Це розділення робить можливим повтор, коли парсер ламається.
Центральний обробник помилок має спостерігати за кожним етапом. Якщо запит провалюється через поганий регіон проксі, планувальнику потрібен цей сигнал. Якщо парсер починає повертати null для рейтингів або блоків пропозицій, оркестратор має знизити пріоритет цього маршруту або переключити режим збору.
Більшість збоїв скрейпера викликані не одним заблокованим запитом. Вони виникають через чергу, яка продовжує живити зламану конфігурацію.
Таргетинг за поштовим індексом має бути нативним
Це частина, яку пропускає більшість туторіалів, і це велика прогалина для арбітражу та рекламних операцій.
Якщо ви перевіряєте локалізоване ціноутворення, доступність доставки або наявність товарів для гео-таргетованих кампаній, геолокації на рівні країни недостатньо. Вам потрібне програмне виконання за поштовими індексами. Це означає, що ваша модель завдань повинна нести разом маркетплейс, цільовий поштовий індекс, політику сесії та політику проксі, а не як випадкові параметри, розкидані по воркерах.
Лише 2 з топ-9 API для скрапінгу Amazon явно підтримують таргетинг на рівні поштових індексів з резидентськими проксі, і це стало важливішим після того, як анти-бот оновлення Amazon 2025 року запровадили суворішу валідацію локації на основі IP, як зазначено в цій дискусії про скрапінг Amazon на основі локації. Якщо ваша система не може переключати геолокацію в коді без ручного скидання сесії, ви збиратимете непослідовні дані про локацію і не знатимете, які відповіді є неправильними.
Практична архітектурна схема виглядає так:
- Прийом завдань: ключове слово, ASIN, URL продавця або URL категорії потрапляє в чергу.
- Прив'язка локації: оркестратор додає цільовий поштовий індекс та маркетплейс.
- Визначення проксі: проксі-шар вибирає резидентську кінцеву точку на рівні міста, яка відповідає завданню.
- Отримання та перевірка: воркер підтверджує, що повернута сторінка відображає очікуваний контекст доставки.
- Парсинг та публікація: лише валідовані записи потрапляють до вашого вебхука, об'єктного сховища або бази даних.
Якщо ви будуєте власні інфраструктурні компоненти, корисною довідкою для базових механізмів є цей посібник з реалізації проксі-сервера. Навіть якщо ви не будуєте проксі-рівень самостійно, корисно розуміти, де повинна знаходитися логіка сесій.
Виконання стратегічного плану проксі
Політика проксі - це те, де програми скрапінгу Amazon зазвичай ламаються.
Воркер може мати чисту логіку парсингу, повторні спроби та пристойні заголовки, але все одно зазнає невдачі, тому що проксі-шар розглядався як звичайний пул. На Amazon вибір проксі контролює три речі, що мають значення для операторів: чи будуть обслуговуватися запити, чи є залежні від локації дані надійними, і чи залишається вартість за придатну сторінку передбачуваною для різних облікових записів та кампаній.
Матриця вибору типу проксі для скрапінгу Amazon
| Тип проксі | Основний випадок використання | Рівень прихованості | Відносна вартість | Придатність для Amazon |
|---|---|---|---|---|
| Residential | Сторінки товарів, результати пошуку, сторінки продавців, локалізоване ціноутворення, пропозиції, чутливі до доставки | Високий | Середня до високої | Основний пул для продакшн-скрапінгу |
| Mobile | Чутливі дії з обліковим записом, потоки верифікації, розігрів облікового запису, перевірки довіри з високим тертям | Дуже високий | Висока | Краще зарезервувати для операцій з обліковими записами, а не для масового збору каталогу |
| Datacenter | Отримання низькоцінних даних, внутрішнє QA, допоміжні завдання, де невдачі є прийнятними | Низький | Низька | Корисний лише для ізольованих робочих навантажень |
| ISP | Змішані робочі навантаження, які потребують нижчої затримки з кращою довірою, ніж стандартні діапазони datacenter | Високий | Середня | Хороший вторинний пул для цільових завдань |
| IPv6 | Додаткове розширення пулу, коли ціль приймає його без проблем | Змінний | Зазвичай низька | Протестуйте ізольовано перед використанням у масштабі |
Для скрапінгу Amazon резидентські проксі несуть основне навантаження. Вони є єдиним практичним варіантом за замовчуванням, якщо вам потрібен послідовний доступ до пошуку, пропозицій, сторінок продавців та перегляду доставки за поштовими індексами. Datacenter проксі все ще мають своє місце, але лише там, де блокування не шкодить системі нижче. Це означає попередні перевірки, низькопріоритетні завдання виявлення, внутрішній моніторинг або шляхи повторних спроб, які ви можете дозволити собі втратити.
Інфраструктурне рішення полягає не просто у «який проксі кращий». Це те, як сегментувати трафік, щоб погана IP-репутація в одній смузі не забруднювала іншу. Трафік скрапінгу, входи в облікові записи, операції рекламного облікового запису та верифікація, пов'язана з оформленням замовлення, не повинні ділити один пул, однакову тривалість сесії або однакові правила ротації.
Розділяйте проксі-навантаження за ризиком, а не за зручністю
Працююча продакшн-модель виглядає так:
- Резидентський пул для збору даних Amazon: використовуйте його для сторінок пошуку, сторінок деталей товарів, вітрин продавців, відгуків та будь-якого робочого процесу, що залежить від контексту доставки.
- Мобільний пул для чутливих до облікового запису дій: зберігайте це для потоків з інтенсивними входами, кроків облікового запису, закритих довірою, та комбінацій платформ, де системи захисту від шахрайства агресивно співвідносять репутацію IP у різних сесіях.
- ISP пул для чутливих до затримки вторинних завдань: корисний для вибіркових кінцевих точок, де час відповіді має значення, і вам все ще потрібна чистіша репутація, ніж стандартний datacenter діапазон.
- Datacenter пул для одноразового допоміжного трафіку: використовуйте його для перевірок працездатності, валідації кінцевих точок та експериментів, які ніколи не повинні торкатися вашого основного бюджету на збір даних.
Цей поділ має ще більше значення для управління кількома обліковими записами та арбітражу трафіку. Якщо одна бізнес-одиниця перевіряє ціни Amazon за поштовим індексом, а інша розігріває профілі браузера для рекламних облікових записів, спільний проксі-пул створює перехресне забруднення. Історія сесій, шаблони ASN та сплески швидкості змішуються. Тримайте кожну смугу ізольованою на проксі-шлюзі та забезпечуйте цей поділ у коді, а не в нотатках керівництва.
Політика ротації повинна відповідати формі завдання
Стратегія ротації - це те, де команди марнують багато хорошого резидентського інвентарю. Amazon не потребує однакової моделі сесії для кожного запиту.
Використовуйте короткі липкі сесії для пагінованих потоків пошуку, довші сесії для шляхів пропозицій та продавців, які виграють від безперервності cookies, та агресивну ротацію для широкого виявлення ключових слів, де кожен запит є фактично незалежним. Якщо ваші воркери ротують занадто швидко, ви втрачаєте безперервність і викликаєте додаткові сторінки виклику. Якщо вони утримують сесії занадто довго, показники блокування підвищуються, і одна отруєна ідентичність спалює цілу партію. Практична довідка про встановлення політик ротації проксі-IP є корисною, якщо ви формалізуєте цю логіку на рівні шлюзу.
Ключ полягає в тому, щоб зробити ротацію детермінованою. Прив'яжіть її до типу завдання, маркетплейсу, поштового індексу та меж облікового запису. Не дозволяйте воркерам імпровізувати.
Геолокаційний таргетинг потребує власної політики проксі
Таргетинг за поштовим індексом - це не функція з галочкою. Це інфраструктурна вимога.
Якщо завдання вказує 10001, проксі-шар повинен повернути кінцеву точку, яка може утримувати послідовний контекст доставки Нью-Йорка достатньо довго, щоб воркер завантажив сторінку, зберіг cookies, перевірив стан локації та зібрав HTML. Те саме стосується 94105, 60601 або будь-якої іншої зони доставки, що змінює доступність, поведінку buy box, обіцянки доставки або видимість спонсорованих розміщень. Загальна маршрутизація «US residential» часто занадто груба для цього.
На практиці селектор проксі повинен вирішуватися принаймні за цими полями:
- маркетплейс
- країна
- штат або місто, коли підтримується
- цільовий поштовий індекс
- тривалість сесії
- ідентифікатор облікового запису або орендаря
- клас завдання, наприклад пошук, PDP, продавець, відгуки або пропозиції
Це дає вам те, що можна буде проаудитувати пізніше. Якщо на сторінці з'являється неправильна оцінка терміну доставки, ви можете відстежити, чи проблема виникла через неправильну географію проксі, застарілу сесію, або Amazon скинув локацію під час потоку.
IPv6 і дешева потужність
IPv6 може розширити пул для низькоризикових завдань, але він повинен залишатися за межами основного шляху збору даних Amazon, доки не доведе стабільність у ваших власних тестах. Прийнятність варіюється залежно від якості маршруту та конкретних сторінок, які ви відвідуєте. Розглядайте його як додаткову смугу. Не змішуйте його з високоцінним збором даних, де вам потрібна передбачувана валідація контексту доставки.
Дешеві проксі також створюють операційний податок. Вони збільшують кількість повторних спроб, створюють більше часткових відповідей і підвищують кількість записів, які потребують валідації, перш ніж їм можна довіряти. Ця вартість проявляється пізніше у вигляді винятків парсера, хибних змін інвентаря та поганих рішень для кампаній.
Витрати на проксі легко виміряти. Погані дані про локацію - ні. Ось чому план проксі потрібно розробити до того, як краулінг масштабується.
Розробка невиявлюваних запитів
Чистого маршруту проксі недостатньо. Amazon оцінює весь ланцюг запиту: поведінку TLS, заголовки, куки, порядок навігації та тайминг. Якщо ці частини не підходять одна до одної, запит викликає підозру задовго до того, як ваш парсер побачить сторінку продукту.
Створюйте браузероподібні відбитки запитів
Трафік Amazon зазнає невдачі, коли команди змішують твердження одного браузера з поведінкою іншого браузера. User agent Chrome у парі з неповними client hints, безстатусними куками та шаблоном загальної HTTP-бібліотеки легко класифікувати. Рішення - це узгодженість у всій сесії, а не рандомізація.
Зберігайте кожен профіль браузера внутрішньо узгодженим:
- Сімейство User-Agent: підбирайте браузер і версію, які ви маєте намір імітувати.
- Accept-Language: підбирайте ринок, локаль облікового запису та контекст доставки.
- Accept-Encoding: надсилайте значення, які може обробляти ваш клієнт.
- Client hints: включайте заголовки, такі як
Sec-CH-UA, тільки якщо решта відбитка їх підтримує. - Безперервність куків: зберігайте куки між пов'язаними кроками, такими як пошук, PDP, пропозиції та пагінація. Скидайте їх між непов'язаними завданнями або орендарями.
Якщо ви формуєте запити на рівні клієнта, цей посібник із заголовків запитів у Python корисний для створення наборів заголовків, які залишаються узгодженими під навантаженням.
Інфраструктурний аспект тут має значення. Команди, які виконують багатоакаунтний скрейпінг і арбітраж трафіку, часто отруюють власне середовище, повторно використовуючи ті самі правила профілю браузера для дуже різних завдань. Краулінг пропозицій продавця, перевірка реклами та запит buy box для конкретної локації не повинні успадковувати одну й ту саму банку куків або шаблон заголовків. Ізолюйте профілі за класом завдання та групою облікових записів, потім логуйте точний відбиток, призначений кожному запиту. Ось як ви налагоджуєте падіння показника успішності без здогадок.
Темп запитів як у планувальника, а не скрипта
Тайминг - частина відбитка. Фіксовані інтервали, ідентичні проміжки повторних спроб і локальні для воркера цикли повтору створюють шаблон, який Amazon може класифікувати, навіть якщо заголовки виглядають нормально.
Використовуйте правила темпу на рівні планувальника:
- Додавайте джиттер до кожного вікна відправки.
- Резервуйте липкі сесії для потоків, яким потрібна безперервність, таких як кошик, підтвердження локації або пагінований обхід пропозицій.
- Відступайте при відповідях 429, 503 і м'якого блокування зі зростаючими затримками.
- Обмежуйте повторні спроби на маршрут і повертайте невдалу роботу до центральної черги.
- Відправляйте слабкі маршрути на карантин замість того, щоб дозволяти воркерам їх бомбардувати.
Це одна з найяскравіших відмінностей між скриптом та операцією, яка масштабується. Скрипт повторює спробу, бо хоче сторінку. Спроектований планувальник захищає IP, сесію та решту пакета.
Я використовую просте правило в продакшені. Якщо той самий воркер бачить повторні м'які блокування з одного маршруту, він втрачає повноваження продовжувати. Планувальник вирішує, чи поміняти відбиток, охолодити сесію, змінити географію або перекинути завдання в смугу з нижчим пріоритетом. Це запобігає штормам повторних спроб, які є дорогими та легко виявляються.
Для візуального огляду обробки запитів проти блокування це відео корисне:
Зміна є операційною. Високі показники успішності досягаються шляхом узгодження ідентичності запиту, стану сесії та темпу виконання з конкретним завданням, що виконується, особливо коли ви ротуєте облікові записи та потоки збору даних, націлені на поштові індекси, у великих масштабах.
Нейтралізація CAPTCHA та виявлення ботів
CAPTCHA є запізнілим індикатором. Якщо ви постійно їх бачите, проблема зазвичай починалася раніше з довіри до проксі, відбитків запитів або темпу виконання.
Уникнення краще за розв'язання
Найнадійніша стратегія щодо CAPTCHA - це зменшення частоти їх показу Amazon.
Спеціалізовані API для скрапінгу Amazon, які використовують величезні пули проксі з понад 110 мільйонами IP-адрес, стабільно досягають показників успішності понад 98%, згідно з бенчмарком API для скрапінгу Amazon від Nimbleway. Це важливо, оскільки чиста IP-інфраструктура є основним захистом як від CAPTCHA, так і від прямих блокувань.
Ось чому дешеві пули проксі отруюють серйозні операції. Перевикористані IP-адреси частіше зазнають перевірок. Перевірені сесії створюють більше повторних спроб. Більше повторних спроб робить ваш трафік гіршим. Потім оператори витрачають час на інтеграцію розв'язувачів CAPTCHA у стек, який потрібно було виправити на вищому рівні.
Часті CAPTCHA зазвичай означають, що ваш стек розкриває наміри задовго до появи сторінки виклику.
Для команд, які керують як скрапінгом, так і рекламними операціями, тримайте експозицію CAPTCHA ізольованою. Не дозволяйте одному профілю браузера або групі проксі взаємозамінно обробляти скрапінг Amazon і дії з обліковими записами Facebook. Якщо пул проксі починає отримувати повторний трафік викликів від Amazon, ізолюйте його від ваших робочих процесів у антидетект-браузерах.
Коли ви все ж натрапляєте на стіну CAPTCHA
Вам все ще потрібен реактивний шлях.
Є два практичні варіанти:
- Повністю автоматизоване розв'язання: інтегруйте сторонній сервіс розв'язання CAPTCHA через API. Ваш воркер виявляє виклик, надсилає його, чекає на токен, потім повторює спробу сесії з правильним станом.
- Напівручне вирішення: для робочих процесів у Dolphin Anty, AdsPower, GoLogin, Multilogin або Hidemyacc передайте сесію оператору, коли скрапінг прив'язаний до ширшого завдання верифікації.
Автоматизоване розв'язання підходить для постійно працюючих конвеєрів даних. Ручне розв'язання підходить для граничних випадків, коли людина вже перевіряє гео-таргетований потік, приховану варіацію сторінки або шлях від реклами до лендінгу.
Пастка полягає в надмірному інвестуванні в розв'язання, ігноруючи основну причину. Якщо ваш стек API для скрапінгу Amazon спалює виклики щогодини, не святкуйте, що ваша інтеграція розв'язувача працює. Виправте вибір маршруту, обробку кукі та гігієну проксі.
Якщо ви працюєте зі стеками, насиченими JavaScript, цей довідник зі скрапінгу на Node є корисним супутником для проектування чистішого виявлення та обробки повторних спроб у робочих процесах на основі браузера.
Парсинг даних та гарантія доставки
Скрапінг не завершується, коли ви отримуєте відповідь. Він завершується, коли структуровані, валідовані дані потрапляють туди, де решта вашої системи може їх використовувати.
Сирий HTML ламається першим
Багато конвеєрів скрапінгу Amazon все ще залежать від крихких CSS-селекторів і ланцюжків XPath. Вони працюють, доки Amazon не змінить макет сторінки, не перемістить елемент за новий обгортковий елемент або не змінить шлях рендерингу для локалізованого блоку пропозицій. Тоді ваш скрапер продовжує повертати вихідні дані, але вони неправильні.
Ця тиха помилка гірша за жорстке блокування.
Керовані API скраперів частково вирішують це, повертаючи структуровані дані замість сирого HTML. API скраперів корпоративного рівня можуть повертати вихідні дані у форматі JSON з такими полями, як ASIN, ціни та рейтинги, і вони можуть доставляти результати асинхронно через вебхуки або зовнішнє сховище, як-от S3 для високооб'ємних завдань, як описано в цьому порівнянні API скраперів Amazon.
Це не означає, що сирий HTML марний. Це означає, що ви повинні вирішити, де належить ризик парсингу.
Використовуйте сирий HTML, коли:
- Вам потрібен повний контроль: кастомна логіка витягування, аудити або експериментальні поля.
- Ви можете активно підтримувати парсери: ваша команда очікує зміни макету та має тести для селекторів.
- Вам потрібна можливість відтворення: збереження сирих знімків допомагає, коли парсери ламаються.
Використовуйте структурований JSON, коли:
- Вам потрібна стабільна доставка: низхідні системи дбають про дані, а не про розмітку.
- Ви працюєте з великими обсягами: підтримка парсера стає операційним тягарем.
- Вас турбує швидкість виконання: рекламні операції та арбітражні робочі процеси зазвичай потребують полів зараз, а не роботи парсера пізніше.
Шляхи доставки, які не втрачають дані
Не дозволяйте вашим воркерам виводити записи в stdout і називати це конвеєром.
Використовуйте модель доставки, яка відповідає робочому процесу:
| Шлях доставки | Найкраще підходить | Чому це працює |
|---|---|---|
| Вебхук | Логіка кампанії майже в реальному часі | Надсилає валідовані результати безпосередньо в системи верифікації або ставок |
| Об'єктне сховище | Пакетна аналітика та відтворення | Зберігає великі набори результатів і сирі payload доступними для повторної обробки |
| Вставка в БД | Операційні дані з пошуком | Добре для дашбордів, об'єднань і низхідних сповіщень |
| Передача через чергу | Багатоетапна обробка | Розділяє отримання, парсинг, збагачення та публікацію |
Моє правило просте. Зберігайте три речі окремо: метадані запиту, розпарсені поля та причину помилки. Це розділення рятує вас, коли Amazon змінює структуру сторінки або коли маршрут проксі починає повертати неповні локалізовані сторінки.
Якщо ви не можете відтворити вчорашні невдалі завдання з сьогоднішнім парсером, ваш конвеєр крихкий за дизайном.
Для арбітражних команд це також захищає якість кампанії. Якщо гео-таргетована кампанія залежить від паритету місцевих цін, а ваш парсер ненавмисно втрачає блок локалізованої пропозиції, ви прийматимете рішення щодо витрат на основі неправильних даних.
Операційний моніторинг та відповідність вимогам
Коли ваш стек API для скрапінгу Amazon запущений, ставтеся до нього як до будь-якого іншого продакшн-сервісу. Стежте за показником успішності, затримкою, здоров'ям парсера, затримкою доставки та дрейфом витрат. Точні пороги залежать від вашого стеку, але принцип незмінний. Сповіщайте про зміни, а не лише про збої.
Найбільша операційна помилка - чекати, поки бізнес-користувачі повідомлять про неправильні дані. Ваш планувальник уже має знати, коли один регіон починає зазнавати більше невдач, ніж інші. Ваш парсер уже має знати, коли зникають очікувані поля. Ваш рівень доставки вже має знати, коли вебхуки відкладаються.
Легке налаштування моніторингу працює, якщо воно спрацьовує. Важчий стек з дашбордами працює, якщо хтось за нього відповідає. Важливо виявляти зміни макету, погані партії проксі та невідповідність регіонів до того, як вони поширяться на рішення про кампанії, дії з обліковими записами або звітність.
Дотримання вимог теж має значення. Ігноруйте їх - і ви створите непотрібні ризики. Уникайте збору персональних даних. Перевіряйте robots.txt і умови використання, щоб розуміти, які шляхи є чутливими, навіть якщо ваша логіка збору не покладається на них для контролю доступу. Підтримуйте дисципліновану поведінку запитів. Операційна стриманість знижує ваш профіль ризику та зазвичай підвищує стабільність скрейпера.
Команди, які тримаються в цій сфері довго, не ставляться до скрейпінгу як до разового хаку. Вони керують ним як інфраструктурою.
Якщо ваша операція залежить від стабільних проксі для скрейпінгу Amazon, геотаргетованої верифікації, рекламних акаунтів Facebook та TikTok, фармінгу акаунтів або робочих процесів антидетект браузерів, Sota Proxy створено саме для такого навантаження. Він надає операторам резидентські, мобільні, ISP, дата-центрові та IPv6 опції з таргетингом на рівні міста, контролем ротації та інфраструктурою, що підходить для реальних продакшн-процесів, а не демо-скриптів.
Схожі статті
Мережева надлишковість для проксі та платформ автоматизації
Дізнайтеся, як мережева надлишковість підтримує працездатність проксі та платформ автоматизації. Розглядаємо активні/пасивні схеми, мультирегіональні кластери, налаштування відмовостійкості та забезпечення доступності 99,9%
Географічний розподіл інфраструктури проксі-серверів
Опануйте географічний розподіл інфраструктури проксі-серверів. Дізнайтеся, як обирати локації, типи проксі та стратегії маршрутизації для верифікації реклами, веб-скрейпінгу
Що таке Sticky Session: технічний посібник для користувачів проксі
Дізнайтеся, що таке sticky session, як працює прив'язка сесій у балансувальниках навантаження та проксі-серверах, і коли її використовувати для мультиакаунтингу, скрейпінгу та рекламних кампаній.
Як уникнути CAPTCHA в автоматизованих процесах
Дізнайтеся, як уникнути CAPTCHA в автоматизованих процесах за допомогою тактик проксі, антидетект-браузерів, темпування запитів та резервних рішень для справжніх операторів.
Інтеграція проксі з AdsPower: Повний посібник з налаштування
Покрокова інтеграція проксі AdsPower з SotaProxy. Охоплює налаштування, типи проксі, ротацію, усунення несправностей та найкращі практики для роботи з кількома обліковими записами.
7 кращих провайдерів проксі для арбітражу та скрейпінгу
Порівняння 7 кращих провайдерів проксі за типами IP, таргетингом, ротацією, аптаймом, ціновими сигналами та придатністю для скрейпінгу, рекламних акаунтів, фармінгу та арбітражу.