API de Scraping de Amazon: Construye un Pipeline de Datos Escalable
Construye una API de Scraping de Amazon robusta. Esta guía cubre arquitectura de proxies, ingeniería de peticiones, manejo de CAPTCHA y análisis de datos para operadores técnicos.
Tu scraper de Amazon probablemente funcionó con diez URLs en una prueba local. Luego lo pusiste en producción, lo apuntaste a volumen real, y Amazon respondió con errores 503, páginas de CAPTCHA, sesiones rotas e IPs muertas. Ese patrón de fallo es normal.
Impacta más duramente cuando el scraping alimenta un flujo de dinero. Los equipos de arbitraje de tráfico necesitan datos frescos de productos y precios para campañas geo-segmentadas. Los compradores de medios necesitan verificar ofertas localizadas antes de empujar gasto a cuentas publicitarias de Facebook y TikTok. Los operadores multi-cuenta que ejecutan AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc necesitan recolección de datos estable sin envenenar la misma capa de proxies que usan para farming de cuentas, cloaking y verificación.
Una configuración funcional de API de scrape de Amazon no es un script. Es infraestructura. Los equipos que escalan tratan proxies, ingeniería de peticiones, parsing y entrega como un solo sistema de producción. Si todavía tratas la elección de proxy como una casilla al final, seguirás reconstruyendo el mismo stack roto.
Tabla de Contenidos
- Más Allá de un Simple Script
- Diseñando una Arquitectura de Scraping Resiliente
- Ejecutando un Plan Estratégico de Proxies
- Ingeniería de Peticiones Indetectables
- Neutralizando CAPTCHAs y Detección de Bots
- Parseando Datos y Garantizando la Entrega
- Monitoreo Operacional y Cumplimiento
Más Allá de un Simple Script
La primera suposición errónea es pensar que Amazon bloquea solo a scrapers agresivos. No lo hace. Bloquea comportamiento inconsistente. Un script que obtiene un puñado de páginas de productos con un conjunto de headers, un tarro de cookies y un proxy puede verse bien en staging y aún así fallar en el momento en que añades concurrencia.
He visto el mismo patrón en stacks de verificación de anuncios y farms de cuentas. Un equipo scrapea precios localizados de Amazon para alinear landers cloakeados con la región mostrada en una cuenta publicitaria de Facebook. Otro equipo verifica ofertas de vendedores antes de lanzar una campaña de TikTok vinculada a un área de entrega estrecha. Ambos empiezan con un simple worker de Python. Ambos eventualmente aprenden que el script no es el producto. El sistema alrededor de él lo es.
Regla práctica: Si tu scraper de Amazon depende de un proceso que hace fetching, parsing, reintentos y almacenamiento en secuencia, fallará ruidosamente y fallará a menudo.
El scraping de Amazon se vuelve más difícil cuando está conectado a otros sistemas operacionales. Si los mismos operadores también administran perfiles en AdsPower o GoLogin, o ejecutan flujos de farming de cuentas en Dolphin Anty y Multilogin, la mala higiene de proxies se derrama entre flujos de trabajo. Quema una subred en scraping, luego reutilízala para logins, y crearás tu propio problema de confianza.
Por eso una construcción seria de API de scrape de Amazon comienza con separación de responsabilidades. El scraping se ejecuta en su propia política de peticiones, pool de proxies, política de cookies y pipeline de datos. La administración de cuentas se ejecuta en una diferente.
Si todavía estás en la fase de script, este es el punto donde dejas de añadir parches y comienzas a reconstruir con límites más limpios. Un buen primer paso sobre fundamentos de crawlers es esta guía de web crawling en Python, pero el cambio clave es operacional. Deja de pensar como autor de scripts. Empieza a pensar como la persona que tiene que mantener este pipeline vivo durante el lanzamiento de una campaña.
Diseñando una Arquitectura de Scraping Resiliente
Un stack estable de API de scrape de Amazon es modular. No porque se vea más limpio en un diagrama. Porque Amazon romperá una parte de tu sistema antes de romperlo todo, y necesitas aislar el daño.
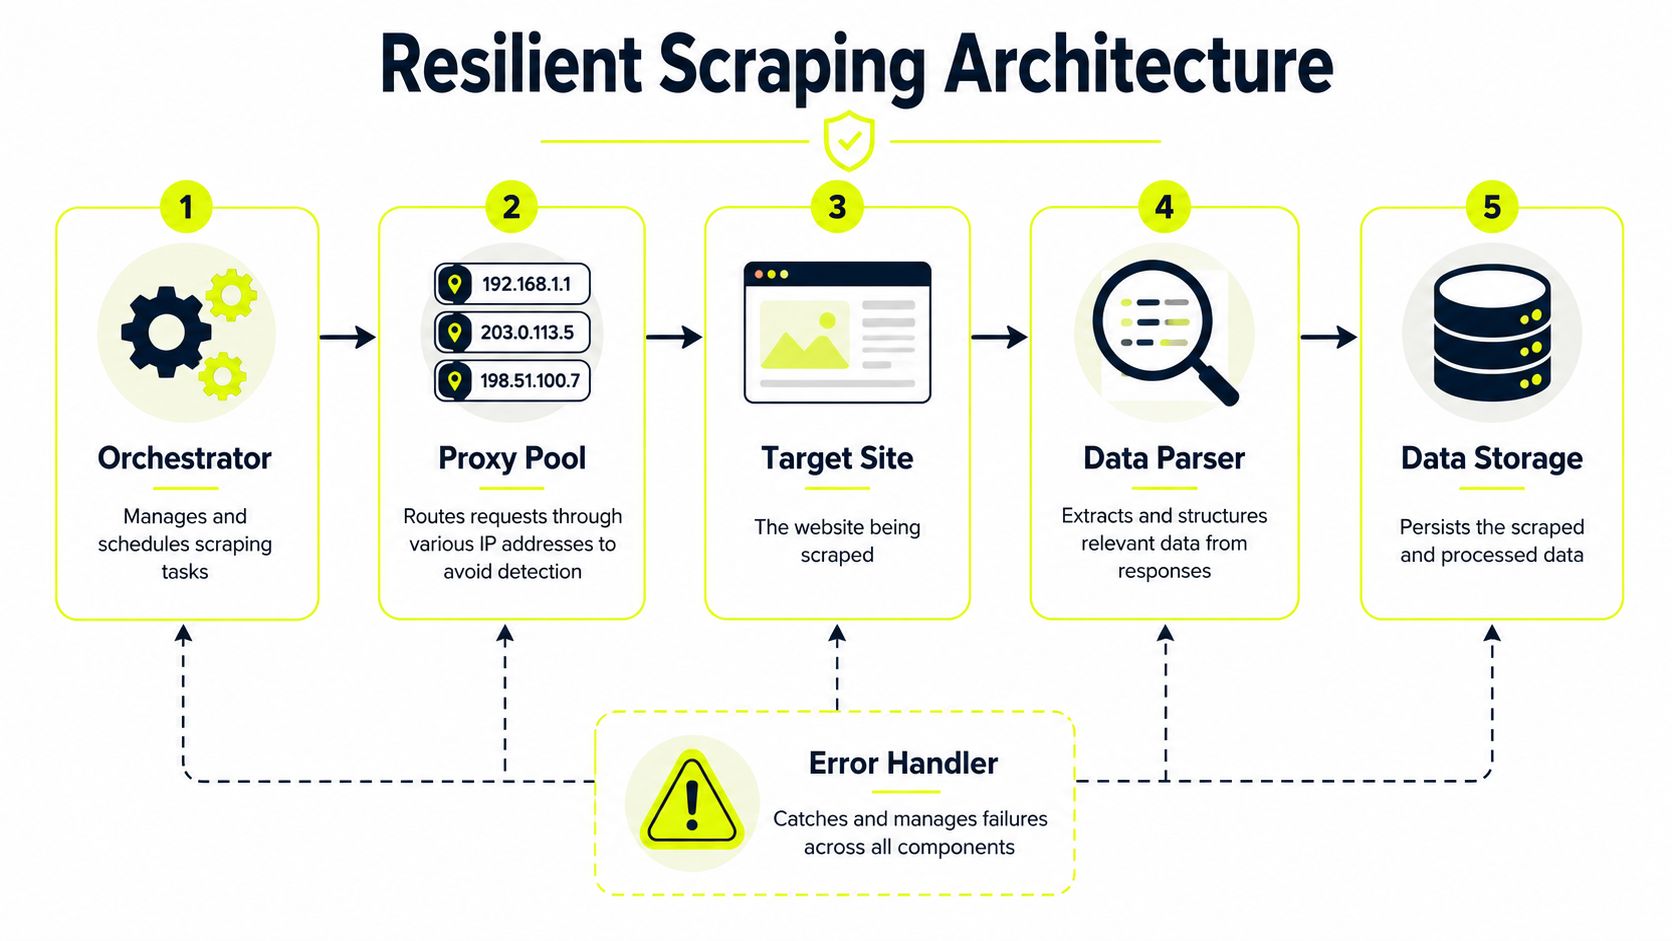
Cómo debería verse el flujo de producción
Piensa en cinco partes móviles más una ruta de error compartida.
Orquestador
Este es tu plano de control. Crea trabajos, asigna prioridad, selecciona marketplace y región, y decide si una petición debe pasar por captura directa de HTML o un endpoint de scraper administrado.Programador de peticiones
Esta capa debe gestionar encolamiento, ritmo, timing de reintentos y límites de concurrencia. No dejes que los workers tomen decisiones de reintento de forma aislada. Martillarán el mismo patrón objetivo y te bloquearán más rápido.Capa de gestión de proxies
La mayoría de las construcciones débiles colapsan en este punto. La capa necesita seleccionar el tipo de proxy por tarea, aplicar política de rotación, preservar sesiones sticky cuando sea necesario, y exponer la geolocalización como un parámetro de petición real.Parser y validador
Parsea solo después de que la respuesta pase verificaciones básicas. Detecta plantillas vacías, páginas de CAPTCHA, contenido parcial y desajuste de región antes de escribir nada downstream.Almacenamiento y entrega
Almacena metadatos de respuesta cruda, payload parseado y estado del trabajo por separado. Esa separación hace posible la reproducción cuando un parser se rompe.
Un manejador de errores central debe vigilar cada etapa. Si una petición falla debido a una mala región de proxy, el programador necesita esa señal. Si el parser empieza a devolver nulos para calificaciones o bloques de ofertas, el orquestador necesita degradar esa ruta o cambiar el modo de recolección.
La mayoría de las interrupciones de scrapers no son causadas por una petición bloqueada. Vienen de una cola que sigue alimentando una configuración rota.
La segmentación por código postal tiene que ser nativa
Esta es la pieza que la mayoría de los tutoriales omiten, y es una gran falta para arbitraje y operaciones publicitarias.
Si estás verificando precios localizados, elegibilidad de envío o disponibilidad de productos para campañas geosegmentadas, la geolocalización a nivel de país no es suficiente. Necesitas ejecución programática por código postal. Eso significa que tu modelo de trabajo debe llevar el marketplace, el código postal objetivo, la política de sesión y la política de proxy juntos, no como parámetros ad hoc dispersos entre workers.
Solo 2 de las 9 principales APIs de scraping de Amazon admiten explícitamente segmentación a nivel de código postal con proxies residenciales, y esto se volvió más importante después de las actualizaciones anti-bot de Amazon de 2025 que impusieron validación de ubicación basada en IP más estricta, como se señala en esta discusión sobre scraping basado en ubicación en Amazon. Si tu sistema no puede cambiar la geolocalización en código sin reinicios manuales de sesión, recopilarás datos de ubicación inconsistentes y no sabrás qué respuestas son incorrectas.
Un flujo de arquitectura práctico se ve así:
- Ingreso de trabajo: keyword, ASIN, URL de vendedor o URL de categoría entra en la cola.
- Vinculación de ubicación: el orquestador adjunta el código postal objetivo y el marketplace.
- Resolución de proxy: la capa de proxy selecciona un endpoint residencial a nivel de ciudad que coincida con el trabajo.
- Obtener y verificar: el worker confirma que la página devuelta refleja el contexto de entrega esperado.
- Parsear y publicar: solo los registros validados llegan a tu webhook, almacenamiento de objetos o base de datos.
Si estás construyendo tus propias piezas de infraestructura, una referencia útil para la fontanería subyacente es este tutorial de implementación de servidor proxy. Incluso si no construyes la capa de proxy tú mismo, ayuda entender dónde debe residir la lógica de sesión.
Ejecutando un Plan Estratégico de Proxies
La política de proxies es donde los programas de scraping de Amazon suelen fallar.
Un worker puede tener lógica de parsing limpia, reintentos y headers decentes, y aún así fallar porque la capa de proxy fue tratada como un pool de commodities. En Amazon, la selección de proxy controla tres cosas que importan a los operadores: si las solicitudes son servidas, si los datos dependientes de ubicación son confiables, y si el costo por página utilizable se mantiene predecible entre cuentas y campañas.
Matriz de Selección de Tipo de Proxy para Scraping de Amazon
| Tipo de Proxy | Caso de Uso Principal | Nivel de Sigilo | Costo Relativo | Ajuste para Amazon |
|---|---|---|---|---|
| Residential | Páginas de productos, resultados de búsqueda, páginas de vendedor, precios localizados, ofertas sensibles a entrega | Alto | Medio a alto | Pool principal para scraping en producción |
| Mobile | Acciones sensibles de cuenta, flujos de verificación, calentamiento de cuenta, verificaciones de confianza de alta fricción | Muy alto | Alto | Mejor reservado para operaciones de cuenta, no para recolección masiva de catálogo |
| Datacenter | Obtenciones de bajo valor, QA interno, trabajos de soporte donde los fallos son aceptables | Bajo | Bajo | Útil solo en cargas de trabajo aisladas |
| ISP | Cargas de trabajo mixtas que necesitan menor latencia con mejor confianza que rangos de datacenter estándar | Alto | Medio | Buen pool secundario para trabajos dirigidos |
| IPv6 | Expansión de pool suplementario donde el objetivo lo acepta limpiamente | Variable | Usualmente bajo | Probar de forma aislada antes de usar a escala |
Para scraping de Amazon, los proxies residenciales llevan la carga principal. Son el único predeterminado práctico si necesitas acceso consistente a búsqueda, ofertas, páginas de vendedor y vistas de entrega específicas por código postal. Los proxies de datacenter todavía tienen un lugar, pero solo donde un bloqueo no daña el sistema downstream. Eso significa verificaciones preflight, trabajos de descubrimiento de baja prioridad, monitoreo interno o rutas de reintento que puedes permitirte perder.
La decisión de infraestructura no es solo "qué proxy es mejor". Es cómo segmentar el tráfico para que la mala reputación de IP en un carril no contamine otro. El tráfico de scraping, inicios de sesión de cuenta, operaciones de cuenta publicitaria y verificación adyacente a checkout no deben compartir el mismo pool, la misma duración de sesión o las mismas reglas de rotación.
Divide las cargas de trabajo de proxy por riesgo, no por conveniencia
Un modelo de producción funcional se ve así:
- Pool residencial para recolección de Amazon: úsalo para páginas de búsqueda, páginas de detalle de producto, escaparates de vendedor, reseñas y cualquier flujo que dependa del contexto de entrega.
- Pool móvil para acciones sensibles de cuenta: mantén esto para flujos con mucho login, pasos de cuenta protegidos por confianza y combinaciones de plataforma donde los sistemas antifraude correlacionan la reputación de IP agresivamente entre sesiones.
- Pool ISP para trabajos secundarios sensibles a latencia: útil para endpoints selectivos donde el tiempo de respuesta importa y todavía necesitas una reputación más limpia que un rango de datacenter estándar.
- Pool de datacenter para tráfico de soporte desechable: úsalo para health checks, validación de endpoints y experimentos que nunca deben tocar tu presupuesto de recolección principal.
Esa división importa aún más para la gestión de múltiples cuentas y arbitraje de tráfico. Si una unidad de negocio está validando precios de Amazon por código postal mientras otra está calentando perfiles de navegador para cuentas publicitarias, un pool de proxy compartido crea contaminación cruzada. El historial de sesión, patrones de ASN y picos de tasa se mezclan. Mantén cada carril aislado en el gateway de proxy y aplica esa separación en código, no en notas de runbook.
La política de rotación debe coincidir con la forma del trabajo
La estrategia de rotación es donde los equipos desperdician mucho buen inventario residencial. Amazon no necesita el mismo modelo de sesión para cada solicitud.
Usa sesiones sticky cortas para flujos de búsqueda paginados, sesiones más largas para rutas de ofertas y vendedor que se benefician de la continuidad de cookies, y rotación agresiva para descubrimiento amplio de keywords donde cada solicitud es efectivamente independiente. Si tus workers rotan demasiado rápido, pierdes continuidad y desencadenas páginas de desafío extra. Si mantienen sesiones demasiado largas, las tasas de bloqueo aumentan y una identidad envenenada quema un lote completo. Una referencia práctica sobre establecer políticas de rotación de IP de proxy es útil si estás formalizando esta lógica en la capa de gateway.
La clave es hacer que la rotación sea determinista. Vincúlala al tipo de trabajo, marketplace, código postal y límite de cuenta. No dejes que los workers improvisen.
La segmentación por geolocalización necesita su propia política de proxy
La segmentación por código postal no es una característica de checkbox. Es un requisito de infraestructura.
Si el trabajo dice 10001, la capa de proxy necesita devolver un endpoint que pueda mantener un contexto de entrega consistente de Nueva York el tiempo suficiente para que el worker cargue la página, persista las cookies, verifique el estado de ubicación y recopile el HTML. Lo mismo es cierto para 94105, 60601 o cualquier otra zona de entrega que cambie la disponibilidad, el comportamiento del buy box, las promesas de envío o la visibilidad de colocación patrocinada. El enrutamiento genérico "residencial US" a menudo es demasiado burdo para eso.
En la práctica, el selector de proxy debe resolver al menos en estos campos:
- marketplace
- país
- estado o ciudad, cuando sea compatible
- código postal objetivo
- duración de sesión
- ID de cuenta o tenant
- clase de trabajo, como búsqueda, PDP, vendedor, reseñas u ofertas
Eso te da algo que puedes auditar más adelante. Si aparece una estimación de entrega incorrecta en la página, puedes rastrear si el problema provino de una geografía de proxy incorrecta, una sesión obsoleta, o Amazon restableciendo la ubicación durante el flujo.
IPv6 y capacidad económica
IPv6 puede ampliar el pool para trabajos de bajo riesgo, pero debe mantenerse fuera de la ruta principal de recolección de Amazon hasta que demuestre estabilidad en tus propias pruebas. La aceptación varía según la calidad de la ruta y las páginas exactas que consultes. Trátalo como un carril suplementario. No lo mezcles en recolecciones de alto valor donde necesitas validación de contexto de entrega predecible.
Los proxies económicos también conllevan un costo operativo. Aumentan los reintentos, crean más respuestas parciales y elevan el número de registros que necesitan validación antes de poder confiar en ellos. Ese costo aparece después como excepciones del parser, cambios de inventario falsos y malas decisiones de campaña.
El gasto en proxies es fácil de medir. Los datos de ubicación incorrectos no lo son. Por eso el plan de proxies debe diseñarse antes de que el crawl escale.
Ingeniería de solicitudes indetectables
Una ruta de proxy limpia no es suficiente. Amazon califica toda la cadena de solicitud: comportamiento TLS, encabezados, cookies, orden de navegación y timing. Si esas piezas no encajan, la solicitud se desafía mucho antes de que tu parser vea una página de producto.
Construye huellas de solicitud similares a las de navegadores
El tráfico de Amazon falla cuando los equipos mezclan el claim de un navegador con el comportamiento de otro navegador. Un user agent de Chrome emparejado con client hints incompletos, cookies sin estado y un patrón genérico de librería HTTP es fácil de clasificar. La solución es la consistencia en toda la sesión, no la aleatorización.
Mantén cada perfil de navegador internamente coherente:
- Familia User-Agent: haz coincidir el navegador y la versión que pretendes simular.
- Accept-Language: haz coincidir el marketplace, la configuración regional de la cuenta y el contexto de entrega.
- Accept-Encoding: envía valores que tu cliente pueda manejar.
- Client hints: incluye encabezados como
Sec-CH-UAsolo si el resto de la huella los soporta. - Continuidad de cookies: persiste las cookies a través de pasos relacionados como búsqueda, PDP, ofertas y paginación. Reinícialas entre trabajos o tenants no relacionados.
Si estás configurando solicitudes en la capa del cliente, esta guía sobre encabezados de solicitud en Python es útil para construir conjuntos de encabezados que permanezcan consistentes bajo carga.
El ángulo de infraestructura importa aquí. Los equipos que ejecutan scraping multi-cuenta y arbitraje de tráfico a menudo envenenan su propio entorno al reutilizar las mismas reglas de perfil de navegador en trabajos muy diferentes. Un crawl de ofertas de vendedor, una verificación de anuncios y una solicitud de buy box específica de ubicación no deberían heredar todos el mismo jar de cookies o plantilla de encabezados. Aísla los perfiles por clase de trabajo y grupo de cuentas, luego registra la huella exacta asignada a cada solicitud. Así es como depuras una caída en la tasa de éxito sin adivinar.
Ritma las solicitudes como un scheduler, no como un script
El timing es parte de la huella. Intervalos fijos, brechas de reintento idénticas y bucles de reintento locales al worker crean un patrón que Amazon puede clasificar incluso si los encabezados se ven bien.
Usa reglas de ritmo a nivel de scheduler:
- Agrega jitter a cada ventana de despacho.
- Reserva sesiones sticky para flujos que necesitan continuidad, como carrito, confirmación de ubicación o recorrido paginado de ofertas.
- Retrocede en respuestas 429, 503 y soft block con retrasos crecientes.
- Limita los reintentos por ruta y devuelve el trabajo fallido a una cola central.
- Pon en cuarentena las rutas débiles en lugar de dejar que los workers las martilleen.
Esta es una de las diferencias más claras entre un script y una operación que escala. Un script reintenta porque quiere la página. Un scheduler ingenierizado protege la IP, la sesión y el resto del lote.
Uso una regla simple en producción. Si el mismo worker ve soft blocks repetidos de una ruta, pierde autoridad para continuar. El scheduler decide si intercambiar la huella, enfriar la sesión, cambiar de geografía o lanzar el trabajo a un carril de menor prioridad. Eso previene tormentas de reintentos, que son costosas y fáciles de detectar.
Para un recorrido visual del manejo de solicitudes anti-bloqueo, este clip es útil:
El cambio es operativo. Las altas tasas de éxito provienen de hacer coincidir la identidad de la solicitud, el estado de sesión y el ritmo con el trabajo exacto que se está ejecutando, especialmente cuando se rota entre cuentas y flujos de recopilación dirigidos por código postal a gran escala.
Neutralizar CAPTCHAs y la Detección de Bots
Los CAPTCHAs son un indicador rezagado. Si sigues viéndolos, el problema generalmente comenzó antes con la confianza del proxy, las huellas digitales de las solicitudes o el ritmo.
Evitar es mejor que resolver
La estrategia de CAPTCHA más confiable es reducir la frecuencia con la que Amazon presenta uno en primer lugar.
Las APIs dedicadas de scraping de Amazon que utilizan pools masivos de proxies de más de 110 millones de IPs logran consistentemente tasas de éxito superiores al 98%, según el benchmark de APIs de scraping de Amazon de Nimbleway. Esto importa porque una infraestructura de IP limpia es la defensa principal tanto contra CAPTCHAs como contra bloqueos directos.
Esta es también la razón por la que los pools de proxies de baja calidad envenenan las operaciones serias. Las IPs sobreutilizadas reciben más desafíos. Las sesiones desafiadas crean más reintentos. Más reintentos hacen que tu tráfico se vea peor. Luego los operadores pierden tiempo conectando solucionadores de CAPTCHA en una infraestructura que debería haberse arreglado en el origen.
Los CAPTCHAs frecuentes generalmente significan que tu infraestructura está filtrando intención mucho antes de que aparezca la página de desafío.
Para equipos que ejecutan tanto operaciones de scraping como de publicidad, mantén la exposición a CAPTCHA aislada. No permitas que el mismo perfil de navegador o grupo de proxies maneje el scraping de Amazon y las acciones de cuenta de Facebook de manera intercambiable. Si un pool de proxies comienza a atraer tráfico de desafíos repetidos de Amazon, ponlo en cuarentena de tus flujos de trabajo de navegador antidetección.
Cuando aún te encuentras con un muro de CAPTCHA
Aún necesitas una ruta reactiva.
Hay dos opciones prácticas:
- Resolución completamente automatizada: integra un servicio de resolución de CAPTCHA de terceros a través de API. Tu worker detecta el desafío, lo envía, espera el token y luego reintenta la sesión con el estado correcto.
- Resolución semimanual: para flujos de trabajo en Dolphin Anty, AdsPower, GoLogin, Multilogin o Hidemyacc, entrega la sesión a un operador cuando el scraping está vinculado a una tarea de verificación más amplia.
La resolución automatizada se adapta a pipelines de datos siempre activos. La resolución manual se adapta a casos extremos donde un humano ya está verificando un flujo dirigido geográficamente, una variante de página encubierta o una ruta de anuncio a landing.
La trampa es invertir demasiado en la resolución mientras se ignora la causa raíz. Si tu stack de API de scraping de Amazon quema desafíos cada hora, no celebres que tu integración de solucionador funciona. Arregla la selección de rutas, el manejo de cookies y la higiene del proxy.
Si estás trabajando en stacks con mucho JavaScript, esta referencia de scraping en Node es un recurso útil para diseñar un manejo más limpio de detección y reintentos alrededor de flujos de trabajo impulsados por navegador.
Análisis de Datos y Garantía de Entrega
Un scraping no está terminado cuando obtienes una respuesta. Está terminado cuando los datos estructurados y validados llegan a donde el resto de tu sistema pueda usarlos.
El HTML crudo se rompe primero
Muchos pipelines de scraping de Amazon todavía dependen de selectores CSS frágiles y cadenas XPath. Funcionan hasta que Amazon ajusta el diseño de la página, mueve un elemento detrás de un nuevo contenedor o cambia la ruta de renderizado para un bloque de oferta localizado. Entonces tu scraper sigue devolviendo resultados, pero los resultados son incorrectos.
Esa falla silenciosa es peor que un bloqueo total.
Las APIs de scraper administradas resuelven parte de esto devolviendo resultados estructurados en lugar de HTML crudo. Las APIs de scraper de nivel empresarial pueden devolver salidas en formato JSON con campos como ASINs, precios y calificaciones, y pueden entregar resultados de forma asíncrona a través de webhooks o almacenamiento externo como S3 para trabajos de alto volumen, como se describe en esta comparación de APIs de scraper de Amazon.
Eso no significa que el HTML crudo sea inútil. Significa que debes decidir dónde pertenece el riesgo de análisis.
Usa HTML crudo cuando:
- Necesitas control total: lógica de extracción personalizada, auditorías o campos experimentales.
- Puedes mantener analizadores activamente: tu equipo espera desviaciones de diseño y tiene pruebas alrededor de selectores.
- Quieres capacidad de reproducción: mantener capturas crudas ayuda cuando los analizadores fallan.
Usa JSON estructurado cuando:
- Necesitas entrega estable: los sistemas posteriores se preocupan por los datos, no por el marcado.
- Ejecutas alto volumen: el mantenimiento del analizador se convierte en carga operativa.
- Te importa el tiempo de respuesta: los flujos de trabajo de operaciones publicitarias y arbitraje generalmente necesitan campos ahora, no trabajo de análisis después.
Rutas de entrega que no pierden datos
No permitas que tus workers impriman registros en stdout y llames a eso un pipeline.
Usa un modelo de entrega que coincida con el flujo de trabajo:
| Ruta de Entrega | Mejor Ajuste | Por qué funciona |
|---|---|---|
| Webhook | Lógica de campaña casi en tiempo real | Empuja resultados validados directamente a sistemas de verificación o licitación |
| Almacenamiento de objetos | Análisis por lotes y reproducción | Mantiene grandes conjuntos de resultados y cargas útiles crudas disponibles para reprocesamiento |
| Inserción en base de datos | Datos operativos consultables | Bueno para dashboards, uniones y alertas posteriores |
| Traspaso basado en cola | Procesamiento en múltiples etapas | Desacopla obtención, análisis, enriquecimiento y publicación |
Mi regla es simple. Almacena tres cosas por separado: metadatos de solicitud, campos analizados y razón de falla. Esa separación te salva cuando Amazon cambia la estructura de la página o cuando una ruta de proxy comienza a devolver páginas localizadas incompletas.
Si no puedes reproducir los trabajos fallidos de ayer contra el analizador de hoy, tu pipeline es frágil por diseño.
Para equipos de arbitraje, esto también protege la calidad de la campaña. Si una campaña dirigida geográficamente depende de la paridad de precios locales y tu analizador inadvertidamente elimina el bloque de oferta localizado, tomarás decisiones de gasto basadas en datos incorrectos.
Monitoreo Operativo y Cumplimiento
Una vez que tu stack de API de scraping de Amazon esté en vivo, trátalo como cualquier otro servicio de producción. Observa la tasa de éxito, latencia, salud del analizador, retraso de entrega y desviación de costos. Los umbrales exactos dependen de tu stack, pero el principio no. Alerta sobre cambios, no solo sobre interrupciones.
El mayor error operativo es esperar a que los usuarios de negocio reporten datos incorrectos. Tu programador ya debería saber cuándo una región comienza a fallar más que otras. Tu analizador ya debería saber cuándo los campos esperados desaparecen. Tu capa de entrega ya debería saber cuándo los webhooks se acumulan.
Una configuración de monitoreo liviana funciona si se activa. Un stack más pesado con dashboards funciona si alguien se hace cargo. Lo que importa es detectar cambios de diseño, lotes de proxies defectuosos y desajustes de región antes de que se propaguen en decisiones de campaña, acciones de cuenta o informes.
El cumplimiento también importa. Ignóralo y crearás riesgos innecesarios. Evita recopilar datos personales. Revisa robots.txt y los términos para que comprendas qué rutas son sensibles, incluso si tu lógica de recopilación no depende de ellas para los permisos. Mantén un comportamiento de solicitudes disciplinado. La restricción operativa reduce tu perfil de riesgo y generalmente mejora la estabilidad del scraper de todas formas.
Los equipos que perduran en este espacio no tratan el scraping como un hack ocasional. Lo ejecutan como infraestructura.
Si tu operación depende de proxies estables para scraping de Amazon, verificación geo-dirigida, cuentas publicitarias de Facebook y TikTok, account farming o flujos de trabajo con navegadores antidetección, Sota Proxy está diseñado para ese tipo de carga. Ofrece a los operadores opciones residenciales, móviles, ISP, datacenter e IPv6 con segmentación a nivel de ciudad, control de rotación e infraestructura que se ajusta a flujos de trabajo de producción reales en lugar de scripts de demostración.
Artículos relacionados
Redundancia de Red para Plataformas de Proxy y Automatización
Descubre cómo la redundancia de red mantiene en línea las plataformas de proxy y automatización. Cubre configuraciones activo/pasivo, clústeres multirregión, ajuste de conmutación por error y disponibilidad del 99.9%
Distribución Geográfica para Infraestructura de Proxy
Domina la distribución geográfica para infraestructura de proxy. Aprende a elegir ubicaciones, tipos de proxy y estrategias de enrutamiento para verificación de anuncios y scraping
Qué es Sticky Session: Guía Técnica para Usuarios de Proxies
Descubre qué es sticky session, cómo funciona la afinidad de sesión en balanceadores de carga y proxies, y cuándo usarla para multi-accounting, scraping y campañas publicitarias.
Cómo Evitar CAPTCHA en Flujos de Trabajo Automatizados
Aprende cómo evitar CAPTCHA en flujos de trabajo automatizados con tácticas de proxies, navegadores antidetección, control de ritmo de solicitudes y respaldos de resolución diseñados para operadores reales.
Integración de Proxy en AdsPower: La Guía Completa de Configuración
Integración paso a paso de proxy en AdsPower con SotaProxy. Cubre configuración, tipos de proxy, rotación, solución de problemas y mejores prácticas para flujos de trabajo con múltiples cuentas.
7 Mejores Proveedores de Proxies para Arbitraje y Scraping
Compara 7 proveedores de proxies destacados según tipos de IP, segmentación, rotación, uptime, señales de precios y adecuación para scraping, cuentas publicitarias, farming y arbitraje.