Mejores proxies para web scraping en 2026: elige el tipo según tu objetivo
Qué tipo de proxy se ajusta al sitio que estás scrapeando, cuánto cuesta procesar un millón de páginas con cada uno y una prueba de 200 peticiones para distinguir un límite de tasa de un bloqueo por clase de IP.
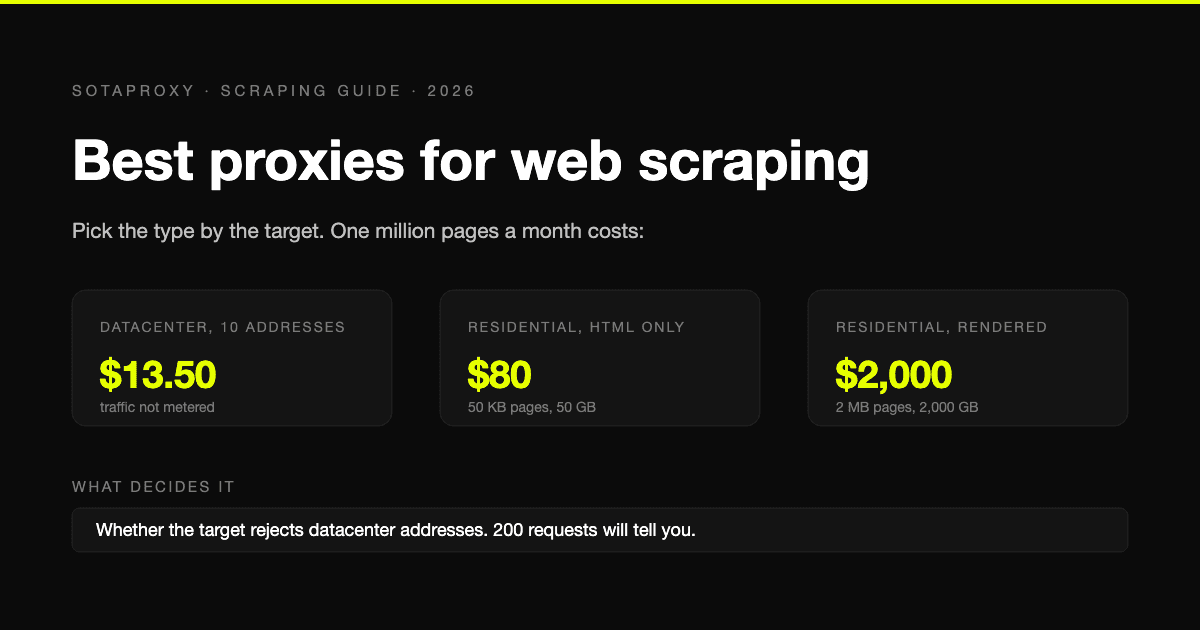
El mejor proxy para web scraping es el tipo más barato que tu objetivo todavía acepte. Esa frase vale más que cualquier lista de los diez mejores, porque la brecha de precio entre tipos es enorme: un millón de páginas al mes cuesta unos $14 con direcciones de datacenter y hasta $2.000 con tráfico residencial si renderizas cada página en un navegador.
Así que la pregunta no es qué proveedor. Es qué tipo, y eso puedes averiguarlo con doscientas peticiones antes de gastar nada serio. Esta guía te da la prueba, el costo de cada tipo por millón de páginas y la configuración que importa una vez que hayas elegido. Los precios son nuestros, tomados de nuestra lista de precios en vivo el 30 de septiembre de 2026.
La respuesta corta, según el objetivo
| Qué estás scrapeando | Tipo de proxy | Cómo se factura |
|---|---|---|
| Sitios sin defensa antibot: documentación, tiendas pequeñas, portales de datos públicos | Datacenter | Por dirección al mes, tráfico sin medición |
| Sitios grandes que responden por IPv6 y no defienden duro | IPv6 | Por dirección al mes, el tipo más barato que vendemos |
| Sitios defendidos: marketplaces, resultados de búsqueda, viajes, entradas | Residencial rotativo | Por gigabyte |
| Páginas detrás de tu propio login | ISP, una dirección estática por cuenta | Por dirección al mes |
| Apps móviles y contenido exclusivo de operadoras | Móvil | Por módem al día |
La mayoría de trabajos de scraping entran en la primera o tercera fila, y el error costoso es pagar por la tercera cuando la primera habría funcionado.
Descubre qué necesita tu objetivo en 200 peticiones
Toma una dirección de datacenter y solicita el mismo tipo de página doscientas veces. No te quedes sólo con los códigos de estado: verifica que la respuesta contenga algo que sólo tiene la página real, como un elemento de título de producto.
import collections
import requests

TARGET = "https://example.com/some/listing"
MUST_CONTAIN = "product-title"      # una cadena que sólo tiene la página real
PROXY = "http://login:password@198.51.100.20:50100"

results = collections.Counter()
for _ in range(200):
    try:
        r = requests.get(TARGET, proxies={"http": PROXY, "https": PROXY}, timeout=20)
    except requests.RequestException:
        results["network error"] += 1
        continue
    if r.status_code == 429:
        results["429 rate limit"] += 1
    elif r.status_code in (403, 503):
        results[f"{r.status_code} block"] += 1
    elif r.status_code == 200 and MUST_CONTAIN not in r.text:
        results["200 without content"] += 1
    elif r.status_code == 200:
        results["ok"] += 1
    else:
        results[str(r.status_code)] += 1

print(results)
Luego lee el resultado:
- Las doscientas están bien. Datacenter es suficiente. Para aquí y no compres tráfico residencial.
- Bien al principio, luego 429. Eso es un límite de tasa sobre la dirección, no un juicio sobre su tipo. Baja la velocidad o añade más direcciones de datacenter. Cambiar a residencial costaría mucho más y no solucionaría nada.
- 403 o una página de desafío desde la primera petición. El objetivo rechaza la clase de dirección. Para esto existe el tráfico residencial.
- 200 sin contenido, siempre. Un bloqueo suave: el sitio responde educadamente con un muro antibot. En nuestras propias pruebas una página de producto de Amazon volvió como HTTP 200 y 3,8 KB de "continúa comprando". Trátalo como un bloqueo, y reintenta con un tipo de dirección diferente.
Un control hace que la prueba sea confiable. Ejecuta el mismo script sin proxy, desde tu propia conexión. Si también estás bloqueado allí, el problema es tu cliente, sus cabeceras o su huella TLS, y ningún proxy de ningún tipo lo arreglará.
Qué cuesta un millón de páginas en cada tipo
Para los tipos facturados por gigabyte el costo lo decide el peso de página, así que usamos pesos que medimos nosotros mismos: 46 KB y 106 KB para el HTML crudo de un artículo de Wikipedia y una página de ciudad de Booking.com, 424 KB y 2.011 KB para las mismas páginas renderizadas en un navegador. Las mediciones están en cómo ganar dinero con web scraping.
| Configuración | Tráfico para 1.000.000 de páginas | Costo con nosotros |
|---|---|---|
| Datacenter, diez direcciones | Sin medición | $13,50 al mes |
| IPv6, cien direcciones | Sin medición | $20 al mes |
| Residencial, sólo HTML, páginas de 50 KB | unos 48 GB | $80 por un paquete de 50 GB |
| Residencial, sólo HTML, páginas de 106 KB | unos 101 GB | unos $150 |
| Residencial, renderizado, páginas de 424 KB | unos 405 GB | $650 por un paquete de 500 GB |
| Residencial, renderizado, páginas de 2 MB | unos 1.920 GB | $2.000 por un paquete de 2.000 GB |
Esas cifras son antes de reintentos, y una petición fallida se factura como una exitosa.
Dos cosas se siguen de la tabla. Primero, las filas de datacenter no crecen con el volumen. Un millón de páginas al mes es una petición cada 2,6 segundos en todo el trabajo, o una cada 26 segundos por dirección con diez direcciones, lo que casi cualquier sitio tolera. Segundo, en residencial la palanca de costo más grande no es el proveedor ni la tarifa por gigabyte. Es si renderizas. El mismo millón de páginas cuesta $150 como HTML y $2.000 a través de un navegador.
Configuración que importa una vez que hayas elegido
La rotación es por conexión, no por petición. En nuestro gateway residencial una nueva conexión obtiene una nueva salida. Un cliente que mantiene conexiones vivas, que es lo que hacen los objetos de sesión en las librerías HTTP, mantiene la dirección con la que empezó. Si tu scraper muestra una dirección durante minutos, es por eso.
La solución limpia es controlarlo tú mismo con identificadores de sesión en el login:
import itertools
import requests

GATEWAY = "proxy.sotaproxy.com:10000"
counter = itertools.count(1)

def proxy_for_new_exit(country="US"):
    n = next(counter)
    url = f"http://login_c_{country}_s_{n}_ttl_30s:password@{GATEWAY}"
    return {"http": url, "https": url}

session = requests.Session()
r = session.get("https://example.com/page/1", proxies=proxy_for_new_exit(), timeout=30)
Cada nuevo identificador pide una nueva salida, y reutilizar un identificador mantiene la misma durante tanto tiempo como su vida útil permita.
Mantén una dirección para cualquier cosa con estado. Paginación que depende de una cookie, un carrito, una sesión de búsqueda: dale a ese trabajo un identificador con una vida útil de quince minutos o una hora. Las tres vidas útiles y cómo elegir entre ellas están en la referencia de sesiones rotativas y pegajosas.
Dale a cada worker su propio identificador. Dos workers compartiendo uno comparten una salida, y el objetivo ve un visitante haciendo el doble de peticiones.
Elige el país de salida para que coincida con el sitio. Un minorista del Reino Unido muestra precios y stock del Reino Unido a direcciones del Reino Unido. Nuestras direcciones de datacenter se venden por país en 41 países, el Reino Unido, Estados Unidos y Alemania entre ellos, y el tráfico residencial toma el país como un sufijo en el login.
Reduce el peso de página antes de reducir la tasa. En un navegador headless, bloquea lo que no analizas:
BLOCKED = {"image", "media", "font"}
def drop_heavy(route):
if route.request.resource_type in BLOCKED:
route.abort()
else:
route.continue_()page.route("**/*", drop_heavy)
Esa es la API de Python de Playwright. No hace que una página renderizada sea barata, ya que los scripts y las hojas de estilo representan la mayor parte del peso, pero elimina la parte que nunca necesitaste.
Proxies IPv6 para scraping: cuándo funcionan
Las direcciones IPv6 cuestan $0,20 cada una al mes con nosotros, el precio más bajo de nuestro catálogo. Solo funcionan si el sitio objetivo publica un registro AAAA, lo que significa que el sitio es accesible por IPv6.
Verificamos esto para los sitios grandes el 8 de septiembre de 2026. Google, YouTube, Facebook, Instagram, LinkedIn, Reddit, Wikipedia y Amazon responden por IPv6. X, TikTok, eBay, AliExpress y Walmart no. La lista completa por país, con un script para verificar cualquier dominio tú mismo, está en nuestra página de soporte IPv6.
Dos advertencias antes de que compres mil de ellas:
- Accesible no es lo mismo que permisivo. Un sitio puede responder por IPv6 y aun así bloquear rangos de centros de datos. Ejecuta primero la prueba de 200 solicitudes en una dirección IPv6.
- Los sitios cuentan IPv6 por bloque, no por dirección. Como un suscriptor normalmente recibe un /64 completo, los límites de tasa se aplican comúnmente al /64 o más amplio. Muchas direcciones de un mismo bloque pueden comportarse como una sola dirección.
Vendemos IPv6 en 17 países. Los detalles están en la página de proxies IPv6.
Cuando un proxy no es la solución
Los proxies cambian la dirección desde donde proviene una solicitud. No cambian cómo se ve el cliente.
- La página es un cascarón vacío hasta que se ejecutan los scripts. Nuestra solicitud sin procesar a un listado de Reddit devolvió 8 KB titulados "Reddit". Eso necesita un navegador, independientemente del proxy.
- Estás bloqueado incluso sin un proxy. Eso es fingerprinting del cliente, y la solución está en el cliente.
- No quieres mantener nada de esto. Entonces compra el resultado en lugar del tráfico. Bright Data, Oxylabs y Zyte venden unblockers y APIs de scraping que manejan renderizado, reintentos y desafíos como un servicio administrado. Nosotros no vendemos uno. Los dos más grandes se comparan en Bright Data vs Oxylabs.
Dónde comprar
Para tráfico residencial, los precios de cinco proveedores a 10, 100 y 1.000 GB están en mejores proxies residenciales. Al momento de escribir esto, somos los más baratos de los cinco por gigabyte, y no tenemos ningún benchmark de terceros publicado, así que prueba antes de comprar volumen.
Para direcciones de centros de datos, ISP e IPv6, nuestros precios son $1,80, $3,00 y $0,20 por una sola dirección al mes, bajando a $1,35 y $2,10 por diez direcciones para las dos primeras. No hay suscripción, y el pago es solo en criptomonedas. Las escalas completas están en la página de precios.
Si quieres ejecutar la prueba de 200 solicitudes antes de pagarle a alguien, Webshare ofrece diez proxies compartidos de centros de datos gratis. Las direcciones compartidas fallan más a menudo que las dedicadas, así que un resultado exitoso ahí es buena señal y un fallo no es la palabra final.
Preguntas frecuentes
¿Cuál es el mejor proxy para web scraping?
El tipo más barato que acepte el objetivo. Centro de datos para sitios sin defensa antibot, residencial para sitios que rechazan rangos de centros de datos, una dirección ISP estática para cualquier cosa detrás de un login. Averigua cuál aplica con una prueba de 200 solicitudes en una dirección de centro de datos.
¿Necesito proxies residenciales para scraping?
Solo si el objetivo bloquea direcciones de centros de datos por clase, lo que aparece como un 403 o un muro antibot desde la primera solicitud. Un 429 después de una serie de solicitudes exitosas es un límite de tasa, y más direcciones de centros de datos lo resuelven a una fracción del costo.
¿Cuántos proxies necesito?
Divide las páginas que necesitas por día entre lo que una dirección puede obtener bajo el límite del objetivo. Si un sitio tolera una solicitud cada dos segundos desde una dirección, una dirección obtiene unas 43.000 páginas al día. Para un millón de páginas al mes eso es una sola dirección en el papel, y diez en la práctica para margen. En residencial rotativo la pregunta no aplica: compras gigabytes, y el pool suministra las direcciones.
¿Son suficientes los proxies gratuitos o los scrapers de proxies?
Un scraper de proxies recopila listas públicas de proxies, y esas direcciones se comparten con todos los demás que rasparon la misma lista. Espera que la mayoría estén muertas o ya bloqueadas en cualquier sitio que valga la pena scrapear. Están bien para aprender cómo funcionan los proxies y no para un trabajo del que dependas.
¿HTTP o SOCKS5 para scraping?
HTTP, a menos que tu herramienta necesite algo que HTTP no pueda transportar. Cada producto que vendemos habla ambos. Si usas SOCKS5, escribe socks5h:// para que los nombres de host se resuelvan del lado del proxy y no en tu máquina. Los detalles están en protocolos y puertos.
¿Es legal el web scraping?
Depende del país, de qué son los datos y de cómo los uses. Los datos públicos no personales se tratan de forma muy diferente a los datos personales o contenido detrás de un login, y los términos de un sitio también pueden importar. Esto no es asesoría legal. Si los datos son personales o el proyecto es comercial, consulta a un abogado antes de escalar.
Artículos relacionados
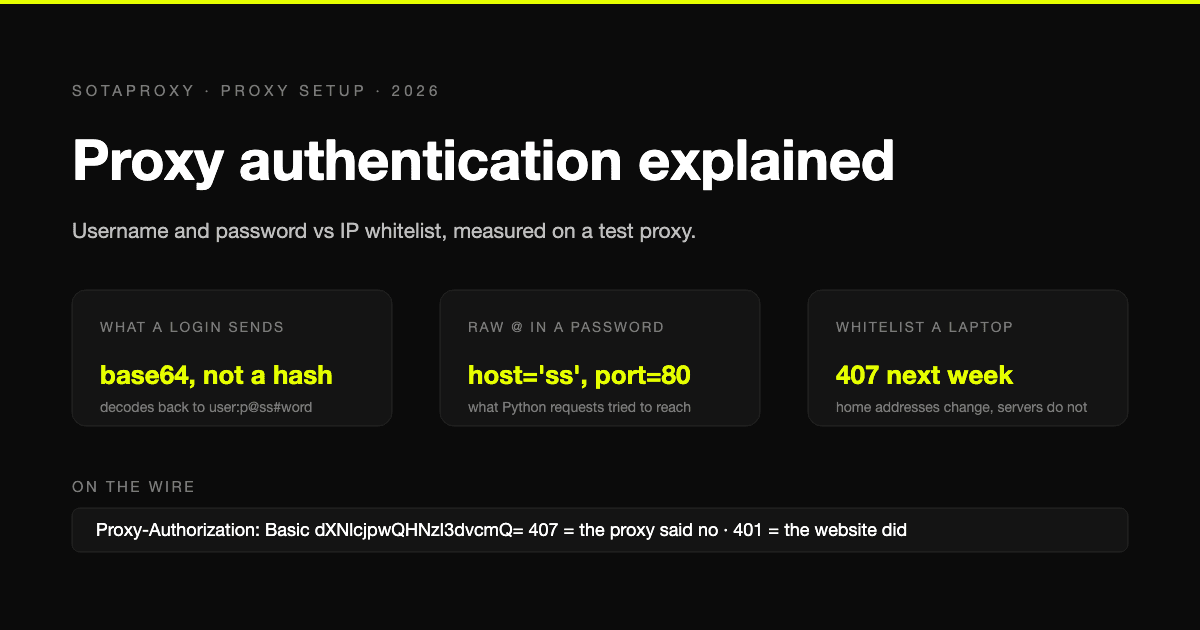
Autenticación de proxy: usuario y contraseña o whitelist de IP
Un proxy sabe que eres tú de dos maneras: por las credenciales que envías en cada conexión o por una lista de direcciones a las que deja pasar sin ellas. Qué envía cada método por la red (medido en un proxy de prueba), qué herramientas solo admiten uno y por qué un portátil en la whitelist deja de funcionar una semana después.
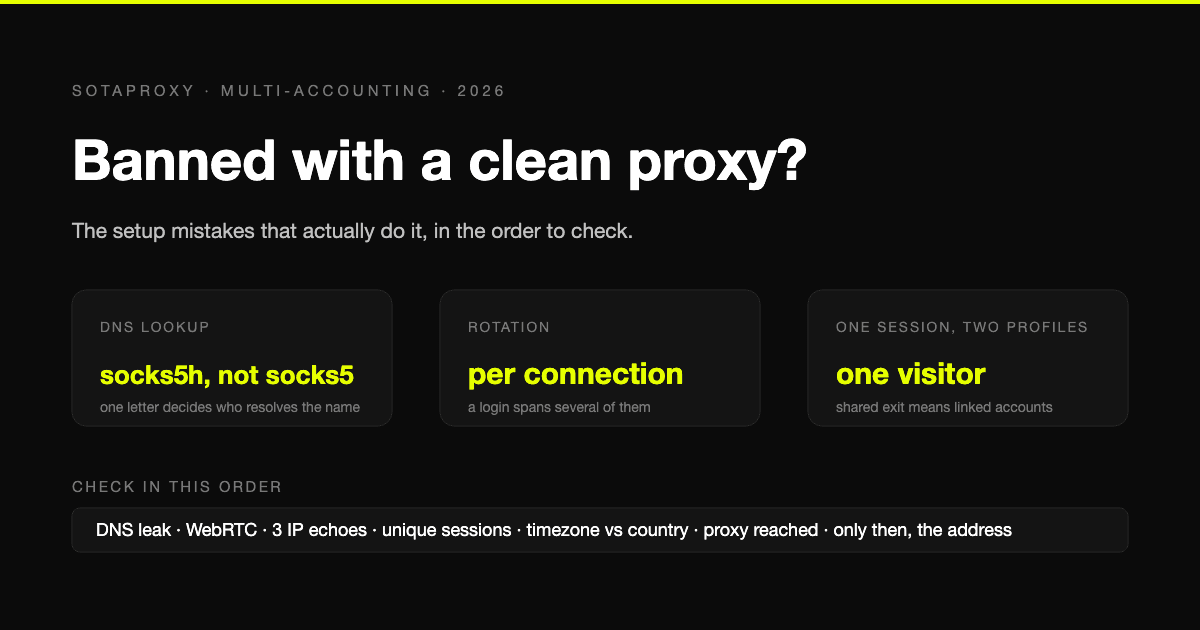
¿Baneado con un proxy limpio? Los errores de configuración que de verdad lo provocan
El proxy estaba limpio, la IP era residencial y la cuenta murió igual. En la mayoría de los casos que vemos, la dirección nunca fue el problema. Siete fallos de configuración, cada uno comprobable en un minuto, en el orden en que suelen resultar ser la causa.
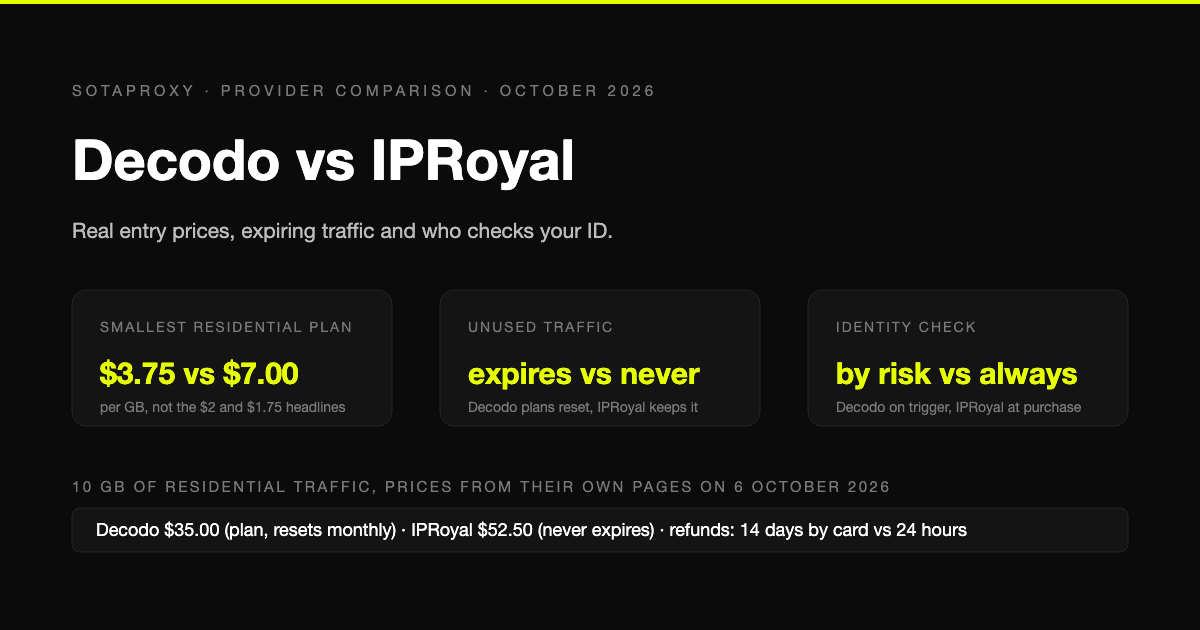
Decodo vs IPRoyal en 2026: precios de entrada reales, tráfico que caduca y quién verifica tu identidad
Ambos son proveedores de proxies de gama media que aceptan tarjeta y cripto y venden por gigabyte. Los precios de sus propias páginas a 6 de octubre de 2026, por qué ninguna tarifa de portada es un precio de entrada, a quién le caduca el tráfico, quién verifica tu identidad antes de dejarte comprar y quién devuelve el dinero.
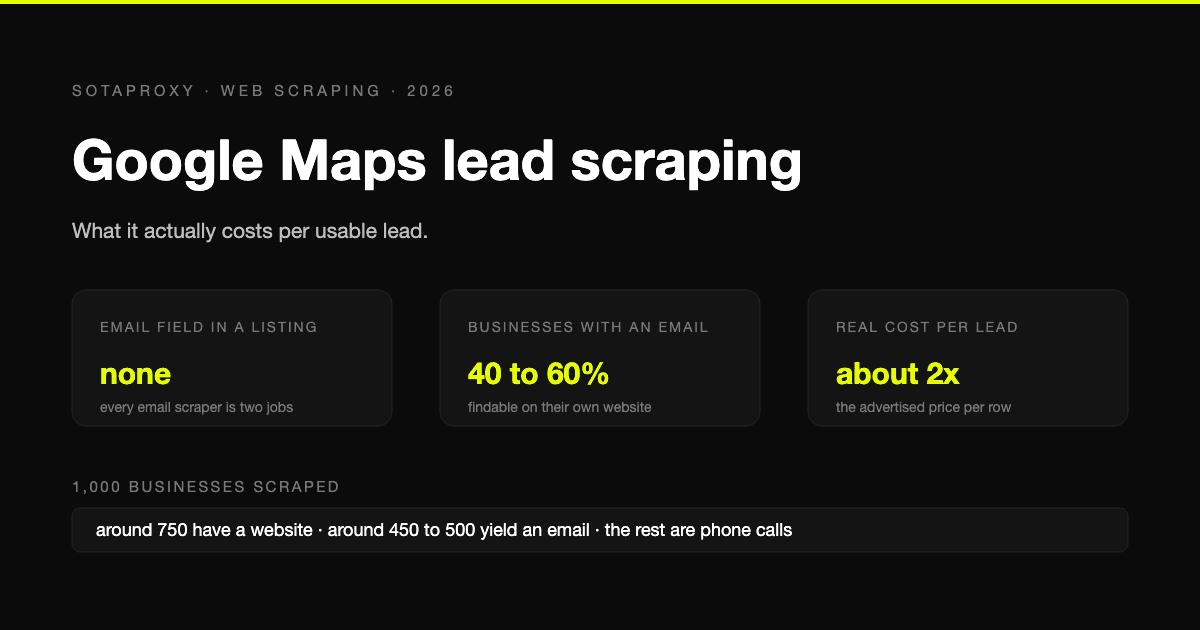
Scraping de Google Maps: cuánto cuesta realmente cada lead con email
Google Maps no tiene campo de correo, así que todo scraper de emails es una pipeline de dos pasos y solo la mitad de los negocios devuelven una dirección. Qué cuesta realmente obtener mil fichas en leads utilizables, el problema de los negocios sin web y qué dice la ley tras la sentencia de SerpApi.
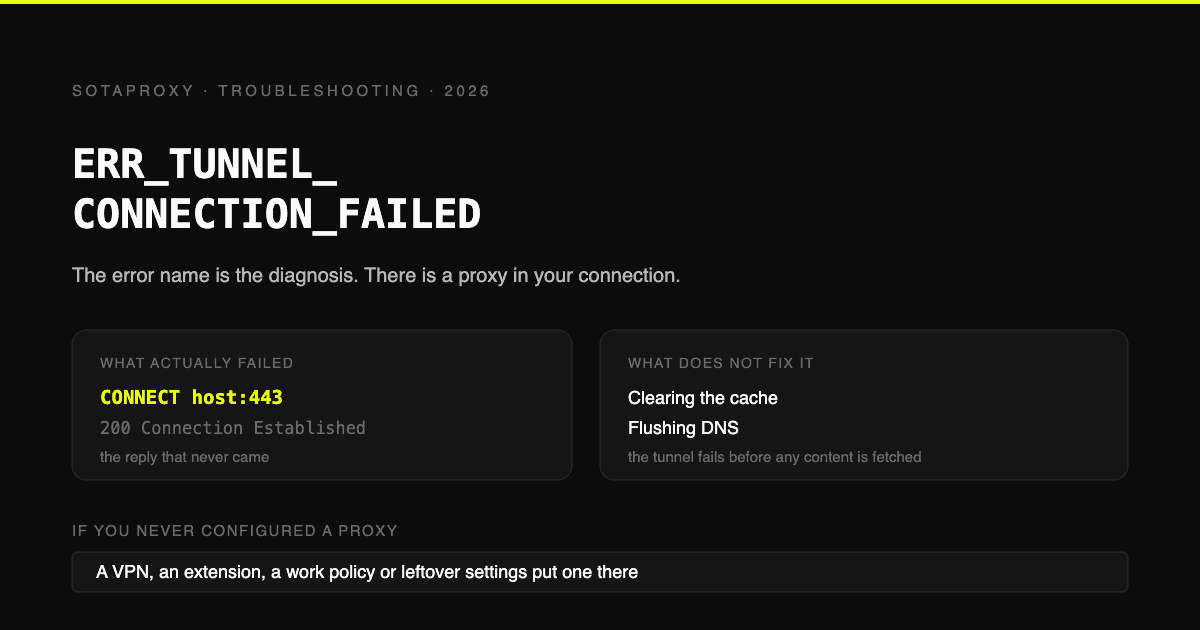
ERR_TUNNEL_CONNECTION_FAILED: el nombre del error ya es el diagnóstico
Chrome le pidió a un proxy que abriera un túnel CONNECT y falló. Eso es todo el error. De dónde sale ese proxy cuando nunca configuraste ninguno, las seis razones por las que un proxy configurado puede generar este error, y por qué limpiar la caché no soluciona nada.
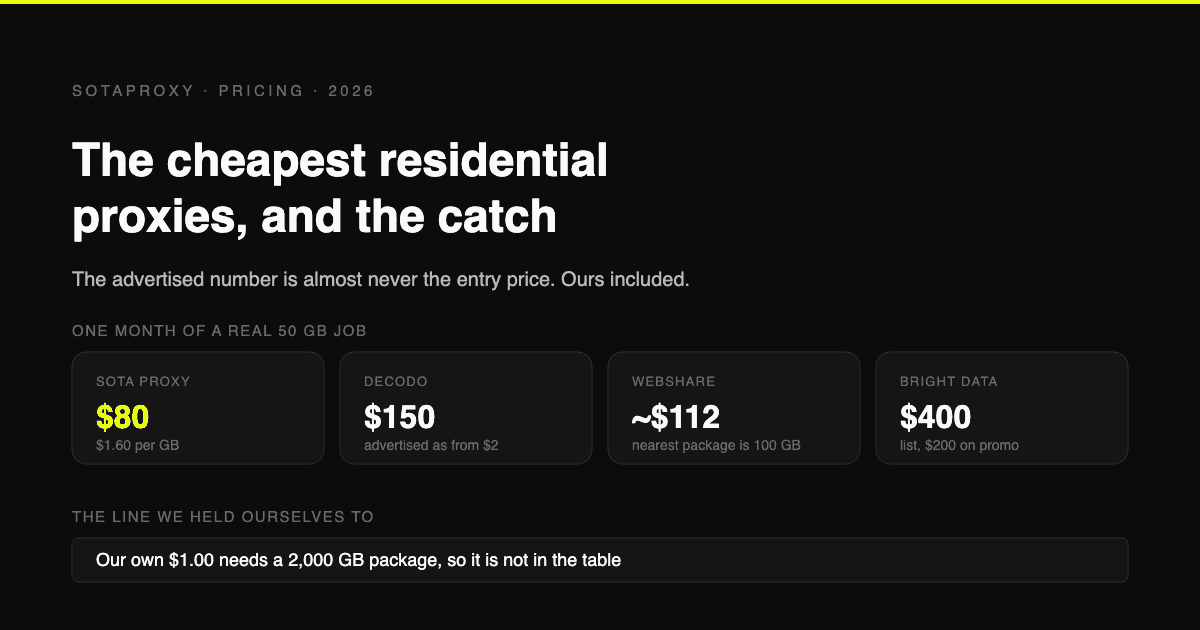
Los proxies residenciales más baratos en 2026 y la trampa oculta de cada proveedor
Precios verificados por gigabyte extraídos directamente de las páginas de cinco proveedores, no de artículos desactualizados. Por qué la tarifa anunciada casi nunca es el precio real de entrada, qué proveedores te obligan a pagar un mínimo mensual y cómo calcular tu costo real por gigabyte.