Suplantación de Huella Digital: Métodos, Detección y Uso de Antidetect
Descubre cómo funciona la suplantación de huella digital, los métodos utilizados para eludir la detección y cómo los navegadores antidetect con proxies gestionan operaciones multi-cuenta de forma segura.
Tienes 30 cuentas de Facebook en calentamiento, creatividades de TikTok en cola y perfiles de navegador separados mapeados a proxies separados. Entonces una cuenta se abre con un resultado de canvas diferente, un renderizador WebGL que no coincide con el dispositivo declarado y una zona horaria que pertenece a otra región. La primera restricción parece aislada. Rara vez permanece así. Las verificaciones de confianza se propagan a través de perfiles vinculados, sesiones, actividad de pagos e historial de red hasta que una pequeña discrepancia de huella digital se convierte en una cascada completa de cuentas.
La suplantación de huellas digitales no resuelve ese problema por sí sola. Cambia señales seleccionadas del navegador, pero las operaciones confiables necesitan un stack antidetect completo, incluyendo un perfil de navegador persistente, un proxy coincidente, comportamiento controlado, cookies limpias e historial de cuenta consistente. El mismo principio aplica para el farming de cuentas, cloaking y campañas geotargetizadas en Facebook y TikTok.
El contexto técnico es más amplio que las herramientas de navegador. La suplantación de huellas digitales ha sido un problema formal de investigación en seguridad biométrica desde al menos principios de los años 2000. La investigación sobre detección de ataques de presentación de huellas digitales evolucionó desde verificaciones básicas de materiales falsos hasta métodos estructurados para ataques desconocidos, variación de sensores y análisis de materiales, como se documenta en esta revisión de detección de ataques de presentación de huellas digitales.
Esta guía se enfoca en lo que importa en producción: las señales que exponen los navegadores, los métodos usados para alterarlas, por qué falla la suplantación aleatoria, cómo los sistemas de detección correlacionan capas y cómo la selección de proxies aumenta o reduce el riesgo.
Tabla de Contenidos
- Qué Significa la Suplantación de Huellas Digitales en 2026
- La Anatomía de una Huella Digital de Navegador
- Métodos de Suplantación Comparados Lado a Lado
- Cómo los Sistemas de Detección Capturan Huellas Digitales Suplantadas
- Emparejando Tipos de Proxy con Identidades Suplantadas
- Combinando Navegadores Antidetect con Proxies
- Por Qué la Suplantación Estable Supera a la Suplantación Aleatoria
- Lista de Verificación Operacional para Trabajo Confiable con Múltiples Cuentas
Qué Significa la Suplantación de Huellas Digitales en 2026
Un comprador clona un perfil, asigna un proxy, cambia la ubicación y lanza el mismo flujo de trabajo de Facebook. La cuenta inicia sesión, pero su salida de canvas ya no coincide con sesiones anteriores. WebGL reporta un renderizador que entra en conflicto con el sistema operativo. La IP apunta a una geografía mientras la zona horaria y el idioma del navegador apuntan a otra parte.
Las plataformas no necesitan una señal para probar manipulación. Pueden calificar estas discrepancias con el momento del inicio de sesión, cookies, historial del dispositivo y comportamiento de la cuenta. El resultado pueden ser solicitudes de verificación, revisiones retrasadas de anuncios, pagos rechazados o una cuenta deshabilitada. La pérdida directa es la cuenta y su historial. La pérdida operacional es reconstruir un perfil que nunca alcanzó un estado estable.
Una huella digital de navegador consiste en valores y comportamientos de renderizado que scripts y servicios pueden observar desde un dispositivo y navegador. La suplantación de huellas digitales cambia esos valores expuestos o altera cómo el navegador los produce. La salida de canvas, detalles de WebGL, fuentes, procesamiento de audio, datos de user-agent, propiedades de pantalla y sugerencias de hardware pueden formar parte de esa superficie.
La distinción práctica está entre un valor alterado y una identidad coherente. Un randomizador de canvas cambia un resultado, pero no alinea la geografía del proxy, el comportamiento TLS, cookies, headers del navegador, zona horaria, idioma o patrones de interacción. Una definición útil de browser fingerprinting ayuda a separar las señales observables de los controles usados para modificarlas.
La suplantación es una capa en un stack antidetect, no un truco independiente. El stack también necesita un perfil de navegador persistente, un proxy coincidente, cookies limpias, comportamiento controlado e historial de cuenta consistente. A escala, los patrones repetidos de suplantación y las discrepancias de proxy se vuelven más fáciles de correlacionar, especialmente cuando varias cuentas comparten la misma configuración inusual.
Recursos como la etiqueta de identidad online de Prompt Builder proporcionan contexto para la relación más amplia entre señales del navegador, privacidad y rastreo en línea.
Regla práctica: Un perfil debe parecerse a un dispositivo usado por una persona, no a un conjunto de campos aleatorizados independientemente.
La misma regla aplica para cuentas publicitarias de Facebook y TikTok, sistemas de cloaking de afiliados y campañas geotargetizadas. Los navegadores antidetect mantienen el perfil. Los proxies establecen la identidad de red. El comportamiento y el historial de cuenta configuran la reputación. La suplantación de huellas digitales cubre solo parte del stack.
La Anatomía de una Huella Digital de Navegador
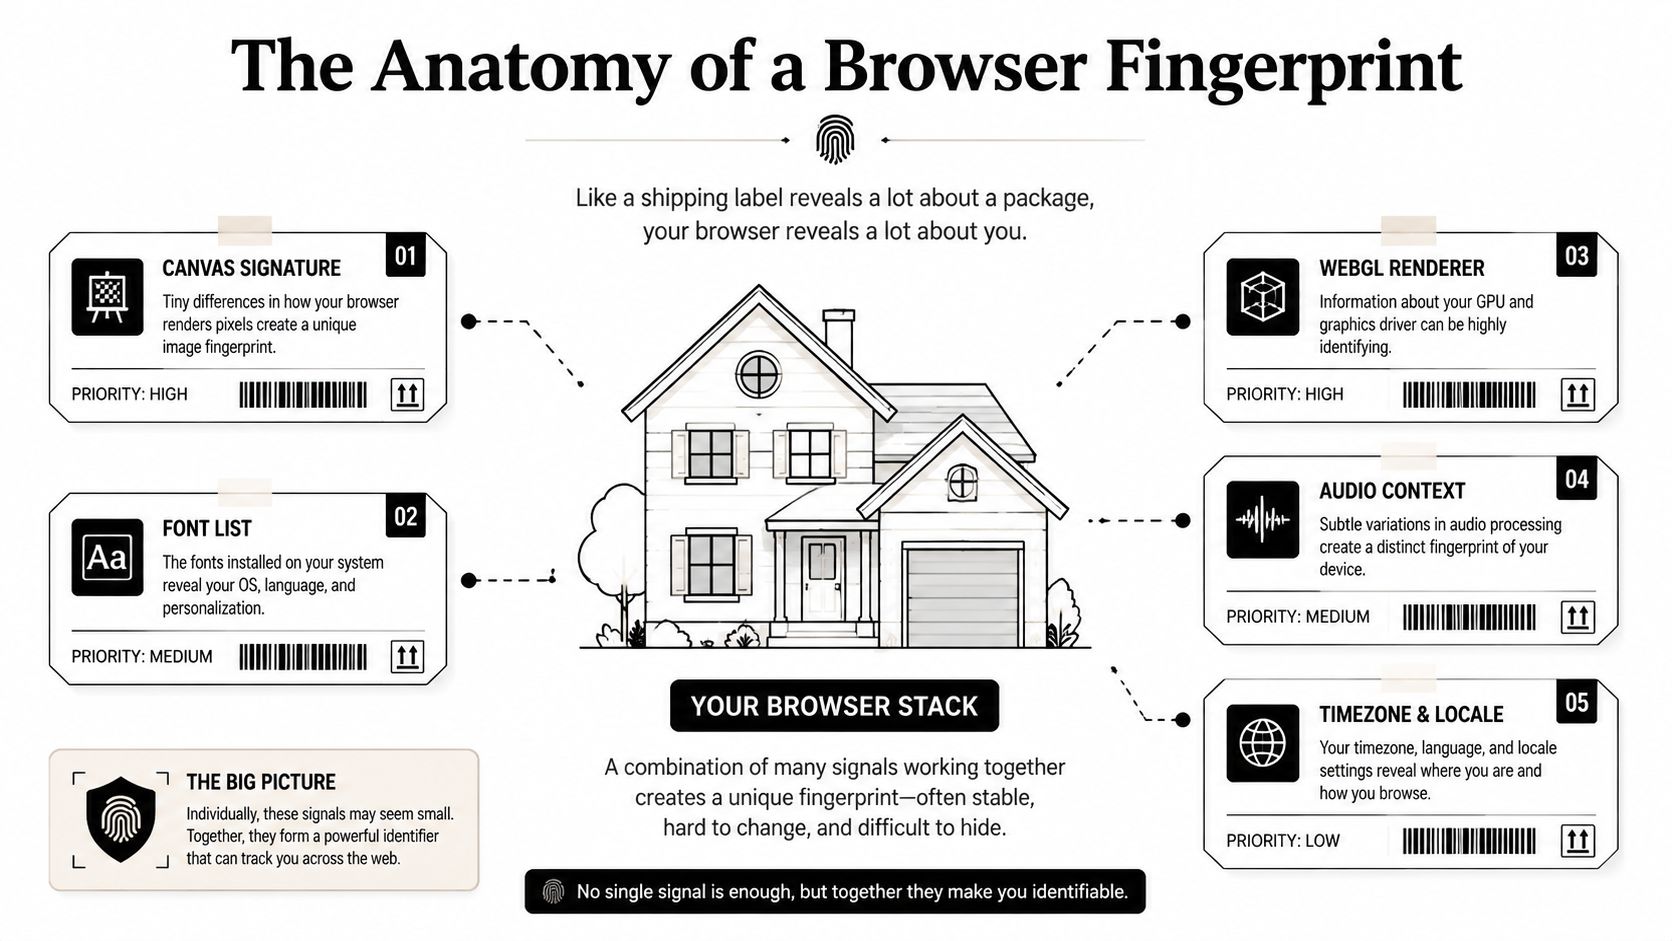
Piensa en el stack del navegador como una casa. El mundo exterior no puede ver cada habitación, pero sí puede leer las etiquetas de envío pegadas a los paquetes que salen de la propiedad. Cada etiqueta revela algo diferente. Cuando las etiquetas no concuerdan, la casa se vuelve sospechosa.
Señales de renderizado y software
El renderizado de canvas pide al navegador que dibuje formas, texto o gradientes y luego mide la salida. Pequeñas diferencias en bibliotecas gráficas, sistemas operativos, controladores y rutas de renderizado pueden producir un resultado reconocible. Aleatorizar la salida de canvas puede ocultar un valor repetible, pero el ruido excesivo puede verse menos natural que una firma estable.
WebGL expone el pipeline de gráficos, incluyendo cadenas de vendor y renderer, comportamiento de shaders y características de precisión. Un perfil que declara una laptop Windows común no debería reportar repentinamente un renderizador asociado con una clase de hardware diferente. WebGL también se conecta con la capa de huella digital TLS y JA3, lo que da a los defensores otra forma de comparar el navegador declarado con el handshake de red.
Las fuentes revelan lo que el sistema operativo y las aplicaciones tienen instalado. Una lista de fuentes puede exponer la plataforma subyacente, la configuración de idioma y a veces el entorno usado para crear el perfil. La enumeración de fuentes es difícil de falsificar limpiamente porque la lista debe concordar con el renderizado de texto, la configuración regional, el diseño de página y el resto del stack del navegador.
El contexto de audio produce otra señal dependiente de la implementación. El procesamiento de audio puede variar según la versión del navegador, el sistema operativo y la ruta de hardware. Un hash de audio falseado que cambia entre sesiones, mientras que todas las demás propiedades del perfil permanecen fijas, crea su propia anomalía.
Hardware, pantalla y entorno
La concurrencia de hardware expone la capacidad de procesador reportada por el navegador. La memoria del dispositivo proporciona otra pista aproximada sobre el hardware. Ningún valor identifica una máquina por sí solo, pero ambos contribuyen a una clase de dispositivo declarada. Un perfil de escritorio de alta memoria emparejado con una conexión de operadora móvil puede requerir mayor escrutinio si el resto de la sesión no respalda esa historia.
La arquitectura de CPU, resolución de pantalla, profundidad de color y escalado de pantalla afectan cómo se renderizan las páginas. Las dimensiones de pantalla también influyen en los diseños responsivos y la geometría de interacción. Un perfil que cambia su resolución en cada sesión no se asemeja a un usuario recurrente.
La zona horaria, el paquete de idioma y el comportamiento de Accept-Language conectan el navegador con una geografía. Una zona horaria que entra en conflicto con la región del proxy es una de las inconsistencias más simples de detectar. La información de la batería puede revelar si un dispositivo se comporta como una computadora portátil, mientras que los plugins instalados y las capacidades del navegador ayudan a distinguir un navegador normal de un entorno gestionado o sintético.
Las plataformas no ponderan todos los campos por igual en cada flujo de trabajo. Los sistemas de confianza de cuentas típicamente evalúan el acuerdo entre capas, no el valor dramático de un atributo aislado. Una huella digital se vuelve útil solo cuando el canvas, WebGL, fuentes, audio, hardware, pantalla, configuración regional y red cuentan la misma historia.
Comparación de Métodos de Falsificación
El enfoque más económico suele ser el menos estable. La aleatorización de canvas puede ser gratuita o estar integrada en una extensión de privacidad, pero solo toca una parte estrecha de la identidad del navegador. La inyección de JavaScript alcanza más atributos, pero las extensiones pueden dejar rastros detectables y pueden fallar cuando un sitio cambia su script de recolección.
La falsificación nativa opera más profundamente dentro de bifurcaciones de Chromium o Firefox. Puede coordinar canvas, WebGL, fuentes, audio y otras propiedades del navegador a través de un modelo de perfil único. Los entornos virtuales completos van más allá al recrear un sistema operativo o contexto de dispositivo, pero consumen más recursos y crean sus propias señales de virtualización.
| Método | Rango de Costo | Riesgo de Detección | Mejor Uso |
|---|---|---|---|
| Aleatorización de canvas | Gratis | Alto cuando se usa solo | Pruebas de bajo riesgo y privacidad básica |
| Inyección de JavaScript | $20-50/mes | Medio a alto | Experimentos controlados y automatización limitada |
| Falsificación nativa basada en hooks | $80-200/mes | Menor cuando se configura consistentemente | Perfiles de tráfico pagado y operaciones de cuentas |
| Entorno virtual completo | $100+/mes | Variable, a menudo alto si hay fugas de virtualización | Pruebas específicas de dispositivo y flujos de trabajo aislados |
Los rangos de costo describen intervalos operativos comunes, no precios de producto garantizados. La estabilidad depende de la implementación, persistencia del perfil, versión del navegador, calidad del proxy y cuán agresivamente el objetivo recopila señales.
Dónde falla primero cada método
La aleatorización de canvas generalmente falla por desacuerdo entre señales. El canvas cambia, pero el renderizador WebGL, las fuentes, la pantalla y el sistema operativo aún identifican el entorno subyacente.
La inyección de JavaScript a menudo falla cuando la plataforma detecta APIs alteradas, comportamiento de extensiones, diferencias de temporización o valores que no se correlacionan. También es vulnerable a actualizaciones de scripts del lado del sitio. Un método que funcionó durante una prueba puede degradarse cuando el objetivo cambia su biblioteca de recolección.
La falsificación nativa tiende a fallar por mala disciplina de perfiles. Los operadores clonan perfiles, rotan user agents o reutilizan la misma identidad de navegador en cuentas no relacionadas. El motor puede ser capaz, pero el proceso operativo crea la señal.
Los entornos virtuales completos fallan cuando el hardware virtual, la capa de automatización o el patrón de teléfono en la nube se vuelve visible. Pueden ser útiles para flujos de trabajo específicos de Android, pero son costosos de escalar y no eliminan la necesidad de un historial de red y comportamiento coherente.
Para tráfico pagado de Facebook y TikTok, la falsificación nativa dentro de un navegador antidetección es la opción práctica. Los métodos solo de extensiones no proporcionan suficiente control para perfiles persistentes, sesiones de pago, cultivo de cuentas, cloaking o campañas geográficamente dirigidas de larga duración.
Cómo los Sistemas de Detección Atrapan Huellas Digitales Falsificadas
La detección moderna no es una sola verificación de vida. Es un pipeline de puntuación en capas que compara la salida del navegador, el contexto de red, el comportamiento y el historial de sesión.
Verificaciones pasivas de inconsistencia
Una plataforma puede inspeccionar cómo se distribuye el ruido del canvas, cómo aparecen las fuentes durante la carga de la página y si la salida de audio se comporta consistentemente. Un aleatorizador que produce un resultado diferente en cada visita puede crear más entropía que un dispositivo normal. La temporización de scripts, respuestas de API y combinaciones de capacidades del navegador añaden contexto adicional.
Correlación entre señales
Las verificaciones más útiles comparan campos relacionados:
- Acuerdo de ubicación: La geografía del proxy, zona horaria, configuración regional del sistema y encabezados de idioma deben alinearse.
- Acuerdo de dispositivo: User agent, dimensiones de pantalla, renderizador WebGL, fuentes y pistas de hardware deben describir la misma clase de dispositivo.
- Continuidad de sesión: Cookies, almacenamiento, historial de perfil y propiedades recurrentes del navegador deben persistir entre inicios de sesión.
- Contexto de red: Reputación de IP, patrones de ASN y actividad de cuentas relacionadas pueden cambiar el significado de una huella digital que de otro modo sería ordinaria.
La biometría del comportamiento proporciona otra capa. Trayectorias del mouse, velocidad de desplazamiento, cadencia del teclado y la temporización de las acciones durante una sesión de apertura pueden separar a un usuario recurrente de un flujo de trabajo programado. Un perfil puede pasar las verificaciones pasivas y aún verse anormal si cada acción sigue el mismo intervalo.
La falsificación biométrica eleva el estándar
La falsificación de huellas digitales también existe fuera del navegador. En seguridad biométrica, la serie de competencias LivDet expuso cuán fuertemente dependen los resultados del sensor y el material de ataque. Una encuesta reporta que los mejores sistemas de LivDet 2009 tenían tasas de error de huellas digitales falsas de 1.9%, 2.8% y 11.4%, dependiendo del sensor. LivDet 2011 permaneció más difícil, con tasas de error falsas de 6.2% a 15.1% y errores de huellas digitales reales tan altos como 29.2%. Para LivDet 2013, algunos sensores alcanzaron 0% de error falso, mientras que otro aún registró 31.3%, mostrando por qué las condiciones del dispositivo importan (historial de benchmark y encuesta).
Las defensas conscientes del material pueden superar las comprobaciones basadas únicamente en imágenes. Un estudio de terahercios reportó tasas de detección verdadera del 87.9% con características tiempo-frecuencia predefinidas y del 98.8% con análisis de aprendizaje profundo (detección de suplantación mediante huella dactilar de propiedades de material).
El equivalente en navegador es la correlación. Un glosario de sistemas anti-bot es una referencia útil para la capa de control más amplia, pero los profesionales deben pensar en términos de evidencia acumulada en lugar de un detector mágico.
Combinación de Tipos de Proxy con Identidades Suplantadas
Un perfil de navegador convincente emparejado con la IP incorrecta aún crea una contradicción. La selección de proxy debe coincidir con la clase de dispositivo, geografía, propósito de la sesión e historial de la cuenta.
Las IPs residenciales se originan en conexiones de internet domésticas. Suelen adaptarse mejor a sesiones de navegador de escritorio que rangos de centros de datos, especialmente para flujos de trabajo de Facebook, TikTok, comercio electrónico y redes sociales con sesión iniciada. Su principal compensación operativa es el costo y la calidad del grupo.
Las IPs móviles provienen de operadores celulares. Pueden llevar un fuerte contexto de consumidor, pero el comportamiento del operador móvil no se ajusta automáticamente a una identidad de escritorio. Un perfil de Windows Chrome en una red de operador móvil puede parecer inusual cuando el patrón de sesión no lo respalda. Los grupos móviles también traen el compartimiento a nivel de operador y comportamiento de red cambiante.
Los proxies de centro de datos provienen de servidores. Son rápidos y económicos para scraping, monitoreo y tareas de infraestructura, pero a menudo llevan señales más fuertes de red de alojamiento. Son una opción por defecto deficiente para sesiones sensibles con inicio de sesión.
Los proxies IPv6 utilizan el espacio de direcciones IPv6 más grande para enmascarar la IP de origen y pueden complicar el rastreo. Su tratamiento varía según la plataforma, y la compatibilidad importa. IPv6 no es automáticamente más confiable que el acceso residencial.
| Tipo de Proxy | Puntuación de Confianza | Costo / GB | Mejor Ajuste |
|---|---|---|---|
| Residencial | Generalmente fuerte para sesiones de consumidor | Variable | Facebook, TikTok, trabajo de cuentas, pruebas geográficas |
| Móvil | Fuerte contexto consumidor-operador | Variable a alto | Cuentas sensibles y flujos de trabajo orientados a móvil |
| Centro de datos | A menudo más débil para sesiones de consumidor con inicio de sesión | A menudo más bajo | Scraping, monitoreo y solicitudes de alto volumen |
| IPv6 | Dependiente de la plataforma | Variable | Gestión de espacio de direcciones y cargas de trabajo compatibles |
Un explicador práctico de proxies como esta guía de SMS Activate sobre servidores proxy puede ayudar al evaluar infraestructura regional. Para detalles de implementación, utilice una comparación de tipos de proxy dedicada.
Regla operativa: El user agent, zona horaria, idioma, perfil de visualización y geografía del proxy deben describir un dispositivo y usuario plausibles.
No existe un número universal de sesiones en el que una discrepancia active una alerta. Las plataformas puntúan el contexto de manera diferente, por lo que las afirmaciones sobre un umbral fijo no son confiables. El enfoque seguro es probar el perfil completo contra el flujo de trabajo objetivo antes de asignarlo a una cuenta valiosa.
Combinación de Navegadores Antidetección con Proxies
Un navegador antidetección es el contenedor. El proxy es la identidad de red. El comportamiento crea la reputación que une ambos.
Comience creando un perfil aislado en AdsPower, Dolphin Anty, GoLogin, Multilogin o Hidemyacc. Estas herramientas difieren en cómo controlan canvas, WebGL, fuentes, audio, datos de user-agent y propiedades a nivel de navegador. Multilogin y AdsPower se seleccionan a menudo para gestión de perfiles a nivel de Chromium, mientras que Dolphin Anty es común en flujos de trabajo de compra de medios de afiliados. GoLogin y Hidemyacc pueden adaptarse a equipos que necesitan perfiles centralizados y separación operativa.
Construya el perfil antes de agregar la cuenta
Elija primero el sistema operativo, familia de navegador, dimensiones de pantalla, idioma y zona horaria. No cree un perfil con una configuración regional y lo corrija después de iniciar sesión. La primera sesión se convierte en parte de la línea base de la cuenta, por lo que las inconsistencias tempranas pueden crear verificaciones innecesarias.
Vincule un proxy a través de la ranura de proxy por perfil del perfil. Mantenga la ubicación de red alineada con la zona horaria y el idioma del navegador. Un proxy residencial generalmente se ajusta mejor a un perfil de consumidor de escritorio que un rango de centro de datos, mientras que una IP móvil necesita un dispositivo y patrón de comportamiento que hagan plausible el contexto del operador.
La guía de integración de proxy de AdsPower es útil para equipos que documentan la asignación a nivel de perfil y comprobaciones de conexión. El mismo principio operativo se aplica a los otros navegadores antidetección.
Agregue comportamiento e higiene de cuenta
Un perfil nuevo no debe comportarse como un script de alta velocidad. Use una cadencia de calentamiento controlada, varíe las duraciones de sesión naturalmente y evite tiempos de acción idénticos entre perfiles. Eso no significa agregar retrasos aleatorios en todas partes. Significa preservar una secuencia creíble, como navegar, leer, desplazarse y completar acciones en intervalos diferentes.
Mantenga las cookies y el almacenamiento local dentro del perfil asignado. No mueva una sesión de Facebook entre navegadores. No abra una cuenta de anuncios de TikTok en un perfil y la gestione desde otro porque el segundo entorno es conveniente. El cultivo de cuentas falla cuando el aislamiento existe solo en el panel del navegador pero no en el flujo de trabajo del operador. Esa brecha es más fácil de ver en configuraciones de agencias donde operadores de chat en tres países comparten una cuenta.
Para cloaking y campañas geo-dirigidas, pruebe la ruta completa desde la geografía declarada. Verifique la respuesta de la página de destino, vista previa del anuncio, configuración regional del navegador y región del proxy como una unidad. Un perfil que funciona para una página pública aún puede fallar una vez que las pantallas de facturación, identidad o gestión de campañas apliquen verificaciones más estrictas.
Por Qué la Suplantación Estable Supera a la Suplantación Aleatoria
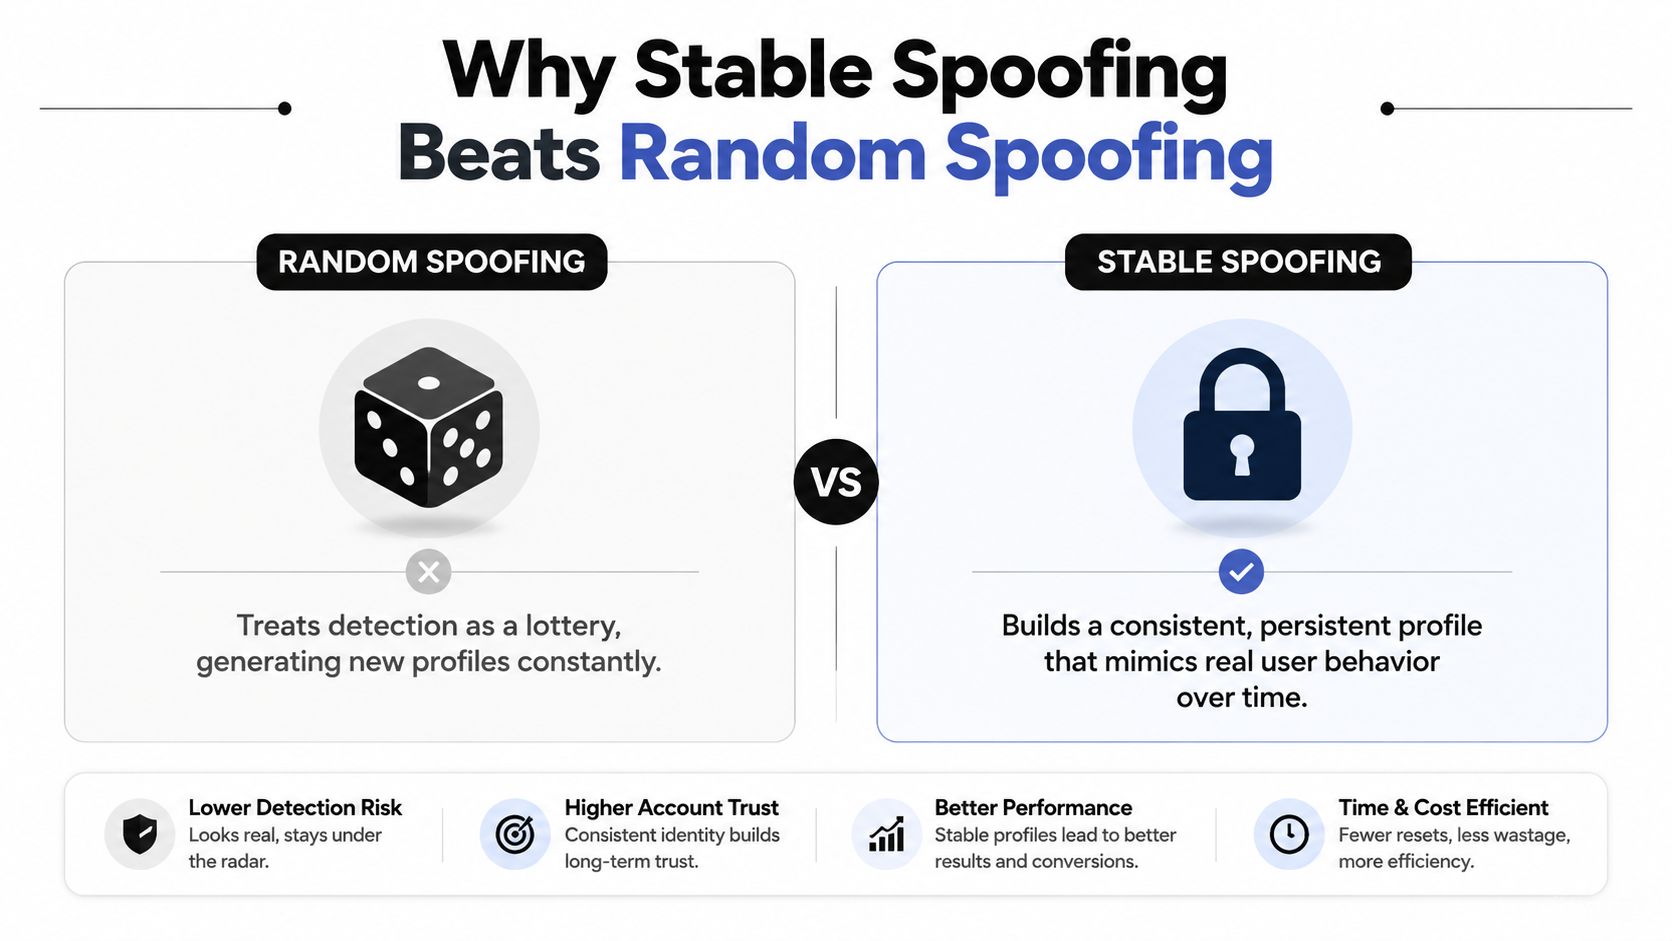
La generación aleatoria suena como sigilo porque previene una huella digital estática. En la práctica, puede crear un perfil que cambia más rápido de lo que lo haría un dispositivo real.
Un usuario recurrente generalmente mantiene la misma familia de navegador, comportamiento de renderizado, fuentes instaladas, características de pantalla y ruta de audio. Si canvas, WebGL, fuentes y audio cambian en cada sesión, la plataforma ve un objetivo móvil en lugar de un dispositivo estable. Ese patrón puede ser más sospechoso que un perfil consistente con imperfecciones ordinarias.
El problema de estabilidad también afecta el historial de la cuenta. El comportamiento de IP, cookies, geografía de inicio de sesión y cadencia de acciones deben respaldar la misma identidad a lo largo del tiempo. Un perfil que mantiene su huella digital pero salta entre ubicaciones de proxy incompatibles aún produce una contradicción. Un proxy que permanece fijo mientras el User-Agent cambia crea otra.
El objetivo no es la aleatoriedad máxima. Es la contradicción mínima.
La investigación de seguridad de sistemas de 2023 muestra por qué el spoofing sigue siendo un problema grave para los sistemas reales. Un ataque logró una tasa de éxito del 97.78% contra un sistema de reconocimiento de huellas dactilares automatizado de código abierto usando 6,342 imágenes de huellas dactilares. En el nivel de seguridad 1, el 86.9% de las huellas falsas tuvieron éxito, y en el nivel de seguridad más alto probado, el 75.33% aún logró burlar el sistema (evaluación de seguridad de sistemas).
Los operadores de navegadores deberían extraer la lección opuesta de esos resultados. No asuman que una configuración de seguridad más alta o un atributo falseado arregla toda la estructura. La misma investigación encontró que el rendimiento del detector de spoofing varió entre materiales y sensores, con resultados de generalización del 75.24% y 91.78% dependiendo del contexto de evaluación. Otro resultado mostró que las falsificaciones mal clasificadas aumentaron del 14.91% en sensores conocidos al 39.58% en sensores desconocidos, lo que demuestra qué tan rápido puede degradarse el rendimiento cuando las condiciones cambian.
Un perfil estable aún necesita mantenimiento. Actualice las versiones obsoletas del navegador, mantenga el User-Agent consistente con la familia de navegador real, y revise la desviación de zona horaria cuando una cuenta cambia de región. Estabilidad no significa congelar cada valor para siempre. Significa realizar cambios deliberados mientras se preserva un historial de dispositivo coherente.
Lista de Verificación Operativa para Trabajo Confiable con Múltiples Cuentas
Use esta lista de verificación antes de vincular una cuenta valiosa de Facebook o TikTok a un perfil:
- Consistencia del perfil: Mantenga alineados canvas, WebGL, fuentes, audio, propiedades de pantalla e indicadores de hardware. No aleatorice una capa de forma independiente.
- Reputación y geografía del IP: Vincule un proxy residencial adecuado por perfil cuando el flujo de trabajo involucre cuentas de consumidor con sesión iniciada. Haga coincidir la ubicación del proxy con la zona horaria, el idioma y el contexto del dispositivo declarado.
- Cadencia de comportamiento: Varíe la duración de la sesión y el tiempo de las acciones sin convertir cada acción en un retraso aleatorio. Un usuario recurrente debe tener un ritmo reconocible.
- Aislamiento de cuentas: Mantenga cookies, almacenamiento local, credenciales y flujos de pago dentro del perfil asignado. Nunca reutilice un perfil preparado entre cuentas no relacionadas.
- Disciplina del User-Agent: No rote el User-Agent dentro de un perfil persistente. Si el navegador cambia, cree un plan de migración controlado en lugar de cambiar abruptamente la identidad.
- Persistencia del perfil: Almacene los perfiles en la nube cifrada del navegador antidetección cuando la plataforma lo admita. Una cuenta recurrente debe cargar el mismo perfil de huella digital que usó durante la preparación.
Los mismos controles importan para el cultivo de cuentas, cloaking, campañas de afiliados, scraping y verificación de anuncios regionales. Pruebe cada perfil con su proxy asignado antes de iniciar sesión, luego monitoree la desviación del navegador, discrepancias de ubicación, cookies fallidas y verificación inesperada.
La calidad del proxy limita el resto de la estructura. El programa de referidos y afiliados de Sota Proxy ofrece hasta 40% de comisión, y sus pools residenciales y móviles pueden evaluarse como una opción de abastecimiento para equipos que necesitan ubicaciones de proxy alineadas con perfiles persistentes.
Sota Proxy proporciona opciones de proxy residenciales, móviles, ISP, datacenter e IPv6 con selección de ubicación, rotación o sesiones sticky, monitoreo de uso y gestión orientada a perfiles. Visite Sota Proxy para alinear la capa de proxy con su configuración de navegador antidetección antes de escalar flujos de trabajo de Facebook, TikTok, cloaking o geo-dirigidos.
Artículos relacionados

Cómo Ganar Dinero con Web Scraping en 2026: Cinco Modelos, con Precios
Cinco formas en que los scrapers generan ingresos, cuánto cobra cada uno y cuánto cuesta realmente ejecutar un scraping, medido en páginas reales: solo HTML versus renderizado completo del navegador.

Lo que realmente cuesta un stack de multi-accounting en 2026
Cifras mensuales reales para 10, 50 y 200 cuentas: perfiles antidetect, proxies, números, teléfonos en la nube y comisiones de tarjetas, con la partida que se come tres cuartas partes del presupuesto.
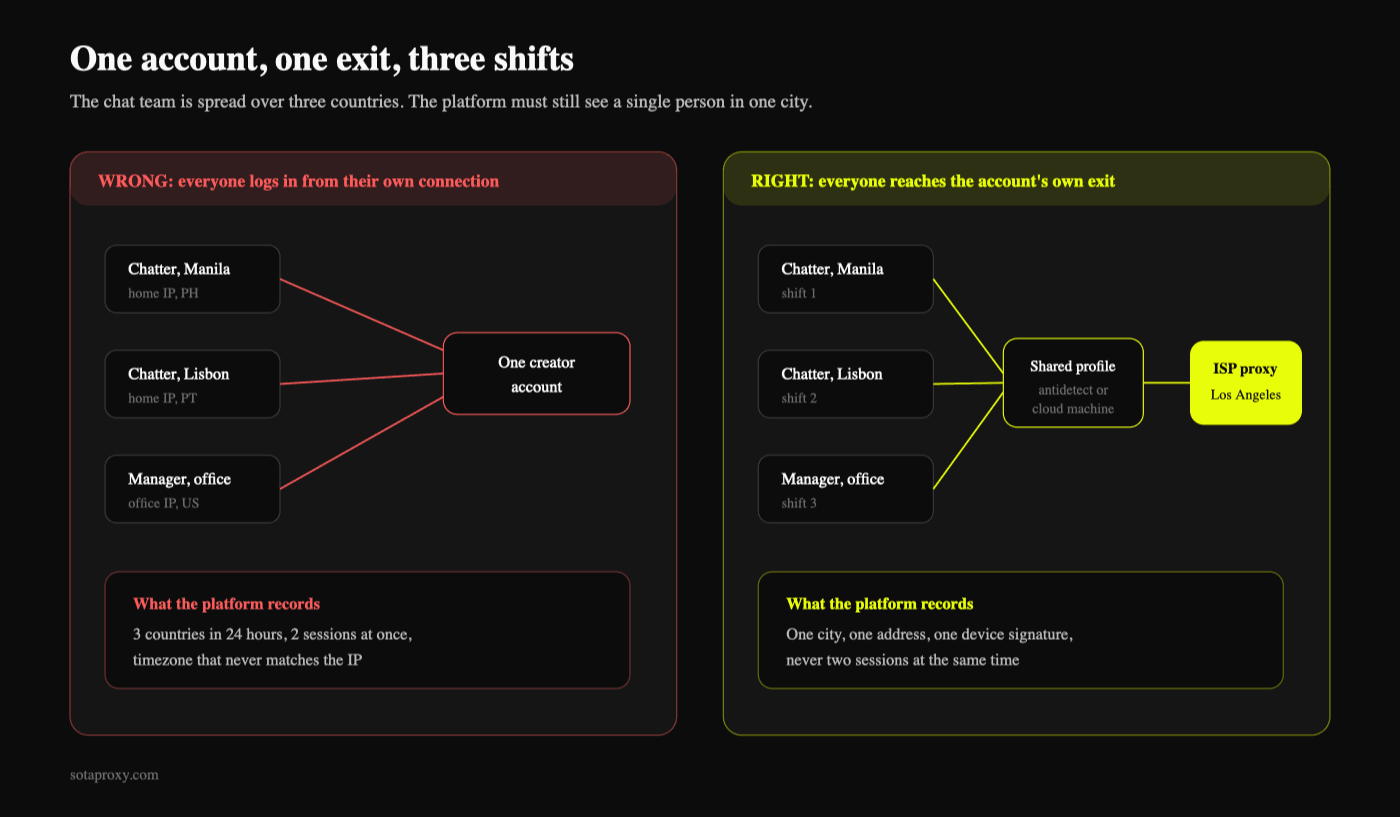
Cómo las agencias de OnlyFans gestionan 20 cuentas de creadores sin vincularlas
Qué vincula realmente las cuentas de creadores, qué tipo de proxy necesita cada una, cómo los chatters en tres países comparten un único inicio de sesión, y cuánto cuesta la capa de aislamiento frente a una comisión de agencia del 20 al 50 por ciento.
Compra Proxies para Geo Surfing que Realmente Funcionan
Aprende cómo comprar proxies para geo surfing de la manera correcta: elige tipos, selecciona ciudades objetivo, configura navegadores antidetect y valida resultados geo.

Cómo construir una infraestructura de protección de tráfico publicitario con Cloaking.House y SotaProxy
Aprende a construir un stack confiable de tráfico publicitario con proxies, perfiles de navegador y cloaking para pruebas GEO, filtrado y resolución de problemas de campañas.
Qué es Sticky Session: Guía Técnica para Usuarios de Proxies
Descubre qué es sticky session, cómo funciona la afinidad de sesión en balanceadores de carga y proxies, y cuándo usarla para multi-accounting, scraping y campañas publicitarias.