Web Scraping con Python: Un Crawler Construido de Tres Formas y la Velocidad de Cada Una
Un crawler funcional en Python usando requests, luego el mismo scraping con asyncio y Scrapy, cada uno cronometrado por nosotros en el mismo sitio. Más páginas JavaScript, proxies y las trampas que rompen los crawlers.
Un rastreador web hace algo que un scraper no hace: encuentra sus propias páginas. Le das una dirección inicial, sigue los enlaces que encuentra y continúa hasta que se queda sin sitio o alcanza el límite que estableciste. Extraer datos de cada página es scraping. Decidir qué página buscar después es crawling.
Esta guía construye el mismo rastreador de tres formas distintas, con requests, con asyncio y con Scrapy. Ejecutamos los tres contra el mismo sitio el 30 de septiembre de 2026 y los cronometramos, así que la comparación del final está medida y no citada de otra fuente. El objetivo es books.toscrape.com, un entorno de pruebas que existe exactamente para este tipo de práctica.
El rastreador más pequeño que funciona
Instala dos paquetes:
pip install requests beautifulsoup4Y este es el rastreador completo:
import time
from collections import deque
from urllib.parse import urljoin, urldefrag, urlparse
from urllib.robotparser import RobotFileParser

import requests
from bs4 import BeautifulSoup

START = "https://books.toscrape.com/"
MAX_PAGES = 300
DELAY = 0.0          # seconds between requests; raise it on real sites
USER_AGENT = "my-crawler/1.0 (+mailto:you@example.com)"

host = urlparse(START).netloc
robots = RobotFileParser(urljoin(START, "/robots.txt"))
robots.read()

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT

queue = deque([START])     # the frontier: URLs waiting to be fetched
seen = {START}             # every URL ever queued, so nothing is fetched twice
pages = 0

while queue and pages < MAX_PAGES:
    url = queue.popleft()
    if not robots.can_fetch(USER_AGENT, url):
        continue
    try:
        r = session.get(url, timeout=15)
    except requests.RequestException as e:
        print("failed", url, e)
        continue
    if r.status_code != 200 or "text/html" not in r.headers.get("Content-Type", ""):
        continue

    pages += 1
    soup = BeautifulSoup(r.text, "html.parser")
    title = soup.title.get_text(strip=True) if soup.title else ""
    print(pages, url, title)

    for a in soup.select("a[href]"):
        link = urldefrag(urljoin(url, a["href"])).url   # absolute, no #fragment
        if urlparse(link).netloc == host and link not in seen:
            seen.add(link)
            queue.append(link)

    time.sleep(DELAY)
Cuatro partes de este código son lo que convierte cualquier rastreador en rastreador:
- La frontera.
queuecontiene las direcciones que esperan ser buscadas. Tomar del frente produce un rastreo en anchura, que alcanza las páginas importantes de un sitio antes que las profundas. - El conjunto de vistas. Sin él, el rastreador busca la página de inicio cada vez que otra página enlaza hacia ella, y nunca termina.
- Alcance. La verificación del host mantiene el rastreador en un solo sitio. Quítala y estarás rastreando internet.
- Cortesía. Lee
robots.txt, se identifica con un User-Agent que indica cómo contactarte, y tiene un delay que puedes aumentar.
Dos detalles menores evitan problemas más adelante. urljoin convierte enlaces relativos en direcciones completas, y urldefrag elimina la parte #section, para que una página no se encole bajo varios nombres. La verificación de Content-Type impide que el rastreador intente analizar imágenes y PDFs como HTML.
El mismo rastreo, diez páginas a la vez
El primer rastreador pasa casi todo su tiempo esperando la red, una solicitud tras otra. La solución es esperar varias a la vez. Esta versión usa httpx y asyncio con diez trabajadores compartiendo una cola:
pip install httpx beautifulsoup4import asyncio
from urllib.parse import urljoin, urldefrag, urlparse
import httpx
from bs4 import BeautifulSoup
START = "https://books.toscrape.com/"
MAX_PAGES = 300
CONCURRENCY = 10
USER_AGENT = "my-crawler/1.0 (+mailto:you@example.com)"
host = urlparse(START).netloc
async def worker(client, queue, seen, state):
while True:
url = await queue.get()
try:
if state["started"] >= MAX_PAGES:
continue
state["started"] += 1
r = await client.get(url)
if r.status_code != 200 or "text/html" not in r.headers.get("content-type", ""):
continue
state["pages"] += 1
state["bytes"] += r.num_bytes_downloaded
soup = BeautifulSoup(r.text, "html.parser")
for a in soup.select("a[href]"):
link = urldefrag(urljoin(url, a["href"])).url
if urlparse(link).netloc == host and link not in seen:
seen.add(link)
queue.put_nowait(link)
except httpx.HTTPError as e:
print("failed", url, e)
finally:
queue.task_done()
async def main():
queue = asyncio.Queue()
queue.put_nowait(START)
seen = {START}
state = {"started": 0, "pages": 0, "bytes": 0}
async with httpx.AsyncClient(timeout=15, headers={"User-Agent": USER_AGENT}) as client:
workers = [asyncio.create_task(worker(client, queue, seen, state))
for _ in range(CONCURRENCY)]
await queue.join()
for w in workers:
w.cancel()
print(state, "urls discovered:", len(seen))
asyncio.run(main())La lógica no cambia: una frontera, un conjunto de vistas, una verificación de alcance. Lo que cambió es que diez trabajadores toman de la cola al mismo tiempo. CONCURRENCY es el número con el que hay que tener cuidado. Diez está bien para un entorno de pruebas. En un sitio real son diez visitantes simultáneos desde una dirección, y muchos sitios lo notarán.
Esta versión omite robots.txt para mantenerse breve. Coloca la misma verificación RobotFileParser antes de apuntarlo a un sitio real.
El mismo rastreo en Scrapy
Scrapy es un framework construido para este trabajo. La frontera, el conjunto de vistas, el alcance, robots.txt, los reintentos y los archivos de salida ya están ahí, así que la araña es principalmente configuración:
pip install scrapyfrom scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
class BooksSpider(CrawlSpider):
name = "books"
allowed_domains = ["books.toscrape.com"]
start_urls = ["https://books.toscrape.com/"]
rules = [Rule(LinkExtractor(), callback="parse_page", follow=True)]
custom_settings = {
"USER_AGENT": "my-crawler/1.0 (+mailto:you@example.com)",
"ROBOTSTXT_OBEY": True,
"CONCURRENT_REQUESTS_PER_DOMAIN": 10,
"DOWNLOAD_DELAY": 0,
"CLOSESPIDER_PAGECOUNT": 300,
}```python
def parse_page(self, response):
yield {
"url": response.url,
"title": response.css("title::text").get(default="").strip(),
}
```
Guárdalo como `books_spider.py` y ejecútalo sin necesidad de crear un proyecto:
```
scrapy runspider books_spider.py -O pages.jsonl
```
Los resultados quedan en `pages.jsonl`, un objeto JSON por línea. En un sitio real, establece `DOWNLOAD_DELAY` por encima de cero o activa `AUTOTHROTTLE_ENABLED`, que ralentiza el rastreo cuando el servidor empieza a responder con lentitud.
## Lo que medimos
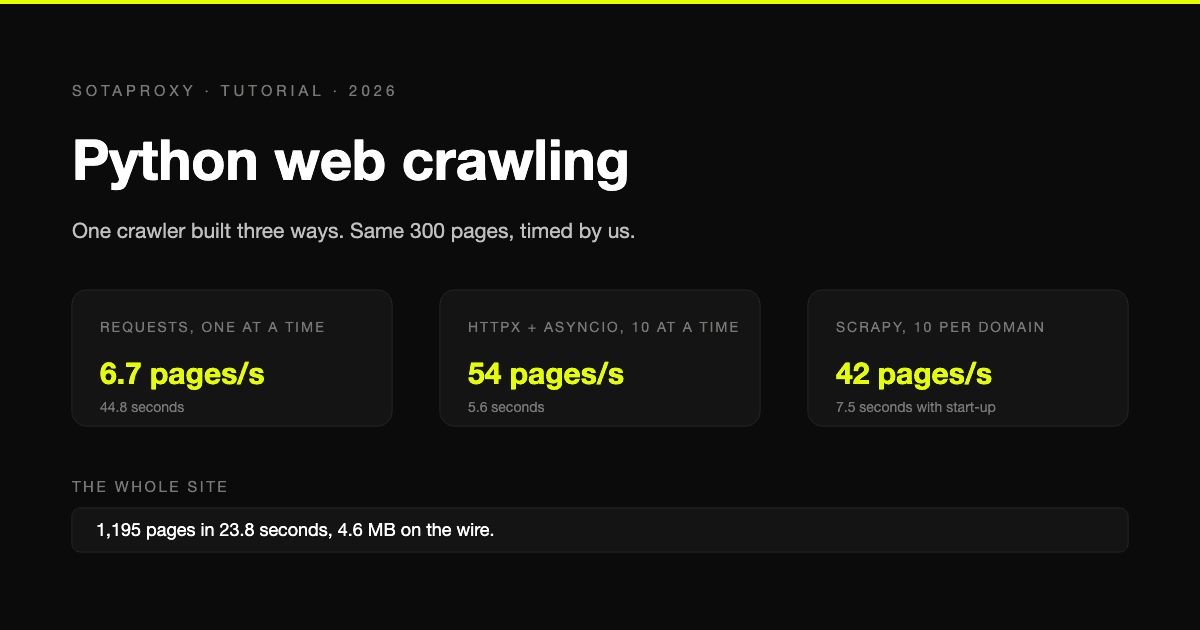
Los tres rastrearon el mismo sitio desde la misma computadora portátil en una conexión doméstica, sin demora, deteniéndose en 300 páginas.
Rastreador Páginas Tiempo total Páginas por segundo requests, una a la vez 300 44,8 s 6,7 httpx y asyncio, 10 a la vez 300 5,6 s 54 Scrapy, 10 por dominio 317 7,5 s 42
Las versiones eran Python 3.13, requests 2.34, httpx 0.28, Scrapy 2.19 y BeautifulSoup 4.15.
Lo que nos dice la tabla:
- La concurrencia lo es todo. Pasar de una solicitud a la vez a diez hizo el rastreo ocho veces más rápido con el mismo código de análisis.
- Scrapy no es tan lento como parece. Sus propias estadísticas mostraron 4,9 segundos de rastreo. El resto de los 7,5 corresponde al inicio, lo cual deja de importar en un rastreo de cualquier longitud real. Se pasó del límite por 17 páginas porque las solicitudes ya en curso se dejan terminar.
- Estas no son velocidades que esperar en un sitio real. Un sandbox no impone límites de frecuencia. En un sitio que sí lo hace, tu velocidad es la que el sitio tolera, y la herramienta no marca diferencia.
También dejamos correr la versión asyncio hasta el final. El sitio completo tiene 1.195 páginas. Tardó 23,8 segundos y 4,6 MB de tráfico, frente a 28,4 MB de HTML una vez descomprimido. Las tres bibliotecas solicitan respuestas comprimidas por defecto, y en este sitio eso redujo la transferencia por un factor de seis. Si pagas por el tráfico del proxy por gigabyte, no desactives esto.
## Cuál usar
Situación Usa Unos cientos de páginas, una vez requests. Es lo más fácil de leer y depurar Miles de páginas, tu propia lógica httpx con asyncio Un rastreo que ejecutarás de nuevo, o varios sitios Scrapy Páginas que están vacías hasta que corre JavaScript Un navegador, mediante Playwright
## Páginas que necesitan JavaScript
Algunas páginas llegan como un cascarón vacío y se llenan solas con scripts. Una solicitud HTTP simple nunca ve el contenido. El sitio de práctica tiene una versión construida así, y la diferencia es fácil de mostrar:
```python
import requests
from bs4 import BeautifulSoup
from playwright.sync_api import sync_playwright
URL = "https://quotes.toscrape.com/js/"
html = requests.get(URL, timeout=15).text
print("requests:", len(BeautifulSoup(html, "html.parser").select(".quote")), "quotes")
with sync_playwright() as p:
browser = p.chromium.launch(channel="chrome") # usa el Chrome ya instalado
page = browser.new_page()
page.goto(URL)
page.wait_for_selector(".quote")
html = page.content()
browser.close()
print("playwright:", len(BeautifulSoup(html, "html.parser").select(".quote")), "quotes")
```
Cuando lo ejecutamos, requests encontró 0 citas y Playwright encontró 10. Instala Playwright con `pip install playwright`. El argumento `channel="chrome"` hace que maneje el Chrome que ya tienes, así que no hay descarga de navegador aparte.
Un navegador es lento y pesado comparado con una solicitud simple, así que úsalo solo para las páginas que lo necesitan. Verifica primero: si los datos están en la respuesta de una solicitud simple, no necesitas navegador.
## Añadir un proxy
Un rastreador necesita un proxy cuando el sitio limita o bloquea tu dirección, o cuando necesitas ver el sitio como lo ve otro país. Cada herramienta toma el proxy en un lugar ligeramente distinto. Verificamos las cuatro formas que siguen contra un proxy con registro para confirmar que las solicitudes pasan por él.
```python
PROXY = "http://login_c_US:password@proxy.sotaproxy.com:10000"
# requests
session = requests.Session()
session.proxies = {"http": PROXY, "https": PROXY}
# httpx
client = httpx.AsyncClient(proxy=PROXY)
```# Playwright
browser = p.chromium.launch(proxy={
"server": "http://proxy.sotaproxy.com:10000",
"username": "login_c_US",
"password": "password",
})Scrapy lee las variables de entorno estándar, así que el spider no cambia:
https_proxy=http://login_c_US:password@proxy.sotaproxy.com:10000 scrapy runspider books_spider.pyDos cosas que conviene saber antes de confiar en esto.
Un proxy rotativo rota por conexión. Los tres clientes HTTP de arriba reutilizan conexiones para ir más rápido, de modo que un crawler puede mantener una misma IP de salida mucho más tiempo del que esperarías. Cómo controlar esto con identificadores de sesión está explicado en la referencia de sesiones rotativas y persistentes.
Selenium no acepta usuario y contraseña de proxy a través de sus opciones estándar. Si estás atado a Selenium, las formas de resolverlo aparecen en autenticación y listas blancas de IP. Playwright no tiene este problema.
Qué tipo de proxy necesita un sitio concreto, y cómo averiguarlo con doscientas peticiones, se cubre en mejores proxies para web scraping.
Qué rompe los crawlers
- Páginas infinitas. Calendarios, filtros y opciones de ordenamiento generan una dirección nueva para cada combinación. Fija un límite de páginas, como hacen todos los ejemplos aquí, y considera también un límite de profundidad.
- Una página bajo muchas direcciones. Parámetros de seguimiento e identificadores de sesión en la URL anulan el conjunto de visitadas. Limpia los parámetros que sabes que son ruido antes de agregar un enlace al conjunto.
- Errores tratados como páginas. Un 429 o un 503 es el sitio pidiéndote que frenes. Espera y reintenta con una pausa creciente en lugar de avanzar:
for attempt in range(4):
    r = session.get(url, timeout=15)
    if r.status_code not in (429, 500, 502, 503, 504):
        break
time.sleep(2 ** attempt)- Un 200 que no es la página. Algunos sitios responden a una petición bloqueada con un código de estado normal y una página que solo dice que vuelvas a intentar. Verifica que el contenido que esperas esté presente, no solo el código de estado.
Crawlea con responsabilidad
Lee el robots.txt del sitio y sus términos antes de empezar. Identifica tu crawler de forma honesta, mantén la tasa de peticiones lo bastante baja como para que el sitio no te note, y no recojas datos personales que no tengas motivo para guardar. Un crawler cortés también dura más, porque no le da al sitio ningún motivo para bloquearlo.
Preguntas frecuentes
¿Cuál es la diferencia entre un web crawler y un web scraper?
Un crawler descubre páginas siguiendo enlaces. Un scraper extrae datos de una página. La mayoría de proyectos reales hacen ambas cosas: crawlear para encontrar las páginas, scrapear cada una.
¿Cuál es la mejor librería de Python para web crawling?
Scrapy, para cualquier cosa que vayas a ejecutar más de una vez. Para un trabajo puntual de unos cientos de páginas, requests con BeautifulSoup es más simple. Para lógica personalizada a volumen, httpx con asyncio.
¿Qué tan rápido puede ir un crawler en Python?
En nuestra prueba, 6,7 páginas por segundo con una petición a la vez y 54 con diez peticiones concurrentes, en un sitio sin límite de velocidad. En un sitio real el límite es lo que el sitio permite, no lo que Python puede hacer.
¿Necesito proxies para crawlear un sitio web?
No para un crawl pequeño y cortés de un sitio que no bloquea. Los necesitas cuando tu dirección es limitada o bloqueada, o cuando necesitas resultados desde otro país.
¿Cómo crawleo un sitio que usa JavaScript?
Renderiza las páginas en un navegador con Playwright, como en el ejemplo de arriba, y solo para las páginas que lo necesiten.
Artículos relacionados
Reddit "You've Been Blocked by Network Security": Todas las causas y la solución para cada una
No es un baneo y no hay nada que apelar. Proviene del edge de Reddit, se aplica a tu conexión y tiene seis causas. Aquí te mostramos cómo identificar cuál tienes y cuánto dura cada una.
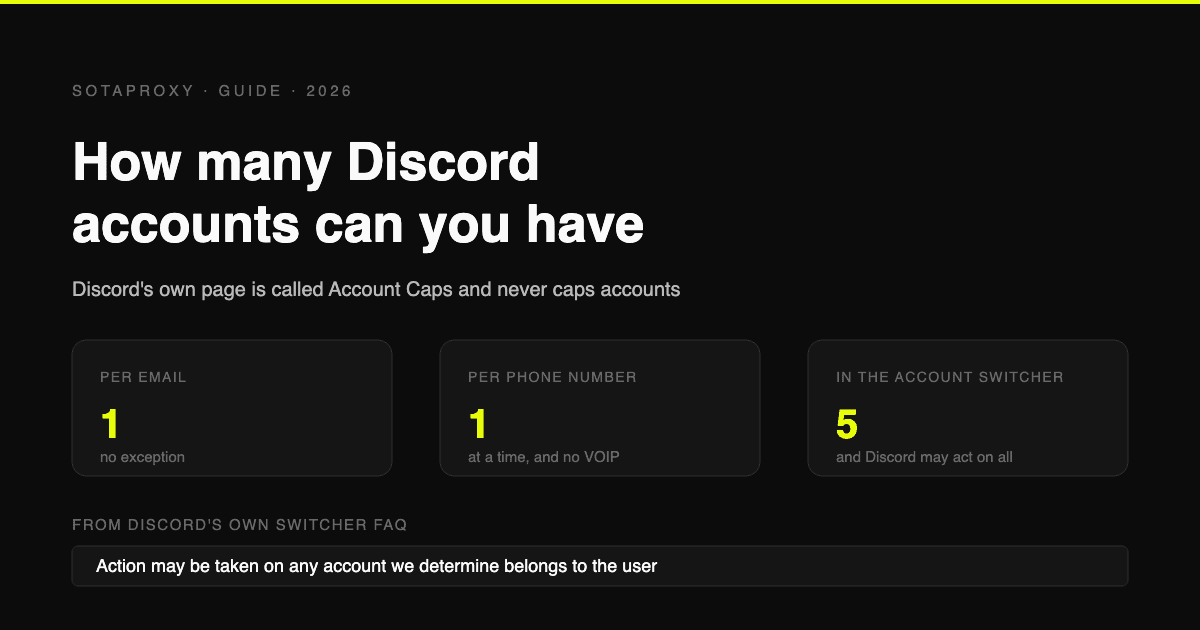
Cuántas Cuentas de Discord Puedes Tener en 2026 (Por Email, Por Teléfono, Por Dispositivo)
Discord no publica ningún límite en las cuentas. Los límites reales son uno por email, un número de teléfono a la vez sin VOIP, y cinco en el Cambio de Cuentas, que Discord indica que puede hacer cumplir de forma general.
Automatización de Telegram con Telegram Expert: qué hacer si la tarea se detuvo a la mitad
Cuántas Cuentas de Reddit Puedes Tener en 2026 (Barreras de Karma, Baneos, Bloqueos de Seguridad de Red)
Reddit permite múltiples cuentas abiertamente. Lo que te detiene son las barreras de karma, calidad del colaborador, límites de tasa y una regla estricta sobre votación, además de los tres tipos de baneo, cómo se apela cada uno, y por qué "bloqueado por seguridad de red" no es ninguno de ellos.
Cuántas Cuentas de TikTok Puedes Tener en 2026 (Límites, Strikes y Reglas de Shop)
Seis cuentas por dispositivo, no tres, y sin límite publicado. Las reglas que realmente deciden la supervivencia: límites de acción según la antigüedad de la cuenta, cómo expiran los strikes, qué es realmente un shadowban y una Shop por entidad comercial por mercado.
Cuántas Cuentas de Facebook Puedes Tener en 2026 (Perfiles, Portafolios, Cuentas Publicitarias)
Una cuenta personal, cuatro perfiles adicionales que comparten su enforcement, dos portafolios de negocios por persona, y un límite de cuentas publicitarias que crece con la confianza. Qué se restringe realmente y en qué orden.